

Gemini 3.5 Transcribeは、2026年8月26日ごろに発表されたGoogleの新しい音声認識専用モデルで、Geminiの音声理解をベースにしています。2種類が用意されています。録音済みファイル向けのgemini-3.5-transcribe(最大1時間、話者分離と単語タイムスタンプに対応)と、WebSocketによるリアルタイムストリーミング向けのgemini-3.5-transcribe-live(1セッション10分、話者分離なし)です。
注目はやはり料金です。ファイルモデルは1分あたり約0.005ドル、ライブは1分あたり約0.009ドルで、Google自身のCloud Speech-to-Text v2の標準ティア(1分あたり0.016ドル)より安くなっています。Googleは非ストリーミングの英語で単語誤り率2.6%(Artificial Analysis測定)と報告しており、Chirp 3の後継として位置づけられています。
率直な評価としては、ラボの数値は優秀ですが、初期の実利用での反応は割れています。ファンは「使った中で最高のディクテーションモデル」と評価し、批判的な声は、スマート文字起こしが正確な言い回しを「簡略化」しうること、話者分離が3人を超えると不安定になることを挙げています。知っておくべきステータス上の注意点もあります。Googleのモデル一覧では「Stable」とされている一方、発表ブログでは「public preview」とされています。音声チケット向けに検討しているサポートチームの場合、文字起こしはあくまで入口の層にすぎないことを覚えておいてください。チケットを実際に解決する仕組みが別に必要で、そこで役立つのがAIヘルプデスクチームメイトです。
Gemini 3.5 Transcribeとは?
ここ数年、Googleのモデルで音声をテキストにするには2つの選択肢がありました。Google CloudのSpeech-to-Text API(Chirpシリーズ)を使うか、汎用のGeminiチャットモデルに音声ファイルを渡して文字起こしを頼むかです。Gemini 3.5 Transcribeは、Googleがこの用途のために特化して作ったGemini名義のモデルとしては初めてで、Gemini 3シリーズの一員として位置づけられます。
Googleはこれを"a speech-to-text model based on Gemini's audio understanding capabilities"と説明しており、発話単位の言語検出、話者分離、単語レベルのタイムスタンプ、スマート文字起こし、カスタム語彙のバイアス指定に対応した低遅延の文字起こしを提供します。平たく言えば、音声を聞き取り、整形済みで話者ラベル付きのきれいなテキストを85以上の言語で返してくれるもので、自前でパイプラインを組む必要はありません。
Google Cloudの文字起こしコンソールを使ったことがあれば、流れはおなじみです。音声ファイルを指定してオプションを選びます。
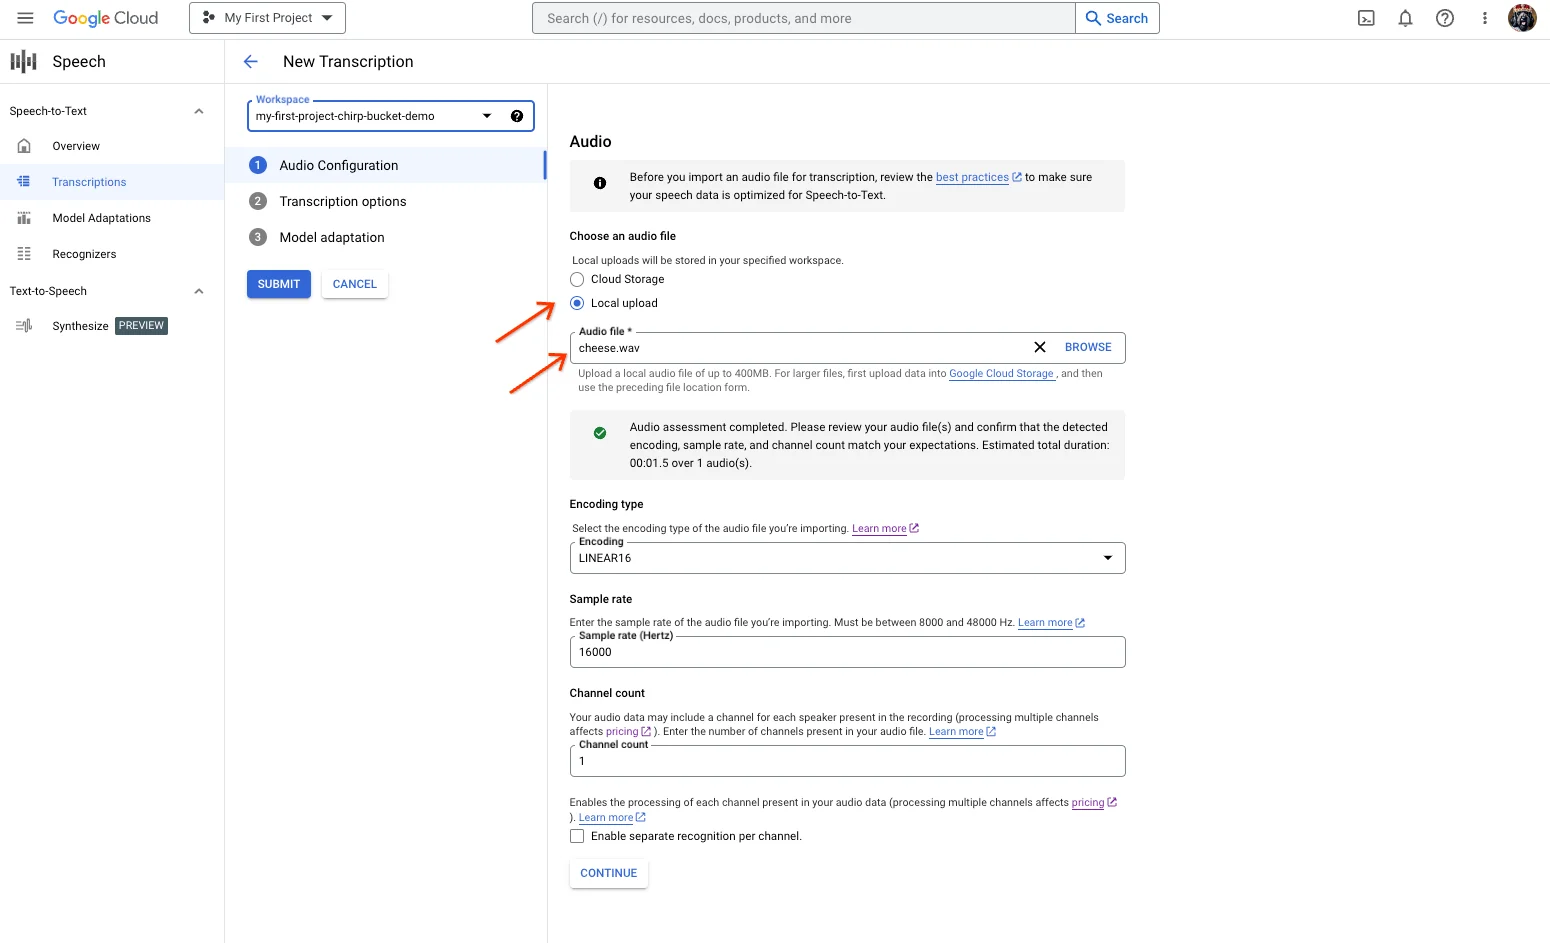
最初にお伝えしておきたいのは、Google自身のドキュメント同士が一致していない点です。モデル概要ページではGemini 3.5 Transcribeに「New Stable」のタグが付いている一方、発表ブログ記事では開発者と企業向けに「in public preview」とされています。同じ記事によれば、すでにAndroid版GboardのRambler、macOS版Geminiアプリなどの一般向け製品で使われており、「Chromeにも近日対応予定」です。本番運用に近いものの、完全に固まったわけではないと考えてください。
2つのモデル:ファイルとライブ
コードを1行書く前に理解しておくべき最も重要なことは、「Gemini 3.5 Transcribe」が実際には2つのエンドポイントであり、その挙動が大きく異なるという点です。
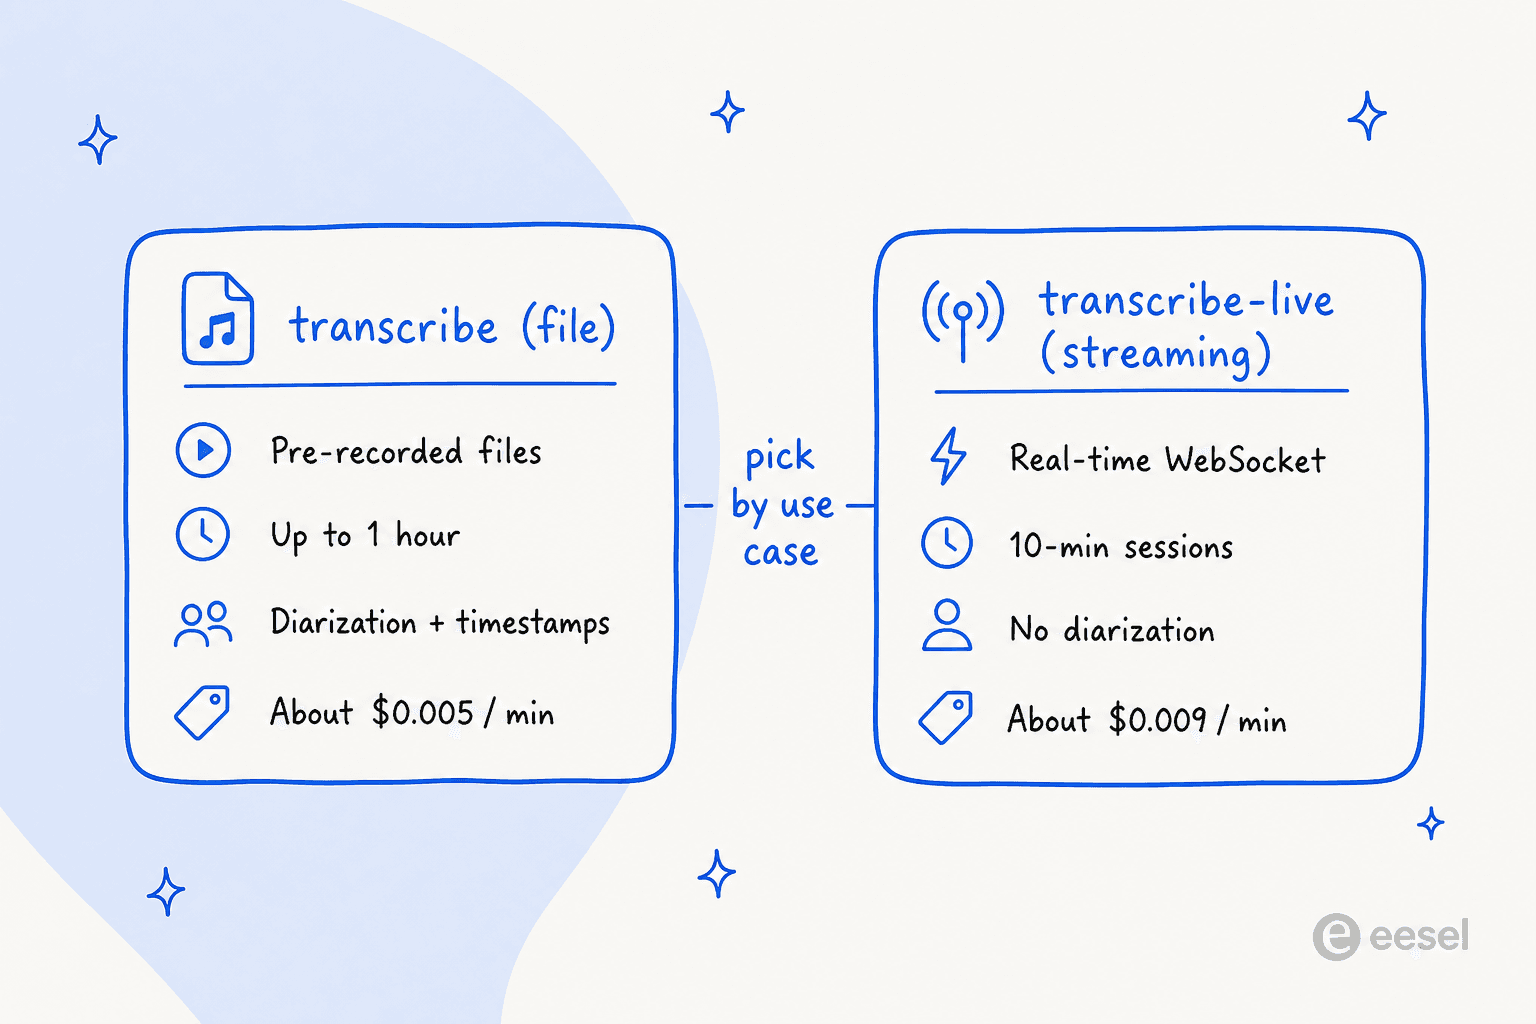
gemini-3.5-transcribeのファイルモデルは、サポート通話、ポッドキャスト、会議など、すでに録音がある状態で、話者ラベル付きの完全な文字起こしがほしいときに使います。gemini-3.5-transcribe-liveのライブモデルは、ライブ字幕のように音声をその場でストリーミングする用途向けで、遅延が1秒増えるごとに体感に影響します。対応機能の内訳は次のとおりです。
| 機能 | gemini-3.5-transcribe(ファイル) | gemini-3.5-transcribe-live(ストリーミング) |
|---|---|---|
| 最適な用途 | 録音済み音声 | リアルタイム字幕 |
| 言語の自動検出 | 85以上の言語、セッション途中の言語混在にも対応 | 85以上の言語 |
| 単語レベルのタイムスタンプ | 対応(精度は低下) | 非対応 |
| 話者分離 | 対応(下記の注意参照) | 非対応 |
| カスタム語彙のバイアス指定 | 最大1,000語(100語以下が最適) | 最大1,000語 |
| スマートディクテーションと整形 | 対応 | 対応 |
| 最大音声長 | 最大1時間(話者分離またはタイムスタンプ使用時は30分) | 1セッション10分 |
| 混合料金 | 約0.005ドル / 分 | 約0.009ドル / 分 |
注意が必要なのは話者分離です。Googleのモデルページの機能表ではファイルモデルが「up to 8 speakers (Attribution for 3+ speakers is experimental)」に対応するとされていますが、発表ブログでは「up to three speakers」とされています。いずれにせよ、現時点で信頼できる上限は3人で、8人ではなくこの数字を前提に計画するのがよいと私は考えます。
スマート文字起こしが実際にやること
Googleが最も力を入れている機能がスマート文字起こしで、これは最も大きな不満の原因でもあるため、理解しておく価値があります。人間の話し言葉をそのまま文字にしたものは雑然としています。「えーと」と言ったり、文を言いかけて止めてやり直したり、数字をもごもご言ったりします。スマート文字起こしはそれらを自動で整えます。
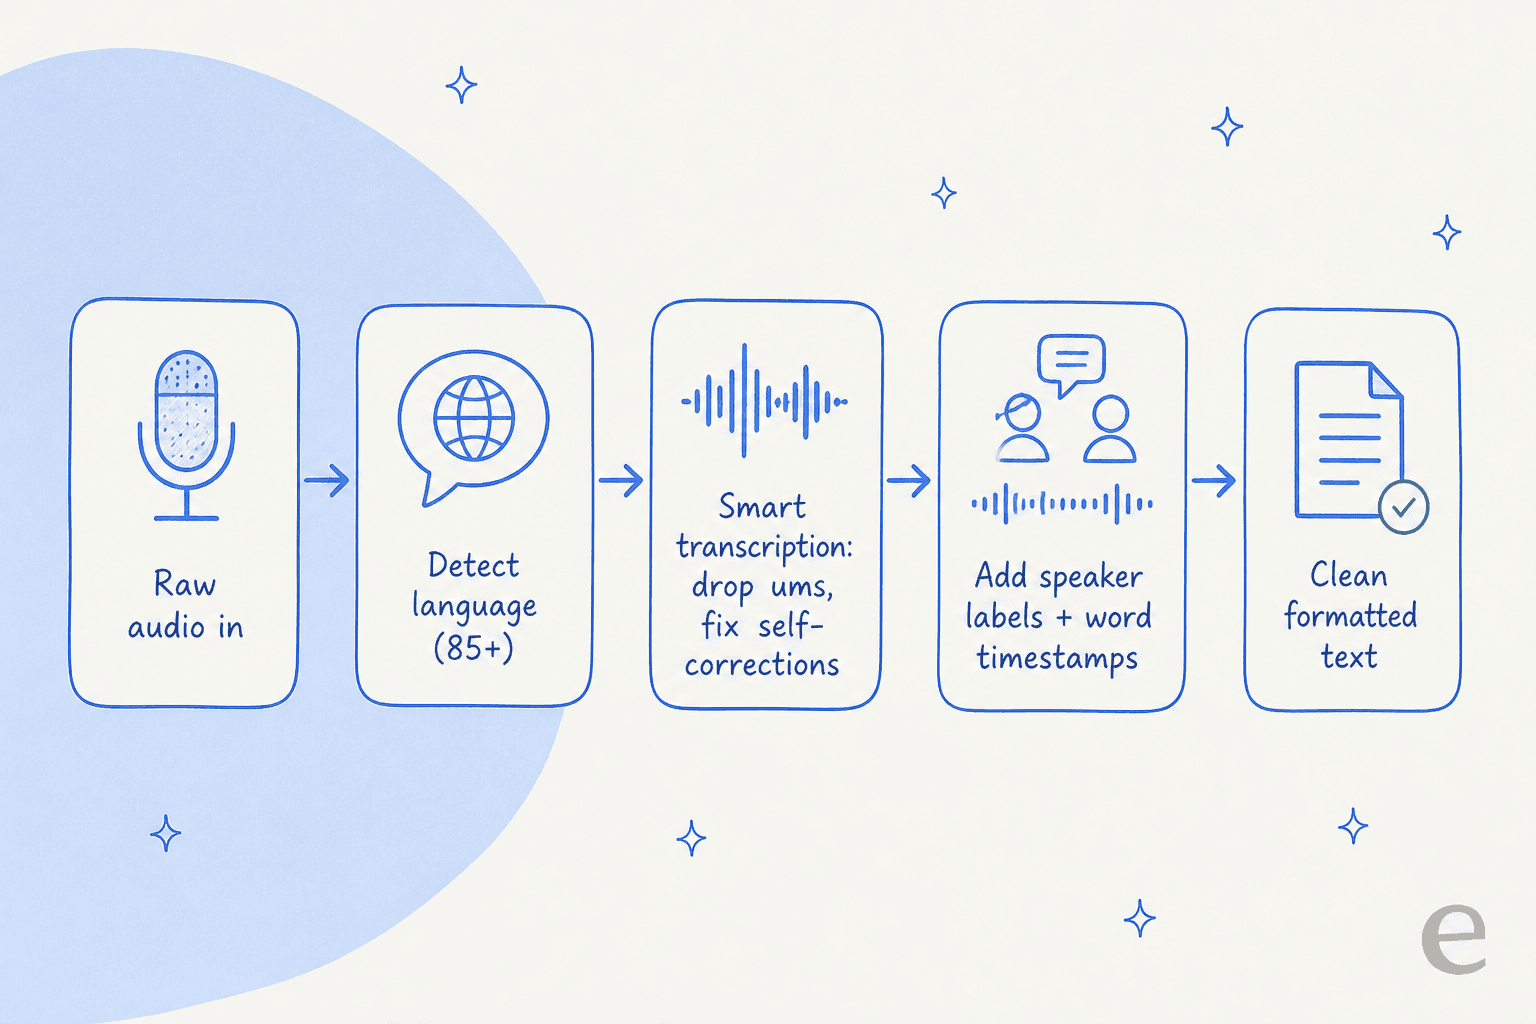
発表記事によれば、言い直し(「火曜に会いましょう、いや、水曜で」と言えば「水曜」になる)に対応し、フィラーを取り除き、英数字の並びなどには意図を踏まえた整形を行います。メールの口述や会議メモの整理では、専用のディクテーションツールが料金を取っているような機能なので、基本モデルに入っているのは便利です。
その反面、「整える」のは判断を伴う作業で、何がノイズかについてモデルがあなたと一致するとは限りません。Pixel 11 Proで試したある開発者は、鋭くこう述べています。
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."

つまり、スマート文字起こしは中立的な文字起こしではなく「機能」だと捉えるのが適切です。一字一句が重要な用途(法務、研究など)では、現実的なトレードオフとして検討すべきです。
実際の精度はどのくらい?
紙の上では、数値は優秀です。Googleは次の単語誤り率を報告しており、すべてArtificial Analysisによるものとされています。
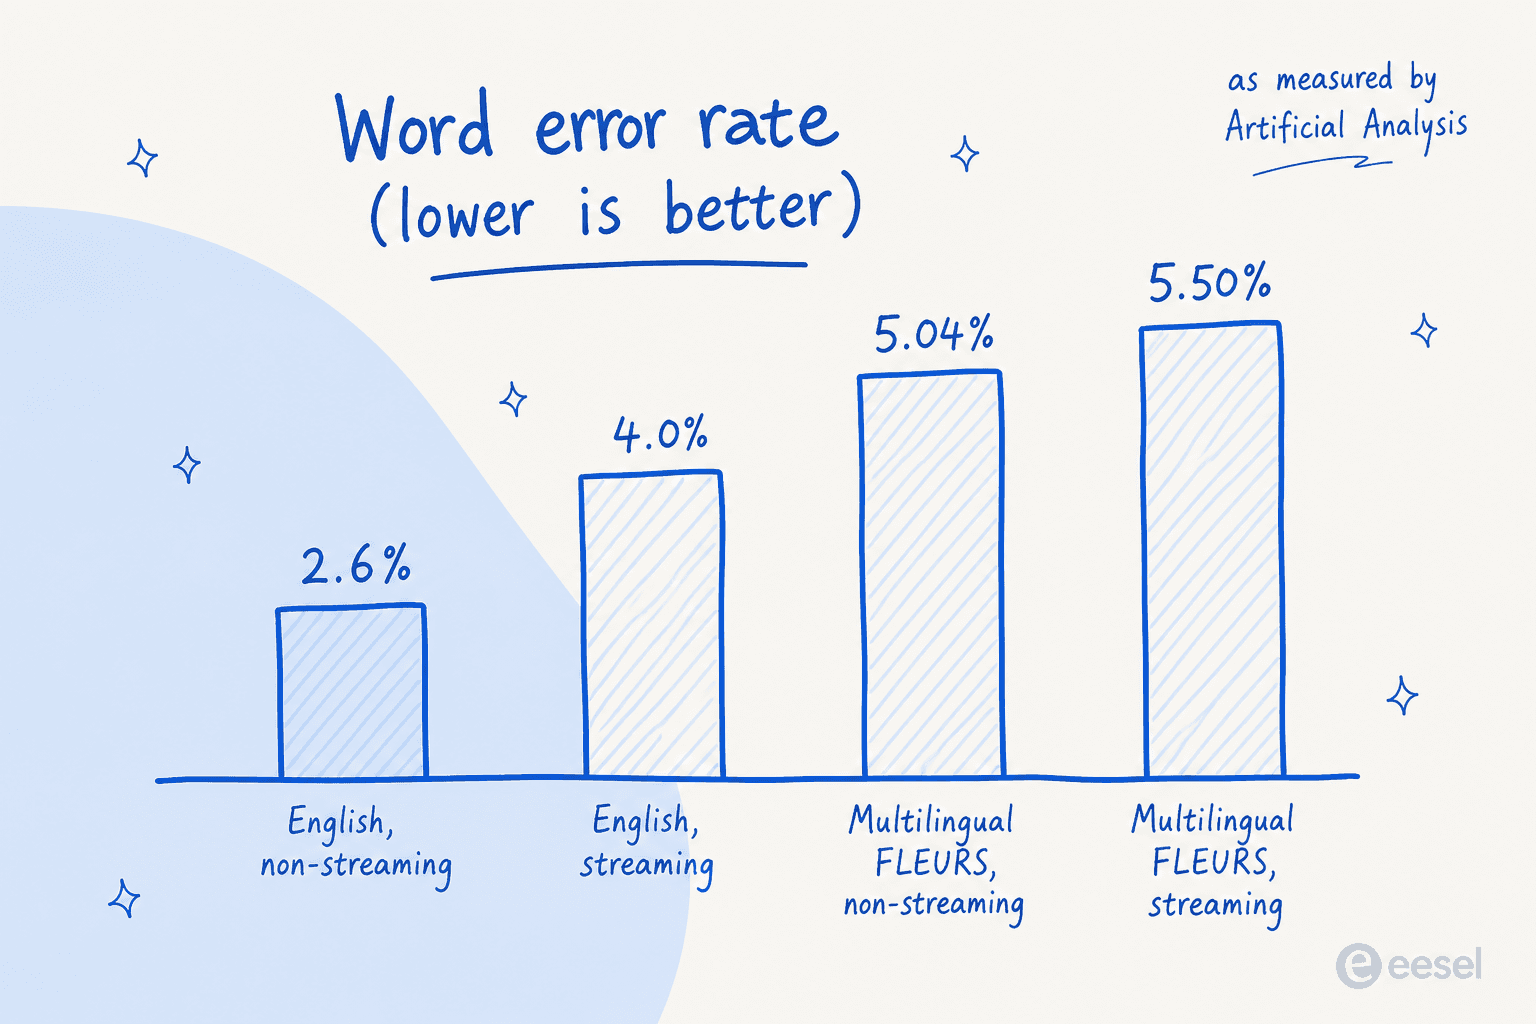
非ストリーミングの英語で単語誤り率2.6%というのは非常に良好で、おおよそ40語に1語の誤りです。Googleはまた、最終的な文字起こしまでの時間がChirp 3比で70%改善したとしていますが、この見方はGoogle自身のものなので、独立したベンチマークではなくベンダー提示の数値として扱うべきだと思います。
より興味深いのは、実際に使った人たちの声です。そしてここでは評価が割れています。肯定的な側では次のような声があります。
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."
しかし、Hacker Newsの発表スレッドには、独自に比較して異なる結論に至った人が大勢います。今でもWhisperを好む人がいて、実際の欠点を見つけた人も何人かいます。
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
私の結論は、クリーンなベンチマーク上のWERと、実際の音声(雑音のある通話、さまざまなアクセント、同時発話)でのWERは別物だということです。ラボの数値は強力な出発点ですが、保証ではありません。実務で文字起こしモデルを評価するなら、導入を決める前に自分の録音で試してください。
Gemini 3.5 Transcribeの料金
Googleはモデルの発表に料金を載せておらず、それに苛立った開発者のひとりが自らHacker Newsに数字を投稿するほどでした。料金ページにある、Gemini Developer API向けの全体像は次のとおりです。
| モデル | 音声入力 | テキスト出力 | 混合レート |
|---|---|---|---|
gemini-3.5-transcribe(ファイル) | 100万トークンあたり2.00ドル(約0.003ドル/分) | 100万トークンあたり12.00ドル(約0.002ドル/分) | 約0.005ドル / 分 |
gemini-3.5-transcribe-live(ストリーミング) | 100万トークンあたり3.50ドル(約0.005ドル/分) | 100万トークンあたり21.00ドル(約0.004ドル/分) | 約0.009ドル / 分 |
比較として、Google自身のCloud Speech-to-Text v2の標準認識は1分あたり0.016ドルから始まり、ボリュームに応じて下がります。動的バッチティアは1分あたり0.003ドルです。つまり新しいGeminiのファイルモデルは、標準のリアルタイム認識より安く、最安のバッチオプションより高い位置にあります。計算するときは、リアルタイム同士、バッチ同士で比べてください。
計算といえば、簡単な計算ツールを用意しました。月に処理する音声の時間数を入力すると、各オプションのおおよその費用がわかります。
具体例です。月に200時間のサポート通話を文字起こしする小規模チームなら、ファイルモデルで月約60ドル、Cloud Speech-to-Text標準では約192ドルになります。この規模では、差は確かにありますが、それほど大きくはありません。コスト面でより大きな問いは、通常、文字起こしそのものではなく、その後トランスクリプトをどう使うかです。
Whisper、Deepgram、Scribeとの比較
ここでは慎重になりたいと思います。公正な比較には各ベンダー自身の数値が必要で、正直なところ、本当の直接比較は私ではなくユーザーが行っています。そこで、十分に裏づけられない仕様表を示す代わりに、これらのモデルを実際にA/Bテストしている人たちが何を見つけているかを紹介します。
コストに関しては、反応はほぼ真っ二つに割れます。whispermemos.comを運営するある開発者は計算してみて、結果を好意的に受け止めました。
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
精度が十分に近いとは納得できない人もいました。
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
最も一貫した不満で、会議の文字起こしをするなら私が最も重く見るのは、複数話者の扱いです。
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
そしてWhisperには今も根強い支持者がいます。セルフホストなら無料であることと、多くのチームがすでにWhisperを軸にパイプラインを構築していることが理由です。よくあるのはハイブリッド構成で、正確な単語タイムスタンプにはWhisper、実際のテキストにはGeminiモデルを使う形です。要するに、Gemini 3.5 Transcribeは価格も妥当な強力なマネージド選択肢であり、専門のASRツールに自動的に勝つわけではありません。どちらが優れるかは、音声の特性と、信頼できる話者分離が必要かどうかに大きく左右されます。
サポートチームにおける文字起こしの位置づけ
見落とされがちなので、はっきり言っておきます。Gemini 3.5 Transcribeはインフラです。音声をテキストに変えるという難しい問題をうまく解いています。しかし、顧客の電話やボイスメッセージの文字起こしは答えではなく、出発点にすぎません。そのテキストを読み、顧客が何を必要としているかを理解し、適切な情報を引き出し、チケットを解決する何かが依然として必要です。
その解決の層こそ、私が取り組んでいる領域です。私はこの数年、ライブのサポートキューで動くAIの開発に携わってきましたが、パターンは常に同じです。言葉を正しく拾うのは最低条件で、それに基づいて正しく行動することが難しいのです。文字起こしモデルは言葉を渡してくれます。しかし、あなたの返金ポリシーも、注文システムも、その顧客が直近で出した3件のチケットも知りません。
これがモデルとチームメイトの違いです。Gemini 3.5 Transcribeは、狭いひとつの仕事に秀でたモデルです。eeselはチームメイト型のプラットフォームで、特定の仕事をすぐにこなせるAIチームメイトを採用できます。現在のラインナップには、AIヘルプデスクチームメイトとAIブログライターがあります。ヘルプデスクチームメイトは、すでに運用中のヘルプデスク(Zendesk、Freshdesk、Gorgias)につながり、既存のキューに加わって、ヘルプセンターと過去のチケットで学習します。
音声・チャットのチケットにeeselを試す
チームが音声やチャットのチケットに追われているために文字起こしを検討しているなら、文字起こしは仕事の半分にすぎません。eesel AIヘルプデスクチームメイトは、Gemini 3.5 Transcribeのようなモデルが終わるところから引き継ぎます。顧客のメッセージを読み、返信を作成または送信し、1,000以上の連携を通じて実際に対応を完結させます。
最初に挙げたいのがシミュレーションモードです。AIが実際の顧客に触れる前に、過去の数千件のチケットで実行して、どのように返信したはずかを正確に確認できるので、スイッチを入れて祈る必要はありません。料金は月額固定で、500クレジットで月299ドルから(チケットまたはチャット1件につき1クレジット)、ユーザーごとの料金はなく、カード不要で100クレジットの無料プランもあります。問題を賢く文字にすることと、実際に解決することの違いです。