

結論
Gemini 3.5 Transcribeは、GoogleがGeminiブランドで初めて出した音声認識モデルです。ファイルモデルは1分あたり約0.005ドルで、クリーンな英語では単語誤り率2.6%と、強力で価格も手頃なマネージドの選択肢です。ただし自動的に最良の選択になるわけではなく、他を探す理由が2つあります。スマート文字起こしが「整える」ために話した言葉そのものを書き換えてしまうこと、そして話者分離が3人を超えると不安定になることです。
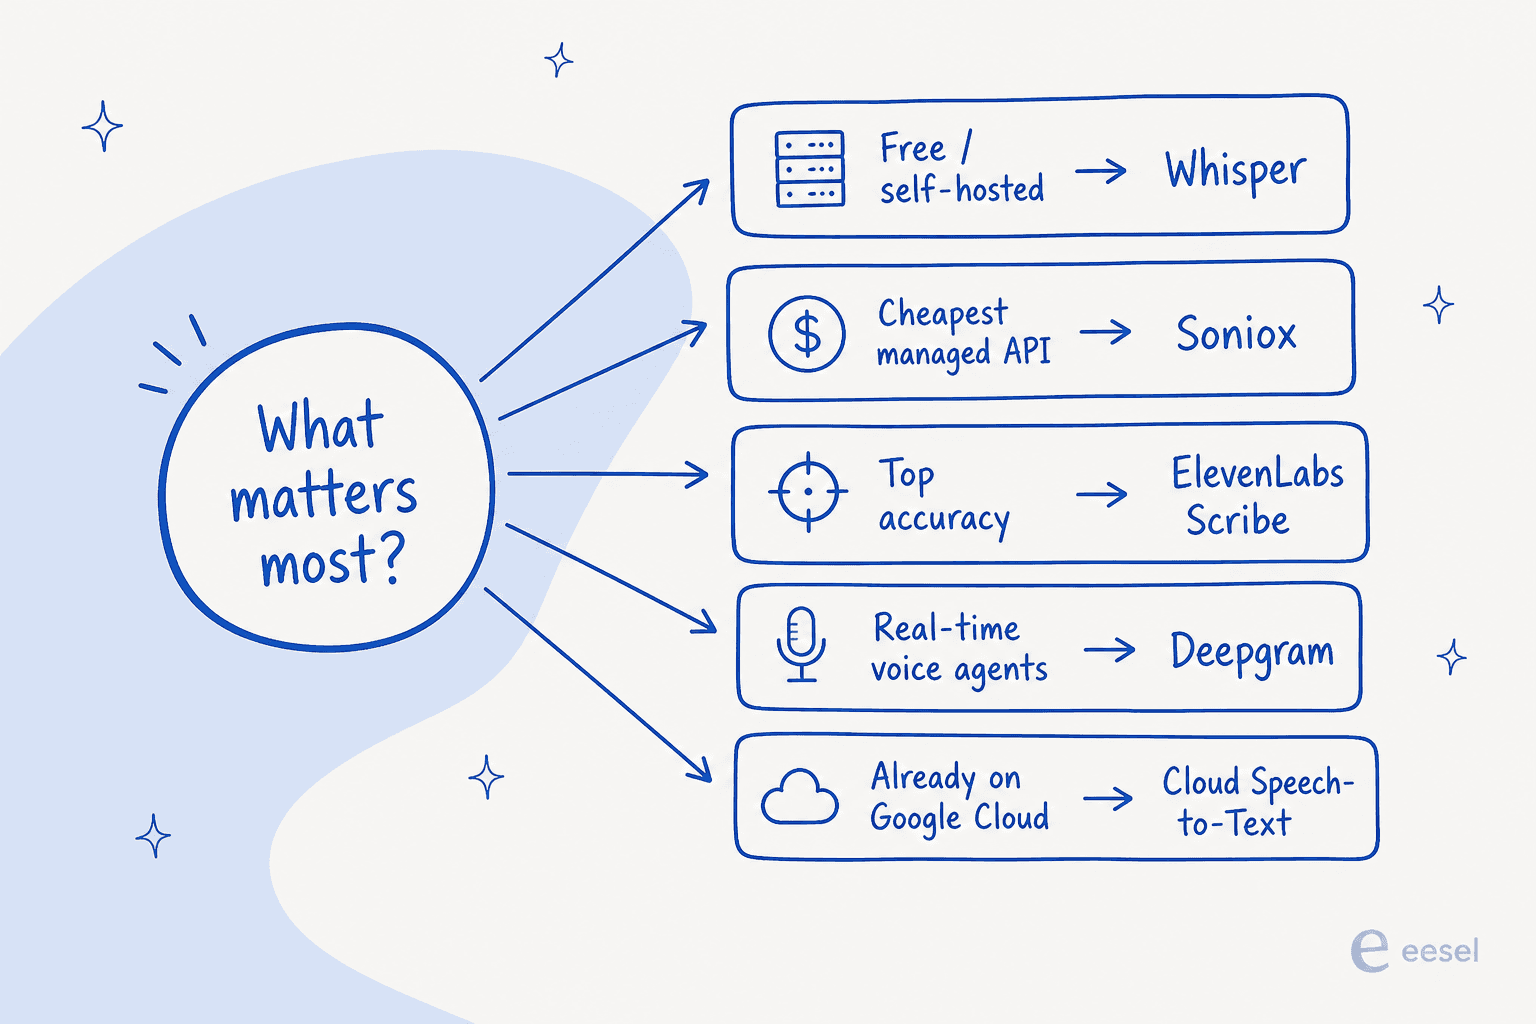
Gemini 3.5 Transcribeの代替をお探しなら、ニーズ別のおすすめは次のとおりです。
- 無料でセルフホスト: OpenAI Whisper(MITライセンス、自分のハードウェアで実行)。
- マネージドAPIで最安: Soniox、1時間あたり約0.10ドルで話者分離と言語検出込み。
- 最高水準の精度: ElevenLabs Scribe、98%以上の精度と最大32人の話者分離。
- リアルタイム音声エージェント: Deepgram、低遅延ストリーミングの専門家。
- すでにGoogle Cloudを利用中: Cloud Speech-to-Text(Chirp 3)、最安のバッチ料金は1分あたり0.003ドル。
最初に言っておきたいことがあります。文字起こしは入力レイヤーにすぎません。音声やチャットをチケットに変えているサポートチームにとって、文字起こしは簡単なほうの半分です。チケットを実際に解決するのが難しい部分であり、それはAIヘルプデスクのチームメイトの仕事で、文字起こしモデルにはできません。
なぜGemini 3.5 Transcribe以外も検討するのか
まず公平に言えば、Gemini 3.5 Transcribeはとても優れたモデルです。GoogleのChirp 3の後継で、非ストリーミングの英語で単語誤り率2.6%を報告し、85以上の言語を自動検出します。ファイルモデルが1分あたり約0.005ドルと、Google自身のCloud Speech-to-Text標準ティアよりも安価です。話者が1人のディクテーションでは、なかなか勝てません。これらはGemini 3.5 Transcribeレビューで詳しく掘り下げました。
では、なぜ乗り換えるのか。具体的な理由が3つ繰り返し挙がります。
スマート文字起こしが言葉を書き換える。 Googleが最も推している機能であり、最も多い不満でもあります。スマート文字起こしは、つなぎ言葉や言い直しを取り除き、その場で整形します。メールのディクテーションには便利ですが、正確な文言が重要な場面では深刻な問題です。ある開発者が試したところ、文を「簡略化」して意味が壊れ、繰り返しのテストで正確な節の前半が抜け落ちたといいます。法務、医療、研究、コンプライアンスの用途では、注釈で済む話ではなく致命的です。
話者分離は3人を超えると止まる。 Googleのドキュメントは矛盾しています。モデルページでは「3+ experimental」で最大8人とされ、ローンチブログでは最大3人とされています。現時点で信頼できる数字は3人で、ライブストリーミングモデルは話者分離をまったく行いません。6人の会議を文字起こしするなら、これは明確な限界です。
実は最安ではない。 ファイルモデルが1時間あたり約0.30ドルのGeminiは、価格帯では高めです。それより安い専門サービスがいくつもあり、Geminiは追加料金なしで含めている話者分離や言語検出を、他社は別料金にしていることもあります。全体像は次のとおりです。
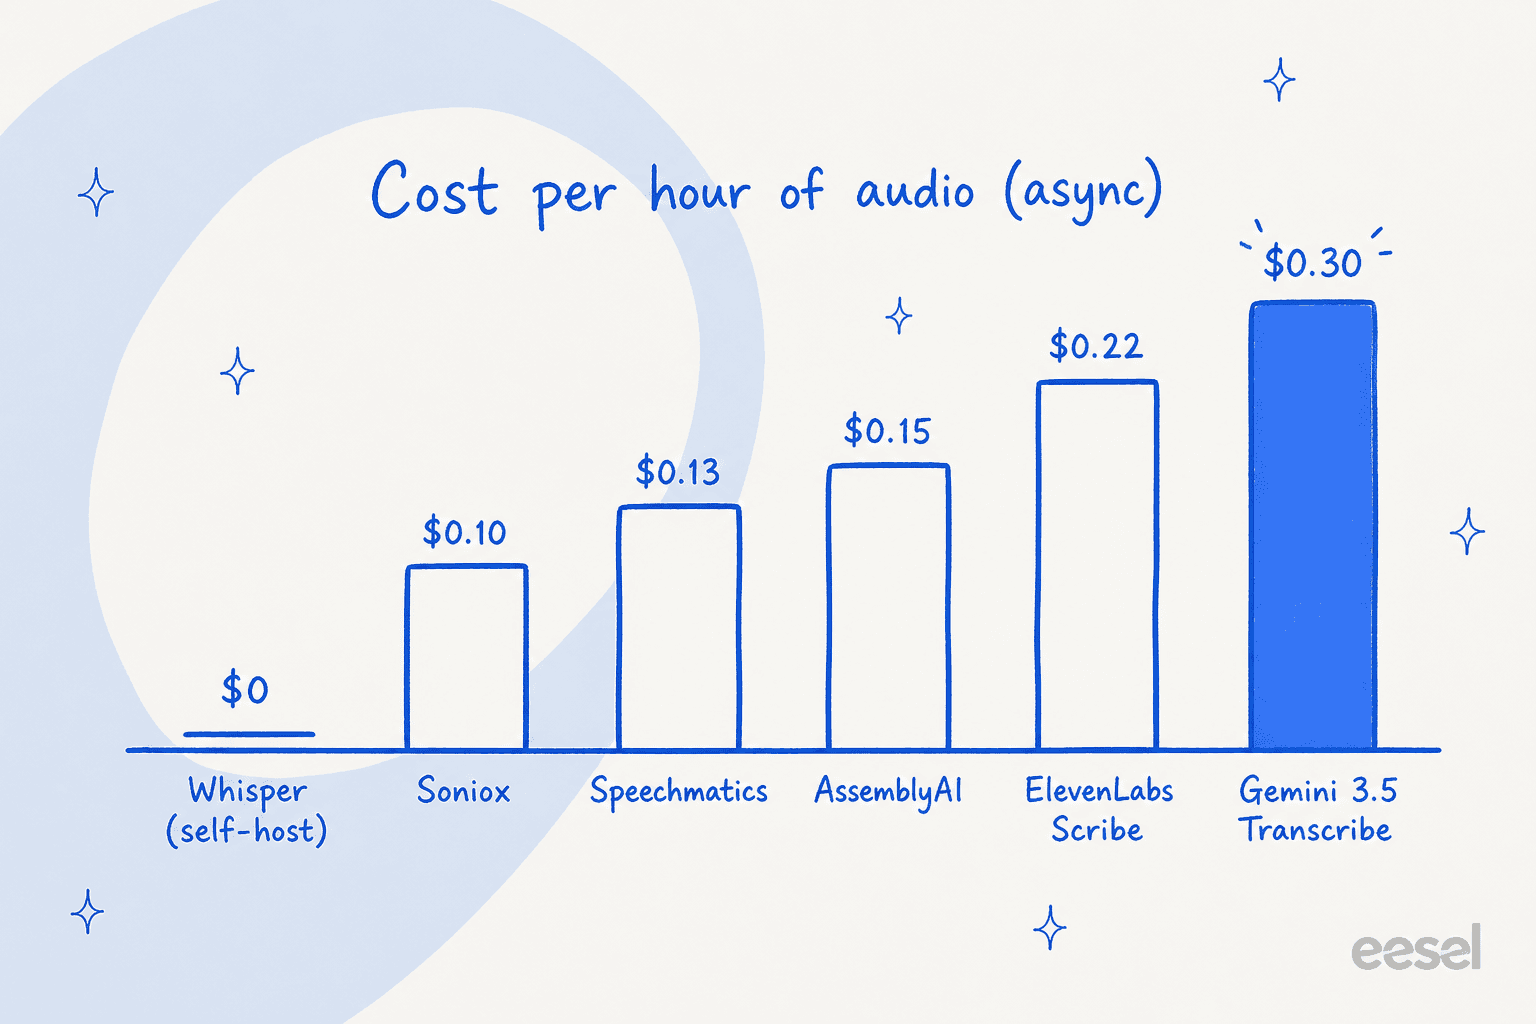
だからといってGeminiが悪いモデルというわけではありません。最適な選択は音声の種類しだいであり、実際の多くのユースケースでは、以下の代替のどれかのほうが合う、ということです。
比較の方法
開発の判断を実際に左右する観点で各サービスを評価しました。表向きの価格ではなく実際の1時間あたりコスト、話者分離と言語検出が込みか追加料金か、対応言語、リアルタイムストリーミングの有無、試せる無料枠です。各ベンダー自身の料金とドキュメントを読み、これらのモデルを並べて動かしている開発者の声も参考にしました。きれいなベンチマークの数値と、皆さんの実環境での結果は大きく違うことがあるためです。
詳細な解説の前に、まとめの表を示します。特に断りがない限り、価格は各ベンダー公式の、非同期(ファイル)文字起こしの従量課金レートです。
| ツール | 非同期の価格 | ストリーミング | 言語数 | 話者分離 | 無料枠 | 向いている用途 |
|---|---|---|---|---|---|---|
| Whisper | 0ドル(セルフホスト) | 自作 | 99 | 追加ライブラリ | オープンウェイト | 管理権限、分単位料金なし |
| Deepgram | 約0.29ドル/時(Nova-3) | あり | 30+ | +0.0020ドル/分 | 200ドル分のクレジット | リアルタイム音声エージェント |
| AssemblyAI | 0.15ドル/時(Universal-2) | あり | 99 | +0.02ドル/時 | 無料の従量課金 | 音声インテリジェンス |
| ElevenLabs Scribe | 0.22ドル/時 | 0.39ドル/時 | 90+ | 最大32人 | 無料枠あり | 最高精度、多人数 |
| Speechmatics | 0.129ドル/時から | 0.24ドル/時から | 55+ | 込み | 100ドル分のクレジット | アクセントと方言 |
| Soniox | 約0.10ドル/時 | 約0.12ドル/時 | 60+ | 込み | 無料クレジット | マネージドAPIで最安 |
| Cloud Speech-to-Text | 0.003ドル/分(バッチ) | 0.016ドル/分 | 125+ | 込み | GCPの300ドル分クレジット | すでにGCPを使うチーム |
| Rev AI | 0.20ドル/時 | あり | 57+ | 込み | 無料トライアル | アクセント全般の精度、HIPAA |
| Gemini 3.5 Transcribe | 約0.30ドル/時 | 約0.54ドル/時 | 85+ | 最大3人 | 無料枠あり | 単一話者のディクテーション |
1. OpenAI Whisper
向いている用途: 完全な管理権限、分単位料金への縛りなし、または無料で始めたいチーム。
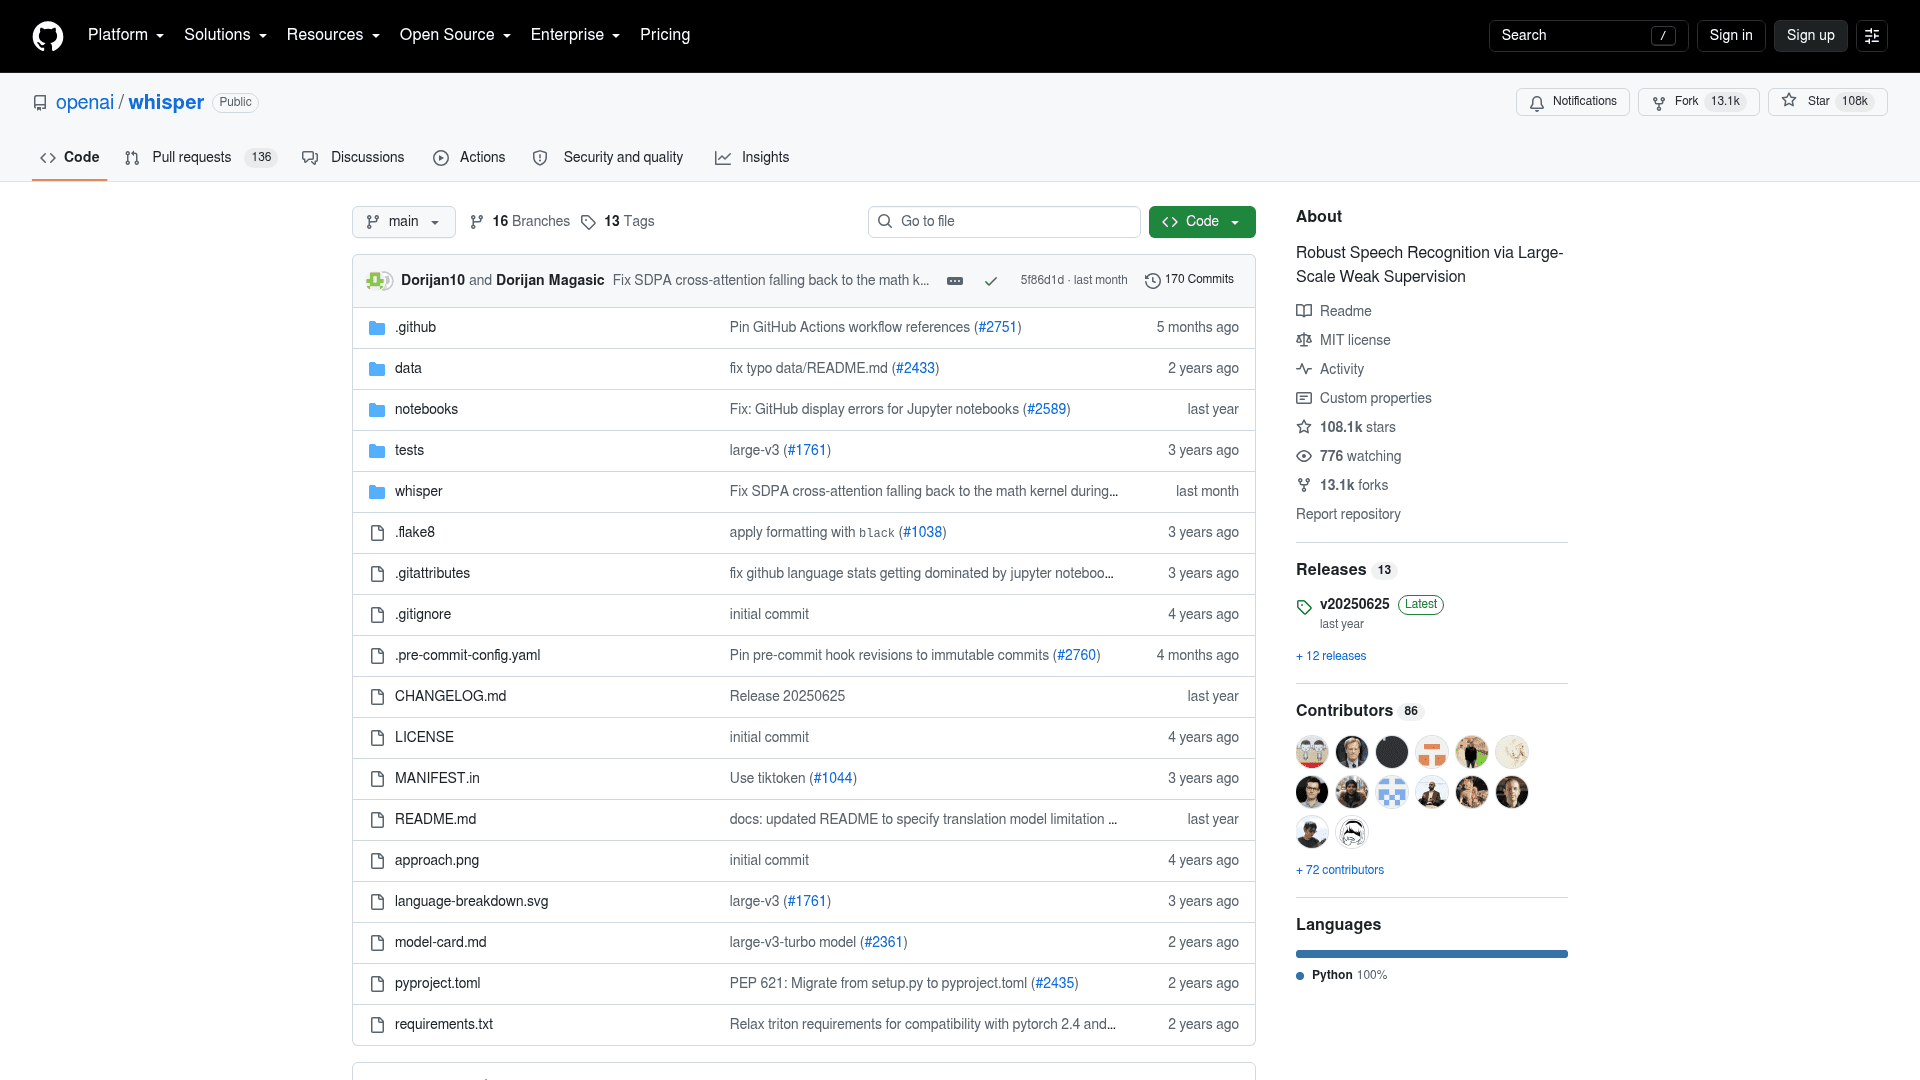
Whisperは、オープンな音声認識の期待値を塗り替えたモデルです。MITライセンスで、GitHubのスターは108,000を超え、自らを「Robust Speech Recognition via Large-Scale Weak Supervision」と説明しています。重みが公開されているので、自分のハードウェアで計算コストだけで動かせ、分単位のAPI料金もなく、データがインフラの外に出ることもありません。この最後の点が、プライバシーを重視する多くのチームがここから始める理由です。
コミュニティで人気が続くのには理由があります。
"Whisper Large-v3 is still the most stable open model across diverse domains. Great accuracy, predictable output, and decent handling of accents."

長所: セルフホストなら無料、オープンウェイト、多言語で高精度、ツールやファインチューニングの豊富なエコシステム、完全オフラインで動作。
短所: セルフホストは本格的なエンジニアリング作業です(GPU、バッチ処理、スケーリング)。話者分離や単語単位のタイムスタンプは組み込まれておらず、追加のライブラリが必要です。また、無音やノイズの多い区間でテキストを幻覚的に生成することでも知られています。インフラを運用したくない場合は、OpenAI自身のマネージドGPT-Transcribe APIが、非同期で1分あたり約0.0045ドル(1時間あたり約0.27ドル)、ライブストリーミングで1分あたり0.017ドルです。
評価: 利便性よりも管理とコストを重視する人にとって、Whisperは定番です。ホストするエンジニアリング力があれば、事実上無料でプライベートに使えます。なければ、OpenAIのマネージドエンドポイントで運用負担なしに同じ系統のモデルを使えます。多くのチームは、単語タイムスタンプにWhisper、テキスト補正にチャットモデルという併用をしています。
2. Deepgram
向いている用途: リアルタイム音声エージェントと、大規模な低遅延ストリーミング。
Deepgramは、速度のために作られたASRの専門企業です。Twilio、Cloudflare、Vapiなどの音声基盤を支えており、アーキテクチャ全体が低遅延ストリーミングに最適化されています。ライブ音声エージェントにまさに必要なものです。現行のNova-3モデルは、単一言語ストリーミングで1分あたり0.0048ドル(1時間あたり約0.29ドル)で、開始時に200ドルの無料クレジットがあります。
各社を比較する開発者は、Deepgramを最も精度が高いというより、速いサービスだと見る傾向があります。
"AssemblyAI and Speechmatics too, who both have much greater accuracy - especially in real-time for Speechmatics. Deepgram are only fastest at..."
長所: 優れたストリーミング遅延、高い同時接続性、規制業界向けのセルフホスト、明快な分単位の料金表。
短所: オプションが積み上がります。話者分離は1分あたり0.0020ドルの追加で、伏せ字処理やキーターム指定はさらに費用がかかります。難しい音声での生の精度は、ユーザーテストによっては精度トップ勢に及びません。
評価: リアルタイム音声を作るなら、Deepgramは真っ先に挙がる名前です。Gemini 3.5 Transcribe Liveのユースケースに最も近く、ストリーミングを低遅延の妥協ではなく第一級の機能として扱っています。速度より精度が重要なファイルのバッチ処理では、決める前にAssemblyAIやScribeと比べてテストすることをおすすめします。
3. AssemblyAI
向いている用途: 文字起こしと音声インテリジェンスを1つのAPIで使いたいチーム。
AssemblyAIは、高品質な文字起こしに、感情分析、トピック検出、要約、安全ガードレールといった多くの「音声インテリジェンス」機能を組み合わせ、同じAPIで提供します。Universal-2モデルは99言語で1時間あたり0.15ドル、新しいUniversal-3.5 Proは1時間あたり0.21ドルで、ネイティブのコードスイッチングと、18言語での過去最高精度の話者分離を備えます。AssemblyAIは、Whisperの92.4%に対して94.1%と、より高い単語正解率を掲げています。
長所: ファイルで高精度、Universal-2は99言語に対応、サポートチケットの業務に役立つインテリジェンス層、無料枠付きのセルフサービス時間単価。
短所: 追加機能は従量課金です。話者分離は1時間あたり0.02ドル、キーターム指定はProモデルで1時間あたり0.05ドルが加算されます。最上位のUniversal-3.5 Proは18言語に限られるため、幅広い多言語の用途ではUniversal-2を使い続けることになります。
評価: 生の文字起こし以上のものがほしいなら、AssemblyAIが最適です。通話の要約、感情のフラグ付け、トピックの抽出が必要な製品では、文字起こしモデルを別のLLMの工程につなぐよりも、1回の呼び出しで済ませるほうが優れています。純粋な精度でもトップ勢に並び、無料の従量課金枠で自分の音声と比較しやすくなっています。
4. ElevenLabs Scribe
向いている用途: 最高水準の精度と、多人数の音声。
ElevenLabsは音声生成で名を上げましたが、Scribeはそれ自体が本格的な音声認識モデルです。98%以上の精度、90以上の言語、そして目を引く数字として最大32人の話者分離を掲げており、Geminiの3人より桁違いです。Scribe v1とv2は1時間あたり0.22ドルで、リアルタイムモデルのScribe v2 Realtimeは1時間あたり0.39ドル、遅延は約150msです。
価格と精度のバランスが支持を集めています。文字起こしを仕事にしている開発者が、Geminiと比較して計算しました。
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."

長所: クリーンな音声で精度トップ、大規模な会議にも実際に対応できる話者分離、幅広い言語対応、リアルタイムの選択肢。
短所: 1時間あたりの価格は、Soniox、Speechmatics、AssemblyAIの基本ティアより高めです。音声認識は音声生成の会社の中の1製品なので、ドキュメントやコミュニティはTTS寄りです。
評価: 「大勢が話していても、言葉を正確に取りたい」が基準なら、まずScribeから始めます。32人の話者分離だけでも、会議やパネルの文字起こしでは明らかな答えです。Gemini 3.5 Transcribeが最も苦手とするまさにその場面です。
5. Speechmatics
向いている用途: 幅広いアクセントや方言への対応と、エンタープライズ導入。
Speechmaticsは、精度とアクセントの専門企業です。55以上の言語と方言をカバーし、「over 4 billion people」を正確に文字起こしできると打ち出しています。通話者が皆同じ標準アクセントで話すわけではない場合に重要な、アクセント対応の主張です。バッチのMelia 1ティアは1時間あたり0.129ドルから、リアルタイムの標準ティアは1時間あたり0.24ドルで、100ドルの無料クレジットと、月500時間超で20%割引があります。
精度をめぐる議論では、特にリアルタイムで、より難しい課題であるにもかかわらず、一貫して上位に名前が挙がります。
長所: アクセントと方言への強い対応、競争力のあるバッチ料金、別料金ではなく込みの話者分離、エンタープライズ向けのオンプレミス導入。
短所: ティア構成(Melia 1、Standard、Enhanced、バッチとリアルタイムごと)を理解するのに少し時間がかかります。見出しの0.129ドルは最安のMelia 1ティアの価格なので、予算を立てる前にティアを確認してください。
評価: 音声が言語的に入り組んでいるとき、つまりアクセントが混在している、方言がある、実際のコールセンター録音のような場合に、私が真っ先に選ぶのがSpeechmaticsです。Geminiのスマート文字起こしが、残したかった話者の言い回しをこっそり「訂正」しているなら、アクセントを忠実に扱うことを軸に作られたモデルのほうが安全です。
6. Soniox
向いている用途: 機能込みでマネージドAPIとして最安。
Sonioxはコストパフォーマンスで勝負するサービスで、それを隠していません。音声認識は非同期で1時間あたり約0.10ドル、リアルタイムで1時間あたり0.12ドルで、60以上の言語に対応します。差別化の核は数字だけではありません。話者分離、言語識別、スマートフォーマット、さらには翻訳まで、追加料金ではなくこの時間単価に含まれています。Sonioxは、リアルタイムでGoogleの約4.5分の1、Azureの8分の1のコストだとうたっています。
長所: ここで最も低いマネージド価格、すべて込み(話者分離や言語検出の追加料金なし)、同じモデルでリアルタイムとバッチ、同じ呼び出しで60以上の言語への翻訳。
短所: DeepgramやGoogleに比べて小規模で新しい名前なので、第三者のベンチマークやブランド認知が少なめです。マーケティング上の計算を信じるのではなく、自分の音声で試す必要があります。
評価: 大量でコストに敏感な文字起こしなら、この比較で最も鋭い選択肢がSonioxです。話者分離と翻訳を1時間あたり0.10ドルの定額に含めるのは、それらを別料金にするGeminiやDeepgramに対する大きな強みです。自分の録音で精度が保てるなら、規模が大きいほど節約が一気に積み上がります。
7. Google Cloud Speech-to-Text(Chirp 3)
向いている用途: すでにGoogle Cloudを使っているチームと、最安のバッチ料金。
ここが興味深い点です。GoogleのCloud Speech-to-Textは、Gemini 3.5 Transcribeが後継として作られたモデルですが、いまも現役です。Chirp 3基盤モデルは125以上の言語に対応し、料金は標準認識の1分あたり0.016ドルから、ダイナミックバッチの1分あたり0.003ドルまであります。これはこの比較全体で最安のバッチ料金です。新規顧客には300ドル分のGoogle Cloudクレジットも付きます。
長所: 大規模バッチで最安の1分あたり0.003ドル、最も広い言語対応、Google Cloud全体との深い統合、エンタープライズ品質のツール。
短所: 1分あたり0.016ドルの標準リアルタイム認識は、Gemini自身のファイルモデルより高価です。単一のすっきりしたエンドポイントより設定の手間が多く、Googleが新規の用途をGemini 3.5 Transcribeへ誘導していることも明らかです。
評価: すでにスタックがGoogle Cloudにある、または1分あたり0.003ドルが効く巨大なバッチ処理を回すなら、Chirp 3は十分に合理的な選択で、新しく華やかなGeminiモデルより安くなることもあります。比較するときは、バッチはバッチ同士、リアルタイムはリアルタイム同士で見てください。
8. Rev AI
向いている用途: アクセント全般での精度、HIPAA準拠、人による文字起こしへの切り替え。
Rev AIは、人手の文字起こし会社Revから生まれ、その実績を強みにしています。モデルは人が検証した700万時間以上の音声で学習されており、「ethnic background, nationality, gender, and accent」を超えた公平性を打ち出しています。57以上の言語に対応し、SOC 2、HIPAA、GDPR、PCIに準拠して稼働率99.99%を掲げ、機械による文字起こしは1時間あたり0.20ドル、ターボモデルは1時間あたり0.10ドル、人手が必要なときの人による文字起こしは1分あたり1.99ドルです。
長所: アクセントや難しい音声でも安定した精度、規制業界向けの強いコンプライアンス体制、最も難しいファイルは人による文字起こしにエスカレーションできる選択肢。
短所: ブランドはいまも人手の文字起こしで知られているため、開発者向けAPIはDeepgramやAssemblyAIほどコミュニティの注目を集めていません。ストリーミングやプレミアムモデルは、基本料金の0.10〜0.20ドルより高くなります。
評価: コンプライアンスや声の違いを超えた公平性が譲れない場合、あるいは重要なファイルで人手品質の文字起こしが時々必要な場合に、Rev AIが最適です。HIPAA対応と人へのエスカレーション経路は、モデルだけの提供元の多くにはないもので、医療や法務のワークフローに自然に合います。
実際の選び方
正直なところ、唯一の勝者はなく、あるのは音声に合うかどうかだけです。8つすべてを見たうえで、判断までの最短ルートを示します。
これらの上で開発する人たちを見てきた経験から、経験則を2つ挙げます。1つ目は、パイプラインを固める前に、必ず自分の録音で2〜3種類を試すことです。ベンチマークのWERと、ノイズやアクセント、混線のある皆さんの音声でのWERはまったく別物で、この点はGemini 3.5 Transcribeレビューでも強調しました。2つ目は、追加機能も数に入れることです。話者分離と言語検出を除いた表向きの料金は、それらを含む料金とは比べられません。だからこそ、オプションを有効にすると、定額で1時間あたり0.10ドルのSonioxが「より安い」モデルを上回ることがあります。
文字起こしが終わり、解決が始まるところ
ここが、モデルの比較記事だけでは抜け落ちがちで、私が最も大切にしている部分です。このリストのどのツールも同じ仕事をします。音声をテキストに変えることです。最良のものがそれを完璧にこなしても、手元に残るのは文字起こしです。そして、顧客の電話やボイスメモの文字起こしは答えではなく、答えの始まりにすぎません。
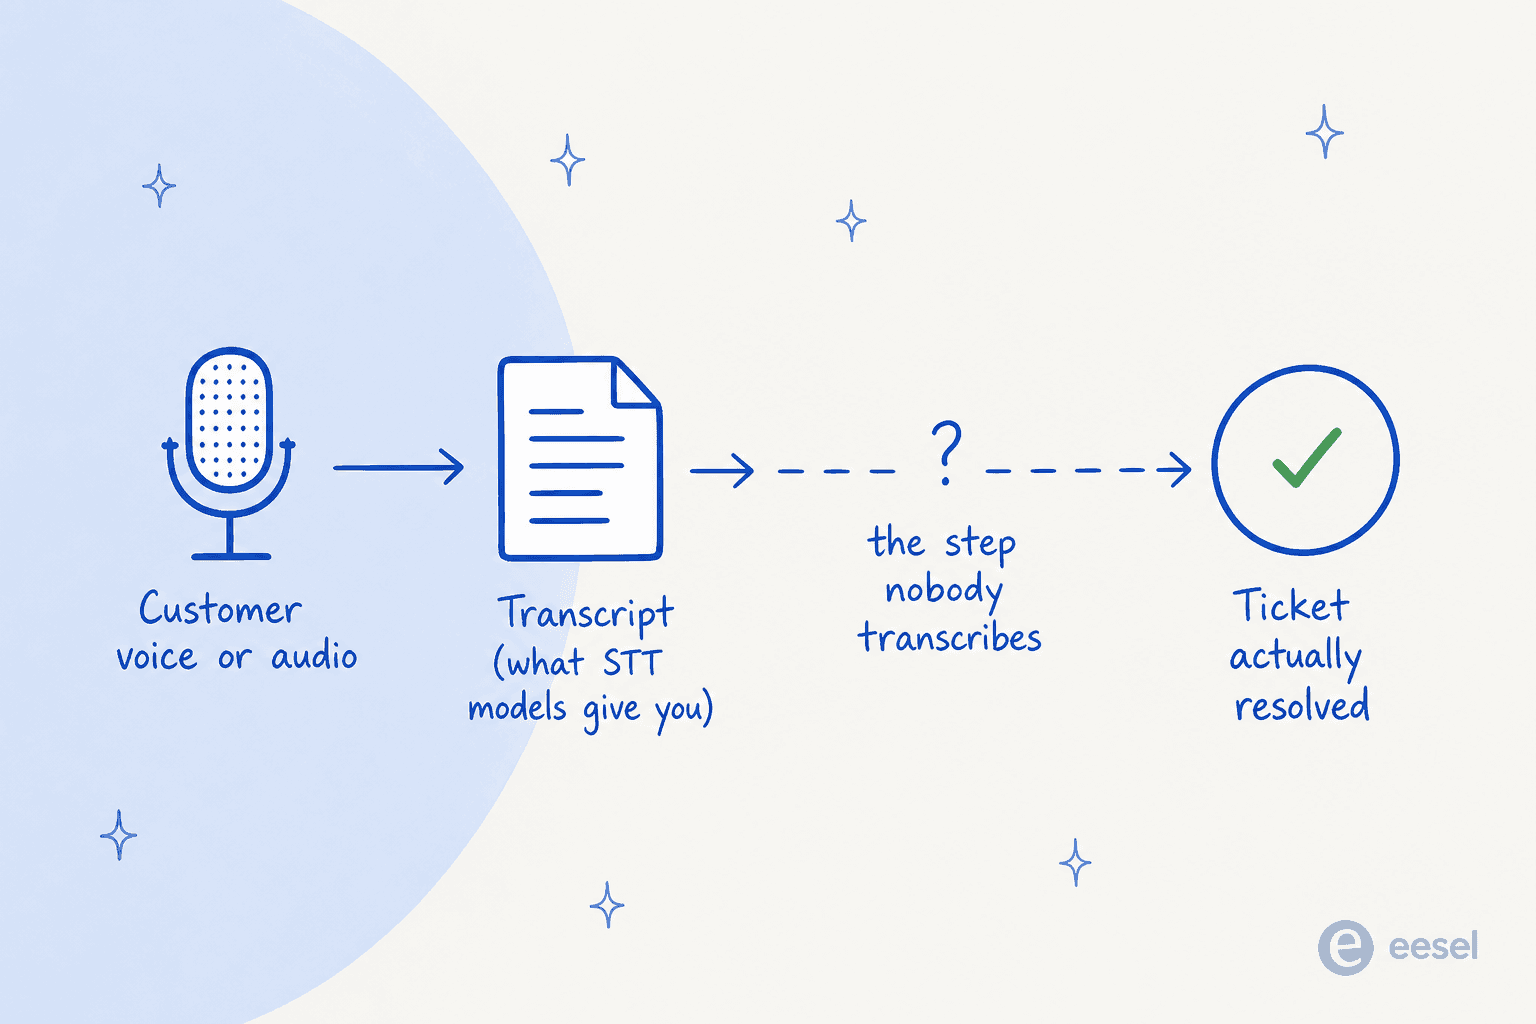
そのテキストを読み、顧客が本当に必要としていることを理解し、適切な情報を引き出して、チケットを解決する存在がまだ必要です。私が取り組んでいるのは、この解決のレイヤーです。ここ数年、実際のサポートキューで動くAIに関わってきましたが、パターンは変わりません。言葉を正しく取るのは最低条件で、それに正しく対応するのが難しい部分です。文字起こしモデルは言葉をくれますが、返金ポリシーも、注文システムも、その顧客が直近で開いた3件のチケットも知りません。
これがモデルとチームメイトの違いです。Gemini 3.5 Transcribe、Whisper、Deepgramなどは、狭い仕事に優れたモデルです。eeselはチームメイト型のプラットフォームで、特定の仕事向けにすぐ働けるAIチームメイトを採用できます。現在のラインナップには、AIヘルプデスクのチームメイトとAIブログライターがあります。ヘルプデスクのチームメイトは、すでにお使いのヘルプデスク、Zendesk、Freshdesk、Gorgiasに接続し、既存のキューに加わります。ヘルプセンターと過去のチケットで学習済みです。
音声・チャットのチケットにeeselを試す
チームが音声やチャットのチケットに追われていて文字起こしモデルを比較しているなら、文字起こしは仕事の半分にすぎないことを思い出してください。eeselのAIヘルプデスクのチームメイトは、Gemini 3.5 Transcribeのようなモデルが終わるところから引き継ぎます。顧客のメッセージを読み、返信を下書きまたは送信し、ループを閉じます。1,000以上の連携に対応しています。
最初に挙げたいのはシミュレーションモードです。AIが実際の顧客に触れる前に、過去の数千件のチケットで実行し、どのように返信したかを正確に確認できます。どの文字起こしモデルにも私が勧める「まず自分のデータで試す」というアドバイスを、製品に組み込んだものです。料金は月額固定で、500クレジットで月299ドルから(1チケットまたは1チャットにつき1クレジット)、ユーザー数による課金はなく、カード不要で100クレジットの無料プランもあります。問題を賢く文字起こしすることと、実際に解決することの違いがここにあります。