

Gemini 3.5 Transcribe est le nouveau modèle de reconnaissance vocale dédié de Google, annoncé vers le 26 août 2026 et construit sur la compréhension audio de Gemini. Il existe en deux versions : gemini-3.5-transcribe pour les fichiers préenregistrés (jusqu'à une heure, avec diarisation et horodatages de mots) et gemini-3.5-transcribe-live pour le streaming en temps réel via WebSockets (sessions de 10 minutes, sans diarisation).
Le prix fait la une : environ 0,005 $ la minute pour le modèle fichier et 0,009 $ la minute pour le live, soit moins que le niveau standard de Cloud Speech-to-Text v2 de Google (0,016 $/min). Google annonce un taux d'erreur de mots de 2,6 % en anglais hors streaming (mesuré par Artificial Analysis), et le modèle est présenté comme le successeur de Chirp 3.
Le verdict honnête : les chiffres de laboratoire sont excellents, mais les premiers retours pratiques sont partagés. Les fans le décrivent comme le meilleur modèle de dictée qu'ils aient utilisé ; les détracteurs disent que la transcription intelligente peut "simplifier" des formulations précises, et que la diarisation cale au-delà de trois locuteurs. Un point de statut à connaître : la liste des modèles de Google l'étiquette "Stable", alors que le blog de lancement parle de "public preview". Si vous êtes une équipe support et envisagez cela pour des tickets vocaux, rappelez-vous que la transcription n'est que la couche d'entrée : il faut encore quelque chose pour résoudre réellement le ticket, et c'est là qu'intervient un coéquipier IA helpdesk.
Qu'est-ce que Gemini 3.5 Transcribe ?
Pendant quelques années, pour transformer de l'audio en texte avec les modèles de Google, vous aviez deux options : la Speech-to-Text API de Google Cloud (la gamme Chirp), ou simplement confier un fichier audio à un modèle de chat Gemini généraliste en lui demandant de le transcrire. Gemini 3.5 Transcribe est la première fois que Google publie un modèle de marque Gemini conçu spécifiquement pour cette tâche, aux côtés du reste de la gamme Gemini 3.
Google le décrit comme "a speech-to-text model based on Gemini's audio understanding capabilities" offrant une transcription à faible latence avec détection de langue par énoncé, diarisation des locuteurs, horodatages au niveau du mot, transcription intelligente et biais de vocabulaire personnalisé. En clair : il écoute l'audio et renvoie un texte propre, formaté et annoté par locuteur, dans plus de 85 langues, sans que vous ayez à assembler un pipeline vous-même.
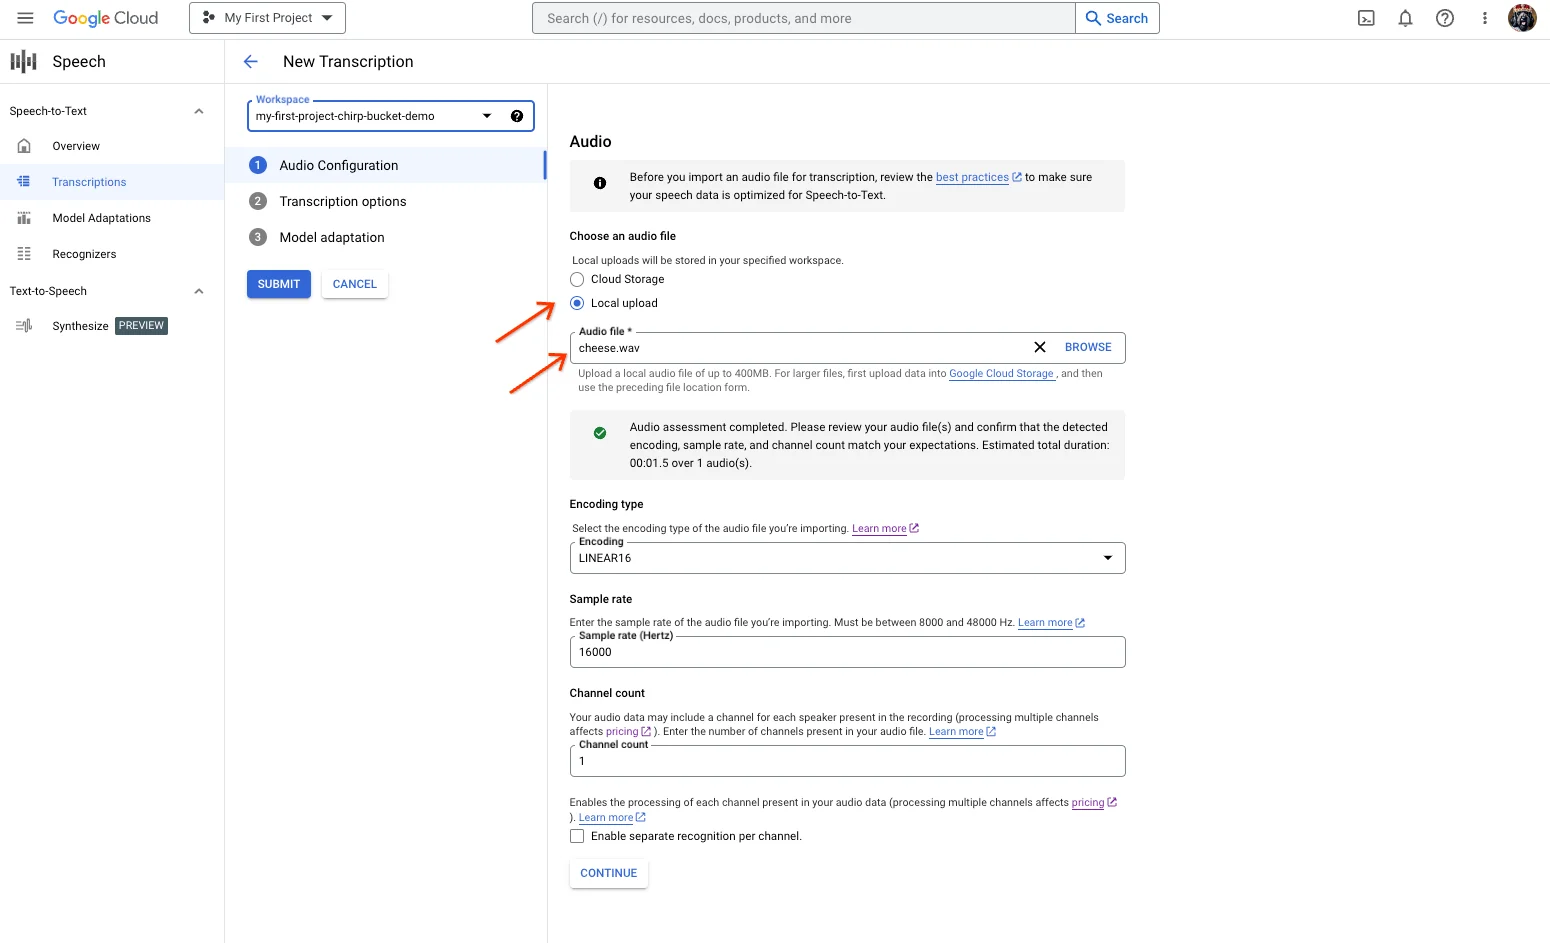
Si vous avez déjà utilisé la console de transcription de Google Cloud, le déroulement vous sera familier : vous pointez vers un fichier audio et choisissez vos options :
Un point à signaler d'emblée, car les documents de Google ne s'accordent pas entre eux : la page de présentation des modèles étiquette Gemini 3.5 Transcribe "New Stable", alors que l'article de blog de lancement dit qu'il est "in public preview" pour les développeurs et les entreprises. Il est déjà présent dans des produits grand public, Rambler dans Gboard pour Android, l'application Gemini sur macOS et "bientôt dans Chrome", selon le même article. Considérez-le comme quasi prêt pour la production, mais pas totalement stabilisé.
Les deux modèles : fichier vs live
Le plus important à comprendre avant d'écrire une ligne de code : "Gemini 3.5 Transcribe" regroupe en réalité deux endpoints, qui se comportent très différemment.
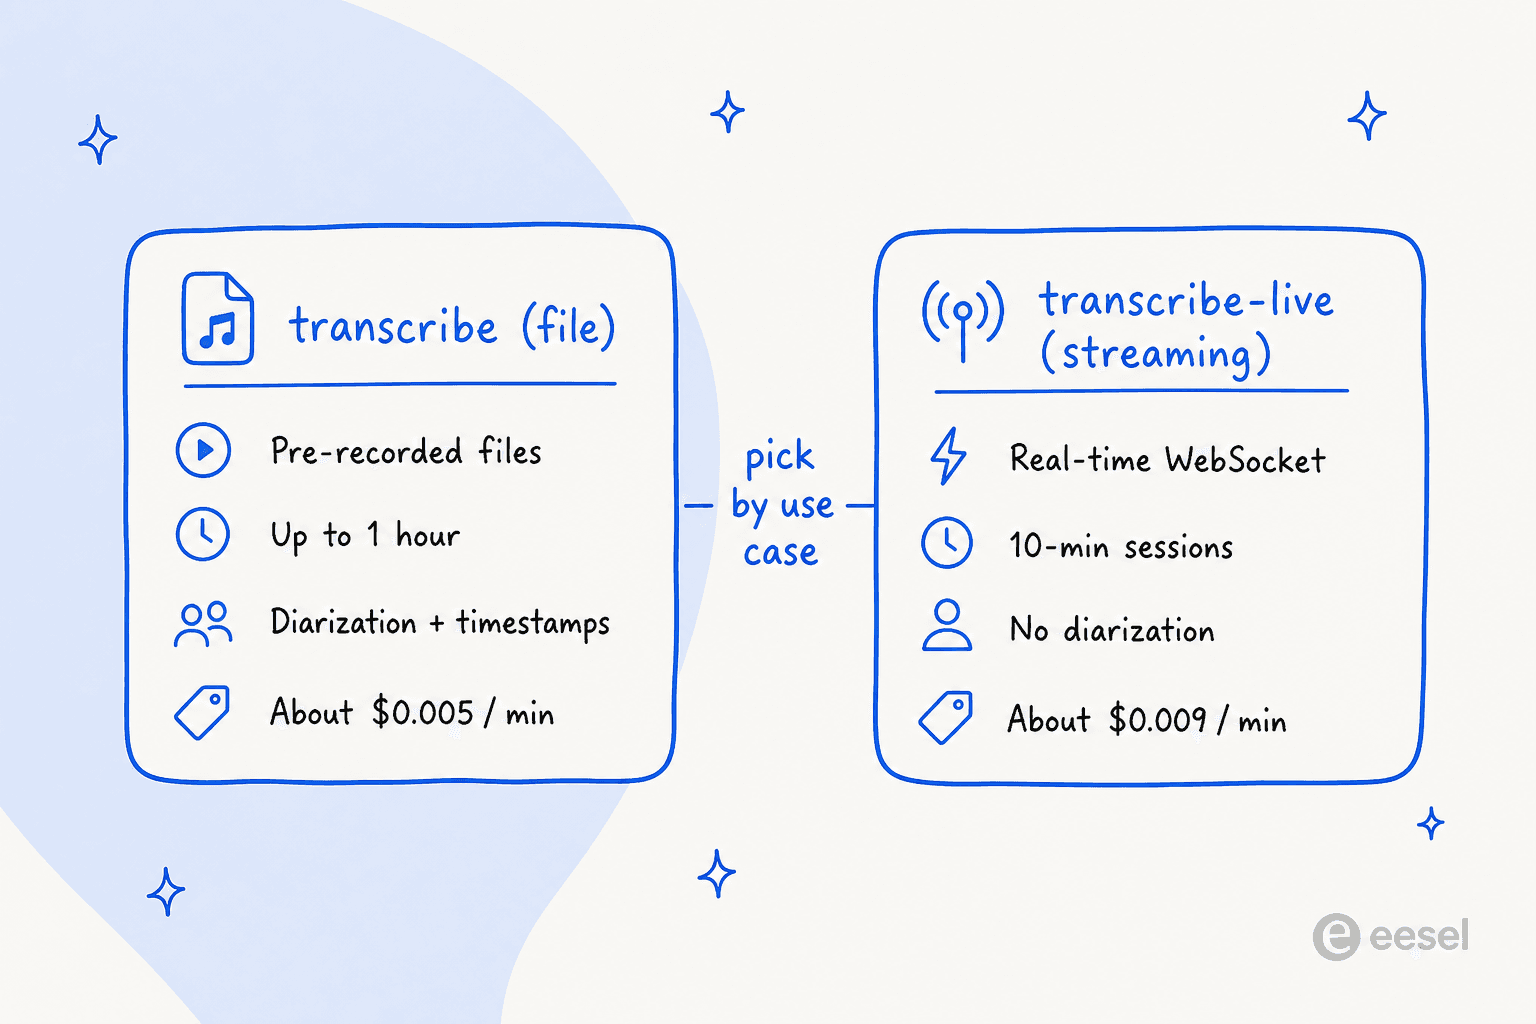
Le modèle fichier gemini-3.5-transcribe est celui qu'on choisit quand on a déjà un enregistrement, un appel de support, un podcast, une réunion, et qu'on veut la transcription complète avec étiquettes de locuteurs. Le modèle gemini-3.5-transcribe-live sert à diffuser l'audio au fil de l'eau, comme pour des sous-titres en direct, où chaque seconde de latence supplémentaire se ressent. Voici le détail des fonctionnalités prises en charge :
| Fonctionnalité | gemini-3.5-transcribe (fichier) | gemini-3.5-transcribe-live (streaming) |
|---|---|---|
| Idéal pour | Audio préenregistré | Sous-titres en temps réel |
| Détection automatique de la langue | Plus de 85 langues, dont le mélange de langues en cours de session | Plus de 85 langues |
| Horodatages au niveau du mot | Pris en charge (réduit la précision) | Non pris en charge |
| Diarisation des locuteurs | Prise en charge (voir la réserve ci-dessous) | Non prise en charge |
| Biais de vocabulaire personnalisé | Jusqu'à 1 000 termes (idéal ≤100) | Jusqu'à 1 000 termes |
| Dictée intelligente et mise en forme | Pris en charge | Pris en charge |
| Durée audio max. | Jusqu'à 1 heure (30 min avec diarisation ou horodatages) | 10 minutes par session |
| Prix combiné | ~0,005 $ / min | ~0,009 $ / min |
La réserve sur la diarisation est celle à surveiller. Le tableau des fonctionnalités de la page du modèle de Google indique que le modèle fichier gère "up to 8 speakers (Attribution for 3+ speakers is experimental)", mais le blog d'annonce dit "up to three speakers". Dans tous les cas, le plafond fiable aujourd'hui est de trois, et je planifierais autour de ce chiffre, pas de huit.
Ce que fait vraiment la transcription intelligente
La fonctionnalité que Google met le plus en avant est la transcription intelligente, et il vaut la peine de la comprendre car elle est aussi à l'origine des plaintes les plus bruyantes. Une transcription brute de la parole humaine est brouillonne : on dit "euh", on commence une phrase, on s'arrête, on reprend, on marmonne des chiffres. La transcription intelligente nettoie tout cela automatiquement.
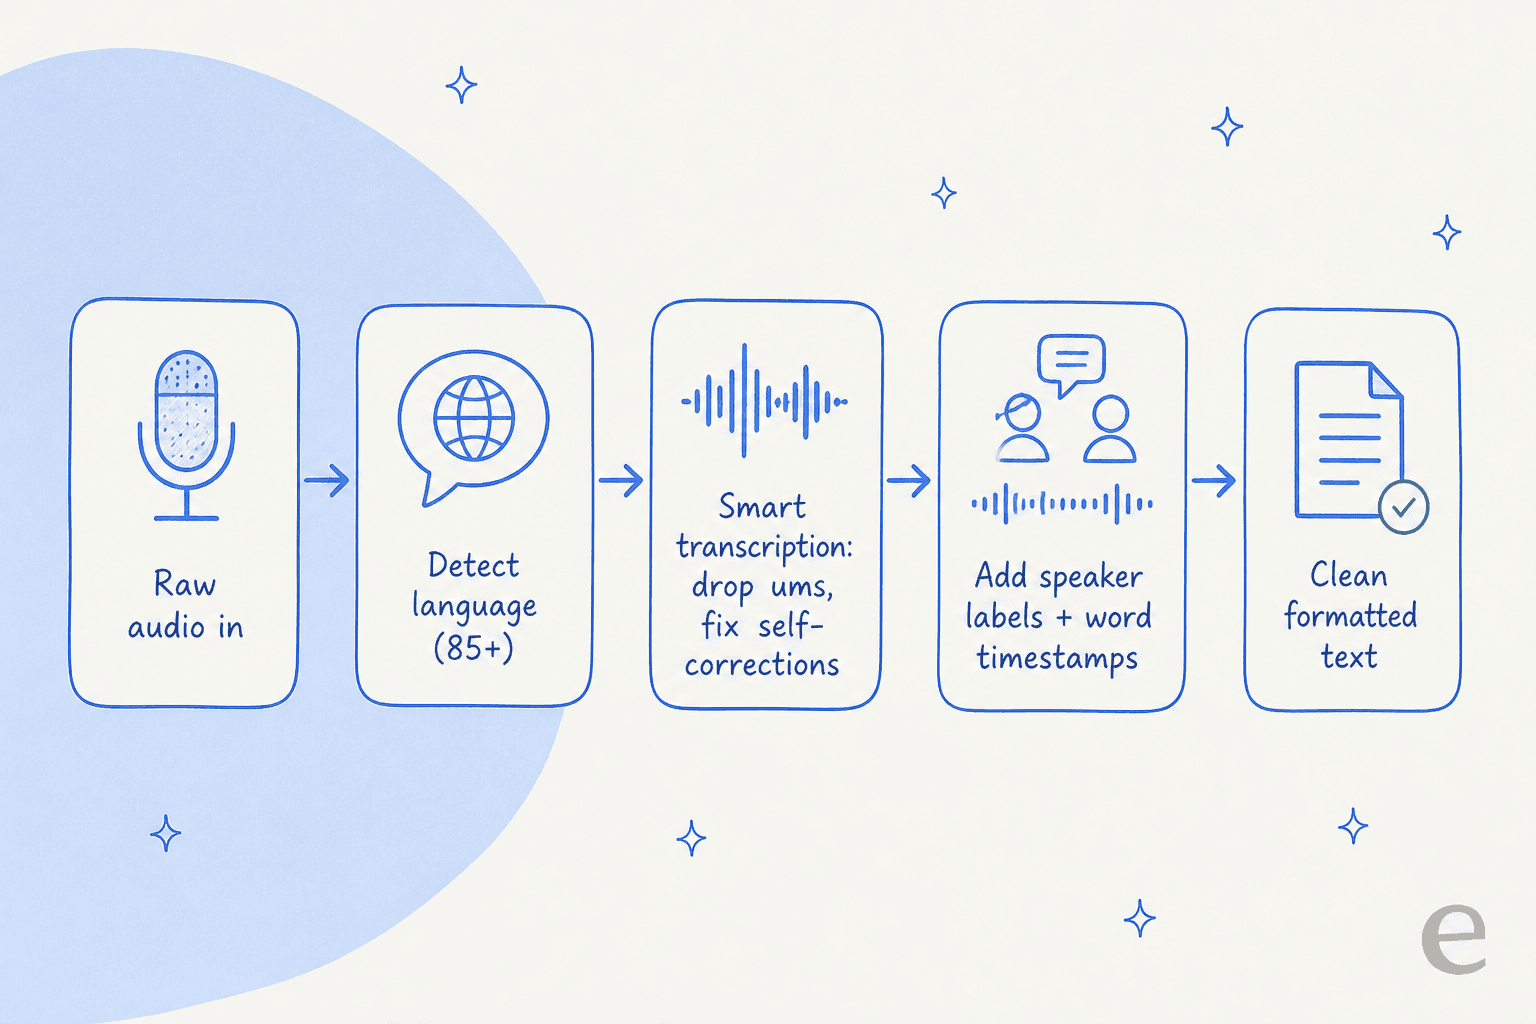
D'après l'article de lancement, elle gère les auto-corrections (quelqu'un dit "voyons-nous mardi, non, mercredi" et vous obtenez "mercredi"), supprime les mots parasites et applique une mise en forme adaptée à l'intention pour des éléments comme les chaînes alphanumériques. Pour dicter un e-mail ou nettoyer des notes de réunion, c'est le genre de chose pour laquelle les outils de dictée dédiés se font payer, donc l'avoir dans le modèle de base est utile.
Revers de la médaille : "nettoyer" relève du jugement, et le modèle n'est pas toujours d'accord avec vous sur ce qui est du bruit. Un développeur qui l'a testé sur un Pixel 11 Pro l'a formulé sans détour :
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."

Le bon modèle mental : la transcription intelligente est une fonctionnalité, pas une transcription neutre. Pour des besoins de fidélité littérale (juridique, recherche, tout ce qui exige les mots exacts), c'est un vrai compromis à peser.
Quelle est sa précision réelle ?
Sur le papier, les chiffres sont excellents. Google annonce les taux d'erreur de mots suivants, tous attribués à Artificial Analysis :
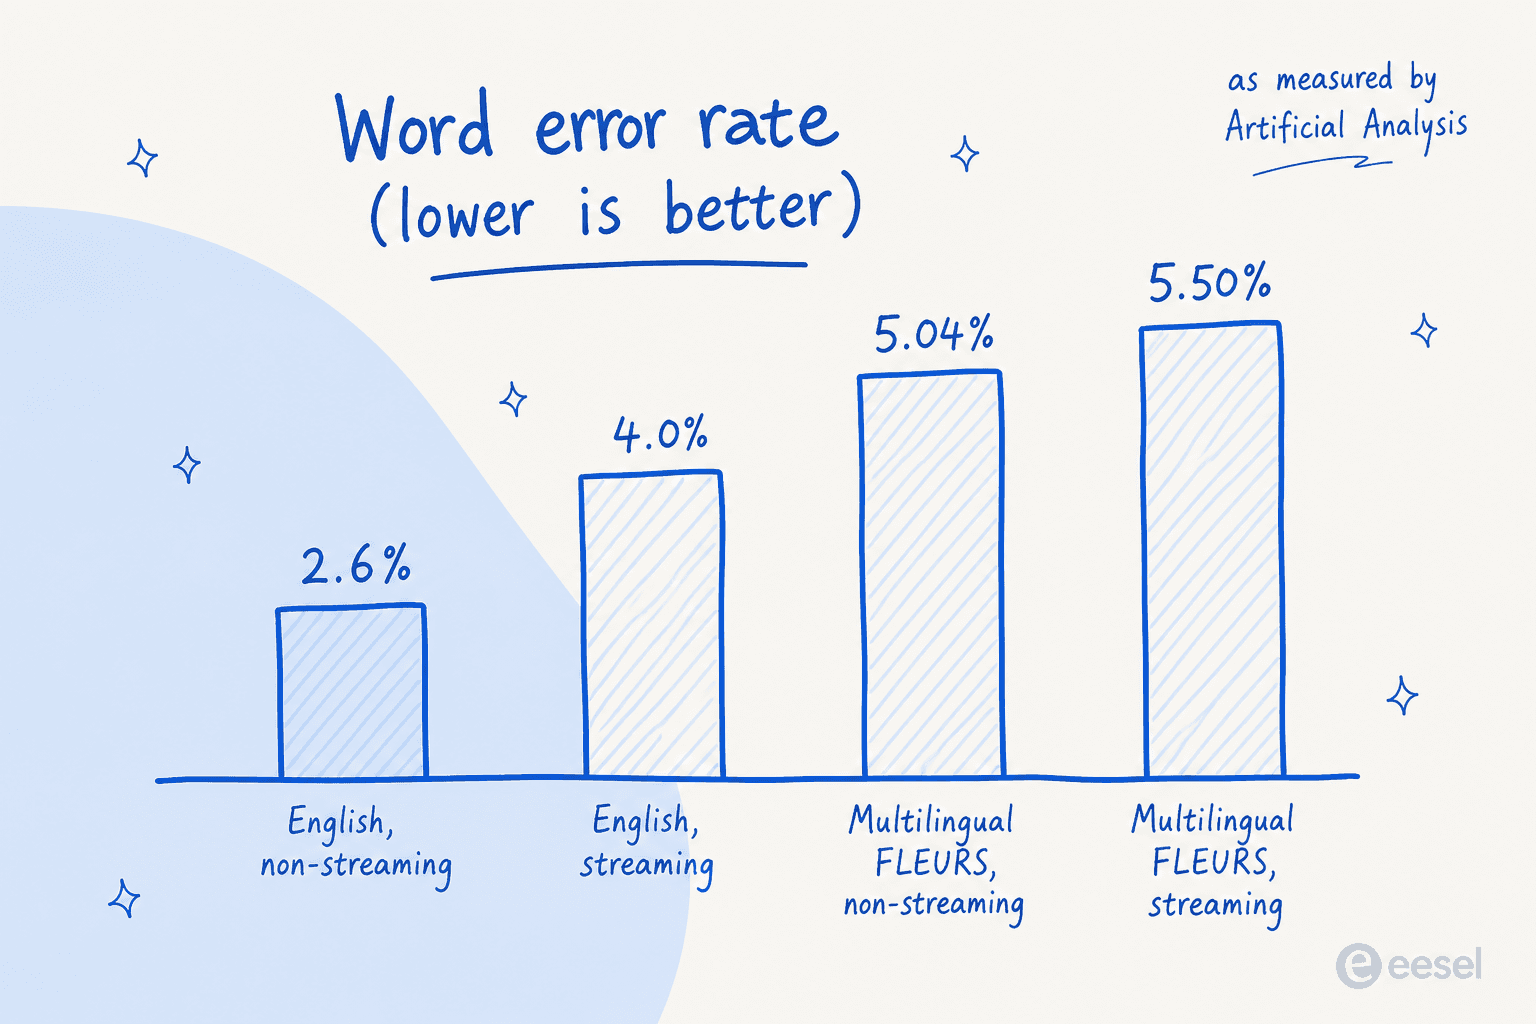
Un taux d'erreur de mots de 2,6 % en anglais hors streaming est très bon, environ un mot erroné sur quarante. Google affirme aussi que le temps jusqu'à la transcription finale s'améliore de 70 % par rapport à Chirp 3, mais cette présentation vient de Google lui-même, je la traiterais donc comme un chiffre constructeur plutôt qu'un benchmark indépendant.
Le signal le plus intéressant, c'est ce que disent les praticiens après usage. Et là, le tableau est partagé. Côté positif :
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."
Mais le fil de lancement sur Hacker News regorge de gens qui font leurs propres comparaisons et arrivent à d'autres conclusions. Certains préfèrent toujours Whisper, et quelques-uns ont trouvé de vraies lacunes :
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
Ce que j'en retiens : le WER sur un benchmark propre et le WER sur votre audio réel (appels bruyants, accents variés, voix qui se chevauchent) sont deux choses différentes. Les chiffres de laboratoire sont un bon début, pas une garantie. Si vous évaluez un modèle de transcription pour un usage réel, testez-le sur vos propres enregistrements avant de vous engager.
Tarifs de Gemini 3.5 Transcribe
Google n'a pas mis les prix dans l'annonce du modèle, ce qui a agacé les développeurs au point que l'un d'eux a publié les chiffres sur Hacker News lui-même. Voici le tableau complet, tiré de la page des tarifs, pour la Gemini Developer API :
| Modèle | Entrée audio | Sortie texte | Tarif combiné |
|---|---|---|---|
gemini-3.5-transcribe (fichier) | 2,00 $ / 1 M de tokens (~0,003 $/min) | 12,00 $ / 1 M de tokens (~0,002 $/min) | ~0,005 $ / min |
gemini-3.5-transcribe-live (streaming) | 3,50 $ / 1 M de tokens (~0,005 $/min) | 21,00 $ / 1 M de tokens (~0,004 $/min) | ~0,009 $ / min |
À titre de comparaison, la reconnaissance standard de Cloud Speech-to-Text v2 de Google démarre à 0,016 $/min et baisse avec le volume, tandis que son niveau de batch dynamique est à 0,003 $/min. Le nouveau modèle fichier de Gemini se place donc nettement sous la reconnaissance standard en temps réel, mais au-dessus de l'option batch la moins chère. Comparez des choses équivalentes (temps réel avec temps réel, batch avec batch) en faisant vos calculs.
En parlant de calculs, voici une calculatrice rapide. Indiquez combien d'heures d'audio vous traitez par mois et voyez à peu près ce que coûte chaque option :
Un exemple chiffré : une petite équipe qui transcrit 200 heures d'appels de support par mois paierait environ 60 $/mois avec le modèle fichier, contre environ 192 $ avec Cloud Speech-to-Text standard. À cette échelle, l'écart est réel mais pas énorme. La plus grosse question de coût est généralement ce que vous faites des transcriptions ensuite, pas la transcription elle-même.
Comment il se place face à Whisper, Deepgram et Scribe
Je veux rester prudent ici, car une comparaison équitable exige les chiffres de chaque éditeur, et la position honnête est que les vrais face-à-face sont menés par les utilisateurs, pas par moi. Plutôt qu'un tableau de spécifications que je ne peux pas entièrement sourcer, voici donc ce que constatent les personnes qui font réellement des tests A/B sur ces modèles.
Côté coût, la réaction se divise presque à égalité. Un développeur qui exploite whispermemos.com a fait le calcul et a apprécié ce qu'il a vu :
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
D'autres n'étaient pas convaincus que la précision soit assez proche :
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
La plainte la plus constante, et celle que je pèserais le plus si vous faites de la transcription de réunions, concerne la gestion de plusieurs locuteurs :
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
Et Whisper conserve des fidèles, en partie parce qu'il est gratuit à auto-héberger et en partie parce que beaucoup d'équipes ont déjà bâti des pipelines autour. Un schéma courant est l'hybride : Whisper pour des horodatages de mots précis, puis un modèle Gemini pour le texte lui-même. En bref, Gemini 3.5 Transcribe est une option managée solide et bien tarifée, pas un gagnant automatique face aux outils de reconnaissance vocale spécialisés. Le meilleur dépend fortement de votre audio et du besoin d'une diarisation fiable.
Où la transcription s'inscrit pour une équipe support
Voici un point à dire clairement, car il est facile à manquer : Gemini 3.5 Transcribe est de l'infrastructure. Il transforme l'audio en texte, un problème difficile qu'il résout bien. Mais la transcription d'un appel client ou d'un message vocal n'est pas une réponse, ce n'est que le début. Il faut encore que quelque chose lise ce texte, comprenne ce dont le client a besoin, aille chercher les bonnes informations et résolve le ticket.
Cette couche de résolution, c'est ce sur quoi je travaille. J'ai passé ces dernières années à aider à construire une IA qui opère sur des files de support en direct, et le schéma est toujours le même : bien saisir les mots est le minimum ; agir correctement dessus est le plus difficile. Un modèle de transcription vous donne les mots. Il ne connaît ni votre politique de remboursement, ni votre système de commandes, ni les trois derniers tickets ouverts par ce client.
C'est la différence entre un modèle et un coéquipier. Gemini 3.5 Transcribe est un modèle, brillant sur une tâche étroite. eesel est une plateforme de coéquipiers : vous recrutez des coéquipiers IA prêts à travailler pour des missions précises, et l'équipe actuelle comprend un coéquipier IA helpdesk et un rédacteur de blog IA. Le coéquipier helpdesk se branche sur le helpdesk que vous utilisez déjà, Zendesk, Freshdesk, Gorgias, et rejoint la file existante, entraîné sur votre centre d'aide et vos anciens tickets.
Essayer eesel pour les tickets vocaux et chat
Si vous vous intéressez à la transcription parce que votre équipe croule sous les tickets vocaux ou chat, la transcription n'est que la moitié du travail. Le coéquipier IA helpdesk d'eesel prend le relais là où s'arrête un modèle comme Gemini 3.5 Transcribe : il lit le message du client, rédige ou envoie la réponse et boucle réellement le dossier, via plus de 1 000 intégrations.
Le point que je soulignerais d'abord est le mode simulation. Avant que l'IA ne touche un client réel, vous la lancez sur des milliers de vos propres tickets historiques et voyez exactement comment elle aurait répondu, sans actionner un interrupteur en espérant. Le tarif est un prix mensuel fixe, à partir de 299 $/mois pour 500 crédits (1 crédit par ticket ou chat) sans frais par utilisateur, et il existe un plan gratuit avec 100 crédits, sans carte. C'est la différence entre une transcription intelligente d'un problème et sa résolution réelle.