

En bref
Gemini 3.5 Transcribe est le premier modèle de reconnaissance vocale de Google sous la marque Gemini, et c'est une option gérée solide et bien tarifée, à environ 0,005 $ la minute pour le modèle de fichiers avec un taux d'erreur de mots de 2,6 % sur de l'anglais propre. Mais ce n'est pas le choix automatique, et deux choses poussent à chercher ailleurs : la transcription intelligente réécrit vos mots exacts pour les « nettoyer », et la diarisation devient fragile au-delà de trois locuteurs.
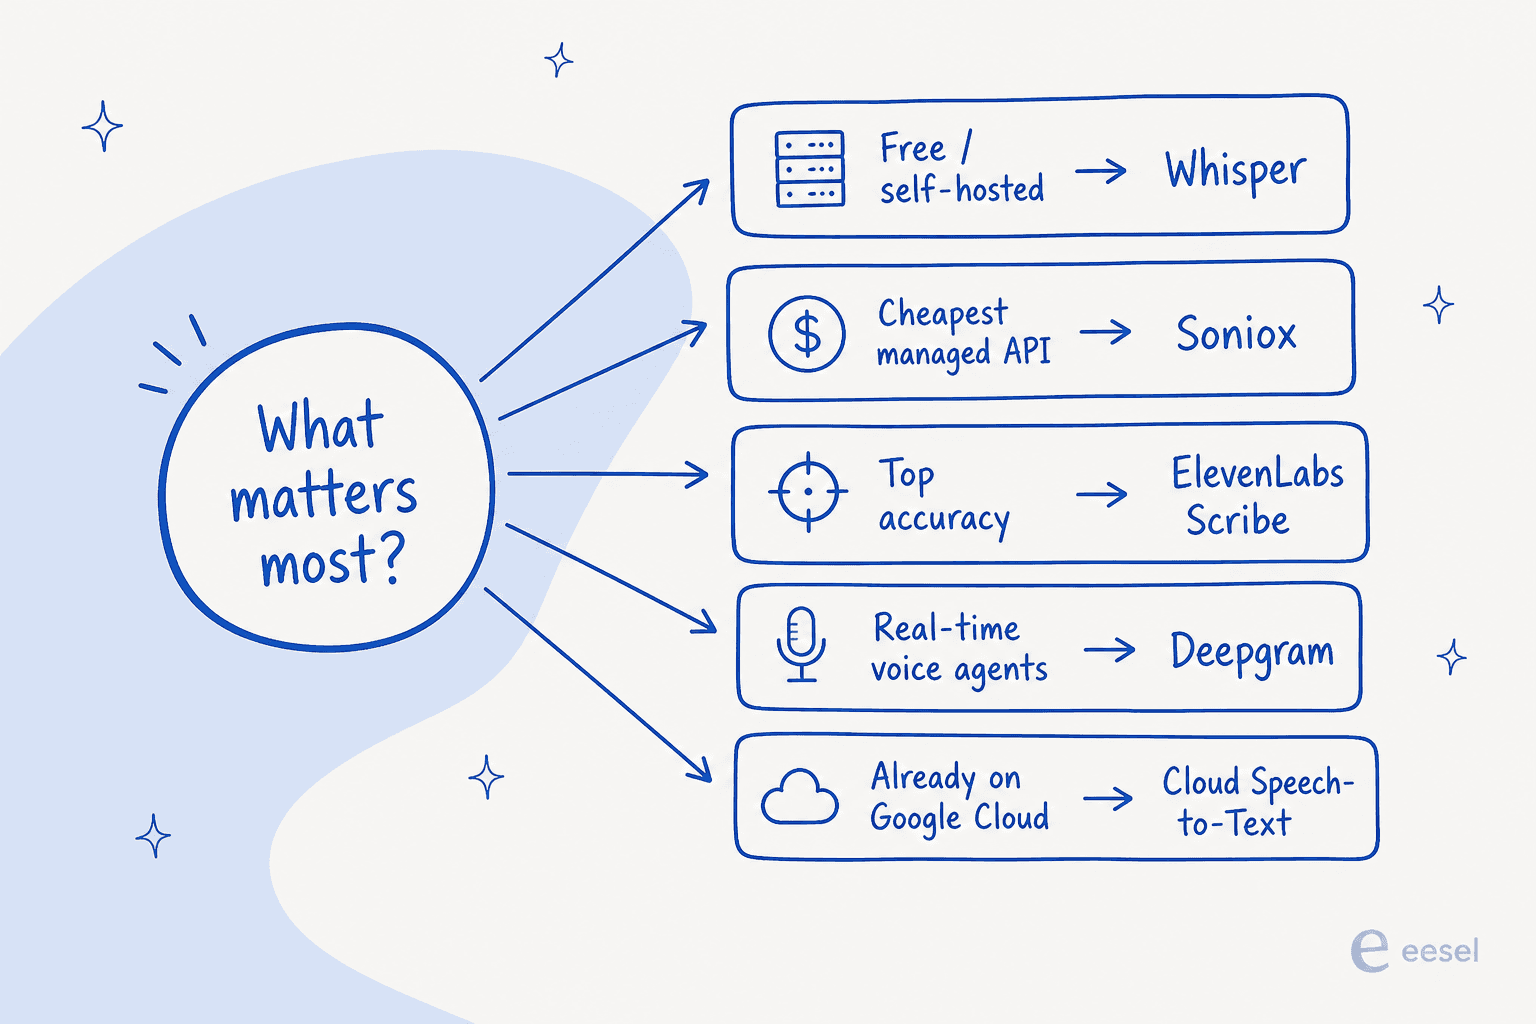
Si vous cherchez une alternative à Gemini 3.5 Transcribe, voici où je vous orienterais selon votre besoin :
- Gratuit et auto-hébergé : OpenAI Whisper (licence MIT, à exécuter sur votre propre matériel).
- API gérée la moins chère : Soniox, environ 0,10 $ de l'heure, diarisation et détection de langue incluses.
- Meilleure précision : ElevenLabs Scribe, plus de 98 % de précision et diarisation jusqu'à 32 locuteurs.
- Agents vocaux en temps réel : Deepgram, le spécialiste du streaming à faible latence.
- Déjà sur Google Cloud : Cloud Speech-to-Text (Chirp 3), avec le niveau par lots le moins cher, à 0,003 $ la minute.
Une chose à dire d'emblée : la transcription n'est que la couche d'entrée. Si vous êtes une équipe support qui transforme voix et chat en tickets, la transcription est la moitié facile. Résoudre réellement le ticket est la partie difficile, le travail d'un coéquipier IA pour le helpdesk qu'un modèle de transcription ne peut pas faire.
Pourquoi regarder au-delà de Gemini 3.5 Transcribe
Soyons justes d'abord : Gemini 3.5 Transcribe est un très bon modèle. C'est le successeur de Chirp 3 de Google, il annonce un taux d'erreur de mots de 2,6 % sur l'anglais hors streaming, détecte automatiquement plus de 85 langues et, à environ 0,005 $ la minute pour le modèle de fichiers, il est moins cher que le niveau standard du Cloud Speech-to-Text de Google lui-même. Pour la dictée à un seul locuteur, il est difficile à battre. J'ai détaillé tout cela dans mon test de Gemini 3.5 Transcribe.
Alors pourquoi changer ? Trois raisons concrètes reviennent sans cesse.
La transcription intelligente réécrit vos mots. C'est la fonction sur laquelle Google insiste le plus, et c'est aussi la plainte la plus courante. La transcription intelligente supprime les mots de remplissage et les autocorrections et reformate au passage, ce qui est excellent pour dicter un e-mail et un vrai problème quand la formulation exacte compte. Un développeur qui l'a testée a constaté qu'elle « simplifiait » une phrase en en brisant le sens, en supprimant la première moitié d'une proposition précise lors de tests répétés. Pour du travail juridique, médical, de recherche ou de conformité, c'est rédhibitoire, pas une simple note de bas de page.
La diarisation cale au-delà de trois locuteurs. La documentation de Google n'est pas d'accord avec elle-même : la page du modèle indique jusqu'à 8 locuteurs avec « 3+ expérimental », tandis que le blog de lancement dit jusqu'à trois. Le chiffre fiable aujourd'hui est trois, et le modèle de streaming en direct ne fait aucune diarisation. Si vous transcrivez des réunions à six personnes, c'est une limite stricte.
Ce n'est pas vraiment le moins cher. À environ 0,30 $ de l'heure pour le modèle de fichiers, Gemini se situe dans le haut du marché. Plusieurs spécialistes sont moins chers, et certains incluent en plus la diarisation et la détection de langue, que Gemini ne facture pas à part mais que d'autres détaillent séparément. Voici ce que cela donne :
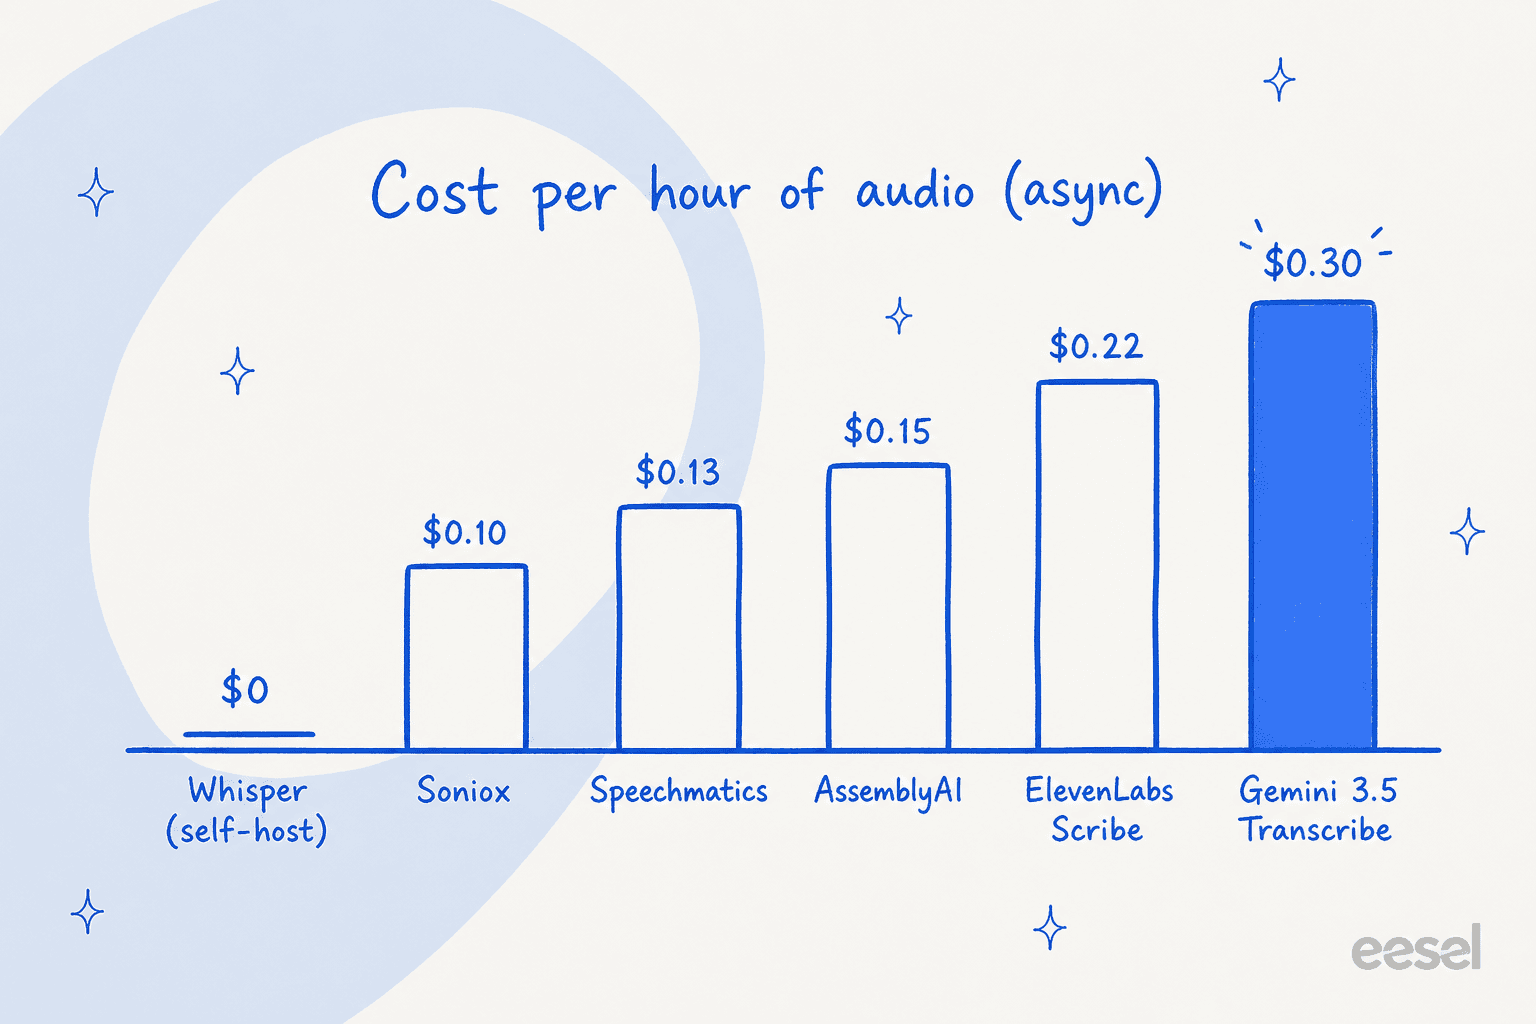
Rien de tout cela ne fait de Gemini un mauvais modèle. Cela signifie simplement que le bon choix dépend de votre audio, et pour beaucoup de cas d'usage réels, l'une des alternatives ci-dessous convient mieux.
Comment je les ai comparées
J'ai jugé chaque alternative sur les critères qui changent réellement une décision de développement : coût réel à l'heure (pas le prix affiché), diarisation et détection de langue incluses ou facturées en options, couverture linguistique, présence d'un mode streaming en temps réel et niveau gratuit pour tester. J'ai lu les tarifs et la documentation de chaque éditeur et me suis appuyé sur des développeurs qui font tourner ces modèles côte à côte, car un score de benchmark propre et votre résultat en conditions réelles peuvent être très éloignés.
Voici le tableau récapitulatif avant les analyses détaillées. Tous les prix sont les tarifs publics à l'usage de chaque éditeur pour la transcription asynchrone (de fichiers), sauf mention contraire.
| Outil | Prix asynchrone | Streaming | Langues | Diarisation | Niveau gratuit | Idéal pour |
|---|---|---|---|---|---|---|
| Whisper | 0 $ (auto-hébergé) | À construire soi-même | 99 | Bibliothèques en plus | Poids ouverts | Contrôle, pas de frais à la minute |
| Deepgram | ~0,29 $/h (Nova-3) | Oui | 30+ | +0,0020 $/min | 200 $ de crédit | Agents vocaux en temps réel |
| AssemblyAI | 0,15 $/h (Universal-2) | Oui | 99 | +0,02 $/h | Paiement à l'usage gratuit | Intelligence audio |
| ElevenLabs Scribe | 0,22 $/h | 0,39 $/h | 90+ | Jusqu'à 32 locuteurs | Niveau gratuit | Meilleure précision, nombreux locuteurs |
| Speechmatics | à partir de 0,129 $/h | à partir de 0,24 $/h | 55+ | Incluse | 100 $ de crédit | Accents et dialectes |
| Soniox | ~0,10 $/h | ~0,12 $/h | 60+ | Incluse | Crédit gratuit | API gérée la moins chère |
| Cloud Speech-to-Text | 0,003 $/min (par lots) | 0,016 $/min | 125+ | Incluse | 300 $ de crédit GCP | Équipes déjà sur GCP |
| Rev AI | 0,20 $/h | Oui | 57+ | Incluse | Essai gratuit | Précision selon les accents, HIPAA |
| Gemini 3.5 Transcribe | ~0,30 $/h | ~0,54 $/h | 85+ | Jusqu'à 3 locuteurs | Niveau gratuit | Dictée à un seul locuteur |
1. OpenAI Whisper
Idéal pour : les équipes qui veulent un contrôle total, aucun verrouillage à la minute ou un point de départ gratuit.
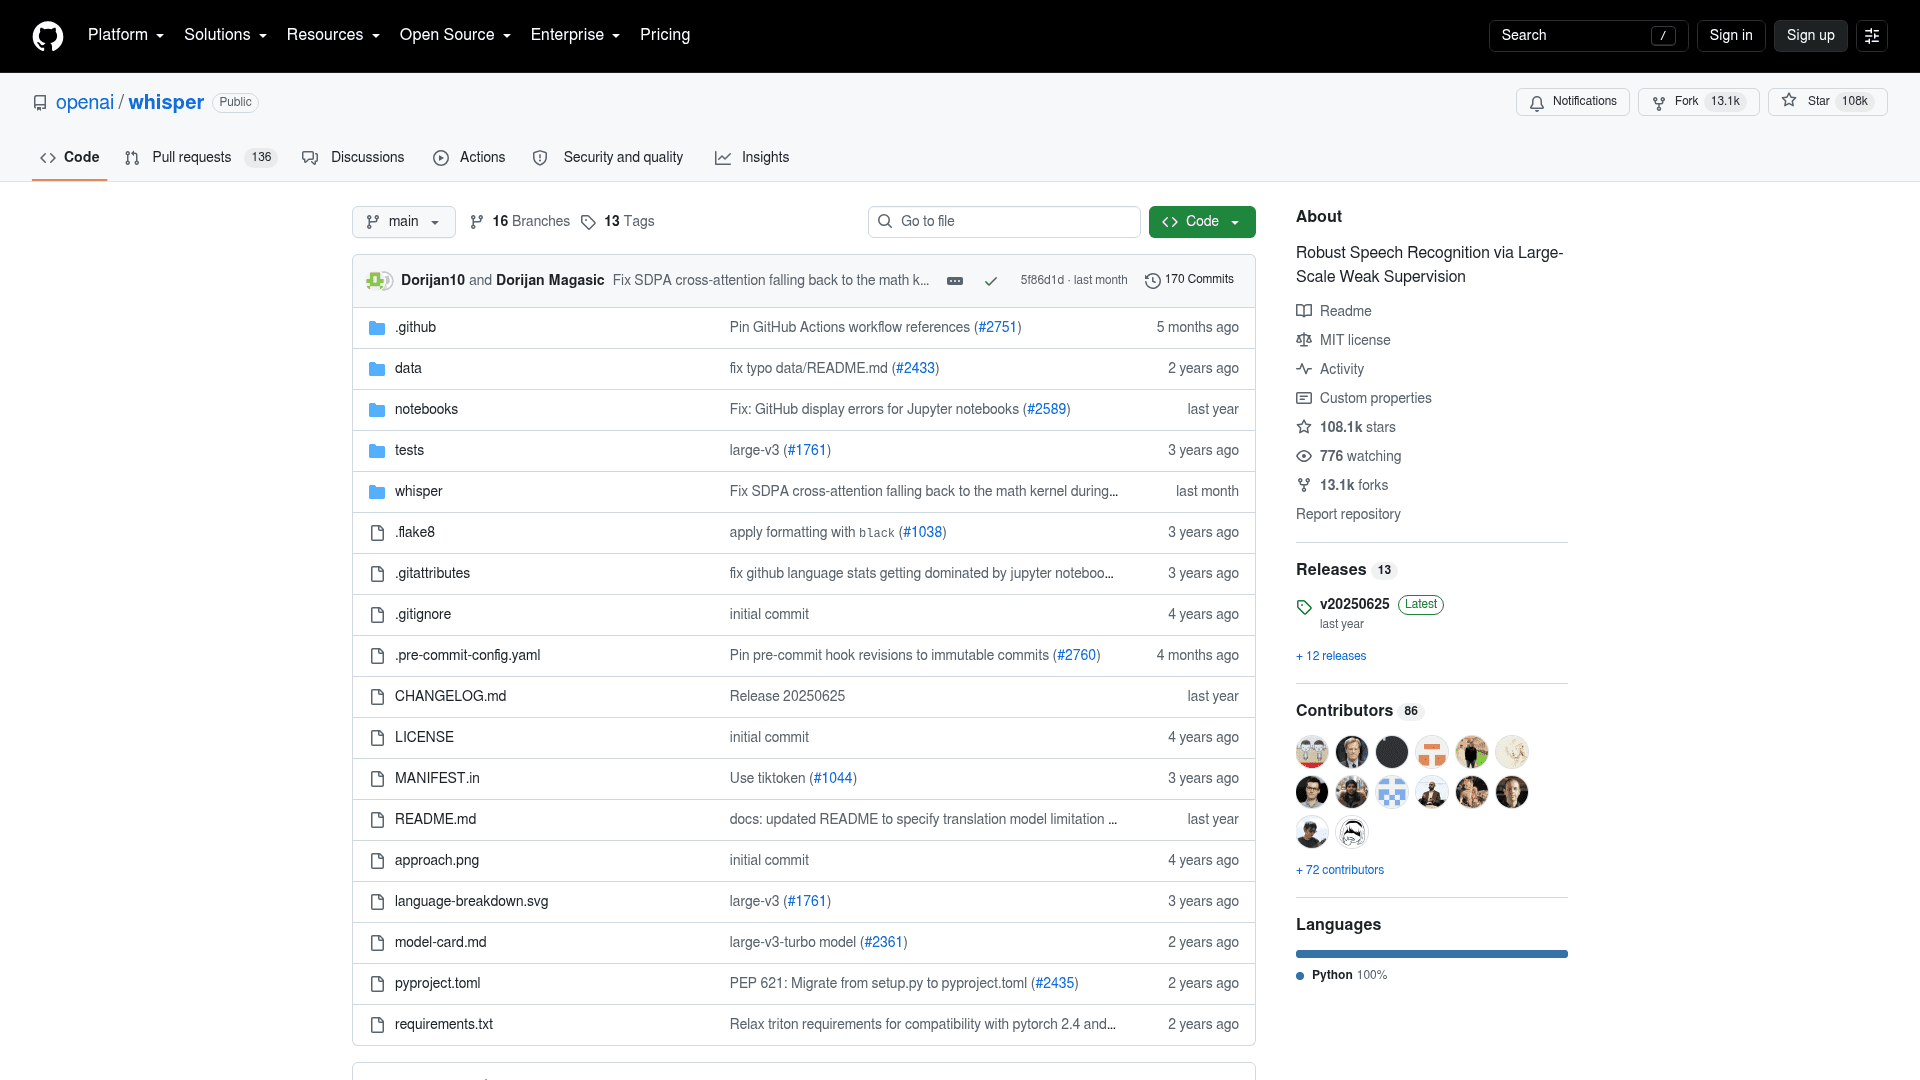
Whisper est le modèle qui a redéfini les attentes en matière de reconnaissance vocale ouverte. Il est sous licence MIT, compte plus de 108 000 étoiles sur GitHub et se décrit comme « Robust Speech Recognition via Large-Scale Weak Supervision ». Les poids étant ouverts, vous pouvez l'exécuter sur votre propre matériel pour le seul coût du calcul, sans facture d'API à la minute et sans que les données quittent votre infrastructure. Ce dernier point explique pourquoi tant d'équipes soucieuses de confidentialité commencent ici.
Il reste un favori de la communauté pour de bonnes raisons :
"Whisper Large-v3 is still the most stable open model across diverse domains. Great accuracy, predictable output, and decent handling of accents."

Avantages : Gratuit à auto-héberger, poids ouverts, forte précision multilingue, énorme écosystème d'outils et d'affinages, fonctionne entièrement hors ligne.
Inconvénients : L'auto-hébergement est un vrai travail d'ingénierie (GPU, traitement par lots, montée en charge). La diarisation et les horodatages par mot ne sont pas intégrés, il faut donc ajouter des bibliothèques. Whisper est aussi connu pour inventer du texte sur les segments silencieux ou bruyants. Si vous préférez ne pas gérer d'infrastructure, l'API gérée GPT-Transcribe d'OpenAI coûte environ 0,0045 $ la minute (environ 0,27 $ de l'heure) en asynchrone et 0,017 $ la minute en streaming en direct.
Verdict : Whisper est le choix par défaut pour qui valorise le contrôle et le coût plutôt que la commodité. Si vous avez les ressources d'ingénierie pour l'héberger, il est pratiquement gratuit et privé. Sinon, les points d'accès gérés d'OpenAI vous donnent la même lignée sans la charge d'exploitation. Beaucoup d'équipes font un mélange : Whisper pour les horodatages par mot et un modèle de chat pour corriger le texte.
2. Deepgram
Idéal pour : les agents vocaux en temps réel et le streaming à faible latence à grande échelle.
Deepgram est le spécialiste de l'ASR conçu pour la vitesse. Il alimente l'infrastructure vocale d'entreprises comme Twilio, Cloudflare et Vapi, et toute son architecture est réglée pour le streaming à faible latence, exactement ce dont un agent vocal en direct a besoin. Son modèle Nova-3 actuel coûte 0,0048 $ la minute en streaming monolingue (environ 0,29 $ de l'heure), avec 200 $ de crédit gratuit pour démarrer.
Les développeurs qui comparent le marché voient plutôt Deepgram comme le rapide que comme le plus précis :
"AssemblyAI and Speechmatics too, who both have much greater accuracy - especially in real-time for Speechmatics. Deepgram are only fastest at..."
Avantages : Excellente latence en streaming, énorme concurrence, auto-hébergement pour les secteurs réglementés et une grille tarifaire claire à la minute.
Inconvénients : Les options s'accumulent : la diarisation des locuteurs coûte 0,0020 $ de plus par minute, et la rédaction (masquage) et le keyterm prompting coûtent encore plus. Sa précision brute sur de l'audio difficile est en retrait par rapport aux leaders de la précision dans certains tests utilisateurs.
Verdict : Si vous construisez de la voix en temps réel, Deepgram est le premier nom de la liste. C'est ce qui se rapproche le plus du cas d'usage de Gemini 3.5 Transcribe Live, et il traite le streaming comme une priorité plutôt que comme un compromis de latence. Pour du travail par lots sur fichiers où la précision compte plus que la vitesse, je le testerais face à AssemblyAI ou Scribe avant de m'engager.
3. AssemblyAI
Idéal pour : les équipes qui veulent transcription et intelligence audio dans une seule API.
AssemblyAI associe une transcription solide à un riche ensemble de fonctions d'« intelligence audio » : sentiment, détection de sujets, résumé et garde-fous de sécurité, le tout via la même API. Son modèle Universal-2 coûte 0,15 $ de l'heure sur 99 langues, et le plus récent Universal-3.5 Pro, à 0,21 $ de l'heure, ajoute l'alternance native de langues et sa diarisation la plus précise à ce jour sur 18 langues. AssemblyAI revendique une meilleure précision de mots que Whisper, 94,1 % contre 92,4 %.
Avantages : Haute précision sur les fichiers, couverture de 99 langues avec Universal-2, une couche d'intelligence utile pour le travail sur les tickets de support et une tarification à l'heure en libre-service avec niveau gratuit.
Inconvénients : Les extras sont facturés : la diarisation des locuteurs ajoute 0,02 $ de l'heure et le keyterm prompting ajoute 0,05 $ de l'heure sur le modèle Pro. Le niveau supérieur Universal-3.5 Pro se limite à 18 langues, donc le travail multilingue étendu reste sur Universal-2.
Verdict : AssemblyAI est le bon choix quand vous voulez plus qu'une transcription brute. Si votre produit doit résumer des appels, signaler le sentiment ou extraire des sujets, le faire en un seul appel vaut mieux que d'assembler un modèle de transcription à une étape LLM distincte. Sur la précision pure, il est au niveau des leaders, et le niveau gratuit à l'usage permet de le comparer facilement à votre propre audio.
4. ElevenLabs Scribe
Idéal pour : la meilleure précision et l'audio avec de nombreux locuteurs.
ElevenLabs s'est fait un nom dans la génération vocale, mais Scribe est un modèle de reconnaissance vocale sérieux à part entière. Il annonce plus de 98 % de précision, plus de 90 langues et le chiffre marquant, la diarisation jusqu'à 32 locuteurs, un ordre de grandeur au-dessus des trois de Gemini. Scribe v1 et v2 coûtent 0,22 $ de l'heure, avec un modèle en temps réel, Scribe v2 Realtime, à 0,39 $ de l'heure et environ 150 ms de latence.
Son rapport prix/précision est ce qui séduit. Un développeur qui fait de la transcription professionnellement a fait le calcul face à Gemini :
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."

Avantages : Leader en précision sur audio propre, diarisation qui passe réellement à l'échelle sur de grandes réunions, large couverture linguistique et une option en temps réel.
Inconvénients : Plus cher à l'heure que Soniox, Speechmatics ou le niveau de base d'AssemblyAI. La reconnaissance vocale est un produit au sein d'une entreprise de génération vocale, donc la documentation et la communauté penchent vers le TTS.
Verdict : Si votre exigence est « obtenir les mots exactement justes, même avec une salle entière qui parle », c'est par Scribe que je commencerais. La diarisation à 32 locuteurs en fait à elle seule la réponse évidente pour la transcription de réunions et de tables rondes, précisément là où Gemini 3.5 Transcribe peine le plus.
5. Speechmatics
Idéal pour : une large couverture d'accents et de dialectes, et les déploiements en entreprise.
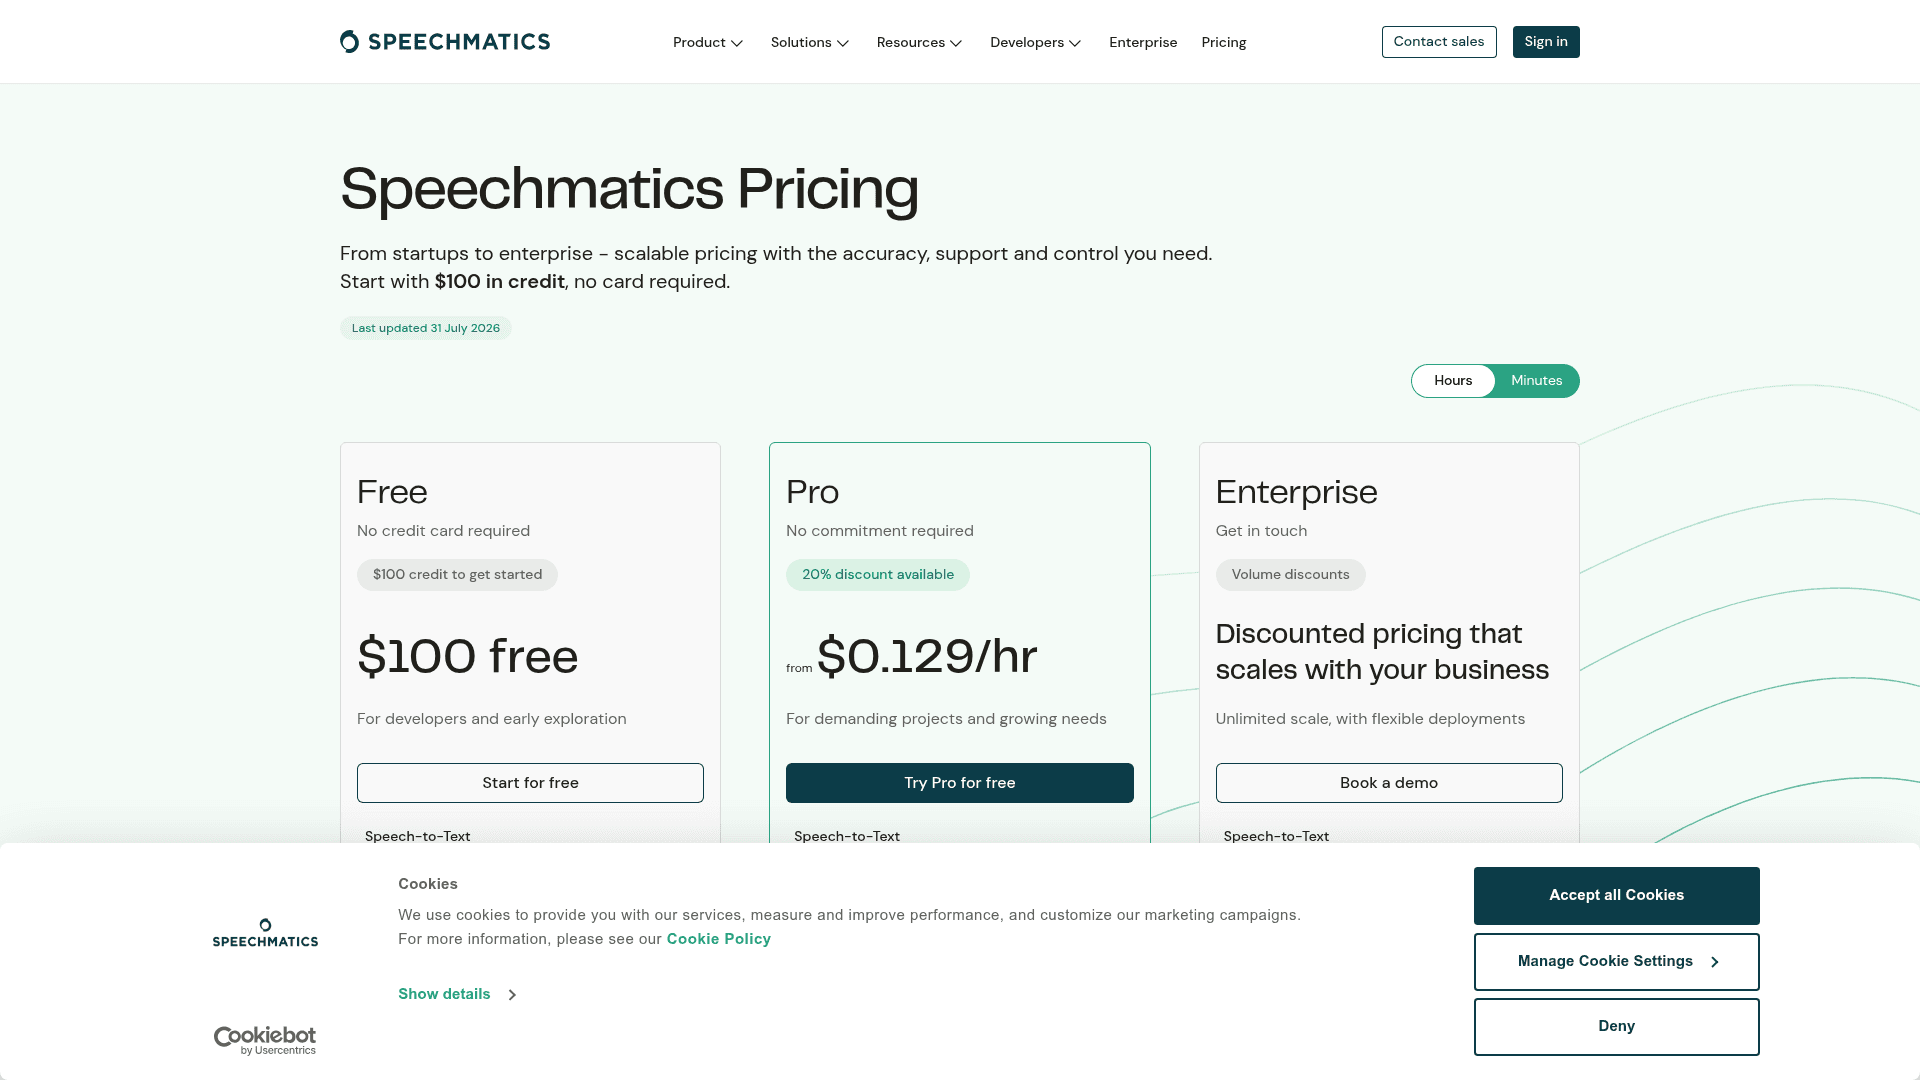
Speechmatics est le spécialiste de la précision et des accents. Il couvre plus de 55 langues et dialectes et se vante de transcrire avec précision « over 4 billion people », le genre de couverture d'accents qui compte si vos appelants ne parlent pas tous avec un même accent standard. Son niveau par lots Melia 1 démarre à 0,129 $ de l'heure, avec un niveau standard en temps réel à 0,24 $ de l'heure, 100 $ de crédit gratuit et 20 % de remise au-delà de 500 heures par mois.
Les utilisateurs dans le débat sur la précision le citent régulièrement parmi les meilleurs, surtout en temps réel, qui est le problème le plus difficile.
Avantages : Bonne gestion des accents et dialectes, tarifs par lots compétitifs, diarisation incluse plutôt que facturée à part et déploiement sur site pour les entreprises.
Inconvénients : La structure de niveaux (Melia 1, Standard, Enhanced, en lots et en temps réel) demande un moment pour être comprise. Le niveau Melia 1, le moins cher, est celui où se situent les 0,129 $ affichés : lisez donc le niveau avant de budgéter.
Verdict : Speechmatics est celui vers lequel je me tournerais quand l'audio est linguistiquement désordonné : accents mélangés, dialectes, vrais enregistrements de centres d'appels. Si la transcription intelligente de Gemini « corrige » discrètement la formulation d'un locuteur que vous aviez besoin de conserver, un modèle conçu autour d'une gestion fidèle des accents est le pari le plus sûr.
6. Soniox
Idéal pour : l'API gérée la moins chère avec les fonctions incluses.
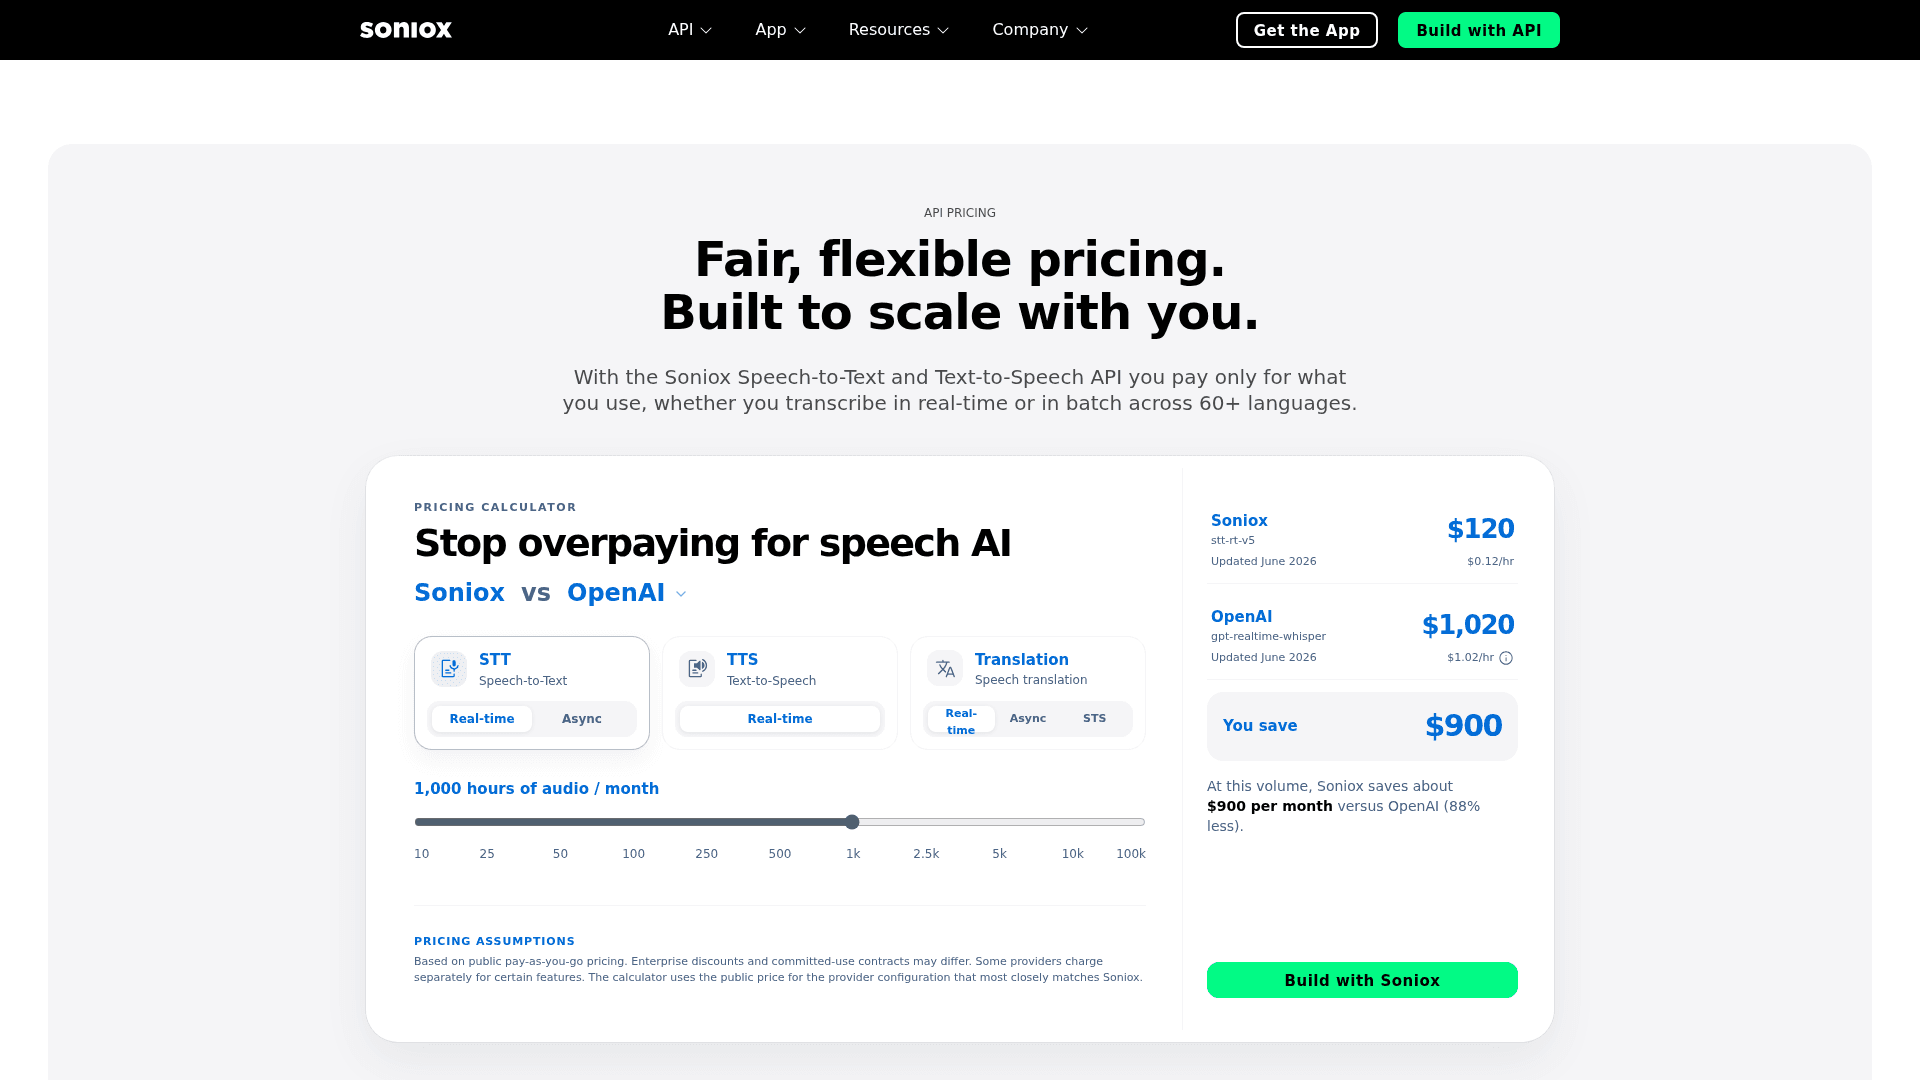
Soniox est le choix de la valeur, et il ne s'en cache pas. La reconnaissance vocale coûte environ 0,10 $ de l'heure en asynchrone et 0,12 $ de l'heure en temps réel, sur plus de 60 langues. Ce qui le distingue n'est pas seulement le chiffre : la diarisation des locuteurs, l'identification de la langue, le formatage intelligent et même la traduction sont inclus dans ce tarif horaire au lieu d'être facturés en options. Soniox se présente comme environ 4,5 fois moins cher que Google et 8 fois moins cher qu'Azure en temps réel.
Avantages : Le prix géré le plus bas ici, tout est inclus (pas de supplément pour la diarisation ou la détection de langue), temps réel et lots sur le même modèle, et traduction dans plus de 60 langues au sein du même appel.
Inconvénients : C'est un nom plus petit et plus récent que Deepgram ou Google, donc il y a moins de benchmarks tiers et moins de notoriété. Il faudra le tester sur votre propre audio plutôt que de croire les calculs du marketing.
Verdict : Pour la transcription sensible au coût et en volume, Soniox est l'offre la plus affûtée de ce comparatif. Inclure la diarisation et la traduction dans un tarif fixe de 0,10 $ de l'heure est un vrai avantage sur Gemini et Deepgram, qui les facturent séparément. Si la précision tient sur vos enregistrements, les économies se cumulent vite à grande échelle.
7. Google Cloud Speech-to-Text (Chirp 3)
Idéal pour : les équipes déjà sur Google Cloud et le niveau par lots le moins cher.
Voici le cas intéressant : le Cloud Speech-to-Text de Google est le modèle que Gemini 3.5 Transcribe est censé remplacer, et il est toujours bien vivant. Son modèle de base Chirp 3 prend en charge plus de 125 langues, et les tarifs vont de 0,016 $ la minute pour la reconnaissance standard jusqu'à 0,003 $ la minute pour le dynamic batch, le tarif par lots le moins cher de toute cette comparaison. Les nouveaux clients reçoivent aussi 300 $ de crédits Google Cloud.
Avantages : Le niveau par lots le moins cher pour les gros volumes, à 0,003 $ la minute, la couverture linguistique la plus large, une intégration profonde avec le reste de Google Cloud et des outils de niveau entreprise.
Inconvénients : La reconnaissance standard en temps réel, à 0,016 $ la minute, est plus chère que le modèle de fichiers de Gemini. Il y a plus de configuration qu'avec un seul point d'accès propre, et Google oriente clairement le nouveau travail vers Gemini 3.5 Transcribe.
Verdict : Si votre stack vit déjà dans Google Cloud, ou si vous exécutez d'énormes traitements par lots où 0,003 $ la minute l'emporte, Chirp 3 est un choix parfaitement rationnel, parfois moins cher que le nouveau modèle Gemini tout brillant. Comparez simplement ce qui est comparable : lots contre lots, temps réel contre temps réel.
8. Rev AI
Idéal pour : la précision selon les accents, la conformité HIPAA et un recours humain.
Rev AI vient de Rev, l'entreprise de transcription humaine, et s'appuie sur cet héritage : ses modèles sont entraînés sur plus de 7 millions d'heures de parole vérifiée par des humains, et elle met en avant l'équité entre « ethnic background, nationality, gender, and accent ». Elle couvre plus de 57 langues, est conforme SOC 2, HIPAA, RGPD et PCI avec 99,99 % de disponibilité, et facture la transcription automatique à 0,20 $ de l'heure, un modèle turbo à 0,10 $ de l'heure et la transcription humaine à 1,99 $ la minute quand il vous faut une personne dans la boucle.
Avantages : Précision constante selon les accents et sur de l'audio difficile, un solide dispositif de conformité pour les secteurs réglementés et la possibilité de basculer vers la transcription humaine pour les fichiers les plus difficiles.
Inconvénients : La marque reste surtout connue pour la transcription humaine, donc l'API pour développeurs reçoit moins d'attention de la communauté que Deepgram ou AssemblyAI. Le streaming et les modèles premium se situent au-dessus des tarifs de base de 0,10 à 0,20 $.
Verdict : Rev AI est le choix quand la conformité et l'équité entre les voix sont non négociables, ou quand vous avez parfois besoin d'une transcription de qualité humaine pour un fichier critique. La couverture HIPAA et la voie d'escalade vers l'humain sont des choses que la plupart des fournisseurs de modèles seuls ne peuvent pas offrir, ce qui en fait un choix naturel pour les flux de travail de santé et juridiques.
Comment choisir concrètement
La réponse honnête est qu'il n'y a pas de gagnant unique, seulement la bonne adéquation avec votre audio. Après avoir parcouru les huit, voici le chemin le plus court vers une décision :
Deux règles pratiques tirées de l'observation de ceux qui construisent sur ces modèles. D'abord, testez toujours deux ou trois solutions sur vos propres enregistrements avant d'engager un pipeline. Le WER de benchmark et le WER de votre audio bruité, accentué et avec des voix qui se chevauchent sont deux choses très différentes, un point sur lequel j'insiste aussi dans le test de Gemini 3.5 Transcribe. Ensuite, comptez les options. Un tarif affiché qui exclut la diarisation et la détection de langue n'est pas comparable à un tarif qui les inclut, c'est pourquoi Soniox à 0,10 $ de l'heure tout compris peut battre un modèle « moins cher » dès qu'on active les extras.
Où s'arrête la transcription et où commence la résolution
Voici la partie qu'un simple tour d'horizon des modèles manque, et c'est celle qui me tient le plus à cœur. Tous les outils de cette liste font le même travail : transformer de l'audio en texte. Même le meilleur, s'il le fait sans faute, vous remet une transcription. Et la transcription d'un appel ou d'un message vocal client n'est pas une réponse, c'est le début d'une réponse.
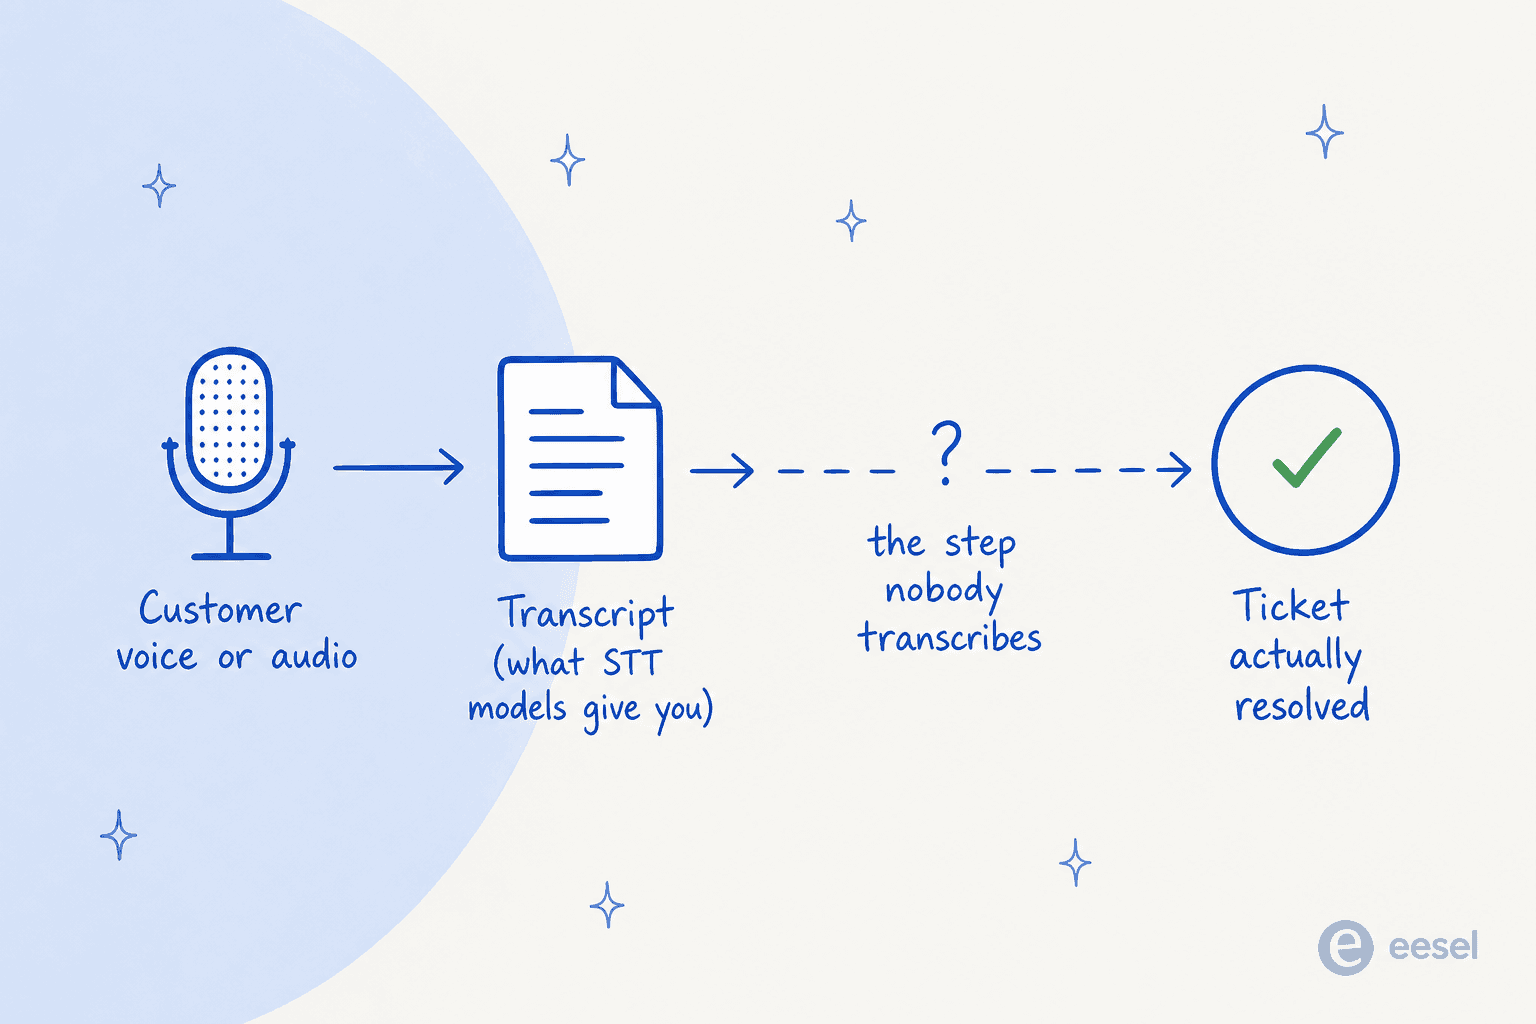
Quelque chose doit encore lire ce texte, comprendre ce dont le client a vraiment besoin, aller chercher la bonne information et résoudre le ticket. Cette couche de résolution, c'est ce sur quoi je travaille. J'ai passé ces dernières années auprès d'IA qui travaillent sur des files de support en direct, et le schéma ne change jamais : obtenir les bons mots est le minimum, agir correctement dessus est la partie difficile. Un modèle de transcription vous donne les mots. Il ne connaît pas votre politique de remboursement, votre système de commandes ni les trois derniers tickets ouverts par ce client.
C'est la différence entre un modèle et un coéquipier. Gemini 3.5 Transcribe, Whisper, Deepgram et les autres sont des modèles, brillants sur une tâche étroite. eesel est une plateforme de coéquipiers : vous embauchez des coéquipiers IA prêts à travailler pour des tâches précises, et l'équipe actuelle comprend un coéquipier IA pour le helpdesk et un rédacteur de blog IA. Le coéquipier helpdesk se branche sur le helpdesk que vous utilisez déjà, Zendesk, Freshdesk, Gorgias, et rejoint la file existante, entraîné sur votre centre d'aide et vos anciens tickets.
Essayez eesel pour vos tickets voix et chat
Si vous comparez des modèles de transcription parce que votre équipe croule sous les tickets voix ou chat, souvenez-vous que la transcription n'est que la moitié du travail. Le coéquipier IA helpdesk d'eesel prend le relais là où un modèle comme Gemini 3.5 Transcribe s'arrête : il lit le message du client, rédige ou envoie la réponse et boucle la boucle, à travers plus de 1 000 intégrations.
Ce que je mettrais en avant en premier, c'est le mode simulation. Avant que l'IA ne touche un vrai client, vous l'exécutez sur des milliers de vos tickets passés et voyez exactement comment elle aurait répondu, le même conseil « testez d'abord sur vos propres données » que je donnerais pour n'importe quel modèle de transcription, intégré au produit. Le tarif est un prix mensuel fixe, à partir de 299 $/mois pour 500 crédits (1 crédit par ticket ou chat) sans frais par utilisateur, et il existe un plan gratuit avec 100 crédits, sans carte. C'est la différence entre une transcription intelligente d'un problème et sa résolution réelle.