

Por qué mirar más allá de Gemini 3.8 Live Avatar
Primero seamos justos con Google, porque el producto lo merece. Gemini 3.8 Live Avatar observa tu cámara y tu pantalla mientras escucha, lanza llamadas a herramientas asíncronas en segundo plano para poder, por ejemplo, hacerte el check-in en un hotel en plena conversación, y detecta y cambia entre idiomas sin que el rostro se desincronice. Es una de las demos de agente en vivo más completas que ha lanzado un laboratorio.
El problema es el acceso y la dependencia. Llegó a disponibilidad general dentro de Gemini Enterprise, así que es un compromiso con Google Cloud, no una clave de API para un fin de semana. Los avatares personalizados creados a partir de tus propias grabaciones de referencia están protegidos por una lista de permitidos más un paso de verificación, de modo que no puedes montar un rostro de marca el primer día. Y una vez que construyes sobre él, tu agente en vivo vive por completo dentro del ecosistema de Google.
También hay un costo que conviene conocer antes de comparar. En la Live API, el medidor de video del avatar sale a unos $0.37 por minuto de habla del avatar (se factura solo mientras habla, no mientras espera). No es escandaloso, pero es dinero real a volumen de soporte y cambia la comparación: no estás eligiendo un extra gratuito, estás eligiendo un producto por minuto. Eso hace que valga la pena mirar las alternativas con calma.
Cómo pensar en las alternativas
Las siete herramientas no son realmente una sola categoría. Se dividen en tres, y saber en qué carril estás te ahorra muchas pruebas inútiles. Para un panorama más amplio más allá de los avatares, nuestra guía de las mejores herramientas de IA para atención al cliente cubre también las opciones centradas en texto.
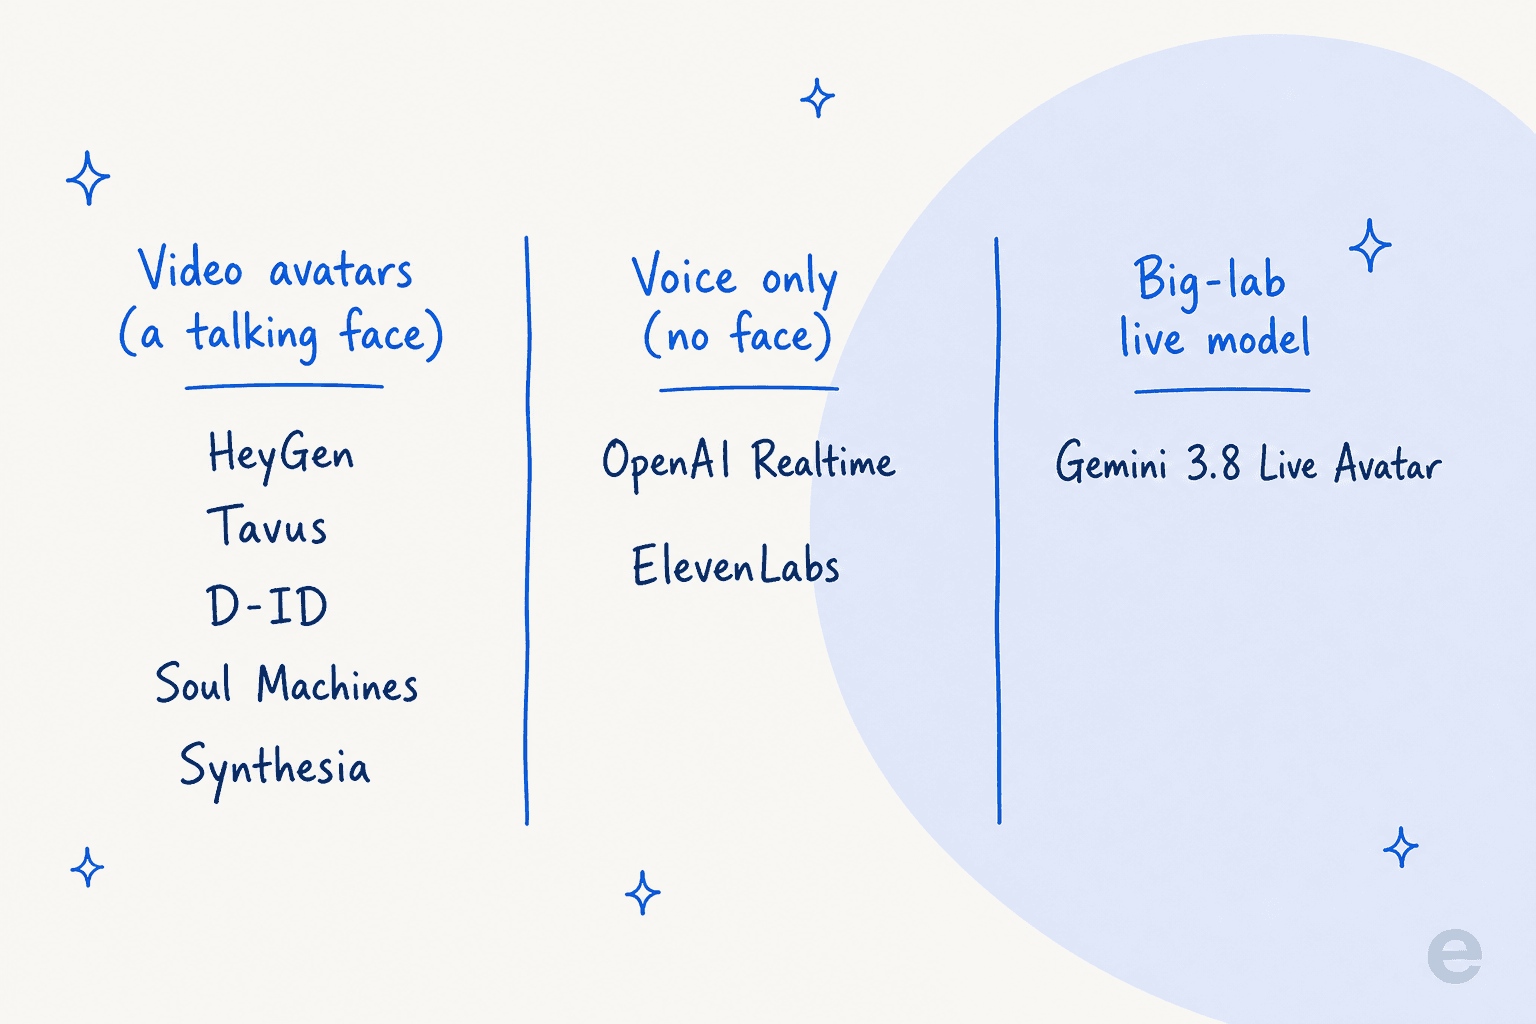
- Avatares de video (un rostro parlante): HeyGen, Tavus, D-ID, Soul Machines y Synthesia. Renderizan un humano animado que sincroniza los labios con sus respuestas. Es lo más parecido a lo que hace Gemini 3.8 Live Avatar.
- Solo voz (sin rostro): la OpenAI Realtime API y ElevenLabs. La misma conversación en tiempo real, sin rostro renderizado. Más barato, más simple y a menudo todo lo que un caso de soporte o ventas necesita realmente. Si estás sopesando todo el panorama, nuestra guía sobre los beneficios de la IA conversacional es una buena introducción.
- Modelo en vivo de un gran laboratorio: el propio Gemini 3.8 Live Avatar, junto a cosas como la OpenAI Realtime API, donde el modelo y el pipeline de medios vienen de un único laboratorio de frontera.
Esta es la parte que la mayoría de las comparativas omite. Todas las herramientas de los tres carriles compiten en la misma capa superior: el rostro, la voz, la alternancia de turnos, la latencia. Nada de eso toca la capa de abajo, donde una conversación de soporte realmente tiene éxito o fracasa.
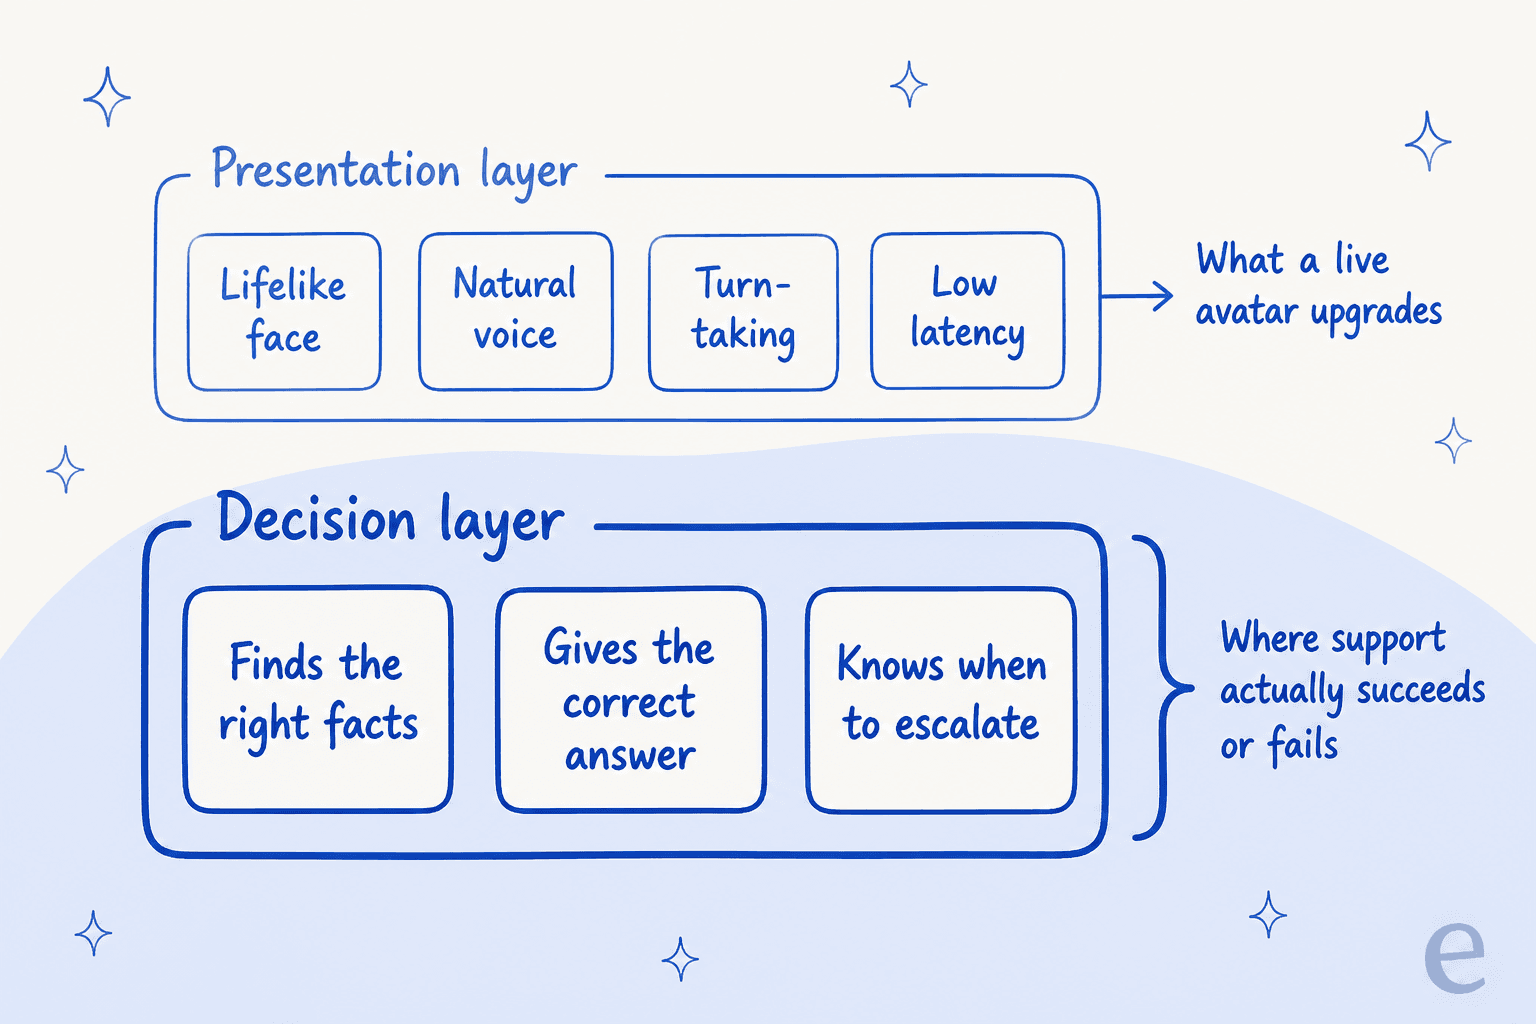
Volveré sobre por qué esa capa de decisión es la parte difícil. Primero, las herramientas.
Las alternativas de un vistazo
| Herramienta | Ideal para | Rostro o voz | Latencia en tiempo real (según el proveedor) | Unidad de facturación | Precio de entrada | Límite destacado |
|---|---|---|---|---|---|---|
| HeyGen LiveAvatar | Avatares de video de marca a escala | Avatar de video | <300ms al primer fotograma | Créditos por minuto de streaming | Free ($0, 10 créditos); Essential $99 | $0.01/min solo en Enterprise |
| Tavus | Desarrolladores que integran agentes de video en vivo | Avatar de video | ~134ms de render, ida y vuelta de menos de 1s | Minuto de video conversacional | Free (25 min); Starter $59 | Quejas por la alternancia de turnos; giro hacia desarrolladores |
| D-ID | Avatares en streaming sin código con RAG | Avatar de video | Menos de 2 segundos | Bolsa mensual compartida de minutos | Prueba de 14 días; API Build $14.40 | Bolsa sin acumulación; quejas de facturación |
| Soul Machines | Humanos digitales emocionalmente expresivos | Avatar de video | No publicada | Minutos de conversación interactiva | Free (solo construir); Basic $12.99 | Escala de forma abrupta; pocas reseñas |
| Synthesia | Video corporativo a escala | Avatar de video (mayormente asíncrono) | N/A (el núcleo es prerrenderizado) | Créditos, más por minuto para live | Free ($0); Starter $19 | El producto principal no es en tiempo real |
| OpenAI Realtime API | Construir tu propio agente de voz | Solo voz | Baja (voz a voz) | Tokens de audio | $32 / 1M de tokens de audio de entrada | Sin rostro; piezas sueltas, no un agente terminado |
| ElevenLabs | Agentes de voz que suenan humanos | Solo voz | Menos de un segundo (declarada) | Minutos de llamada | Free (15 min); Starter $6 | El costo se acumula; los créditos caducan al bajar de plan |
Ahora el detalle de cada una.
1. HeyGen LiveAvatar
Ideal para: equipos que quieren un avatar de busto pulido y de marca transmitido a usuarios reales, con la mínima infraestructura.
HeyGen rebautizó su producto en tiempo real como LiveAvatar, y es el avatar de video más llave en mano de esta lista. Transmite avatares en 1080p con, según HeyGen, menos de 300ms hasta el primer fotograma y concurrencia ilimitada, y puedes integrarlo en unos cinco minutos. Hay dos modos de construcción: FULL, donde HeyGen ejecuta todo el stack de voz y renderizado, y LITE, donde traes tu propio LLM y síntesis de voz.
Precios. LiveAvatar factura en créditos, y la proporción depende del modo: FULL son 2 créditos por minuto, LITE es 1 crédito por minuto. Los planes son Free ($0, 10 créditos, con marca de agua, sesiones de 2 minutos), Essential ($99 por 1,100 créditos), Business ($475 por 6,000 créditos) y Enterprise. El titular "$0.01/min a escala" es real, pero solo se aplica en el nivel Enterprise, que el centro de ayuda sitúa en presupuestos superiores a unos $40,000. Ten en cuenta que esto es aparte de los planes de video principales de HeyGen.
El límite honesto. La cifra <300ms es una afirmación sobre la nueva plataforma, y existe en parte porque el antiguo SDK Streaming Avatar de HeyGen tenía fama en foros de desarrolladores de latencias reales de varios segundos. Si la baja latencia es decisiva, mídela con tu propio tráfico antes de comprometerte.
Veredicto: la forma más fácil de poner un avatar de marca atractivo frente a los usuarios. Solo revisa la cuenta de créditos, porque el modo FULL gasta el doble de rápido de lo que sugiere la tarifa LITE del titular.
2. Tavus
Ideal para: ingenieros que quieren integrar un agente de video en tiempo real y les importan el realismo del renderizado y la latencia.
Tavus construye la Conversational Video Interface, un pipeline de video en tiempo real completo que manejas por API. Su stack de modelos es inusualmente específico: Raven para la percepción, Sparrow para la alternancia de turnos y el renderizador Phoenix, que según Tavus alcanza unos 134ms de renderizado con un ida y vuelta conversacional de menos de un segundo. Una sola API reemplaza a los cinco o seis proveedores que tendrías que conectar, porque el LLM, la síntesis de voz y WebRTC están incluidos en el precio por minuto.
El realismo convence a quienes lo prueban:
"Felt like talking to a person, I couldn't bring myself to treat it like a piece of code, that's how real it felt."

Precios. Tavus usa un modelo híbrido: una cuota mensual más minutos de video conversacional incluidos con excedente de pago por uso. Basic es gratis (25 min/mes), Starter cuesta $59/mes (100 min, luego $0.37/min) y Growth cuesta $397/mes (1,250 min, luego $0.32/min). El entrenamiento de rostros personalizados es un complemento, a $65 cada uno tras unos pocos entrenamientos gratis en Starter.
El límite honesto. La crítica constante, de la misma demo, es la alternancia de turnos:
"The AI kept cutting me off, and not leaving time in the conversation to respond. It would cut off utterances before the end."
Sparrow se creó justo para arreglar esto, así que ahora debería ser mejor, pero el manejo de interrupciones es lo que hay que poner a prueba. Tavus también giró hacia los desarrolladores en 2026, así que apunta a ingenieros, no a especialistas en marketing.
Veredicto: la mejor opción si eres desarrollador y quieres el rostro en tiempo real más realista y vas a hacer el trabajo de integración. Prueba las interrupciones antes de lanzar.
3. D-ID
Ideal para: equipos que quieren un avatar en streaming con una base de conocimiento integrada y un camino sin código, no solo una API.
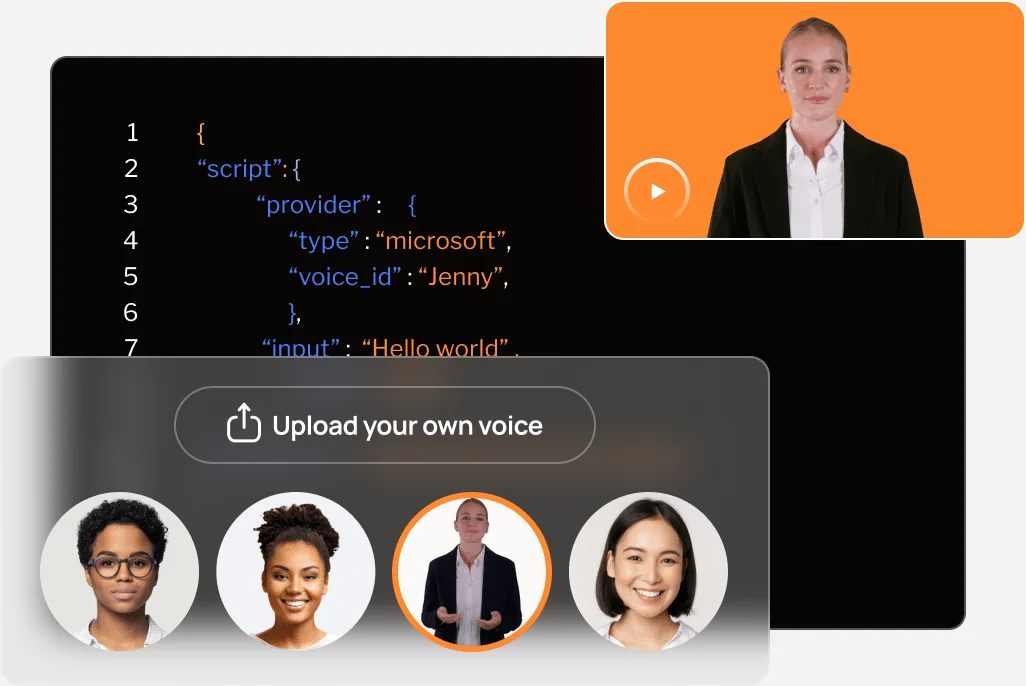
D-ID Agents son avatares conversacionales transmitidos por WebRTC que puedes construir con el SDK de cliente, la API REST o una inserción sin backend. Cada agente combina un avatar con un LLM (incluido uno propio), una base de conocimiento RAG y memoria de conversación, y D-ID promociona "más del 90 % de precisión en menos de dos segundos". A quienes les gusta, realmente les gusta la calidad del avatar:
"For me at the moment the best live interactive Avatars on the market. Good lip Sync, really realistic."

Precios. D-ID maneja dos tarifarios, Studio y API, ambos facturan créditos contra una bolsa mensual compartida de minutos que cubre videos, agentes y traducción en conjunto. En el lado de la API, Build cuesta $14.40/mes (hasta 32 minutos de streaming), Launch $35/mes (hasta 90) y Scale $138.60/mes (hasta 400). Hay una prueba de 14 días pero no un plan gratuito permanente, y el volumen serio de agentes en vivo es una conversación Enterprise de "minutos personalizados".
El límite honesto. Dos cosas. La bolsa de minutos no se acumula, así que los minutos sin usar se reinician en cada ciclo. Y la opinión está polarizada: D-ID tiene 3.7/5 en Trustpilot con una larga cola de quejas de facturación (renovación automática, reembolsos rechazados), aunque en G2 puntúa alrededor de 4.3/5. Lee con cuidado las condiciones de facturación.
Veredicto: una opción intermedia sólida si quieres RAG y un camino sin código ya incluidos. Cuidado con la bolsa compartida de minutos que no se acumula y con la renovación automática.
4. Soul Machines
Ideal para: marcas que quieren el humano digital más expresivo emocionalmente y animado de forma autónoma, y tienen el presupuesto.
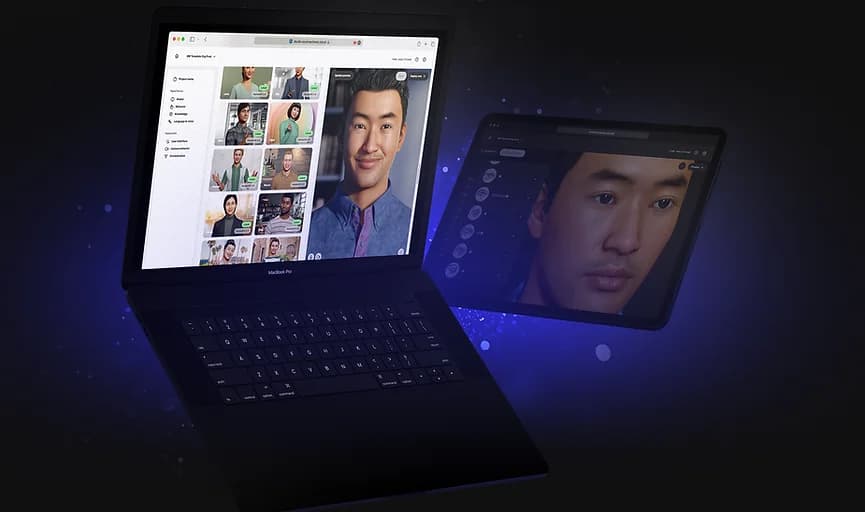
Soul Machines vende "Digital People", avatares impulsados por su Digital Brain patentado, que simula sistemas sensoriales, motores y de atención para que el rostro reaccione y exprese emociones en tiempo real, en lugar de solo sincronizar los labios. Es agnóstico respecto al LLM, construyes en Soul Machines Studio, y entre los despliegues conocidos están ANZ, Mercedes-Benz y UCSF. Si la expresividad es lo importante, es el líder de la categoría.
Precios. Algo poco habitual en un proveedor de humanos digitales, Studio tiene una tarifa pública con un plan Free solo para construir, luego Basic a $12.99/mes (40 minutos interactivos), Plus a $99/mes (350 minutos) y Pro a $2,700/mes (10,000 minutos). Su producto Workforce Connect cuesta una tarifa fija de $40,000/año y requiere una suscripción aparte a Zapier.
El límite honesto. El precio escala de forma muy abrupta, un salto de aproximadamente 27 veces de Plus a Pro, así que quien necesita volumen real de despliegue cae rápido en el rango de varios miles de dólares al mes. La cobertura de reseñas independientes también es escasa (G2 muestra solo un par de reseñas), así que compras más por las demos y los logos conocidos que por un conjunto amplio de opiniones de usuarios.
Veredicto: elígelo cuando la presencia emocional realista de verdad sea el producto, como un quiosco de marca o una experiencia insignia. Es excesivo, y caro, para el soporte rutinario.
5. Synthesia
Ideal para: video corporativo a escala (formación, onboarding, comunicación), no conversación en vivo.
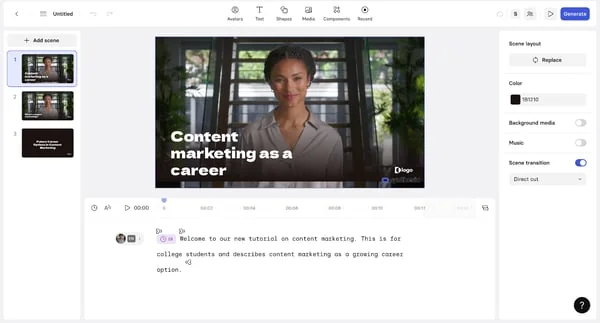
Esta viene con una salvedad, y es justo el punto. El producto principal de Synthesia es video asíncrono prerrenderizado: escribes un guion y renderiza un MP4. Es lo opuesto a un avatar en vivo. Tiene 4.7/5 en G2 con unas 2,000 reseñas, y es excelente en lo que hace, que es video de avatar pulido en muchos idiomas.
Sí tiene un producto en tiempo real, Interactive Avatars, pero es una API para desarrolladores aparte (construida sobre LiveKit, trae tu propio LLM), no uno de los planes de video estándar.
Precios. Los planes principales son Free ($0), Starter ($19/mes), Creator ($89/mes) y Enterprise, todos medidos por una bolsa de créditos compartida que se convierte en minutos de video. Free y Starter tienen un tope de unos 10 minutos de video al mes. El producto en tiempo real Interactive Avatars se factura por minuto aparte, con 500 minutos gratis para empezar.
El límite honesto. Si viniste por un avatar conversacional en vivo, el producto estrella de Synthesia tiene la forma equivocada, y su capa en tiempo real es más nueva y menos probada que la de HeyGen o Tavus. La queja más común, además de los topes bajos de minutos, es el exceso de moderación de contenido sobre lo que puedes generar.
Veredicto: la mejor herramienta de esta lista para video corporativo con guion, y una opción razonable en tiempo real solo si quieres específicamente su API Interactive Avatars. No confundas las dos.
6. OpenAI Realtime API
Ideal para: desarrolladores que construyen un agente de voz a medida, quieren un modelo de frontera y no necesitan un rostro.
La OpenAI Realtime API es el par de un gran laboratorio más cercano a la capacidad en vivo de Gemini, sin el avatar. Es infraestructura de voz a voz (audio de entrada, audio de salida) con llamadas a herramientas asíncronas nativas, MCP remoto y telefonía SIP, todo sobre WebRTC o WebSocket. El agente lo construyes tú: instrucciones, herramientas, salvaguardas. Los desarrolladores han valorado el modelo GA por costo y calidad, aunque vigilan el contador:
"I'm curious now to see how the costs associated with this would work through the API on some user-facing features."
Precios. Factura por tokens de audio, no por minutos: gpt-realtime-2.1 cuesta $32 por 1M de tokens de audio de entrada ($0.40 en caché) y $64 por 1M de tokens de audio de salida, con una versión mini más barata a $10/$20. En la práctica eso sale a unos $0.02 por minuto escuchado y aproximadamente $0.077 por minuto hablado. OpenAI también ofrece un modelo GPT-Live por minuto a $0.05/min si prefieres una medición plana.
El límite honesto. Son piezas sueltas, no un agente terminado. No hay base de conocimiento integrada, ni simulación de tickets, ni salvaguardas específicas de soporte, y las apps de navegador necesitan un proxy de tokens efímeros para no exponer tu clave. Un desarrollador también reportó que el modelo derivó a otro idioma a mitad de sesión en chats largos. Estás comprando un muy buen bloque de construcción y construyendo el resto tú.
Veredicto: la opción correcta si tienes ingenieros y quieres un modelo de voz de primer nivel sin rostro. Si quieres un agente de soporte funcionando en lugar de un kit de herramientas, es mucho ensamblaje.
7. ElevenLabs Conversational AI
Ideal para: agentes de voz que suenan humanos, especialmente por teléfono, sin construir el stack de voz desde cero.
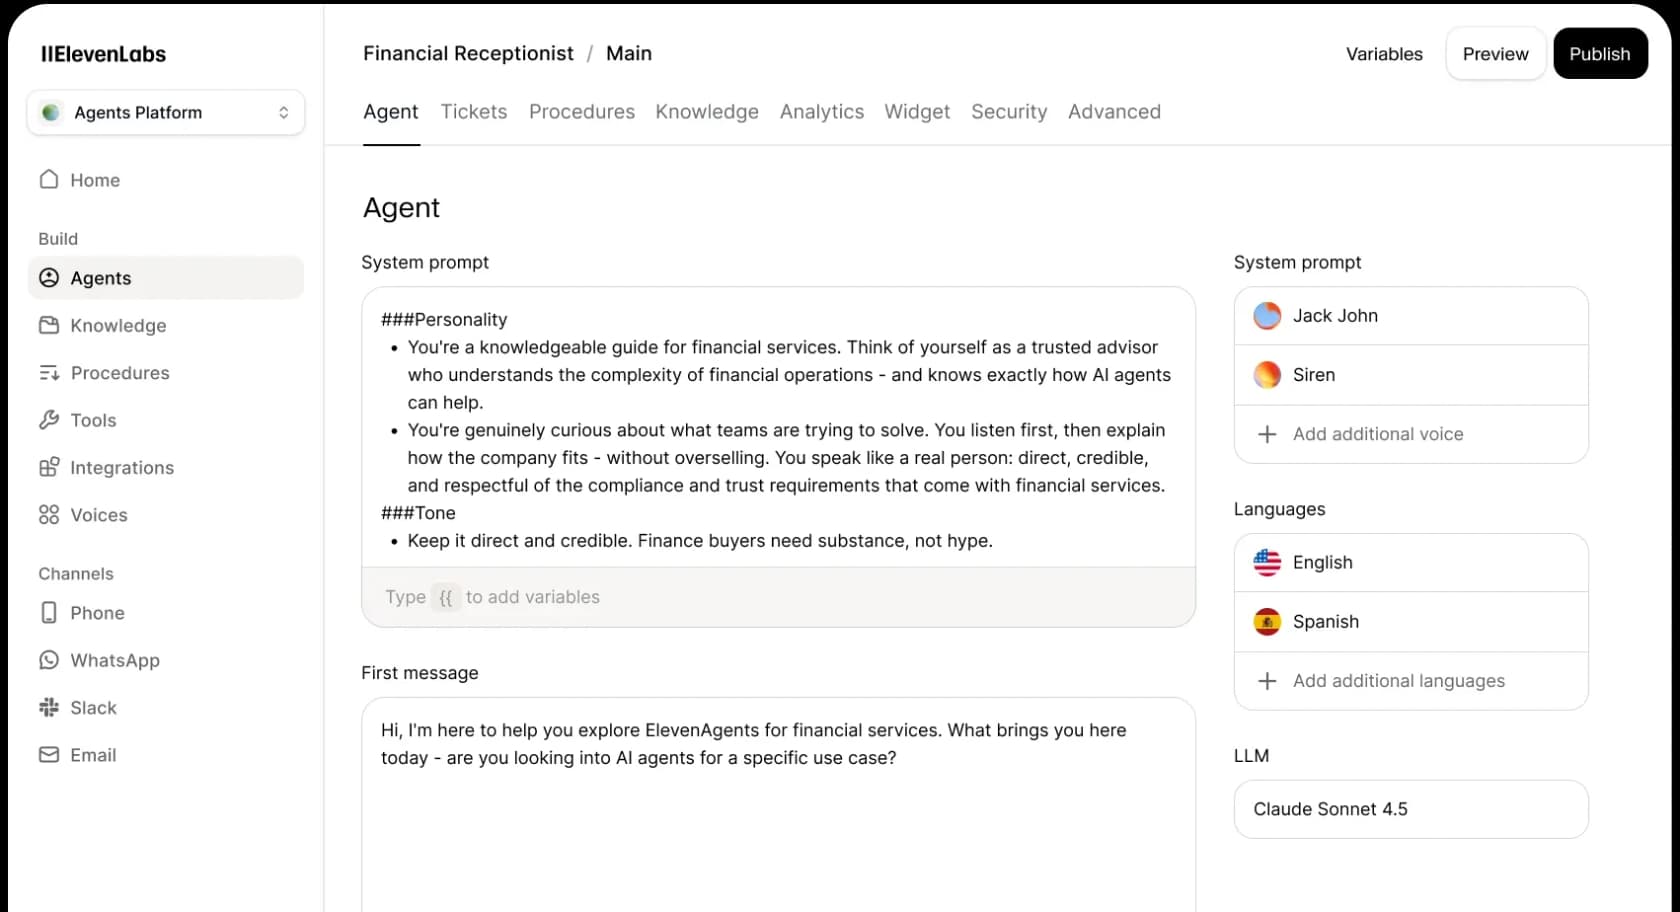
ElevenLabs es voice-first y conocido por el habla más natural de la categoría. Su Agents Platform combina reconocimiento de voz, el LLM que elijas, su síntesis de voz de baja latencia y un modelo propio de alternancia de turnos, con un constructor sin código, SDKs, telefonía Twilio/SIP, una base de conocimiento y llamadas a herramientas en más de 70 idiomas. Tiene aproximadamente 4.6/5 en G2 con unas 584 reseñas.
Precios. Los agentes se facturan por minutos de llamada: Free (15 min), Starter $6 (75 min), Creator $22 (275 min), Pro $99 (1,238 min), Scale $299 (3,738 min) y Business $990 (12,375 min). El excedente es $0.08/min y el precio en ráfaga es $0.16/min. Es clave que el uso del LLM se factura aparte, además, y la telefonía se traslada al costo.
El límite honesto. El costo efectivo se acumula: minutos de llamada más un cargo aparte del LLM más telefonía, así que los $0.08 del titular subestiman la cifra real. Los créditos de pago sin usar también caducan al bajar de plan, una queja recurrente, y algunos usuarios reportan picos de latencia de casi cuatro segundos frente a la promesa de menos de un segundo.
Veredicto: la opción solo de voz más sólida para agentes de cara al cliente, especialmente para soporte telefónico. Calcula el costo total por minuto, no solo la tarifa de lista.
Cómo funciona realmente un avatar en vivo
Quita la marca y todas las herramientas anteriores ejecutan el mismo ciclo para un turno de conversación. Vale la pena verlo, porque muestra dónde ocurre el trabajo real.
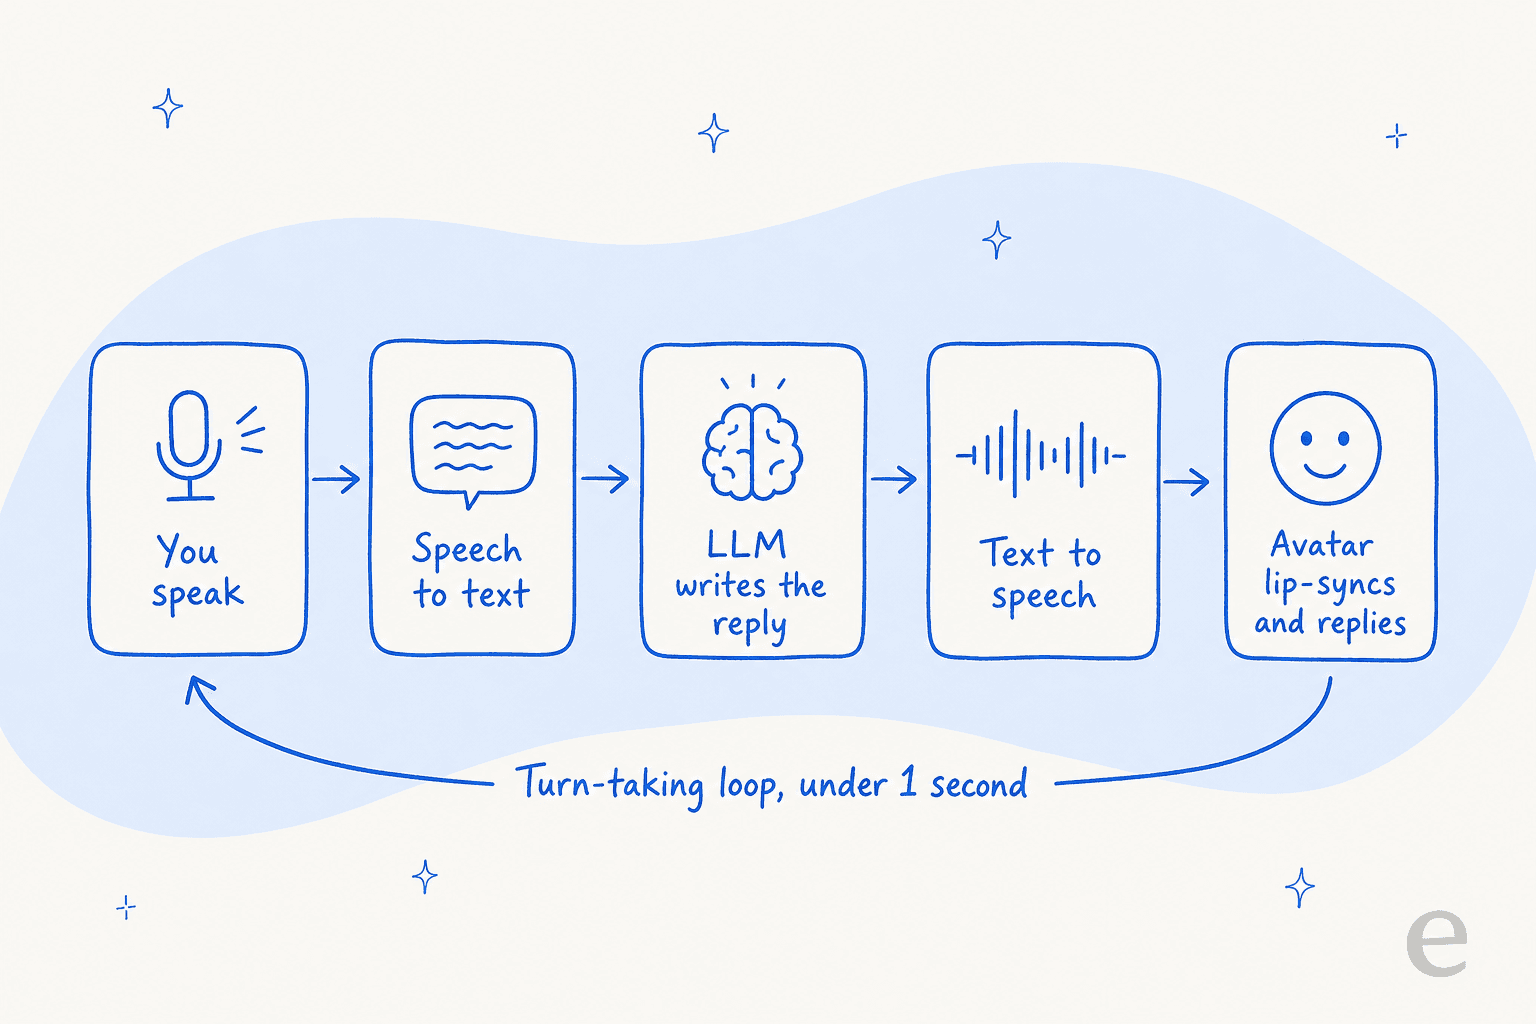
Fíjate en que cuatro de los cinco pasos (captura, transcripción, síntesis de voz, renderizado) tratan de presentación. Exactamente uno, el LLM que escribe la respuesta, decide si el cliente recibe una respuesta correcta. El avatar embellece los otros cuatro. No hace nada por el que importa, que además es la razón por la que un chatbot de IA responde mal incluso cuando suena perfectamente fluido.
Lo que un avatar no arregla
Aquí gasto la confianza del lector, porque es lo más útil de esta publicación. Tras años de poner IA en colas de soporte en vivo, el patrón que sigo viendo es que los equipos se enamoran del front end e invierten poco en la capa que realmente resuelve el ticket. Hemos visto bots que suenan seguros dar respuestas erróneas con total seguridad, por eso cada despliegue de eesel se simula con los propios tickets históricos del cliente antes de que responda a una persona real.
Los datos lo respaldan. En el ranking de soporte de τ-bench, incluso los modelos fuertes muestran un brutal precipicio de recuperación: el rendimiento puede caer unos 68 puntos al pasar de un escenario fácil de telecomunicaciones a uno de banca con mucho conocimiento, y los mejores modelos de soporte solo aciertan de forma fiable alrededor del 35 % de las veces cuando exiges cuatro respuestas correctas seguidas. Esa brecha no es un problema de renderizado. Ninguna sincronización labial la cierra.
Así que si buscas un avatar en vivo porque quieres automatizar la atención al cliente, la pregunta honesta no es "qué rostro parece más humano", sino "qué sistema da la respuesta correcta y sabe cuándo escalar". Las métricas que importan son la tasa de resolución y la precisión de escalado, no el realismo. Para muchos equipos, la respuesta no es un rostro parlante en absoluto, sino un agente de IA bien fundamentado que trabaje en los canales que los clientes ya usan: chat, correo y tickets.
Dónde encaja eesel (y dónde no)
Seré directo, porque todo el sentido de esta publicación es la honestidad: eesel no ofrece voz ni avatares. Si necesitas un rostro renderizado o una voz telefónica, elige una de las siete anteriores. Lo que eesel hace es la capa de decisión, en canales de texto.
Piénsalo así. La OpenAI Realtime API, ElevenLabs y el propio Gemini son infraestructura; eesel es el compañero de equipo de IA que contratas para hacer un trabajo. Nuestro agente de helpdesk con IA se conecta al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias, Front y más), aprende de tus tickets anteriores y tu centro de ayuda desde el primer día, y redacta o envía respuestas automáticamente cuando confías en su precisión. En lugar de "actívalo y espera lo mejor", primero ejecuta una simulación sobre tus tickets históricos para que veas la tasa de resolución antes de que un cliente llegue a él.
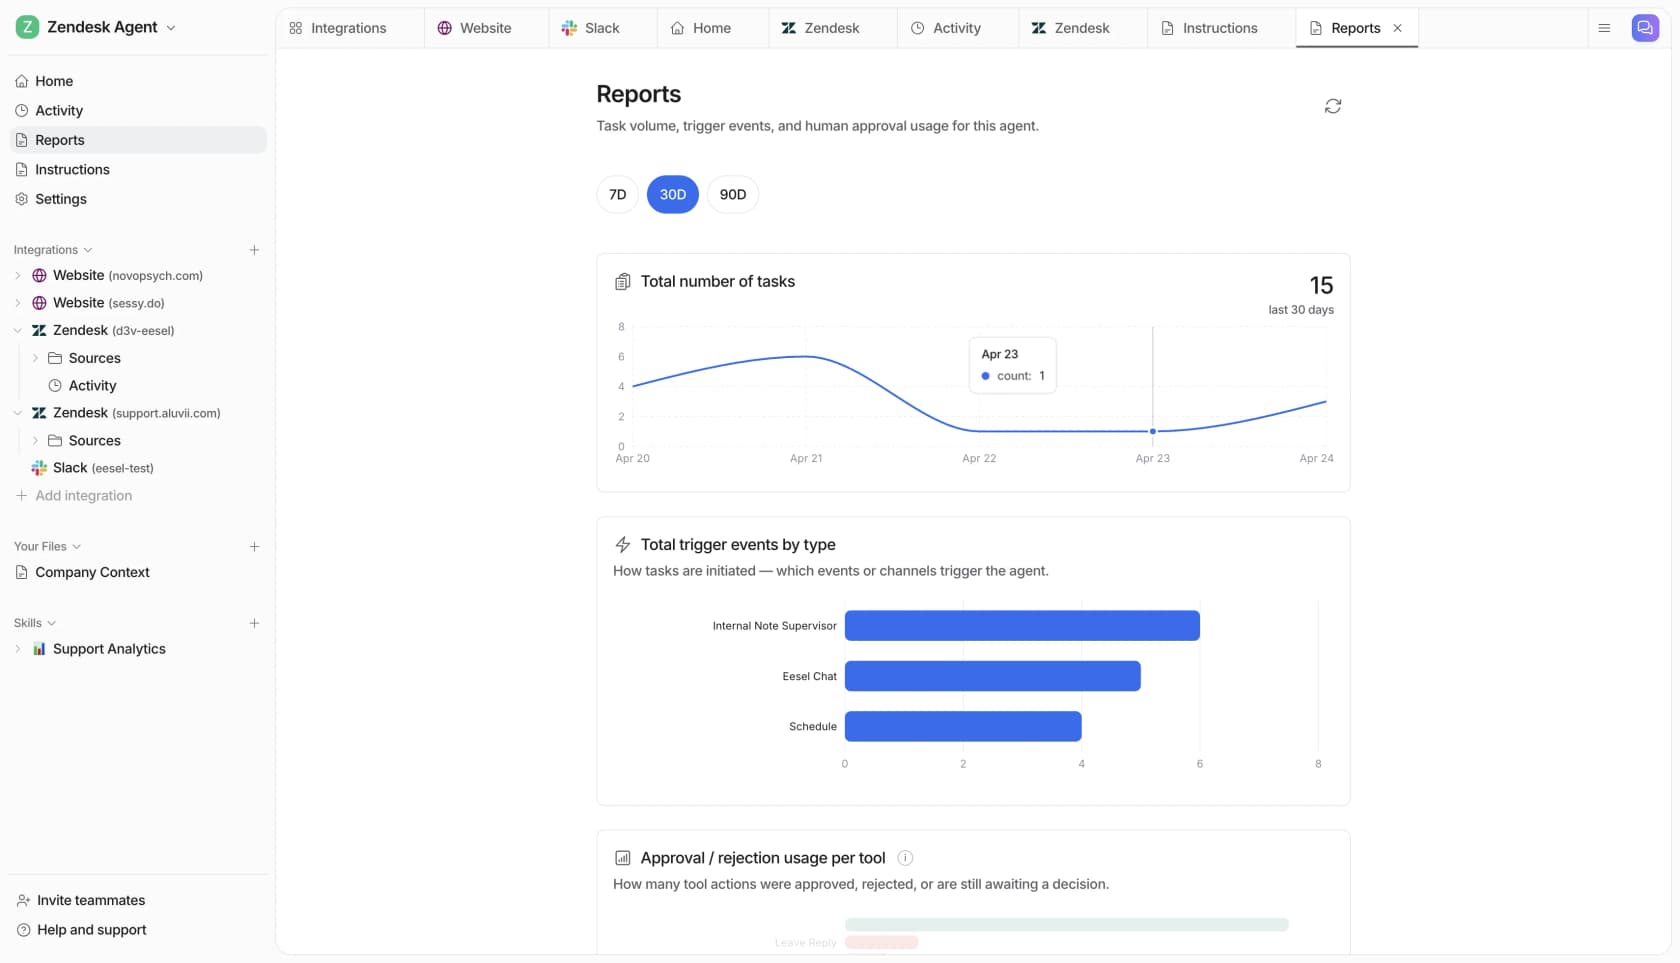
Y como esta lista está llena de APIs y SDKs, algo que conviene saber: eesel también se puede manejar desde la CLI de eesel. Es el mismo compañero de equipo que el panel, expuesto para la terminal, para scripts y para agentes de código como Claude Code, Cursor y Codex. Cada comando devuelve JSON con un campo hint que le dice a un agente qué ejecutar después, así que puedes conectar un helpdesk, subir conocimiento y configurar automatizaciones sin abrir nunca la interfaz. Cada workspace es además un servidor MCP. Es la forma amigable para agentes de operar el mismo compañero de soporte, si así le gusta trabajar a tu equipo.
Si el trabajo es un rostro realista, esta lista te cubre. Si el trabajo es resolver tickets correctamente, para eso se construyó eesel, y puedes probarlo gratis.