

El 2 de septiembre de 2026, Google lanzó Gemini 3.8 Flash Cyber junto con el Gemini 3.8 Flash general. Es una versión del mismo modelo ajustada para hacer bien una sola tarea: encontrar y parchear vulnerabilidades de seguridad en software. Sustituye al anterior 3.5 Flash Cyber, y Google dice que el entrenamiento en ciberseguridad fue lo que impulsó también las mejoras de programación y razonamiento del modelo general.
Dos cosas que debes saber antes de hacerte ilusiones. Primero, casi seguro que no puedes usarlo: está limitado a defensores de confianza a través del Fairwind Program de Google, sin API pública ni acceso de autoservicio. Segundo, es el tercer gran laboratorio seguido que restringe su modelo cibernético más potente tras un programa de solicitud. OpenAI lo hace con GPT-5.6-Cyber a través de Daybreak, y Anthropic fue la primera, en abril, con Claude Mythos 5 a través de Project Glasswing.
Si eres un defensor que no puede entrar en ninguno de estos programas, la conclusión práctica es la que siempre repito al construir agentes de IA: el modelo es la capa inferior y barata, y el sistema que lo rodea es lo que hace el trabajo real. Eso es tan cierto para un agente de seguridad como para uno de soporte.
Qué es realmente Gemini 3.8 Flash Cyber
La familia Gemini de Google se divide en modelos Pro para el razonamiento más exigente y modelos Flash como caballos de batalla rápidos y baratos. Flash Cyber es una tercera cosa: un especialista. Google tomó el Gemini 3.8 Flash general y lo empujó a fondo en un dominio estrecho y de alto riesgo: detectar, validar y parchear vulnerabilidades en el código, a un precio por token menor del que costaría un gran modelo de frontera.
El giro interesante esta vez es en qué dirección fluyó el beneficio. Con Gemini 3.5 Flash Cyber el año pasado, el modelo cibernético era claramente un especialista derivado. Para el 3.8, Google dice que ambas variantes comparten la misma inteligencia de base, y que el entrenamiento cibernético es parte de la razón por la que el modelo general mejoró en programación y razonamiento. El trabajo de seguridad resulta ser un maestro exigente: leer código desconocido, formular una hipótesis sobre dónde se rompe y demostrarlo es un bucle de razonamiento difícil, y entrenar con él parece rendir frutos en todos los frentes.
Este es el enfoque honesto que omite la mayor parte de la cobertura del lanzamiento: Flash Cyber no es un chatbot con el que conversas. Es un componente para ejecutarse sobre enormes bases de código, una y otra vez, buscando agujas. Es exactamente el tipo de trabajo de volumen para el que existe la línea Flash, y por eso Google construyó el especialista en seguridad sobre Flash y no sobre un modelo Pro más pesado. Lo bastante barato para ejecutarlo cien veces gana a lo bastante listo para ejecutarlo una.
Quién puede conseguirlo realmente: el Fairwind Program
Ahora la parte que frena en seco a la mayoría de los lectores. Gemini 3.8 Flash Cyber solo está disponible para defensores de confianza a través del Fairwind Program. No hay interruptor en AI Studio, ni clave de API, ni plan de autoservicio.
La razón está en la propia preocupación: el doble uso. Un modelo excelente para encontrar errores explotables es, por lo mismo, una herramienta que un atacante adoraría. Así que Google lo restringe como se restringe cualquier capacidad que ayuda por igual a defensores y atacantes: un despliegue controlado, primero, a un conjunto de usuarios verificados. El 3.8 Flash general se entrega con las salvaguardas habituales contra CBRN y ciberofensiva; la variante Cyber funciona con "un conjunto más permisivo de mitigaciones" y queda aislada tras el programa.
Los socios de Fairwind citados dan una idea de quién es un "defensor de confianza" en la práctica: equipos de seguridad e infraestructura en Palo Alto Networks (Charlie Sestito), Snowflake (Mayank Upadhyay), Wiz (Gal Nagli) y Armadin (David Slater). Si eres un desarrollador independiente y esperas apuntarlo a tus propios repositorios esta tarde, eso no está sobre la mesa.
¿Qué tal funciona? Los benchmarks para defensores
Google no empezó con la típica tabla sintética. Empezó con lo que sus propios equipos de seguridad y socios obtuvieron del modelo, que es una señal más útil que otro benchmark saturado.
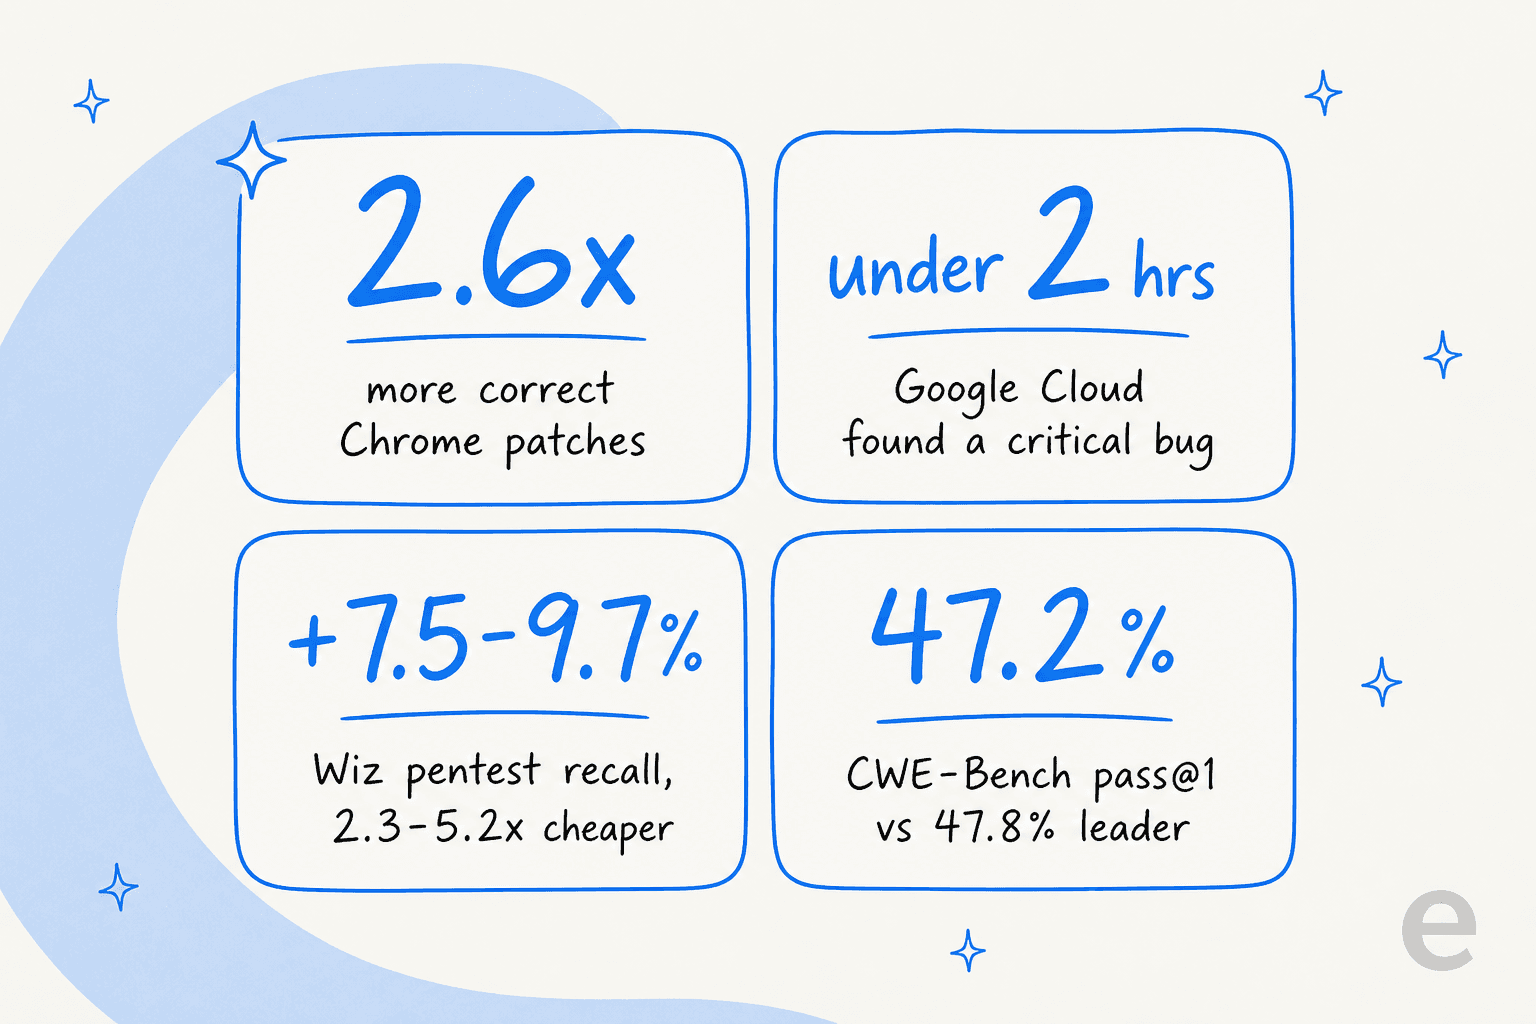
El equipo de Chrome Security informó de que el modelo produjo 2,6 veces más parches correctos para vulnerabilidades de Chrome que los mejores modelos comerciales, que son mucho más grandes. Wiz midió un recall entre 7,5 % y 9,7 % superior en su benchmark interno de pentesting con un coste entre 2,3 y 5,2 veces menor, un buen ejemplo del equilibrio "capacidad por dólar" que la línea Flash está diseñada para ganar. Y el equipo de Vulnerability Research de Google Cloud encontró una vulnerabilidad fundamental crítica en menos de dos horas, un trabajo que según Google suele llevar meses.
En las cifras más comparables, la historia es deliberadamente modesta. En CWE-Bench, un benchmark de parcheo automático dirigido por Collinear, Gemini 3.8 Flash Cyber logró 47,2 % de pass@1 frente al 47,8 % de un modelo de frontera líder, básicamente empate, pero a un coste significativamente menor, que es el punto de la frontera de Pareto que defiende Google. En un benchmark interno que abarca 20 lenguajes de programación logró una tasa de éxito superior al 70 %, y Google dice que supera tanto a 3.5 Flash Cyber como a modelos de frontera significativamente mayores en CyberGym, un benchmark de descubrimiento autónomo de vulnerabilidades.
La lectura es la misma con la que la línea Flash gana en general: no "cima del ranking", sino rendimiento competitivo de frontera por una fracción del coste, porque el ajuste fino y el arnés cargan con el peso que de otro modo tendría que soportar el número bruto de parámetros.
El patrón más amplio: ahora todos restringen su modelo cibernético
Si solo lees la publicación de Google, podrías pensar que un modelo cibernético restringido es cosa de Google. No lo es. Ya es la norma de la industria, y Google es la última en moverse.
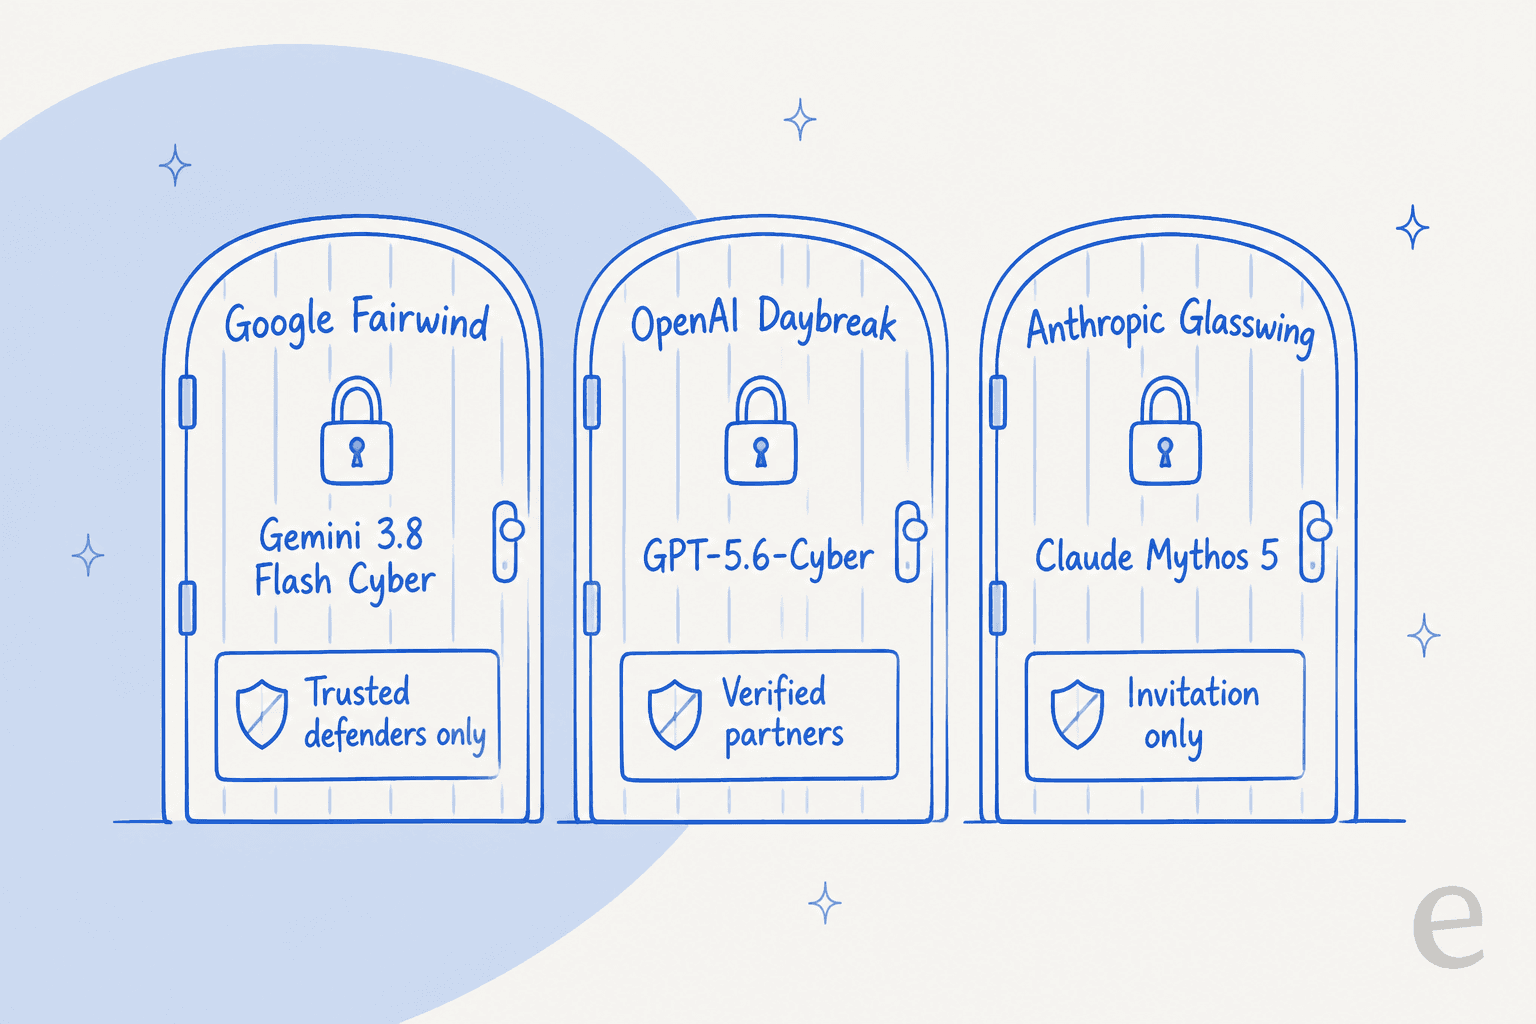
OpenAI restringe GPT-5.6-Cyber a través de su programa Daybreak. Es un modelo entrenado por separado sobre GPT-5.6 Sol, accesible mediante vías verificadas para individuos y socios, y OpenAI nunca ha publicado un precio: la fila Cyber de su tarifario está literalmente en blanco.
Anthropic fue la primera. Project Glasswing arrancó el 7 de abril de 2026, más de dos meses antes que el programa de OpenAI, con un compromiso de 100 M$ en créditos de uso y una docena de socios de lanzamiento. Su modelo restringido, Claude Mythos 5, adopta un enfoque de diseño más limpio: son los mismos pesos subyacentes que el Claude Fable 5 de disponibilidad general, con las salvaguardas de ciberseguridad retiradas en lugar de un reentrenamiento desde cero. Anthropic también publica el precio (10 $ / 50 $ por millón de tokens), algo que ninguno de los otros dos laboratorios hace con sus modelos cibernéticos.
Así se alinean los tres programas:
| Dimensión | Google Fairwind | OpenAI Daybreak | Anthropic Glasswing |
|---|---|---|---|
| Modelo restringido | Gemini 3.8 Flash Cyber | GPT-5.6-Cyber | Claude Mythos 5 |
| Diseño del modelo | Misma base que el 3.8 Flash general | Entrenado por separado sobre Sol | Mismos pesos que Fable 5, salvaguardas retiradas |
| Acceso | Defensores de confianza, solo por solicitud | Socios verificados + vía individual | Solo por invitación, sin autoservicio |
| Precio público | Ninguno | Ninguno | 10 $ / 50 $ por 1 M de tokens |
| Lanzamiento | 2 sep 2026 | 10 ago 2026 | 7 abr 2026 |
Lo que conviene meditar: un gobierno intervino y apagó por completo los modelos de Anthropic durante 18 días por una disputa sobre jailbreaks a principios de este año. Cuando una capacidad es tan de doble uso que un actor estatal desenchufa, la restricción deja de parecer una decisión de marketing y pasa a parecer una característica estructural de toda la categoría.
¿Y si no puedes conseguir ninguno?
Para la mayoría de los equipos, la respuesta a "¿qué modelo cibernético restringido debería usar?" es "ninguno, porque no puedes". Así que la pregunta útil pasa a ser qué puedes hacer.
Si de verdad necesitas capacidad de seguridad de doble uso, la vía más práctica hoy es el Cyber Verification Program de Anthropic, una solicitud gratuita con tu organización existente y un plazo de unos dos días hábiles, que relaja las salvaguardas en modelos de clase Opus y Sonnet (no en Mythos). La búsqueda de vulnerabilidades en código fuente ya funciona de serie en Claude Opus 5, y es lo más parecido a un nivel de confianza de autoservicio que ofrece cualquier laboratorio.
Pero da un paso atrás, porque aquí es donde el lanzamiento importa aunque nunca toques el modelo. Gemini 3.8 Flash Cyber es un caso de estudio limpio de un patrón que encuentro en cada proyecto de agente de IA: el modelo es la capa inferior, no el todo. Google no lanzó un "modelo de seguridad" y se dio por satisfecha: envolvió el modelo en un sistema que detecta un error, demuestra que es real, escribe una corrección y comprueba que la corrección no rompió la compilación. La inteligencia reside tanto en esa envoltura como en los pesos en bruto.
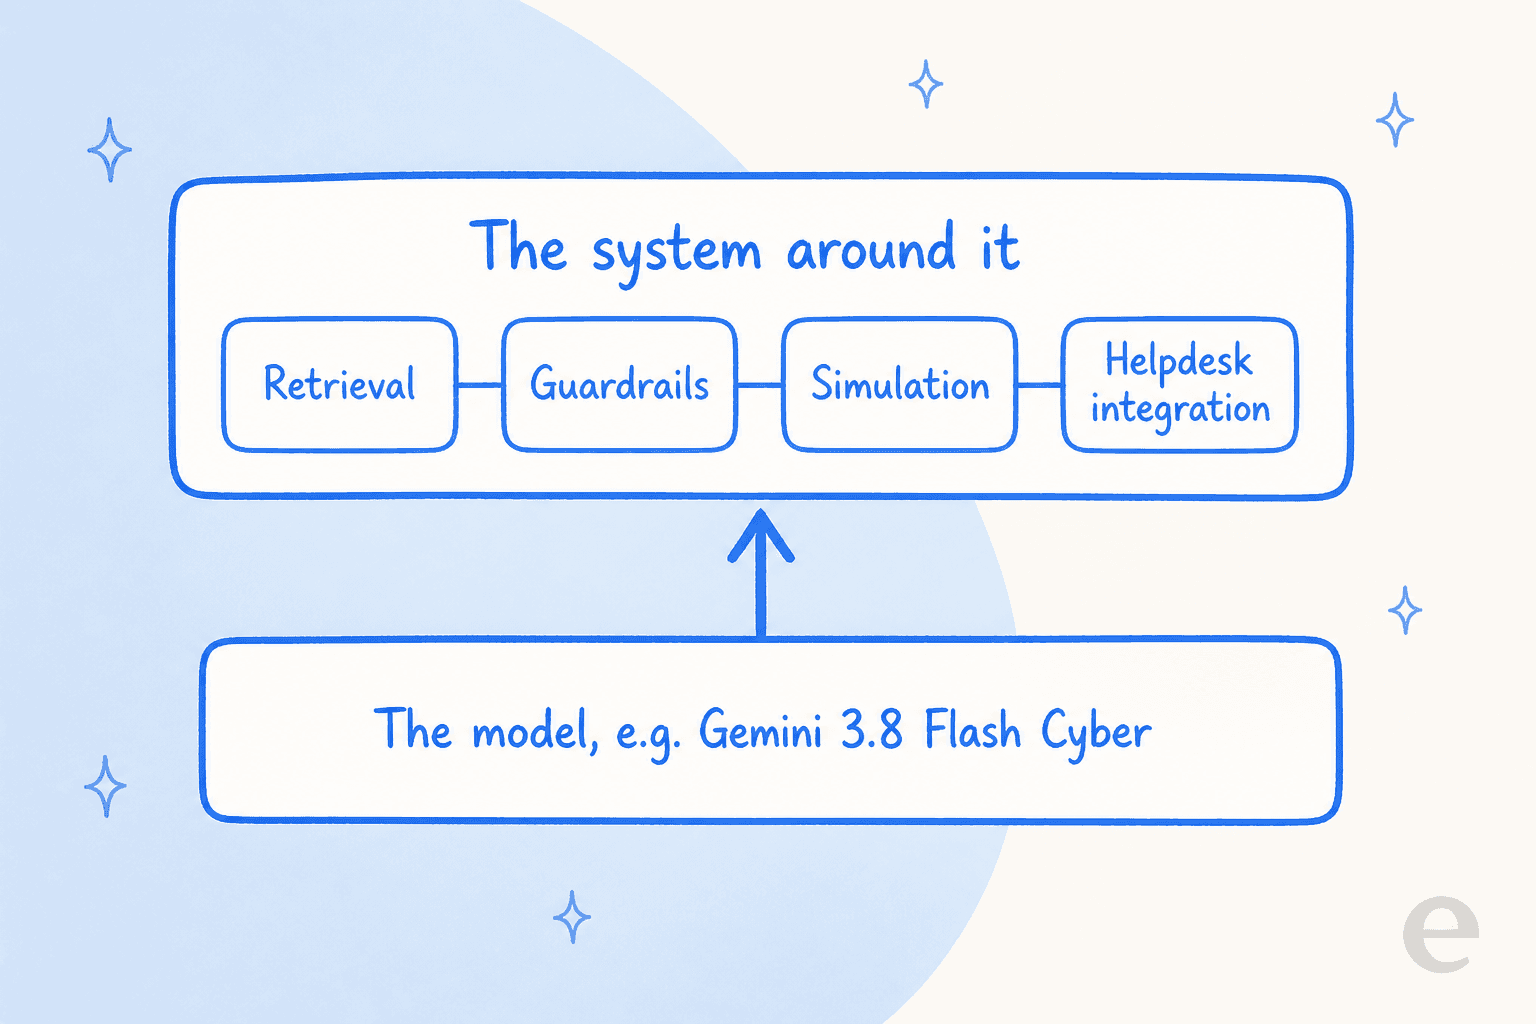
He pasado años en el equipo que pone IA en colas de soporte reales, y el fallo que he visto una y otra vez es el mismo que un buen arnés de seguridad está diseñado para evitar: un modelo que suena seguro da una respuesta incorrecta porque nadie construyó las capas a su alrededor. En seguridad, una "corrección" sin validar que rompe la compilación es el modo de fallo. En el servicio de atención al cliente, es un bot seguro de sí mismo que se inventa una política de reembolsos. La misma enfermedad, distinto dominio. La cura también es la misma: recuperación de información para que el modelo responda desde fuentes reales en lugar de adivinar, barreras de seguridad para que traspase limpiamente, y pruebas para saber cómo se comporta antes de que toque nada real.
Así que cuando llegue un modelo nuevo, ya sea Cyber, el 3.8 Flash general o lo siguiente dentro de tres semanas, la pregunta correcta para un equipo de soporte no es "¿es el modelo lo bastante bueno?". Para la mayoría del trabajo, ya lo es. La pregunta real es quién construye la recuperación, las barreras de seguridad, la simulación y la integración con el helpdesk a su alrededor, porque ese es el trabajo de verdad, y por eso conectar tú mismo una API en bruto a tu helpdesk es una trampa.
Prueba eesel
Un modelo de frontera es infraestructura. eesel es el compañero que contratas encima. Para soporte, la capa que un arnés de seguridad es para un modelo cibernético, eesel lo es para tu helpdesk: un compañero de soporte con IA que se conecta a tus herramientas existentes, aprende de tus tickets pasados y de tu base de conocimiento desde el primer momento, y funciona sobre modelos de frontera para que obtengas las mejoras de capacidad sin conectar la API tú mismo.

La parte que se corresponde directamente con la idea de "validar antes de lanzar" es la simulación: eesel ejecuta al compañero contra tus tickets históricos antes de que responda a un solo cliente real, de modo que ves la tasa de resolución y las respuestas exactas que habría enviado. Y como se cobra por el trabajo que realiza en lugar de por token, te ahorras las cuentas de tokens en cada ticket. Si estás evaluando modelos para construir automatización de soporte, parte del resultado que quieres y deja que la plataforma elija la fontanería. Es gratis probarlo.