

Un agente de voz con IA para atención al cliente contesta llamadas telefónicas por sí solo: transcribe lo que dice quien llama (reconocimiento de voz), razona con un LLM sobre tu conocimiento y tus sistemas y luego responde hablando (síntesis de voz), todo en alrededor de un segundo. Lo difícil no es la IA, es la infraestructura en tiempo real. Quien llama nota el retraso a partir de 800 ms, así que todo el recorrido va con cronómetro.
En cuanto al coste, la voz se factura por minuto. Las plataformas llave en mano sitúan la mayoría de las llamadas de soporte en una banda de 0,07 a 0,16 $ por minuto antes de la línea telefónica, así que una llamada de 5 minutos cuesta aproximadamente de 0,35 a 0,80 $ más la telefonía.
Lo que yo me tatuaría en cada despliegue: la IA de voz funciona cuando deriva a una persona y falla cuando intenta reemplazarla. Llevo años poniendo IA en colas de soporte en vivo, y la mayor lección es confianza por encima de cobertura. Deja que el agente gestione lo que tiene claro y pasa el resto. Esa lección vale para cualquier canal, y por eso conviene acertar con el enfoque del agente de IA para helpdesk que resuelve tus chats y tickets antes de añadirle una línea telefónica.
Qué es realmente un agente de voz con IA
Sin el marketing, un agente de voz con IA es un sistema que descuelga el teléfono, entiende a quien llama en lenguaje natural, hace el trabajo y responde hablando, sin una persona en la línea durante la mayor parte de la llamada. El diseño dominante encadena tres modelos especializados: reconocimiento de voz (STT), un modelo de lenguaje grande (LLM) para pensar y síntesis de voz (TTS), todo sobre una capa de telefonía que conecta la llamada real. Twilio lo llama la arquitectura de agente de voz en cascada, donde "the user's speech is transcribed, the transcript is processed by an LLM, then the resulting tokens are synthesized into audio."
Una variante más reciente reúne esa cadena en un solo modelo. La Realtime API de OpenAI funciona directamente de voz a voz, lo que "reduces latency, preserves nuance in speech, and produces more natural, expressive responses."
Dos comparaciones lo aclaran:
- No es el viejo menú telefónico. "Pulse 1 para facturación" (IVR) solo entiende tonos del teclado o unas pocas palabras guionizadas y obliga a todos a recorrer el mismo menú rígido. Un agente de voz deja que la persona describa el problema con sus palabras y desde ahí deriva o resuelve.
- Es el primo de voz de un chatbot de texto, en un medio mucho más difícil. El chat es por turnos y perdona uno o dos segundos de retraso. La voz es síncrona y en tiempo real, y esa diferencia es todo el reto de ingeniería. Si has leído sobre la diferencia entre un agente de IA y un chatbot basado en reglas, este es ese mismo salto, más un problema de audio en tiempo real encima.
Cómo funciona un agente de voz con IA, paso a paso
Este es el camino completo de una llamada de soporte, del timbre a la respuesta.
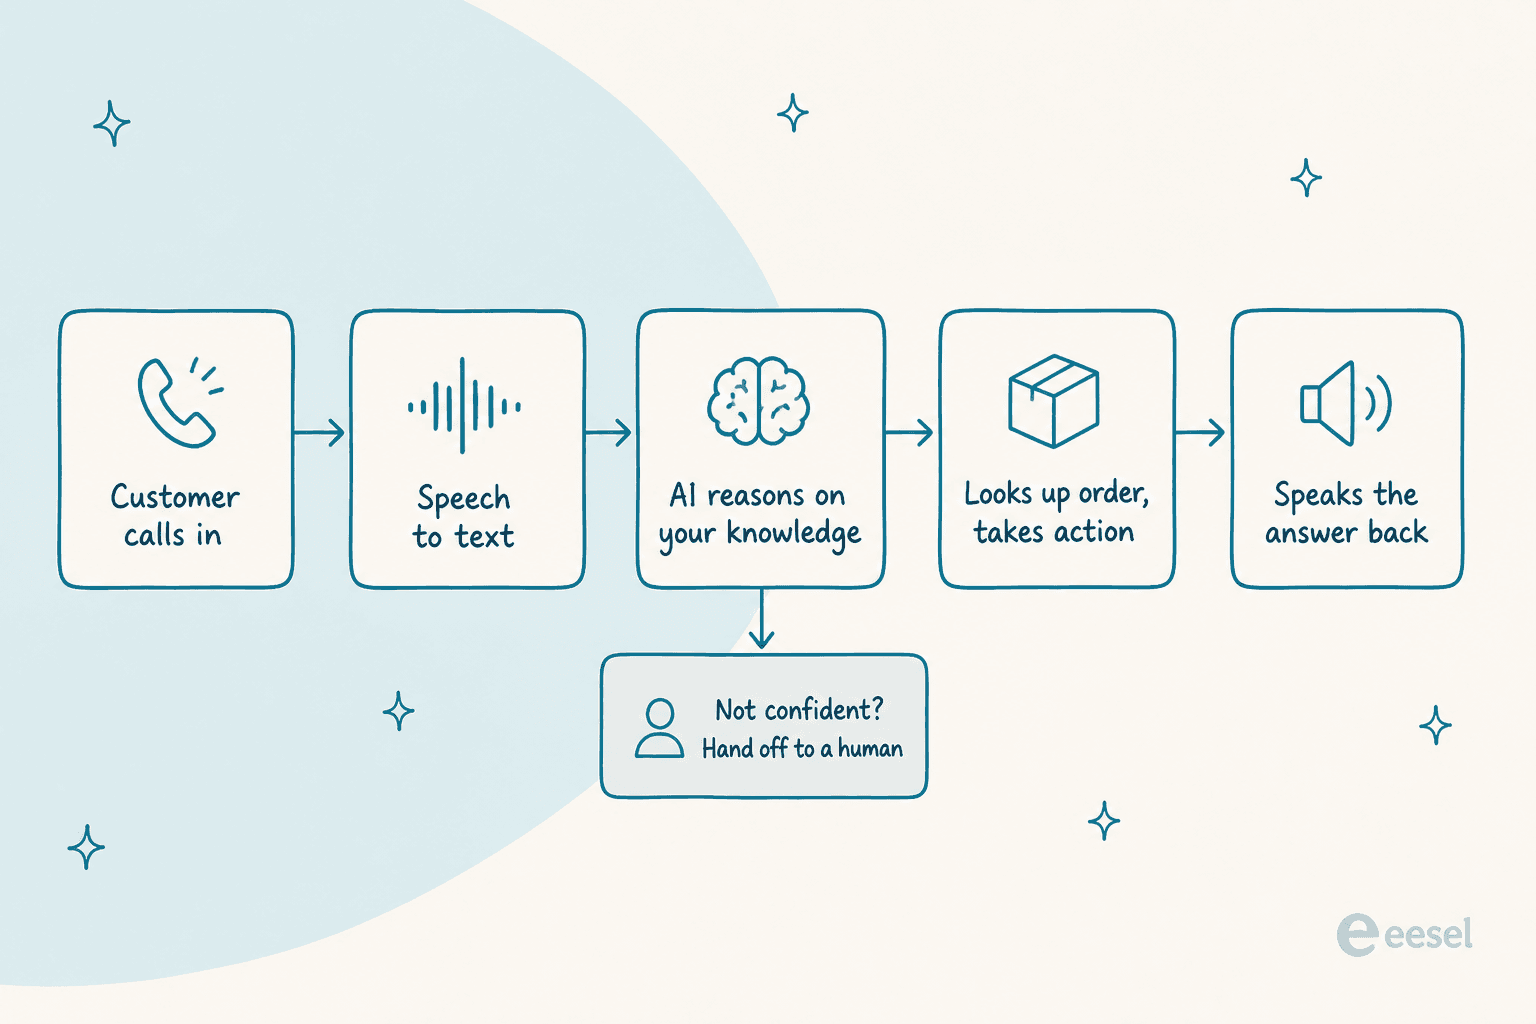
Telefonía (la línea telefónica). La llamada llega por la red telefónica (PSTN) o una conexión SIP. Twilio lo expone como un elemento <ConversationRelay> que "handles the complexities of live, synchronous voice calls," y OpenAI añadió hace poco las llamadas telefónicas por SIP a su Realtime API.
Reconocimiento de voz. El audio de quien llama se transcribe en directo. Lo realmente difícil aquí no es el reconocimiento, sino el endpointing: saber cuándo la persona ha terminado de hablar, ya que una breve pausa a mitad de frase "can sound identical to an end-of-turn pause." Los buenos sistemas mantienen dos búferes de transcripción, una suposición provisional y un registro confirmado, para empezar a pensar pronto y corregir después.
LLM más recuperación de conocimiento. La transcripción pasa a un LLM que averigua lo que necesita quien llama y extrae respuestas fundamentadas de una base de conocimiento en lugar de adivinar. La construcción de referencia de AWS combina Amazon Connect, Lex y Bedrock Knowledge Bases para que el agente responda con contenido recuperado de la empresa. Este paso de recuperación es la misma razón por la que un buen agente de texto necesita entrenarse con tu base de conocimiento antes de decir una palabra.
Acciones en sistemas de negocio. Un agente en producción no solo habla, llama a herramientas: consultar un pedido, revisar un registro del CRM, crear un ticket. gpt-realtime de OpenAI añadió compatibilidad con servidores MCP remotos para que puedas apuntar una sesión a un conjunto de herramientas, e hizo asíncronas las llamadas largas para que "the model can continue a fluid conversation while waiting on results."
Síntesis de voz. Las palabras del modelo se envían de vuelta como voz sintetizada. Flux TTS de Deepgram entrelaza la generación de texto y audio para que la longitud de la respuesta no aumente la latencia del primer audio, con un primer audio "as low as 80ms."
Esa última cifra apunta a la historia real. Cada una de estas etapas corre contra el reloj, que es el tema de la siguiente sección.
Por qué la voz es mucho más difícil que un chatbot
Si has creado un agente de texto, tu instinto es que la voz es "lo mismo, pero hablado." No lo es. La voz añade una serie de restricciones en tiempo real que el chat simplemente no tiene.
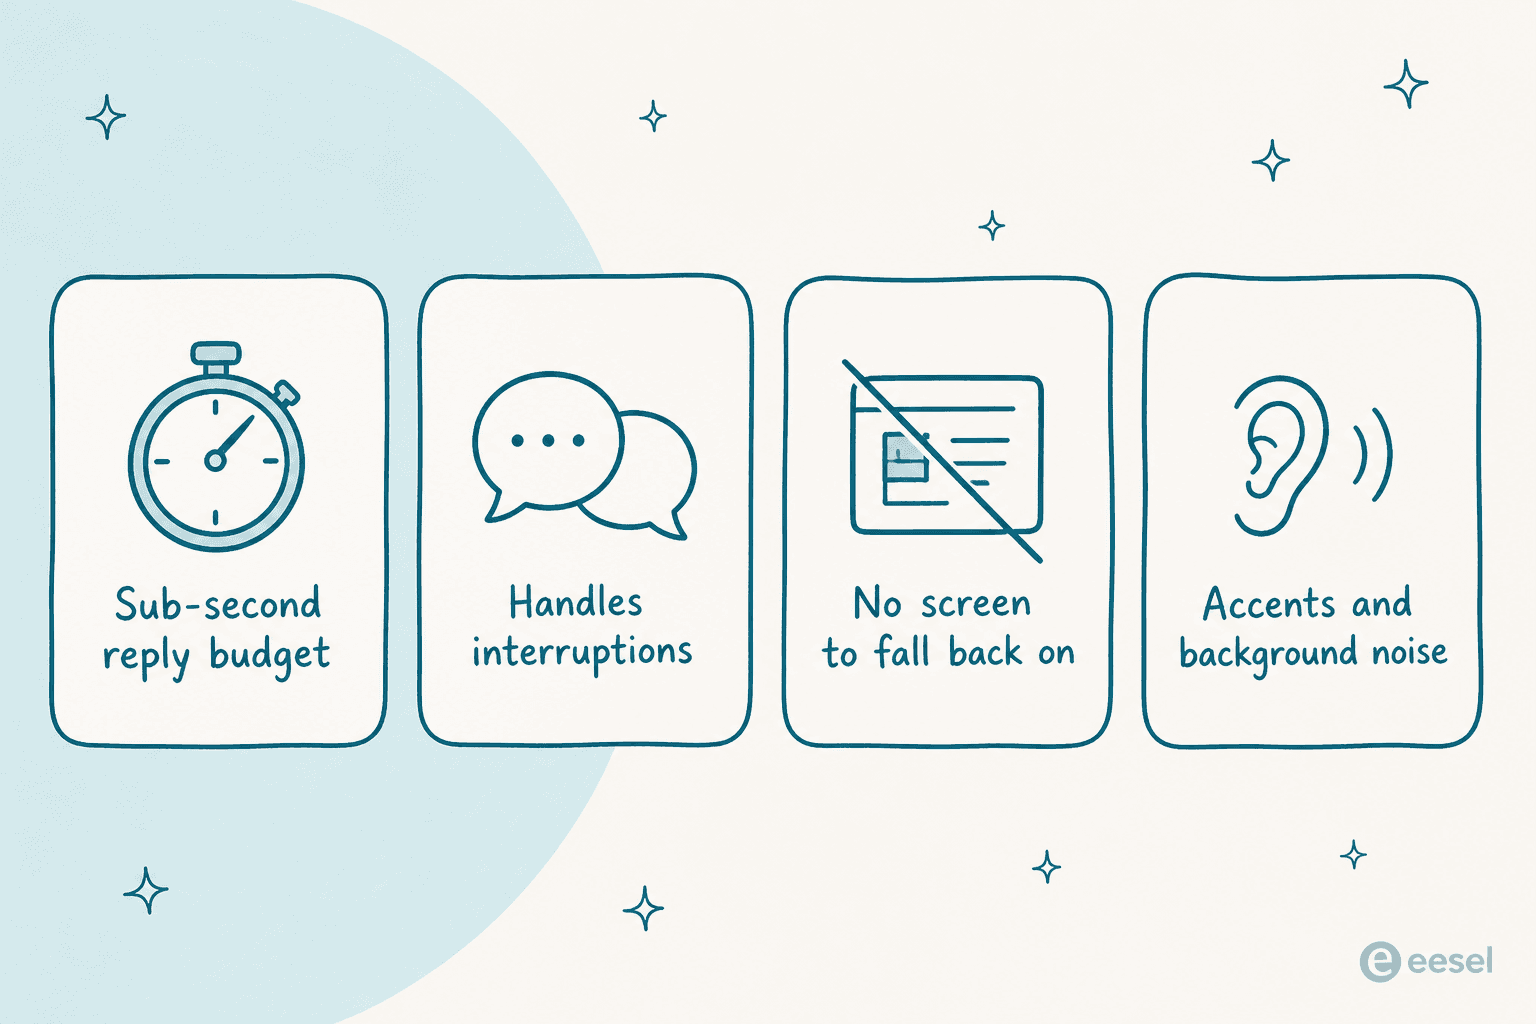
El reloj es lo más importante. Twilio, al publicar sus propios objetivos de lanzamiento a finales de 2025, define la latencia como el "mouth-to-ear turn gap" y fija un objetivo de extremo a extremo de 1.115 ms, con un límite superior de 1.400 ms. Ese presupuesto no se gasta en un solo sitio. Se acumula en aproximadamente STT 350 ms, LLM 375 ms, TTS 100 ms, más red y búfer, y como esas cifras se suman, "acceptable numbers at each stage can still sum to a broken conversation." Deepgram sitúa el umbral de percepción aún más abajo: quienes llaman "start noticing lag near 800ms of total round-trip time."
Luego está todo lo que hace quien llama y que un usuario de chat nunca hace. Interrumpen. Gestionar ese "barge-in" significa cancelar la respuesta en curso en el instante en que la persona interviene, por lo que la API de agentes de Deepgram incluye detección de barge-in integrada y predicción de turnos. También llaman desde sitios ruidosos, con acentos y sin pantalla a la que recurrir, así que no hay salida del tipo "haz clic en el botón de abajo" cuando el audio no es claro.
Un desarrollador que reconstruyó un bucle de voz desde cero situó la dificultad exactamente donde corresponde:
"The hard part isn't STT, LLMs, or TTS in isolation, but turn-taking: detecting when the user starts and stops speaking, cancelling in-flight generation instantly, and pipelining everything to minimize time-to-first-audio... By colocating Twilio, Deepgram, ElevenLabs, and the orchestration layer, I reached ~790ms end-to-end latency."

Hay que reconocer que los modelos han mejorado mucho. gpt-realtime obtiene un 82,8 % en la evaluación de razonamiento Big Bench Audio, frente al 65,6 % del modelo de OpenAI de finales de 2024, y puede captar señales no verbales como risas y cambiar de idioma a mitad de frase. La inteligencia no suele ser lo que rompe una demo de voz. Lo que falla es la infraestructura que la rodea.
Cuánto cuesta realmente un agente de voz con IA
Esta es la parte que la mayoría de las páginas de proveedores esconde: la IA de voz se factura por minuto de conversación, y la cifra por minuto del titular casi nunca es la factura completa. Según el proveedor, se suman además telefonía (la línea telefónica), STT, el LLM y TTS, a veces agrupados, a veces repercutidos "a coste" y a veces como partidas separadas que montas tú mismo.
Predominan tres modelos de precios:
- Todo incluido por minuto (Bland, Retell, ElevenLabs Agents): una tarifa combinada que ya incluye STT, LLM y TTS. Más sencillo, normalmente con un precio de portada algo mayor.
- Cuota de plataforma más repercusión de costes (Vapi): una tarifa fina de orquestación por minuto y luego pagas STT, LLM y TTS a coste. El suelo más barato, con más piezas móviles.
- Componente o infraestructura (Twilio, Deepgram, OpenAI, Amazon Connect): compras una capa y conectas el resto tú mismo.
| Proveedor | Plan / nivel | Tarifa publicada | Qué incluye | Repercutido o aparte |
|---|---|---|---|---|
| Bland AI | Start (dev) | $0.14 / min | LLM, STT, TTS todo incluido, "no model pass-throughs" | Número entrante ~15 $/mes; 0,05 $/min de transferencia |
| Retell AI | Pay-as-you-go | $0.07-$0.31 / min (~$0.115 punto medio) | Infraestructura de voz + LLM + TTS combinados | 10 $ de crédito gratis; telefonía ~0 $ si traes la tuya |
| Ringly | Pago por conversación | 99 $/mes incluye 50 conversaciones; luego 1,99 $/conversación | Soporte telefónico con IA conectado a Shopify | Las llamadas en las que Seth ayuda antes del traspaso son facturables; tarifas personalizadas desde 1.000+ llamadas/mes |
| Vapi | Build (uso) | $0.05 / min cuota de plataforma | Solo orquestación de Vapi | STT/LLM/TTS a coste; 10 $/línea/mes a partir de 10 |
| Deepgram | Voice Agent API (Standard) | $0.075 / min | Paquete de Deepgram STT + LLM + TTS | LLM propio 0,065 $/min; Advanced 0,163 $/min |
| ElevenLabs Agents | Tarifa por exceso | $0.08 / min (burst $0.16) | TTS + orquestación + minutos del plan | LLM facturado aparte; telefonía aparte |
| Twilio | ConversationRelay | $0.07 / min | Solo orquestación de voz con IA | + PSTN $0.0085-$0.014/min + tu propio STT/LLM/TTS |
| Amazon Connect | Voz (uso) | $0.038 / min de voz | Telefonía de contact center + plataforma | Telefonía + complementos de Amazon Q / Contact Lens |
| OpenAI Realtime | gpt-realtime-2.1 | $32 / 1M tokens de audio de entrada, $64 / 1M de audio de salida | Solo el modelo | ~0,06-0,24 $/min en la práctica; sin telefonía |
Ringly es otro tipo de compra: un servicio centrado en Shopify que se factura por conversación, en lugar de infraestructura de voz facturada por minuto. El ejemplo siguiente se aplica a las plataformas por minuto.
Un ejemplo práctico muestra cómo se acumula. Supón que gestionas 2.000 llamadas de soporte al mes con una media de 4 minutos. En una plataforma todo incluido a unos 0,12 $/min, son 8.000 minutos, unos 960 $ de coste de plataforma. Añade una línea telefónica tipo Twilio a ~0,01 $/min y estás cerca de 1.040 $, más el alquiler del número y los minutos de transferencia a una persona. Barato por llamada, pero sube con el volumen, y las llamadas más largas y enrevesadas (las que crea un caso límite) son las caras.
Algunas trampas que conviene tener en cuenta antes de firmar nada:
- La telefonía casi siempre va aparte, incluso con proveedores "todo incluido". Es una partida real por minuto más de 1 a 2 $ por número, y las tarifas internacionales son mucho más altas.
- "A coste" no es gratis. El suelo de 0,05 $/min de Vapi es real, pero STT más LLM más TTS a coste suman fácilmente de 0,05 a 0,10 $, y acabas en la misma banda que los proveedores todo incluido.
- El cumplimiento normativo es un extra. HIPAA y Zero Data Retention son niveles de pago en algunas plataformas; un BAA suele reservarse al plan Enterprise.
Si tras esa tabla tu impresión es que el precio por minuto es impredecible, es la lectura honesta. Es una razón por la que los canales de texto, donde eesel usa planes mensuales de créditos con un crédito por ticket o chat de cliente en lugar de por minuto de conversación, suelen ser más fáciles de prever. Nuestro desglose completo del coste de un agente de IA frente a un agente humano repasa los números.
Tres plataformas de voz con IA para comparar en atención al cliente
Las opciones siguientes cubren distintas necesidades de despliegue. Prueba cada una con tus propias llamadas, sistemas conectados y requisitos de traspaso antes de elegir.
1. Bland AI: una pila de voz agrupada
Bland AI combina el modelo de lenguaje, el reconocimiento de voz y la generación de voz en su plataforma de voz. Es una opción para equipos que quieren esos componentes con un solo proveedor. Confirma los cargos por número de teléfono y transferencia además de la tarifa de plataforma.
2. Retell AI: infraestructura de voz basada en uso
Retell AI ofrece infraestructura de voz con precios basados en el uso. Compara la configuración completa que necesitas, incluidos el modelo, la voz y la telefonía, en lugar de tratar la tarifa anunciada más baja como el coste de cada llamada.
3. Ringly: soporte telefónico con IA para tiendas Shopify
Seth, de Ringly, es un sistema de atención telefónica con IA creado para tiendas Shopify. Contesta llamadas entrantes, consulta pedidos y productos, resuelve dudas rutinarias sobre devoluciones y transfiere a quien llama a tu equipo cuando hace falta. Encaja con equipos de comercio electrónico que quieren un agente de voz conectado a los datos de la tienda sin montar su propia pila de voz y telefonía.
A diferencia de las opciones de infraestructura por minuto anteriores, Ringly cobra por conversación. Su precio publicado es de 99 $/mes por las primeras 50 conversaciones y luego 1,99 $ por cada conversación facturable adicional. Las llamadas en las que Seth ayuda antes de traspasar cuentan igualmente; el spam, los colgados, los números equivocados y las peticiones inmediatas de hablar con una persona, no. Confirma cómo se aplican esas reglas a tu mezcla de llamadas antes de estimar la factura. Su enfoque en Shopify lo hace menos adecuado para otros sectores o para llamadas salientes.
Qué dice la gente realmente sobre llamar a una IA
Las demos siempre muestran lo mismo: alguien pregunta "¿cuál es vuestro horario?" y una IA responde con soltura. La realidad es más variada, y la distancia entre ambas es lo más útil que puedes entender antes de desplegar.
Cuando funciona, funciona de verdad. Aquí una persona real describe una llamada de soporte fuera de horario, no un proveedor:
"It was after hours, and a dreaded robot voice answered my call. I was fully prepared to spend the next 10 minutes rewording my issue... Surprisingly, this robot understood every single sentence I said... That's the most pleasant customer service call I have ever experienced. I don't mind talking to AI. In fact, instead of a live agent, I actually prefer to talk to your LLM, so my issue can be quickly triaged to the right human who actually understand my situation."
Fíjate en lo que hizo buena esa llamada: la derivó a la persona adecuada. Ese es el patrón. Ahora el modo de fallo, de alguien que cayó en un callejón sin salida de desvío:
"One (recently) even told me, after wandering through the menu options, that they were going to text me a link to their app - and then hung up on me. I already tried the app, their system was broken - that's why I was trying to call and talk to a human!"
Y el planteamiento más agudo de la tensión central, que vale la pena leer dos veces:
"The problem with the call center A.I. is that almost every time I need to call somewhere that uses them, I have some kind of edge case. They always give examples of how the automated agent can handle simple queries like 'what's my balance'... but I never need to call with something straightforward like that."
Ese es todo el juego en un comentario. La gente no llama por lo sencillo, llama por el caso límite, y un agente que no sabe admitir con claridad "esto es para una persona" convierte un canal de soporte en un muro.
Lo que todos hacen mal: confianza por encima de cobertura
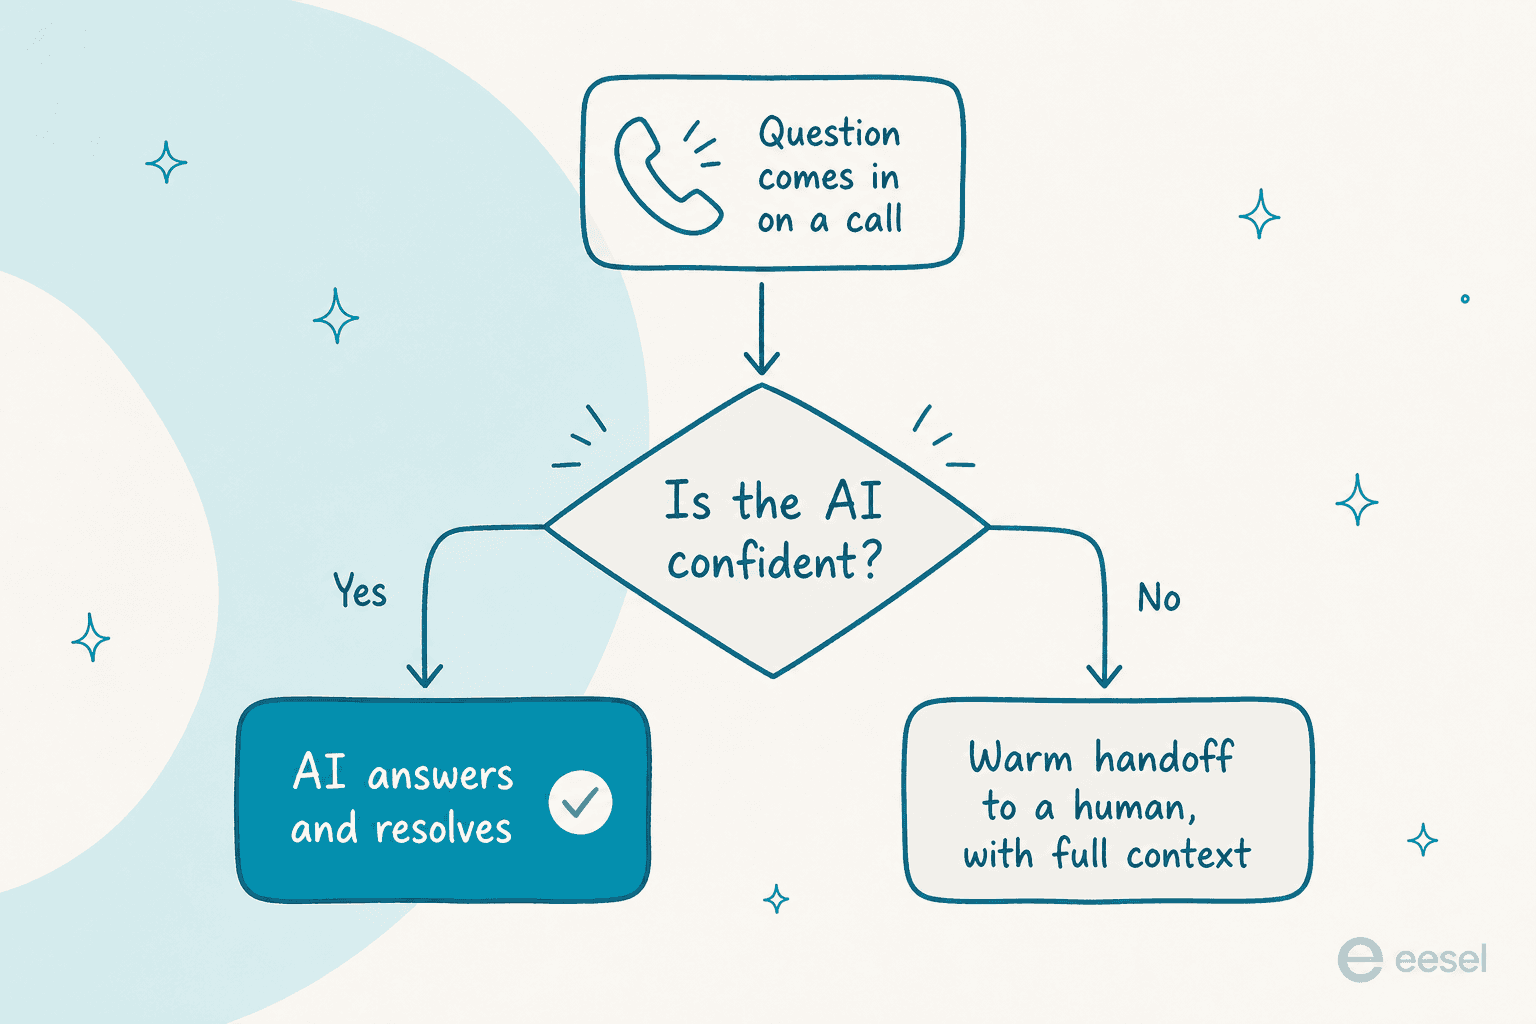
El error que veo cometer a los equipos una y otra vez es optimizar cuánto puede responder el agente de voz en lugar de lo bien que sabe cuándo no hacerlo. En una llamada en vivo, una respuesta errónea dicha con seguridad es peor que un traspaso rápido, porque quien llama actúa en consecuencia y tú te enteras después.
Esta no es una idea específica de la voz, es la lección de años ejecutando IA en colas de soporte en vivo, en todos los canales. Uno de nuestros clientes, responsable de CX en una marca DTC de suplementos, lo dijo mejor que cualquier presentación comercial:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle, and all the other ones, leave them alone."
Ese es el principio de diseño. En la práctica significa tres cosas, tanto si el canal es voz como texto:
- Basa cada respuesta en tu conocimiento real, para que el agente recupere información de tu centro de ayuda y de resoluciones pasadas en lugar de improvisar. Eso evita que alucine en preguntas de soporte.
- Condiciona a la confianza, para que solo resuelva lo que tiene claro y pase el resto a una persona con todo el contexto, exactamente el patrón de la buena llamada anterior.
- Prueba con tu propio historial antes de salir en vivo, no con los escenarios de demo de un proveedor. Quieres saber cómo habría gestionado tus últimas mil llamadas o tickets reales, no un "¿cuál es vuestro horario?" guionizado.
Ese último punto es el que los equipos se saltan y lamentan. Es la diferencia entre esperar y saber, y por eso simular con tickets pasados antes de tocar a un solo cliente se ha vuelto imprescindible en la parte de texto del soporte.
Dónde encaja la voz con IA en tu stack de soporte
Entonces, ¿deberías poner un agente de IA en tu línea telefónica? Mi opinión sincera: la voz es un canal y, para la mayoría de los equipos de soporte, no es el mayor. El chat, el correo y los tickets suelen concentrar mucho más volumen y es menos arriesgado automatizarlos primero, porque un agente de texto puede redactar, esperar revisión y traspasar sin que alguien espere al teléfono en tiempo real.
Una secuencia sensata para la mayoría de los equipos:
- Automatiza primero los canales de texto, donde se aplican el mismo conocimiento y el mismo filtro de confianza con un modo de fallo mucho más suave. Aquí es donde una herramienta de atención al cliente con IA se amortiza más rápido.
- Aprende de qué está realmente seguro tu agente con datos reales, usando la tasa de resolución y otras métricas como guía.
- Extiende a la voz cuando confíes en el enrutamiento, reutilizando la misma base de conocimiento y la misma lógica de traspaso que ya validaste en texto.
El conocimiento y la lógica de confianza son las partes reutilizables. La infraestructura específica de voz (telefonía, latencia, barge-in) es la capa extra que añades encima, y es un proyecto real, no una casilla que marcar. Acertar primero con la base de texto es lo que hace que merezca la pena añadir la capa de voz más adelante.
Prueba eesel para la parte de texto del soporte
eesel es un compañero de IA para helpdesk que gestiona los canales donde vive la mayor parte de tu volumen: tickets, chat en vivo y correo dentro del helpdesk que ya usas. No es un agente telefónico ni de voz, y prefiero decírtelo claramente a exagerar. Lo que hace bien es la base que defiende todo este artículo que construyas primero: se entrena con tus tickets pasados y tu centro de ayuda, condiciona sus respuestas a la confianza para contestar solo lo que tiene claro, y te permite simular con tu historial real de tickets antes de tocar una conversación en vivo, para que veas la tasa de resolución antes de comprometerte.

Se integra con Zendesk, Freshdesk, Gorgias, Front, Help Scout y Slack, y usa planes mensuales de créditos en lugar de facturación por minuto, que puedes comprobar en la página de precios. Consigue primero que los canales de texto resuelvan bien y la capa de voz será una extensión de algo en lo que ya confías, no un salto de fe. Puedes probar eesel gratis, sin tarjeta de crédito ni llamada comercial.