

O FLUX 3 Action é a parte do novo modelo de fundação da Black Forest Labs que prevê ações físicas em vez de pixels. O truque é que ele é o mesmo modelo que gera vídeo, decodificado de outra forma. O argumento da BFL é que, para gerar vídeo convincente, um modelo já precisa aprender como o mundo se comporta (contato, peso, causa e efeito), então prever o próximo movimento de um robô é só mais uma visão dessa mesma compreensão.
Transformado em produto como FLUX-mimic com a mimic robotics, ele foi testado e implantado na Audi em trabalhos que robôs convencionais nunca conseguiriam fazer, como manusear cabos e vedações macias. O número principal: alcançou uma taxa de sucesso mediana de 95% em uma tarefa de kitting com objetos macios e superou modelos de robôs anteriores mesmo com o backbone congelado, uma configuração em que o melhor anterior marcou 0%.
O porém para a maioria dos leitores: você ainda não pode usar o FLUX 3 Action. Ele é restrito a parceiros selecionados, sem API pública, preço ou pesos. Se você chegou aqui procurando um agente de IA que possa colocar para trabalhar hoje, o FLUX 3 é infraestrutura para robôs, não uma contratação. Vale entender essa distinção, e é onde vou chegar no final.
O que o FLUX 3 Action realmente é
Vou esclarecer os nomes primeiro, porque confundem muita gente. O FLUX 3 é um único modelo de fundação multimodal da Black Forest Labs, o mesmo laboratório por trás dos modelos de imagem FLUX. Ele é treinado em conjunto com imagem, vídeo e áudio, e a empresa o descreve como "one multimodal model for Image, Video, Audio and Action-Prediction".
Action-Prediction é essa quarta capacidade. Ela recebe observações visuais mais uma instrução de texto e prevê resultados físicos como ações de controle de robô. Então "FLUX 3 Action" não é um produto separado para baixar. É uma capacidade do backbone do FLUX 3, e a versão criada para robôs reais, em parceria com a mimic, chama-se FLUX-mimic.
O enquadramento que a BFL usa é a parte interessante. Nas palavras deles, um modelo que consegue tanto gerar vídeo quanto controlar robôs "was never really only a content creation model. It is a model of how the world behaves, and content creation is one thing one can do with it." É uma afirmação grande, então vale ver por que ela pode ser verdadeira.
Por que um modelo de vídeo pode controlar um robô
Este é o mecanismo, porque é a ideia inteira. Quando você treina um modelo para gerar vídeo realista, ele não tem escolha a não ser aprender física. Se errar o peso de um objeto, o jeito como uma mão se fecha em torno dele ou o que acontece quando duas coisas colidem, o vídeo parece obviamente falso. Aprender a renderizar o mundo com precisão é, por baixo dos panos, aprender como o mundo se comporta.
A BFL coloca números reais nisso. A previsão de vídeo responde por mais de 95% do total de computação de treinamento do FLUX 3. O áudio, em comparação, é menos de 0,5% dos tokens de um clipe 720p, porque, depois que você entende o vídeo, combinar o som com o movimento labial e os impactos é comparativamente fácil. As ações seguem o mesmo formato: o estado de um robô é um sinal de baixa dimensão fortemente acoplado ao que a câmera vê. Quadros, áudio e ações são todos visões parciais de uma mesma realidade física subjacente, então, uma vez que o modelo aprendeu essa realidade a partir do vídeo, a previsão de ações não é um desvio novo.
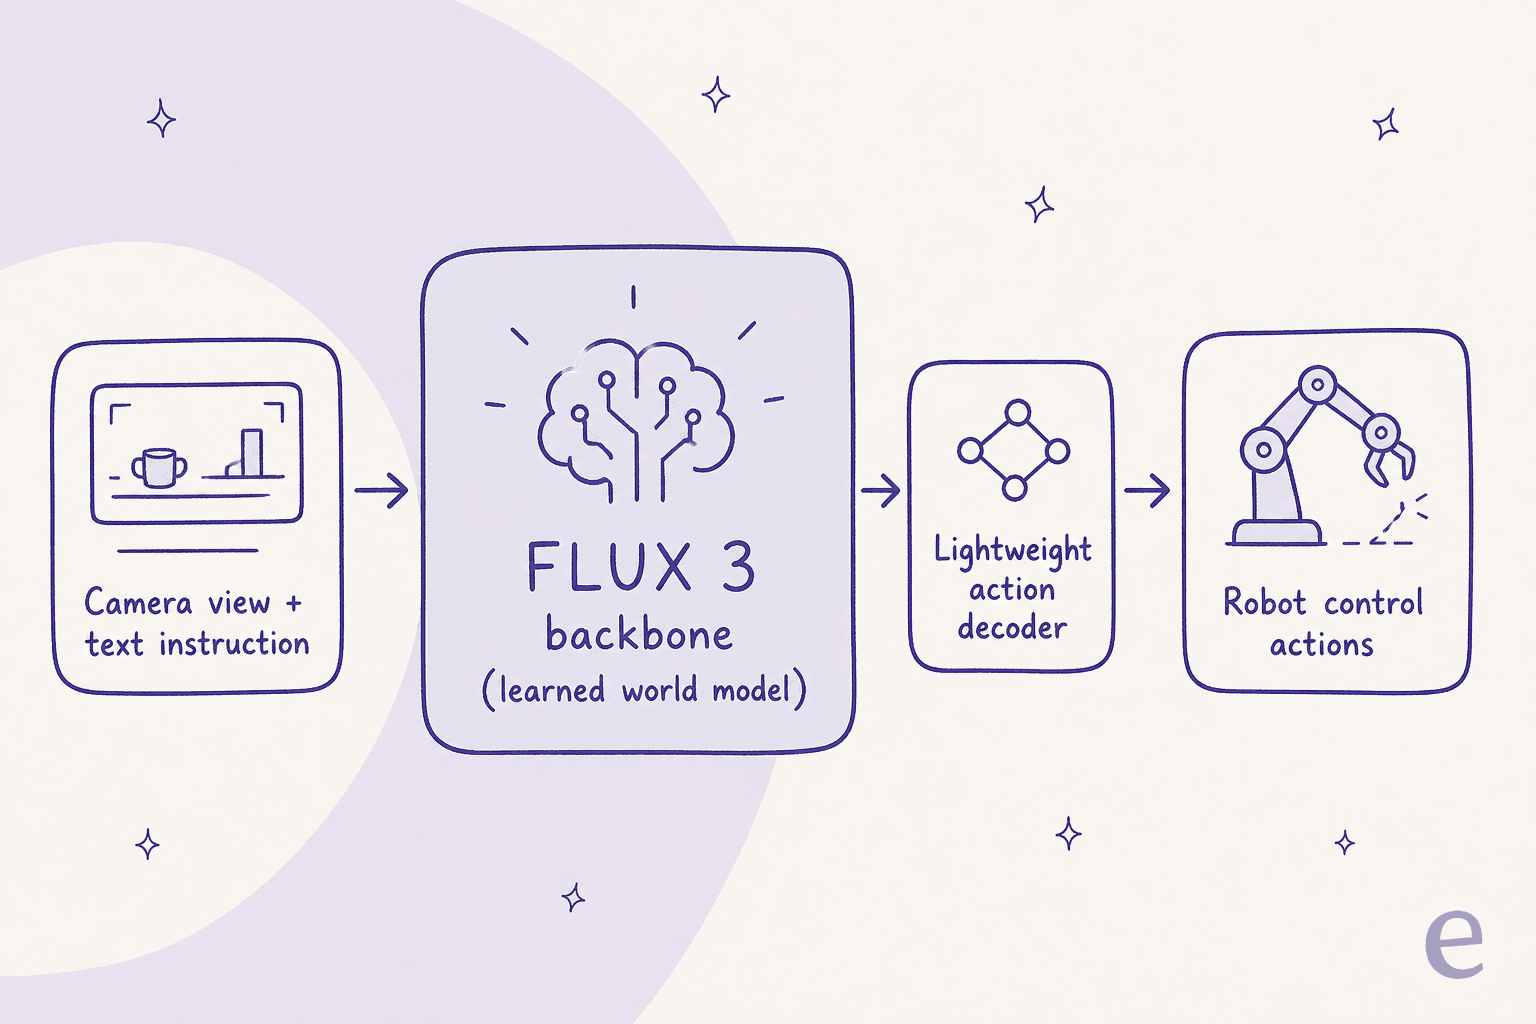
O pipeline é deliberadamente enxuto. Uma visão de câmera e uma instrução entram no backbone do FLUX 3, que guarda o modelo de mundo aprendido. Um pequeno decodificador de ações lê características intermediárias direto do caminho de previsão de vídeo e as transforma em ações de controle. A parte cara, entender o mundo, já está pronta antes de o robô se mover. É uma abordagem distinta da maioria dos modelos de visão-linguagem-ação, que são treinados de ponta a ponta para cuspir ações em vez de reaproveitar um backbone generativo.
Quanto custou adicionar ações
Se as ações realmente são só outra visão do mesmo mundo, ensinar o FLUX 3 a prevê-las deveria ser barato e não prejudicar o que ele já faz. É exatamente isso que a BFL relata. Quando adicionaram a previsão de ações a um grande treinamento, as avaliações humanas de texto para vídeo e imagem para vídeo caíram inicialmente até 10% enquanto o modelo absorvia a nova modalidade. Após 3.500 passos, a qualidade do vídeo voltou totalmente ao ponto de partida, agora com a previsão de ações por cima.
Essa recuperação é a evidência da tese "um backbone, dois trabalhos". O modelo não trocou qualidade de vídeo por controle de robô de forma permanente. Ele só precisou descobrir como a nova modalidade se mapeava ao mundo que já conhecia, e então a perda desapareceu. A pesquisa em que isso se baseia chama-se Self-Flow, que unifica geração e aprendizado de representações, de modo que melhorar um melhora o outro.
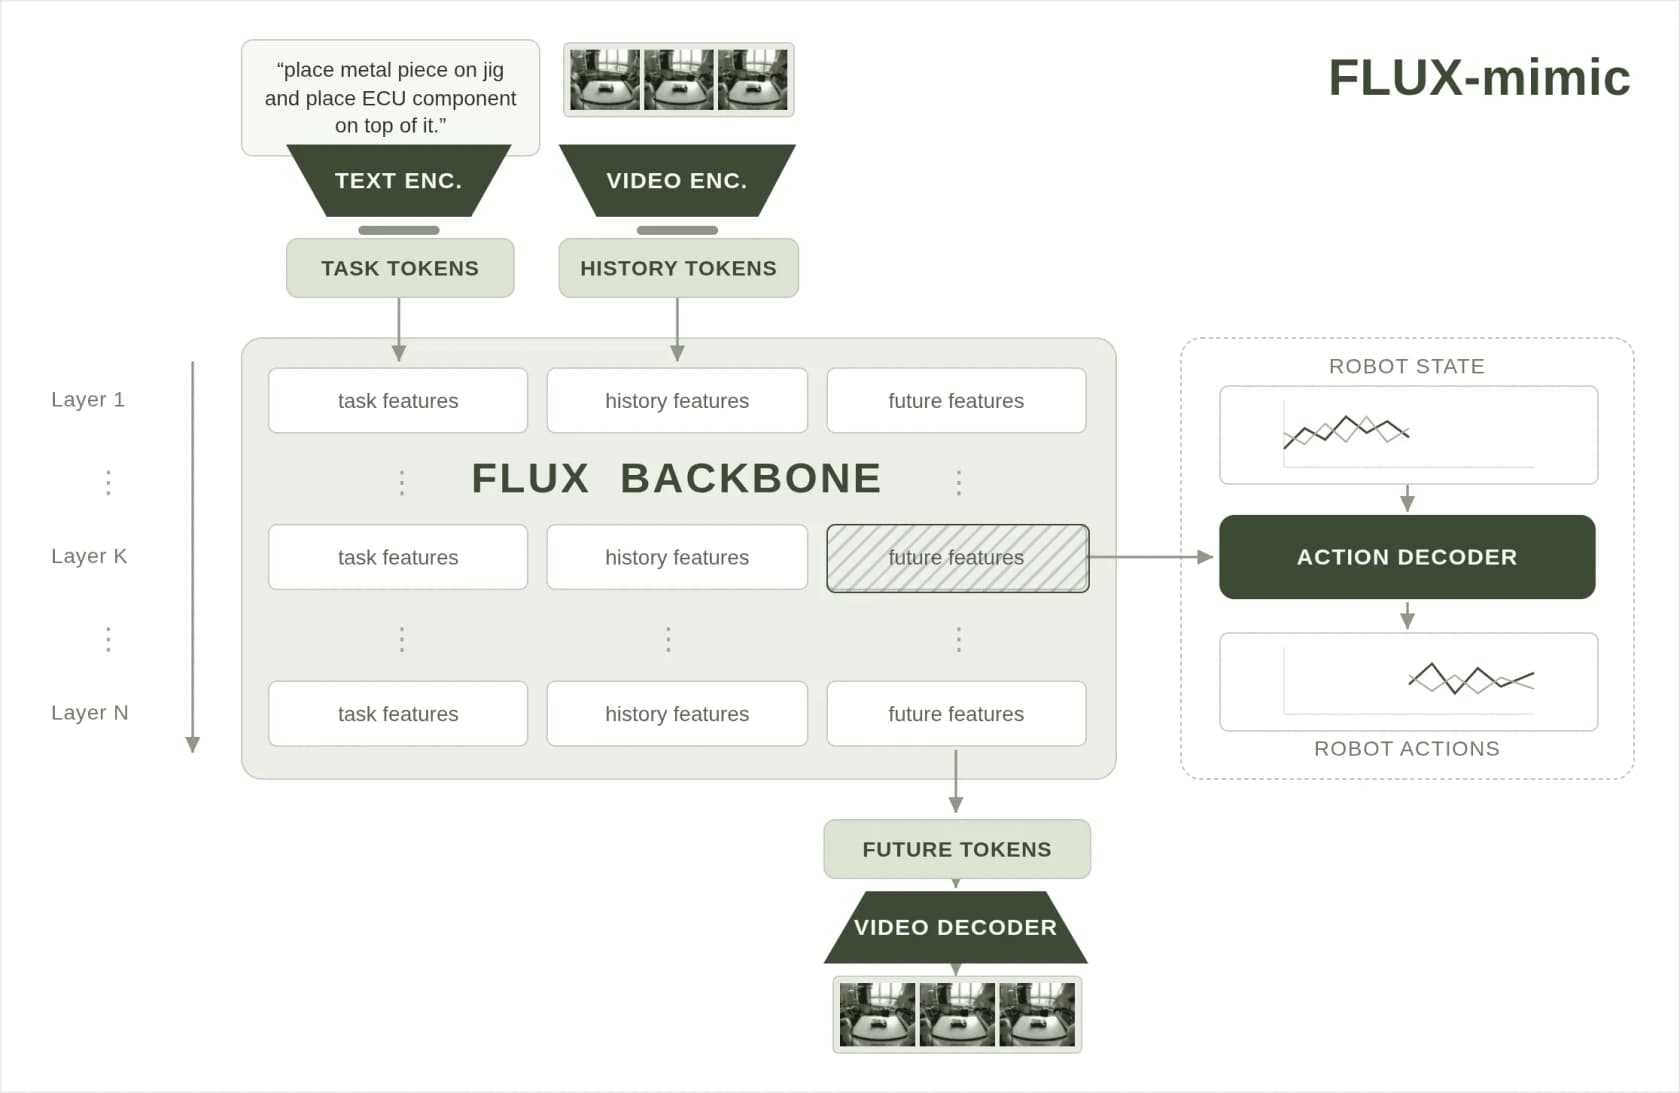
Dá para ver a divisão no próprio diagrama de arquitetura da BFL. Os codificadores de texto e vídeo alimentam o backbone FLUX compartilhado, e as mesmas camadas produzem características futuras de duas formas: por um decodificador de vídeo para gerar quadros e por um decodificador de ações leve para produzir ações de robô. Um tronco, duas cabeças.
O que os benchmarks realmente mostram
É aqui que o FLUX 3 Action surpreende, então quero me deter nos números em vez de passar por cima. Em uma tarefa de kitting com objetos macios (o tipo de manuseio de materiais flexíveis com que a automação convencional sempre teve dificuldade), a BFL mediu o sucesso mediano em 20 tentativas autônomas por modelo.
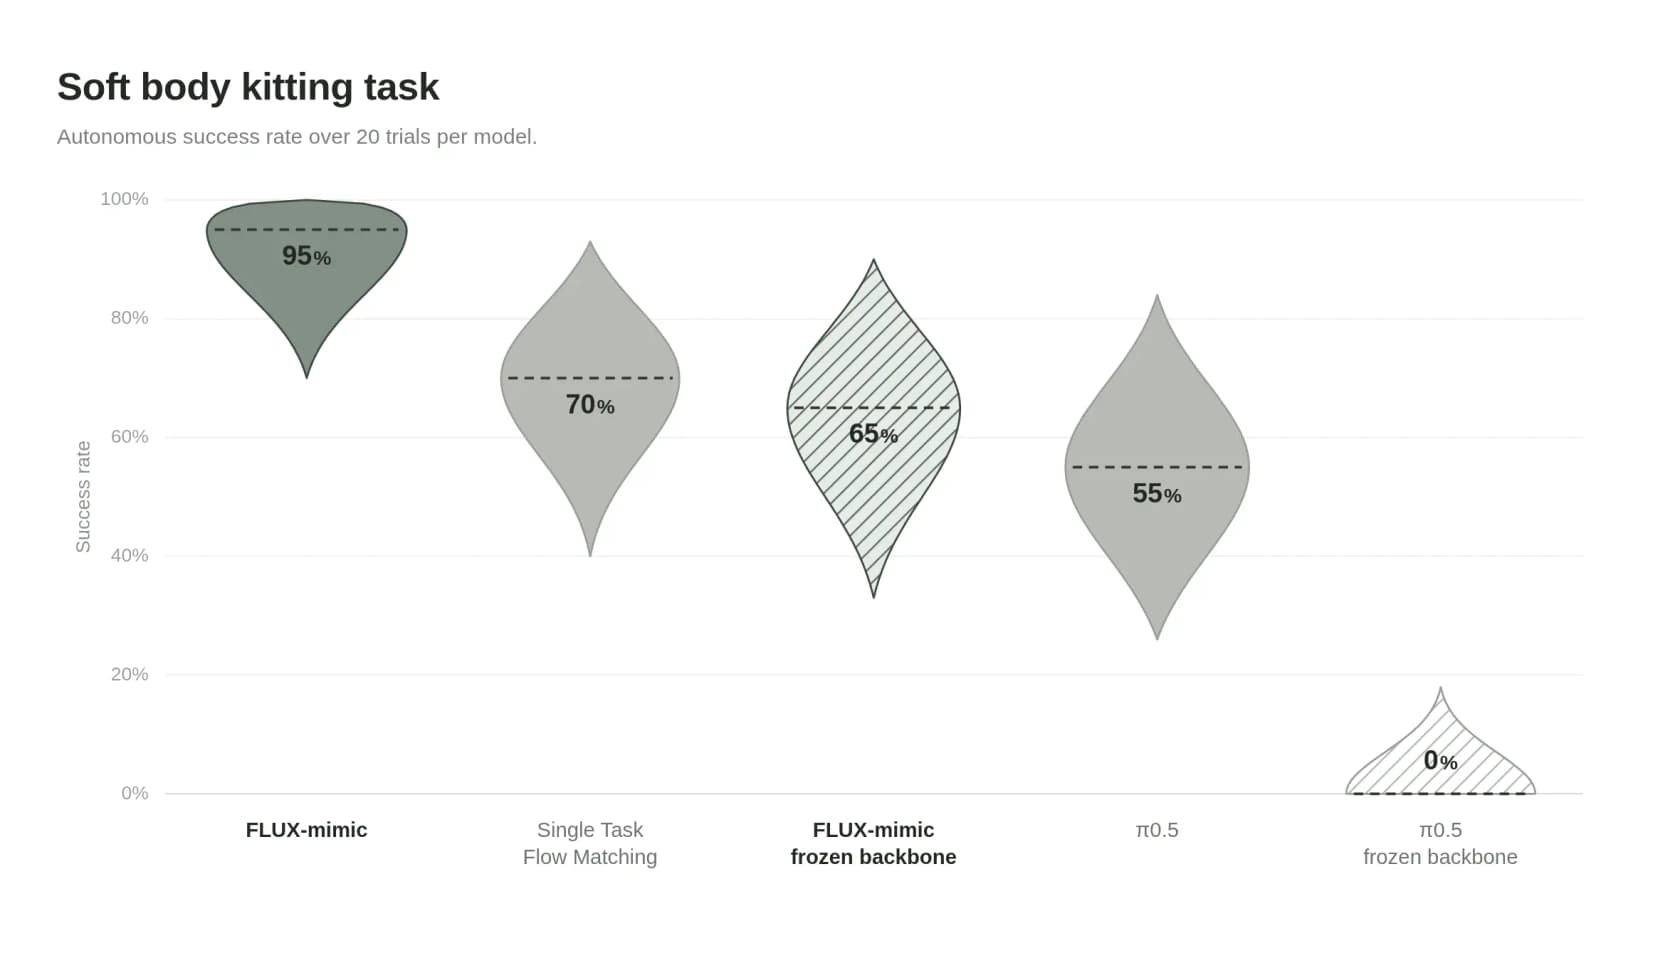
O FLUX-mimic chegou a 95%. Uma linha de base de flow matching de tarefa única atingiu 70%, e o π0.5, um forte modelo anterior de visão-linguagem-ação, 55%. O número que mais importa, porém, é a coluna do backbone congelado. Quando você congela o backbone do FLUX-mimic (sem fine-tuning, só o modelo de mundo pré-treinado com um decodificador por cima), ele ainda marca 65%. Faça o mesmo com o π0.5 e ele marca 0%. Em outras palavras, a representação pré-treinada do FLUX 3 é boa o bastante para controlar um robô com quase nenhum treinamento específico da tarefa, algo que modelos anteriores não podiam afirmar.
Mais alguns achados que vale destacar, porque se acumulam:
- Eficiência de amostras. O trabalho do mimic-video relata até 10 vezes menos exemplos do que um modelo de visão-linguagem-ação para atingir a mesma capacidade, porque a física já está na representação.
- Autorrecuperação. Um robô que erra uma pegada se corrige e tenta de novo, mesmo que nenhuma demonstração tenha mostrado essa recuperação. Ela vem do modelo de mundo, não do conjunto de treinamento.
- Velocidade. O backbone vai da entrada da câmera à representação do mundo em menos de 80 ms em uma única NVIDIA RTX 5090, e o ciclo completo do robô da mimic reage em 101 ms, aproximadamente o tempo de reação visual humano.
O ponto da velocidade é sutil, mas importante. Como representações melhores significam mais capacidade por parâmetro, a BFL pode rodar um backbone menor (e portanto mais rápido) e ainda atingir o nível de precisão. Em robótica, a latência é a restrição que mata implantações, então um backbone menor que acompanha o mundo real vale mais do que a taxa de sucesso bruta.
Do laboratório ao chão de fábrica
Nada disso importaria se só funcionasse em simulação, então a implantação na Audi é a prova. A Audi opera uma das redes de produção mais automatizadas da indústria automotiva, o que significa que tem uma visão precisa de onde os robôs convencionais ainda param: peças flexíveis, manipulação fina e a diversidade de variantes da produção premium, que torna caro demais reprojetar células de robôs programadas à mão para cada caso.
"In partnership with mimic, Audi has been testing and deploying FLUX-mimic. We have seen these robots solve complex soft-body manipulation work that would have been simply impossible with conventional robotics."
As tarefas que a BFL cita são concretas: organizar peças em bandejas estruturadas, inserir unidades de controle eletrônicas em dispositivos justos, montar componentes e manusear materiais macios e flexíveis como vedações e cabos. Essa última categoria é a que permaneceu teimosamente manual por décadas, então é um sinal justo de onde essa abordagem se paga.
Dá para usar o FLUX 3 Action de verdade?
Aqui está a situação honesta, porque a empolgação corre à frente da disponibilidade. A Black Forest Labs está lançando o FLUX 3 em fases, e a previsão de ações não é algo que você possa comprar.
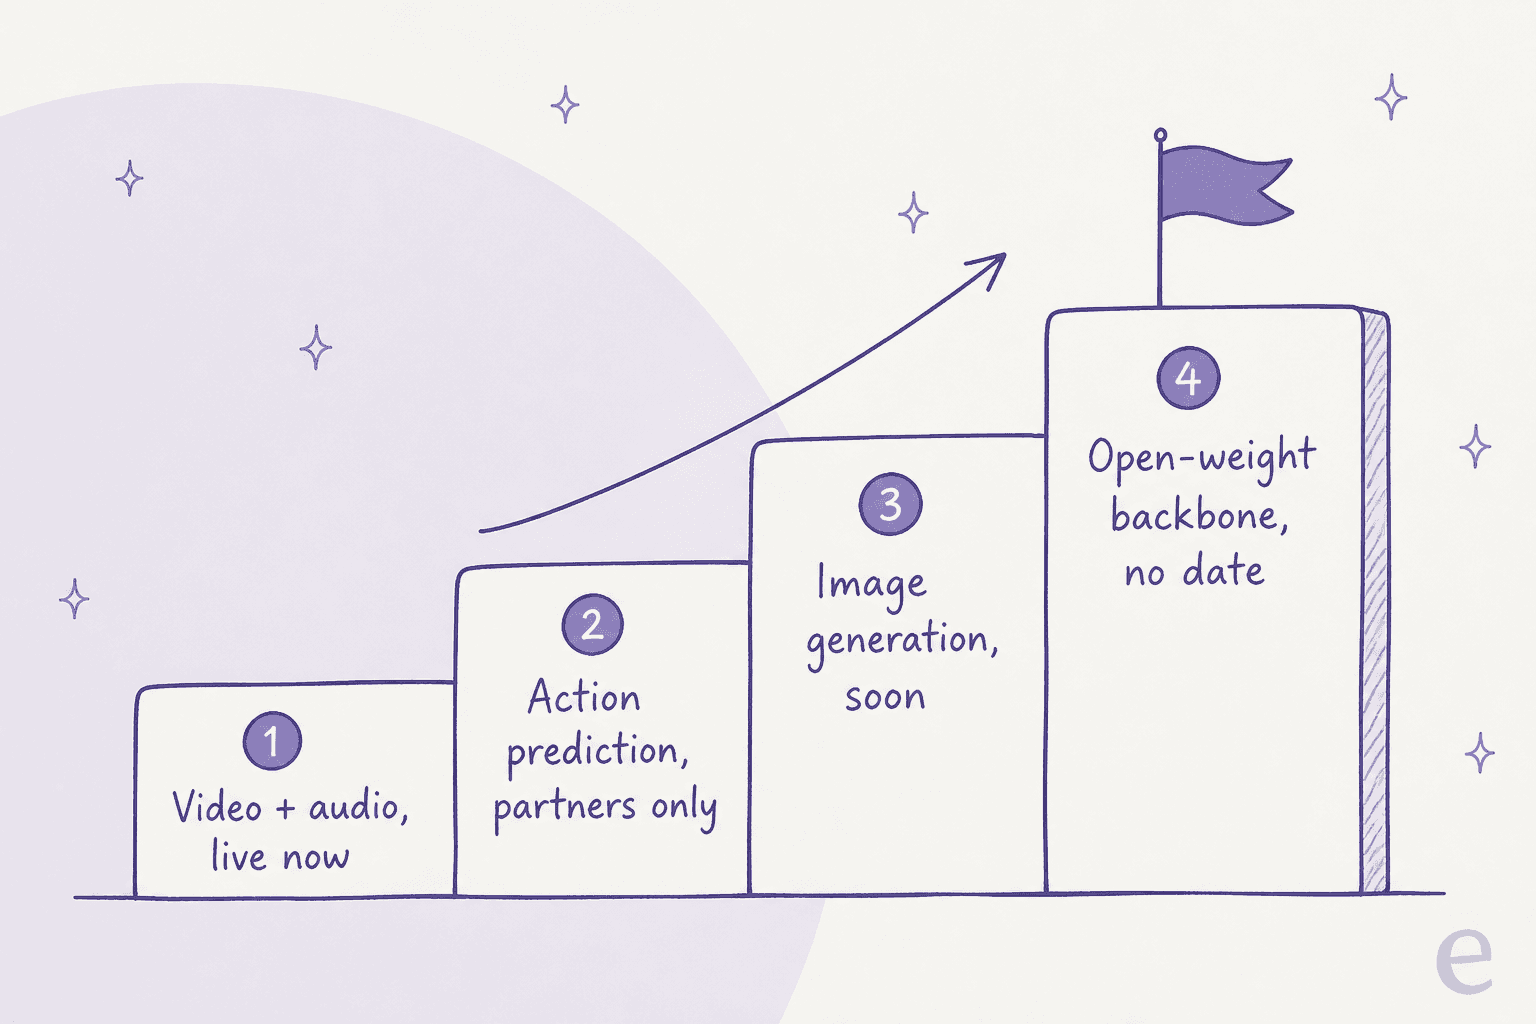
A ordem de lançamento publicada pela BFL é: geração e edição de vídeo primeiro, previsão de ações com parceiros selecionados, depois síntese de imagens e, por fim, acesso de pesos abertos ao backbone. Hoje apenas vídeo com áudio está disponível de forma geral. A previsão de ações é restrita a parceiros (a mimic tem acesso antecipado), com sem API pública, sem preço publicado e sem pesos abertos. A geração de imagens do FLUX 3 continua marcada como "soon", e o backbone de pesos abertos não tem data alguma.
Então, se você quer mexer no FLUX 3 hoje, o que realmente dá para pagar é vídeo: texto para vídeo, imagem para vídeo e vídeo para vídeo de até 20 segundos, com áudio sincronizado nativo, no preço da API da BFL pago por uso e sem assinatura. Para qualquer coisa ligada a robôs, você está acompanhando uma prévia de pesquisa e um programa de parceiros, não um produto. Isso não é uma crítica, é só onde está a fronteira. A IA física passa devagar de parceiros selecionados para disponibilidade geral, por bons motivos.
Infraestrutura versus o colega que você realmente contrata
Quero dar um passo atrás, porque "FLUX 3 Action" e expressões como "agente de IA" são jogados no mesmo saco, e pertencem a prateleiras completamente diferentes.
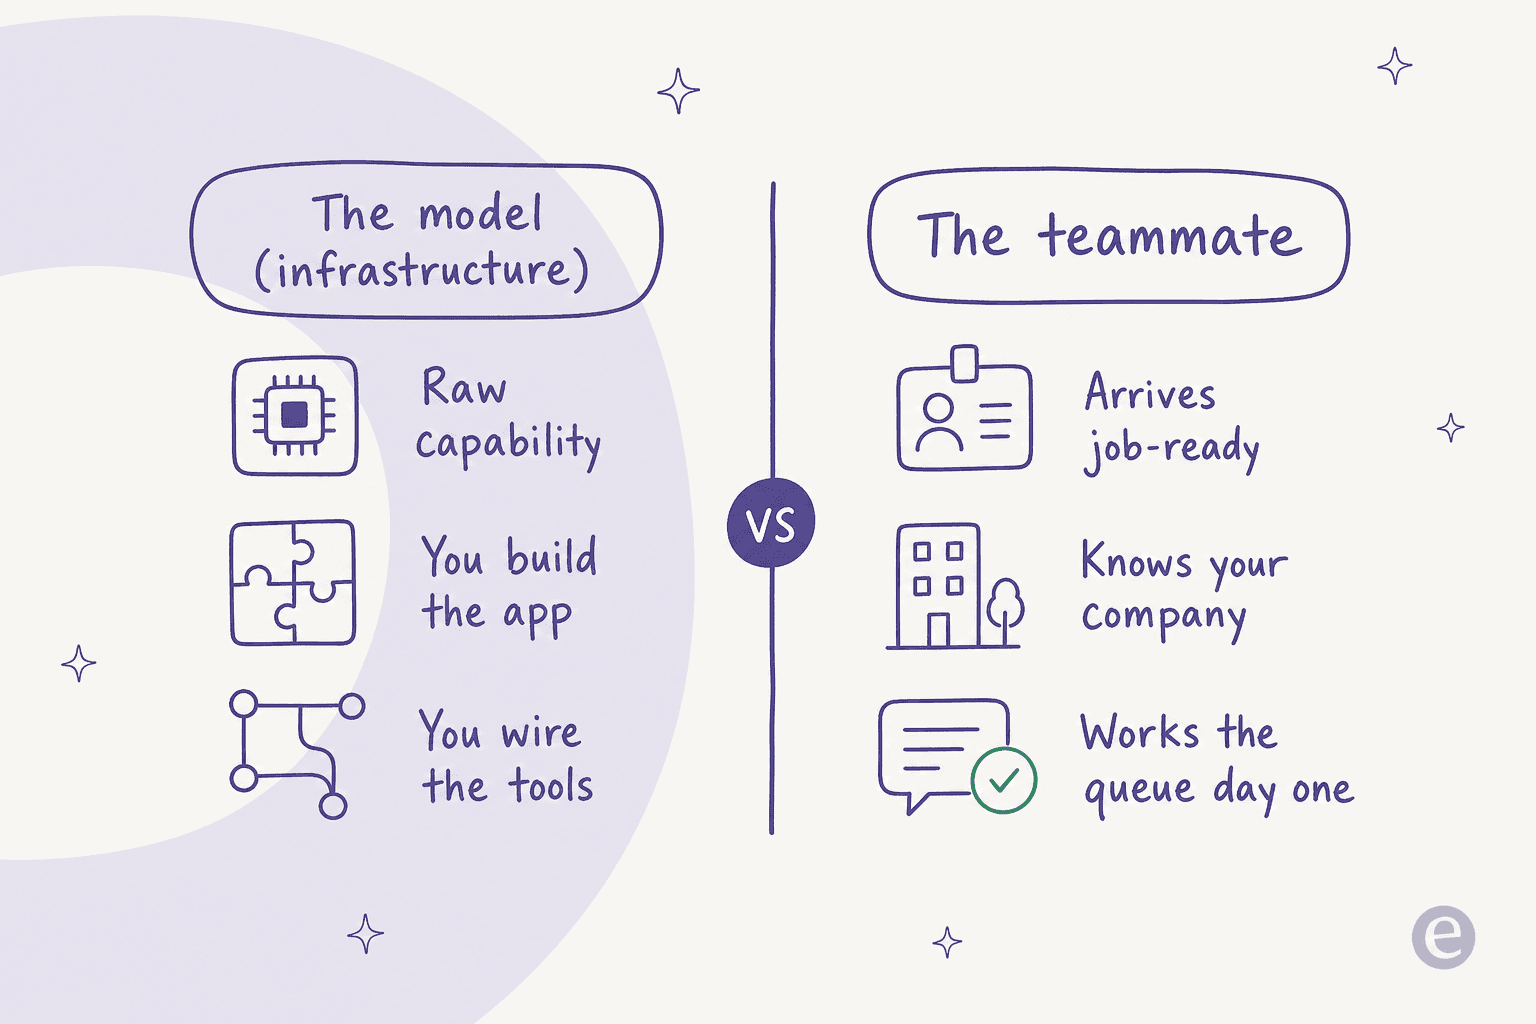
Um modelo de fundação como o FLUX 3 é infraestrutura. É capacidade bruta. Para extrair valor dele, você constrói a aplicação, conecta as ferramentas, cuida da implantação e (neste caso) o acopla a robôs físicos. Essa é exatamente a forma certa para um laboratório de robótica ou uma equipe de produção automotiva com engenheiros. É a forma errada para um líder de suporte que só precisa de tickets respondidos.
A outra prateleira é o colega de IA: algo que chega pronto para o trabalho, já conhece sua empresa e começa a trabalhar no primeiro dia. Você não constrói um app em torno dele, você o orienta como um novo contratado. Essa é a camada em que eu trabalho, e vale deixar claro que um modelo não é um colega, assim como um motor não é um carro. O FLUX 3 Action é um motor notável para IA física. Só não é o que você contrata.
Como isso se encaixa na eesel
Na eesel, levamos a sério o lado "funcionário, não infraestrutura" dessa linha. A eesel é uma plataforma de colegas de IA: em vez de entregar um modelo bruto para você construir em cima, você contrata colegas prontos para trabalhar em funções específicas. A equipe atual é um colega de IA para helpdesk e um redator de blog com IA, cada um chegando com as habilidades, integrações e contexto da empresa de que sua função precisa.
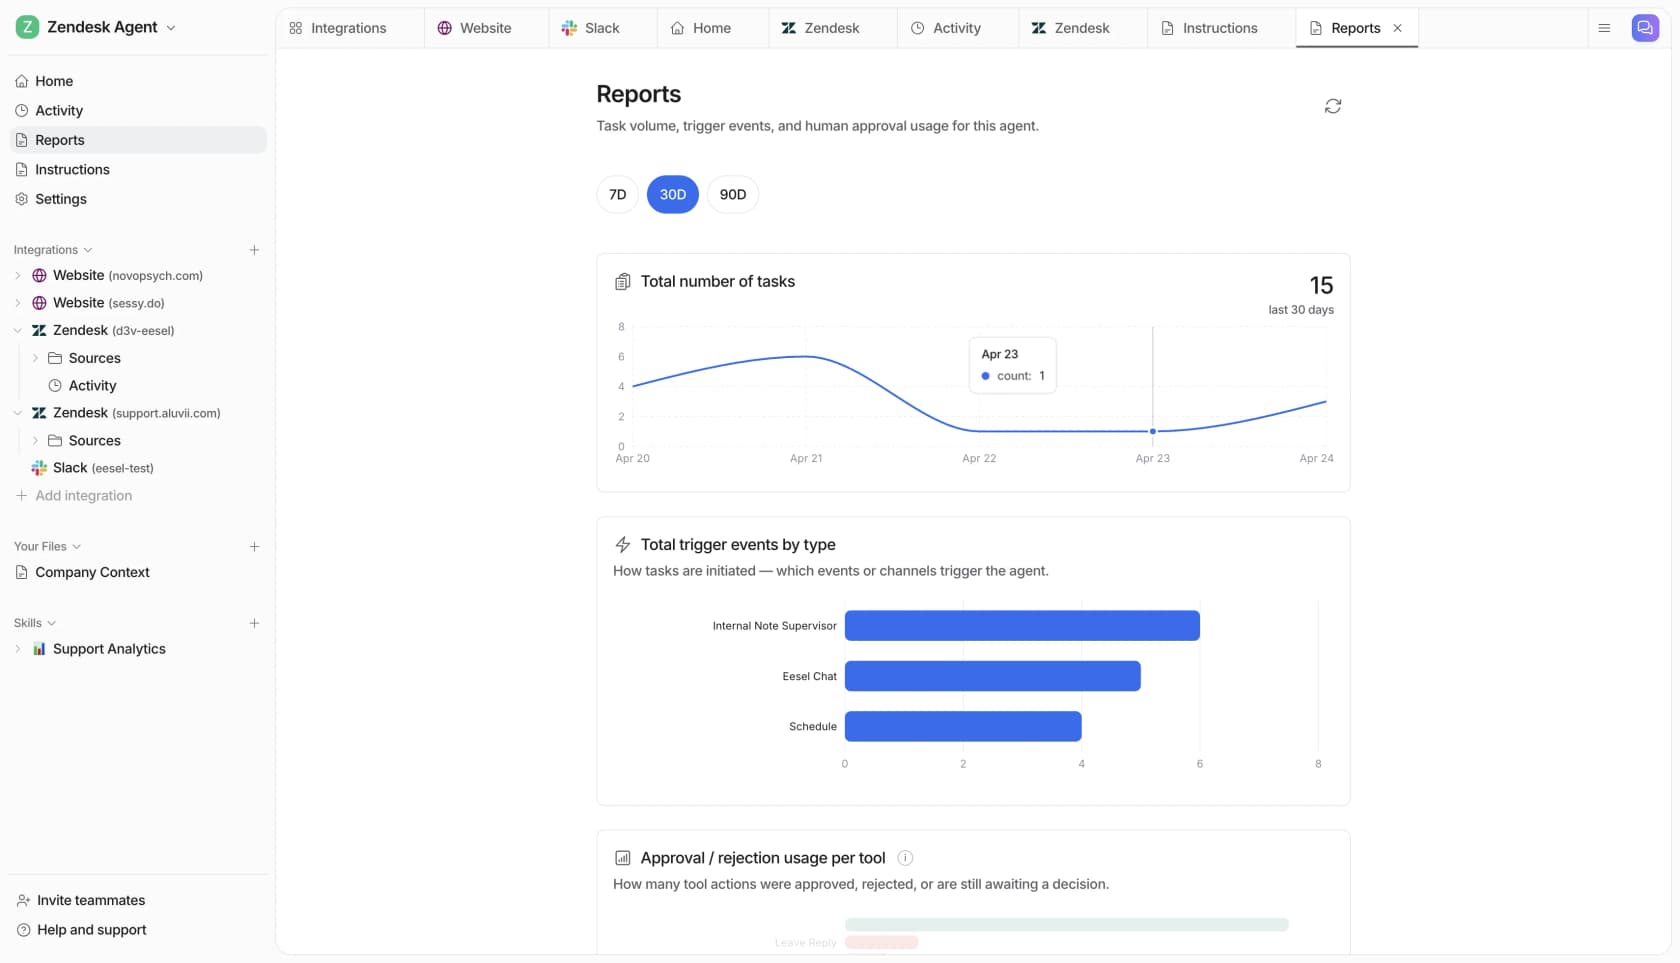
Como o modelo por baixo é um alvo móvel (FLUX hoje, outra coisa no próximo trimestre), a abstração útil é o colega, não a capacidade bruta. O colega de helpdesk aprende com seus tickets passados e sua central de ajuda, redige respostas para revisão, e você pode simulá-lo com seus próprios tickets históricos antes de ele entrar no ar, porque já vi bots de tom confiante darem respostas erradas em silêncio e prefiro pegar isso em um ensaio. Se você gosta de trabalhar pelo terminal, a CLI da eesel e seu servidor MCP permitem que você (ou um agente de programação como o Claude Code) configure integrações, envie conhecimento e aprove ações como JSON, de modo que o mesmo colega é programável sem o painel. Ele não vai dobrar sua roupa nem operar uma linha de fábrica. Mas para atender clientes e escrever conteúdo, ele é a contratação, não a infraestrutura. É grátis para testar.