

O Claude Sonnet 5 é o novo modelo de nível intermediário da Anthropic (lançado em 30 de junho de 2026), e a proposta é direta: qualidade próxima da Opus em codificação e trabalho agêntico, pelo preço do Sonnet. Depois de analisar os benchmarks e a documentação de preços, eu compro em grande parte essa ideia. Pelos próprios números da Anthropic, ele supera o Sonnet 4.6 em todas as frentes e fica a um ou dois pontos do bem mais caro Opus 4.8 em vários testes, e em um benchmark de trabalho de conhecimento ele até ultrapassa.
A pegadinha é o custo. O preço na etiqueta ($3 / $15 por milhão de tokens) é idêntico ao do Sonnet 4.6, mas um novo tokenizador gera mais tokens por requisição e o modelo pensa mais por padrão, então a conta real pode subir. Um índice independente chegou a constatar que ele custa mais por tarefa do que o Opus 4.8 no preço padrão. Resumindo: modelo excelente, fique de olho no controle de esforço.
Se você está avaliando o Sonnet 5 para viabilizar suporte com IA, o modelo é só metade da história: o que determina se é seguro deixá-lo solto em tickets é a camada ao redor dele. É essa a parte que a eesel AI resolve, e eu chego lá no final.
O que é o Claude Sonnet 5, em um minuto
Eu trabalho construindo em cima desses modelos, então vou manter a parte técnica curta. O Claude Sonnet 5 (claude-sonnet-5) é o sucessor direto do Sonnet 4.6 e o novo modelo padrão no Claude.ai. A Anthropic o chama de "nosso Sonnet mais agêntico até agora", e as especificações principais sustentam essa afirmação: uma janela de contexto de 1M de tokens, até 128K tokens de saída, visão de alta resolução e pensamento adaptativo ativado por padrão.
As duas coisas que valem a pena internalizar antes de tudo:
- O parâmetro
effort(low/medium/high/xhigh/max) é território novo para um modelo Sonnet, que é o primeiro a receber oxhigh. É o controle que decide o quanto o modelo pensa, e também o que decide sua conta. - Um novo tokenizador que produz cerca de 1,0 a 1,35x mais tokens para o mesmo texto em comparação ao Sonnet 4.6, o que importa mais do que parece. Mais sobre isso adiante.
Ele foi lançado em todos os lugares no primeiro dia: Claude.ai (web e mobile), Claude Code e Cowork, a Claude Platform, além de AWS, Google Cloud e Microsoft Foundry. Para um resumo mais completo do que mudou, meu colega escreveu separadamente sobre o que é o Claude Sonnet 5; este texto aqui é a análise.
Os benchmarks: o quão bom ele realmente é?
Aqui está a tabela publicada pela Anthropic, e é a forma mais clara de ver onde o Sonnet 5 realmente se posiciona.
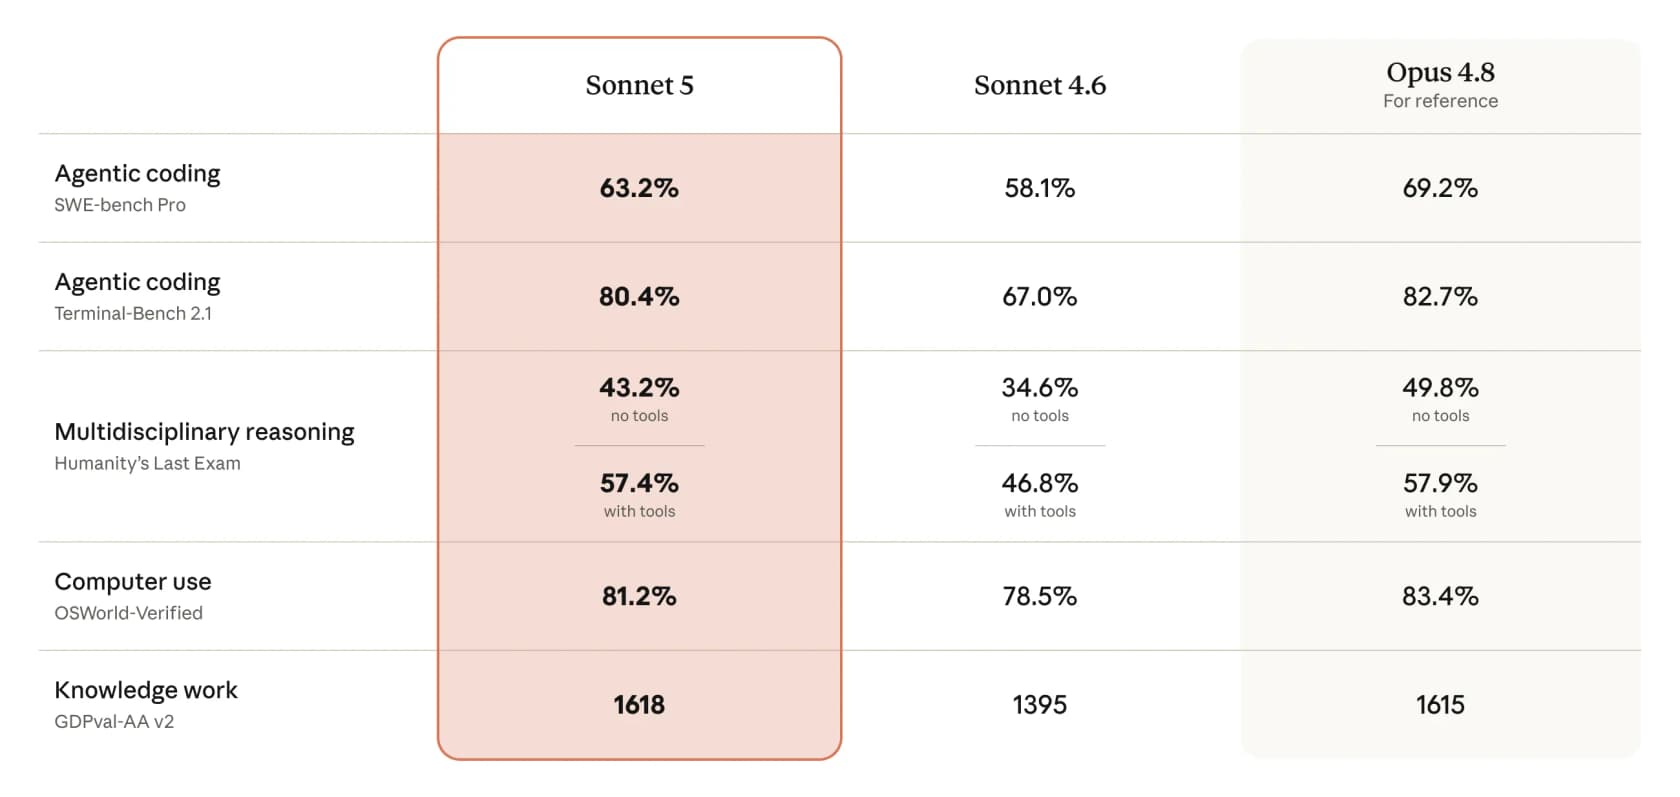
Alguns números chamam a atenção. Em codificação agêntica, o Sonnet 5 alcança 63,2% no SWE-bench Pro (contra 58,1% do Sonnet 4.6, e se aproximando dos 69,2% do Opus 4.8) e 80,4% no Terminal-Bench 2.1, quase empatando com os 82,7% do Opus 4.8. Em uso de computador (OSWorld-Verified), ele marca 81,2%, pouco abaixo dos 83,4% do Opus 4.8. E em trabalho de conhecimento (GDPval-AA v2), ele registra 1618, superando os 1615 do Opus 4.8, um resultado do tipo que faz a afirmação de "quase Opus" soar verdadeira, e não apenas marketing.
O padrão se mantém no Humanity's Last Exam: com ferramentas, o Sonnet 5 alcança 57,4% contra os 57,9% do Opus 4.8, basicamente um empate. Onde o Opus ainda lidera claramente é no raciocínio sem ferramentas (49,8% vs 43,2%), o que indica para que o Opus ainda serve.
O que torna a história mais interessante do que um simples número em uma tabela de classificação é como os ganhos aparecem à medida que você gasta mais. A Anthropic plotou a taxa de acerto em função do custo por tarefa no BrowseComp, o benchmark de busca agêntica:
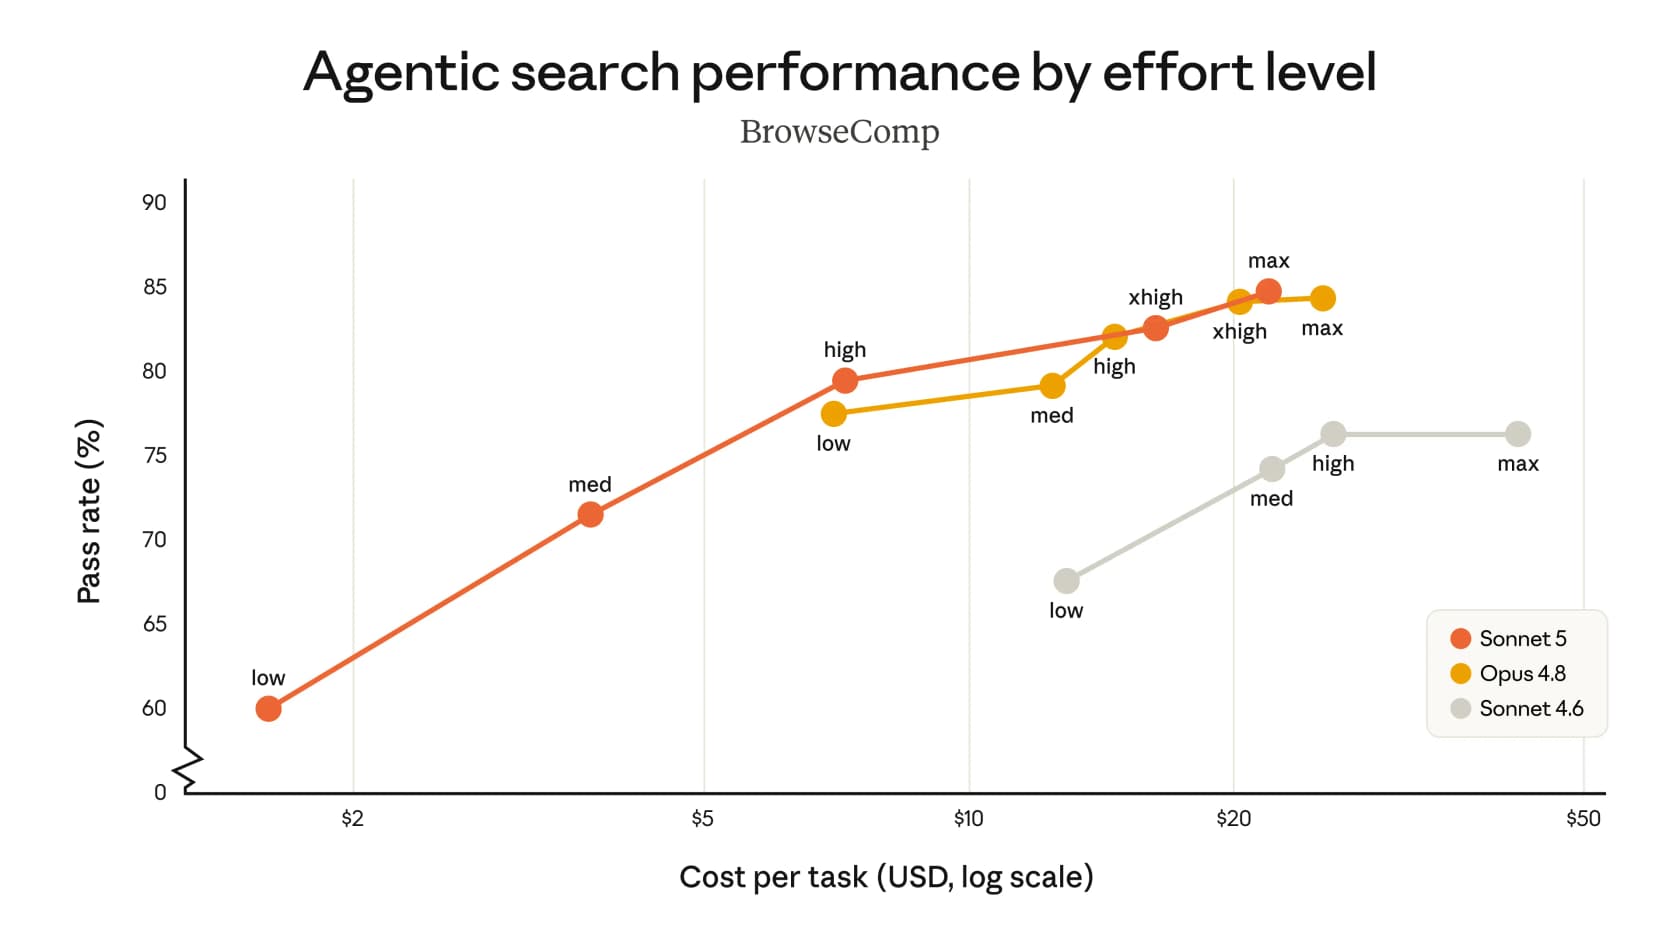
A linha laranja do Sonnet 5 fica bem acima da do antigo Sonnet 4.6 em todos os pontos de preço, e acompanha de perto a curva do Opus 4.8 até bem no topo. Em termos simples: para a maior parte da faixa de custo, o Sonnet 5 entrega resultados no estilo Opus pelo preço do Sonnet. Essa é toda a análise resumida em um único gráfico.
Onde o Sonnet 5 se encaixa na linha Claude 5
A nomenclatura da Anthropic está um tanto confusa no momento (o modelo principal se chama Fable 5, enquanto Opus, Sonnet e Haiku mantêm seus próprios números de versão), então aqui está como os níveis realmente se organizam por preço e capacidade.
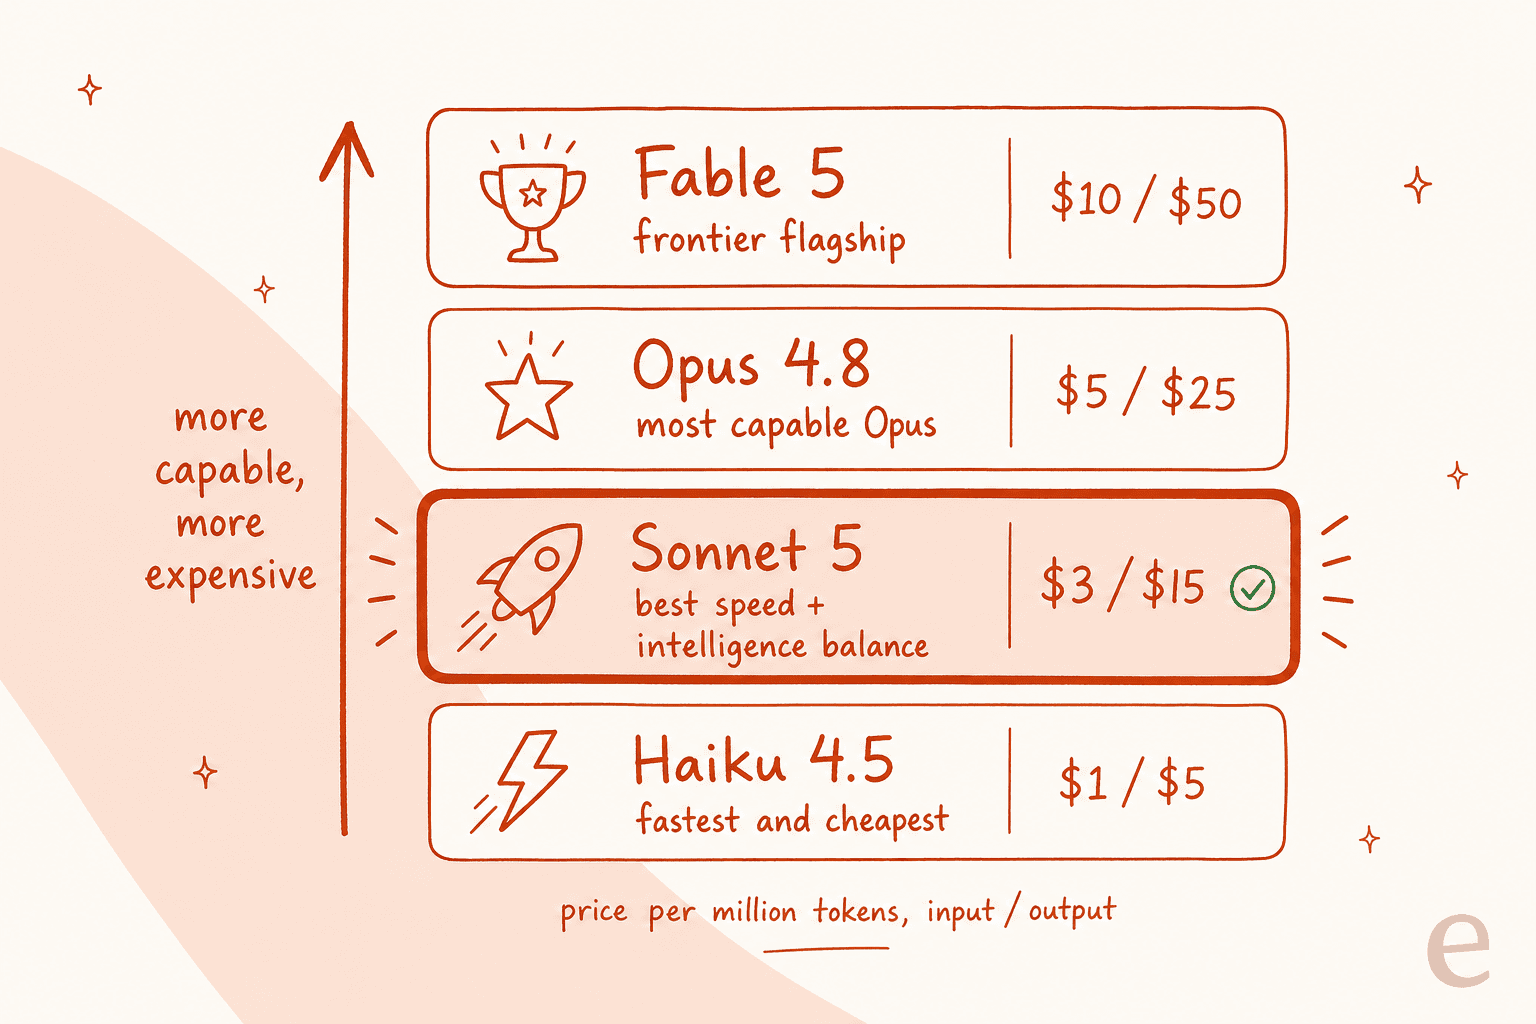
O Sonnet 5 fica bem no meio: mais barato e mais rápido que o Opus 4.8, mais capaz que o Haiku 4.5, e bem abaixo do nível de fronteira do Fable 5. A própria Anthropic afirma que os maiores saltos recentes de capacidade vieram dos seus modelos de classe Opus, e que "o Sonnet 5 diminui essa distância". Os benchmarks concordam. Na prática, para muitas equipes, a pergunta "qual Claude eu uso por padrão?" agora tem uma resposta óbvia, e é esta.
| Modelo | Papel | Entrada / saída por MTok | Contexto |
|---|---|---|---|
| Claude Fable 5 | Modelo principal de fronteira | $10 / $50 | 1M |
| Claude Opus 4.8 | Mais capaz da categoria Opus | $5 / $25 | 1M |
| Claude Sonnet 5 | Melhor equilíbrio entre velocidade e inteligência | $3 / $15 | 1M |
| Claude Haiku 4.5 | Mais rápido e mais barato | $1 / $5 | 200K |
O controle de esforço é a verdadeira história
Se você levar apenas uma coisa desta análise, que seja esta: com o Sonnet 5, você para de trocar de modelo para controlar custo e passa a girar um controle em vez disso.
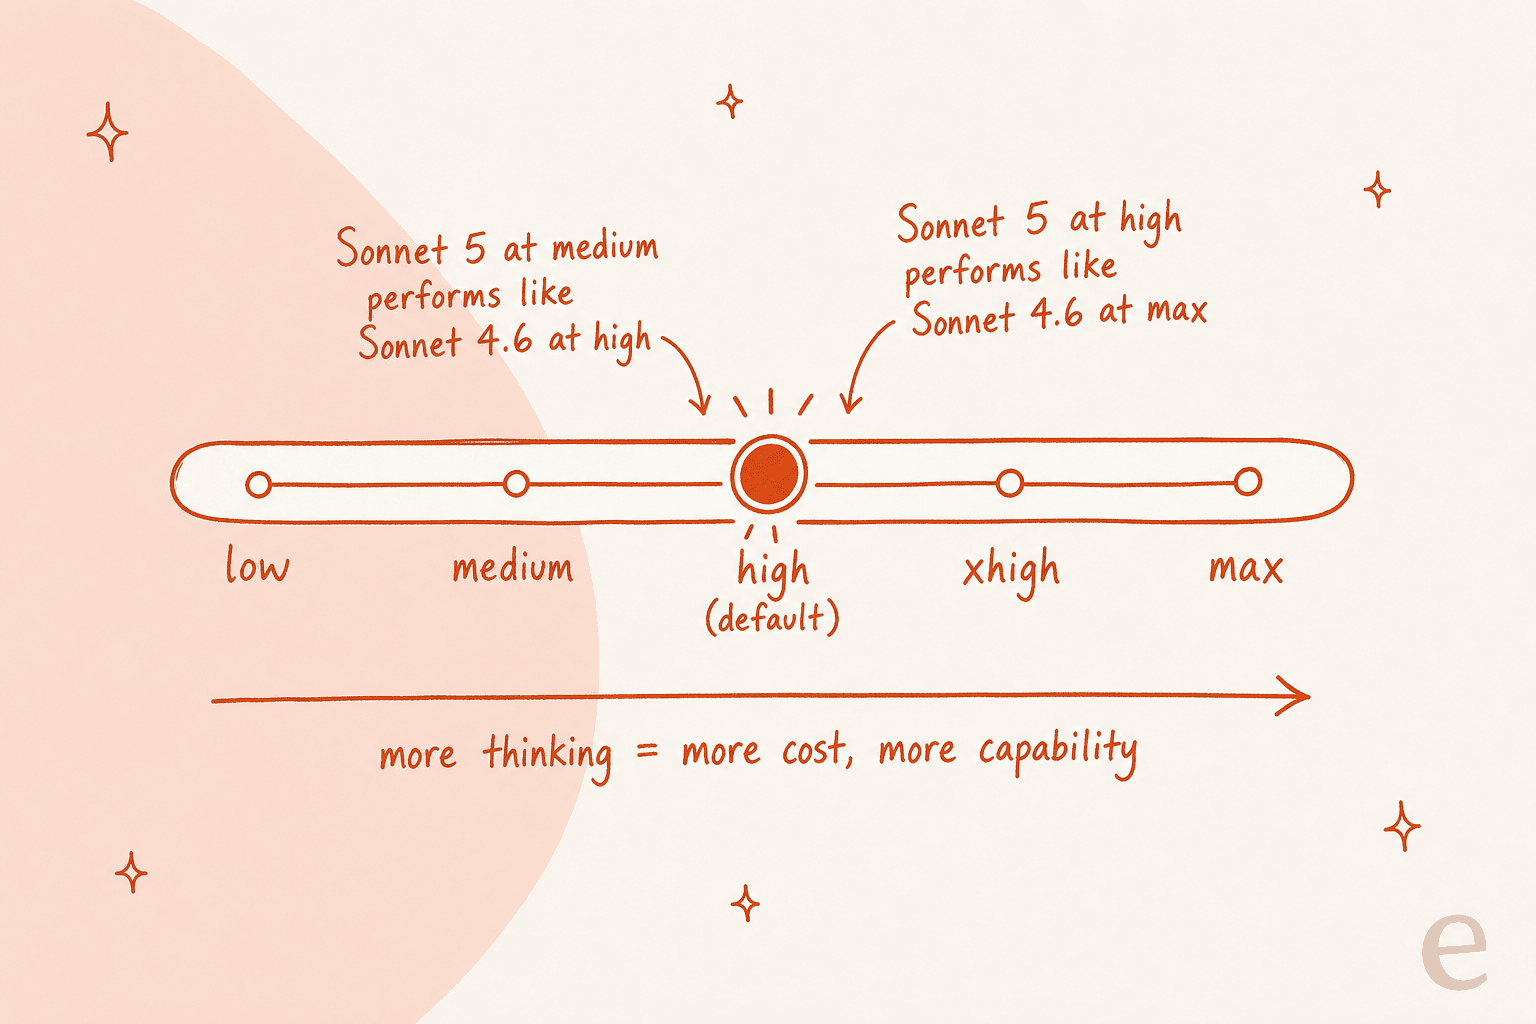
O mapeamento aproximado da Anthropic é genuinamente útil para planejamento de orçamento: o Sonnet 5 em medium tem desempenho parecido com o do Sonnet 4.6 em high, e o Sonnet 5 em high fica próximo de onde o 4.6 estava em max. Ou seja, o mesmo padrão de qualidade agora custa menos tokens de raciocínio, o que é um ganho real de eficiência. O outro lado da moeda é que o padrão é high, então, direto da caixa, o Sonnet 5 pensa mais (e custa mais por chamada) do que você poderia esperar se estiver acostumado com padrões mais antigos. A Anthropic chegou a aumentar os limites de taxa no Chat, Cowork, Claude Code e na API especificamente para absorver o maior uso de tokens em níveis de esforço mais altos.
Para quem está integrando o Sonnet 5 em um produto, o controle de esforço é onde a engenharia de custos agora acontece. Configurá-lo baixo demais deixa qualidade na mesa; deixá-lo em max para tarefas simples queima orçamento à toa.
A controvérsia do valor: ele é realmente mais barato?
É aqui que o consenso da semana de lançamento se dividiu, e é a parte mais útil da análise para se debruçar.
O preço na etiqueta é igual ao do Sonnet 4.6: $2 / $10 por milhão de tokens como tarifa introdutória até 31 de agosto de 2026, e depois $3 / $15. Mas duas coisas silenciosamente empurram o custo real para cima. Primeiro, aquele novo tokenizador cobra o mesmo texto em cerca de 1,0 a 1,35x mais tokens. Segundo, o maior esforço padrão significa mais tokens de raciocínio por requisição. Paridade de preço por token não é paridade de preço por requisição, e a Anthropic é franca ao afirmar que o desconto introdutório existe para manter a migração "aproximadamente neutra em custo" enquanto durar.
O agregador independente de benchmarks Artificial Analysis colocou o dedo na ferida:
"O Claude Sonnet 5 alcança 53 no Artificial Analysis Intelligence Index, mas, sem o preço promocional, vai custar mais por tarefa do que o Opus 4.8."
Eles cravaram cerca de $2,29 por tarefa nesse índice. Do lado dos entusiastas, a reação foi o espelho oposto: Wade Foster, CEO da Zapier, resumiu o argumento otimista:
"O Claude Sonnet 5 está no ar. Ele entrega trabalho no nível do Opus pelo preço do Sonnet."

Os dois têm razão, e esse é o ponto. Em esforço low e medium no trabalho típico, o Sonnet 5 é um valor claro. Empurre-o para xhigh ou max em uma tarefa difícil e você pode gastar mais do que o Opus 4.8 gastaria para entregar um resultado que o Opus daria por menos. Os fóruns no r/singularity têm discutido exatamente isso. O veredito não é "barato" ou "caro", é "barato se você gerenciar o controle".
Sonnet 5 vs Opus 4.8: qual você deveria usar?
Como eles se sobrepõem bastante (ambos com 1M de contexto, ambos fortes em agentes), a decisão é menos "melhor vs pior" e mais "qual deles para este trabalho".
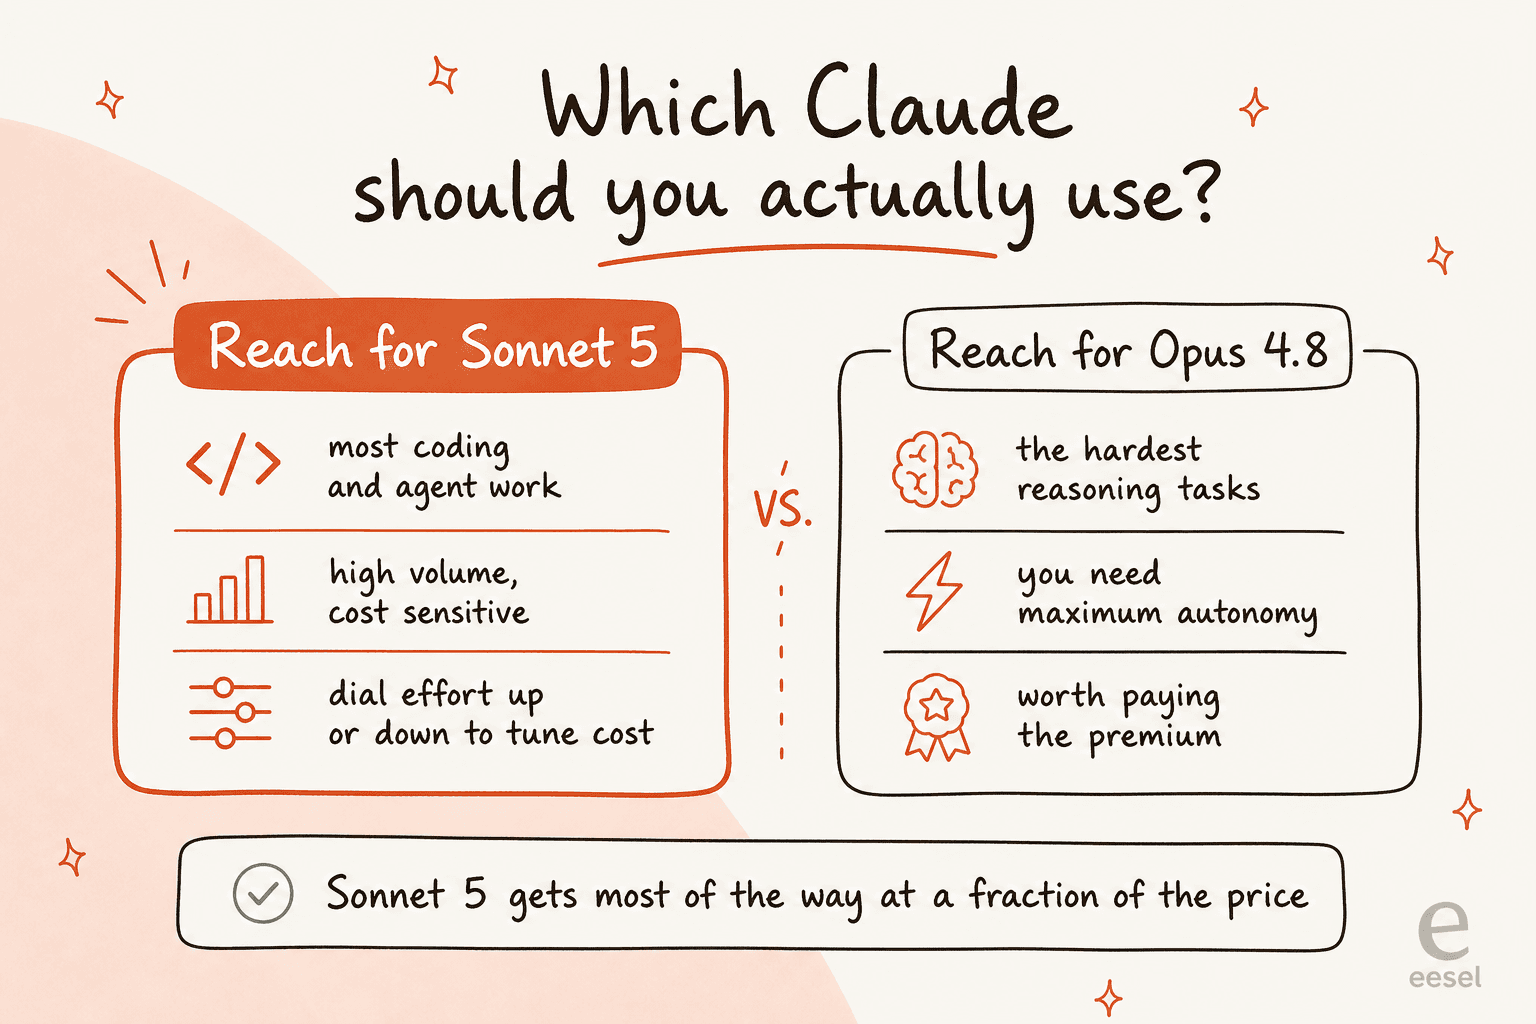
Minha regra prática depois de ler os números: use o Sonnet 5 como padrão para a maior parte da codificação, uso de ferramentas e trabalho cotidiano de agentes, especialmente qualquer coisa que você rode em volume, onde o custo se acumula. Recorra ao Opus 4.8 quando a tarefa exigir raciocínio genuinamente difícil, precisar de longos períodos de autonomia, ou for de risco alto o suficiente para que a qualidade marginal valha o preço premium (e onde a vantagem do Opus em raciocínio sem ferramentas realmente importa). Para a maioria das pessoas, na maior parte do tempo, o Sonnet 5 agora é a escolha padrão certa, e o Opus é o caminho de escalonamento, não o ponto de partida.
É seguro colocar na frente dos clientes?
Para uma demonstração de chatbot, segurança é uma nota de rodapé. Para um agente que toca autonomamente tickets reais de clientes, é o jogo inteiro, então olhei isso de perto.
A boa notícia: o Sonnet 5 é o Sonnet mais seguro até hoje. A Anthropic relata menos alucinação, menos bajulação, resistência mais forte a injeção de prompt e recusas mais limpas de pedidos maliciosos do que o Sonnet 4.6. Na auditoria comportamental automatizada, ele pontuou melhor (mais seguro) do que seu antecessor.
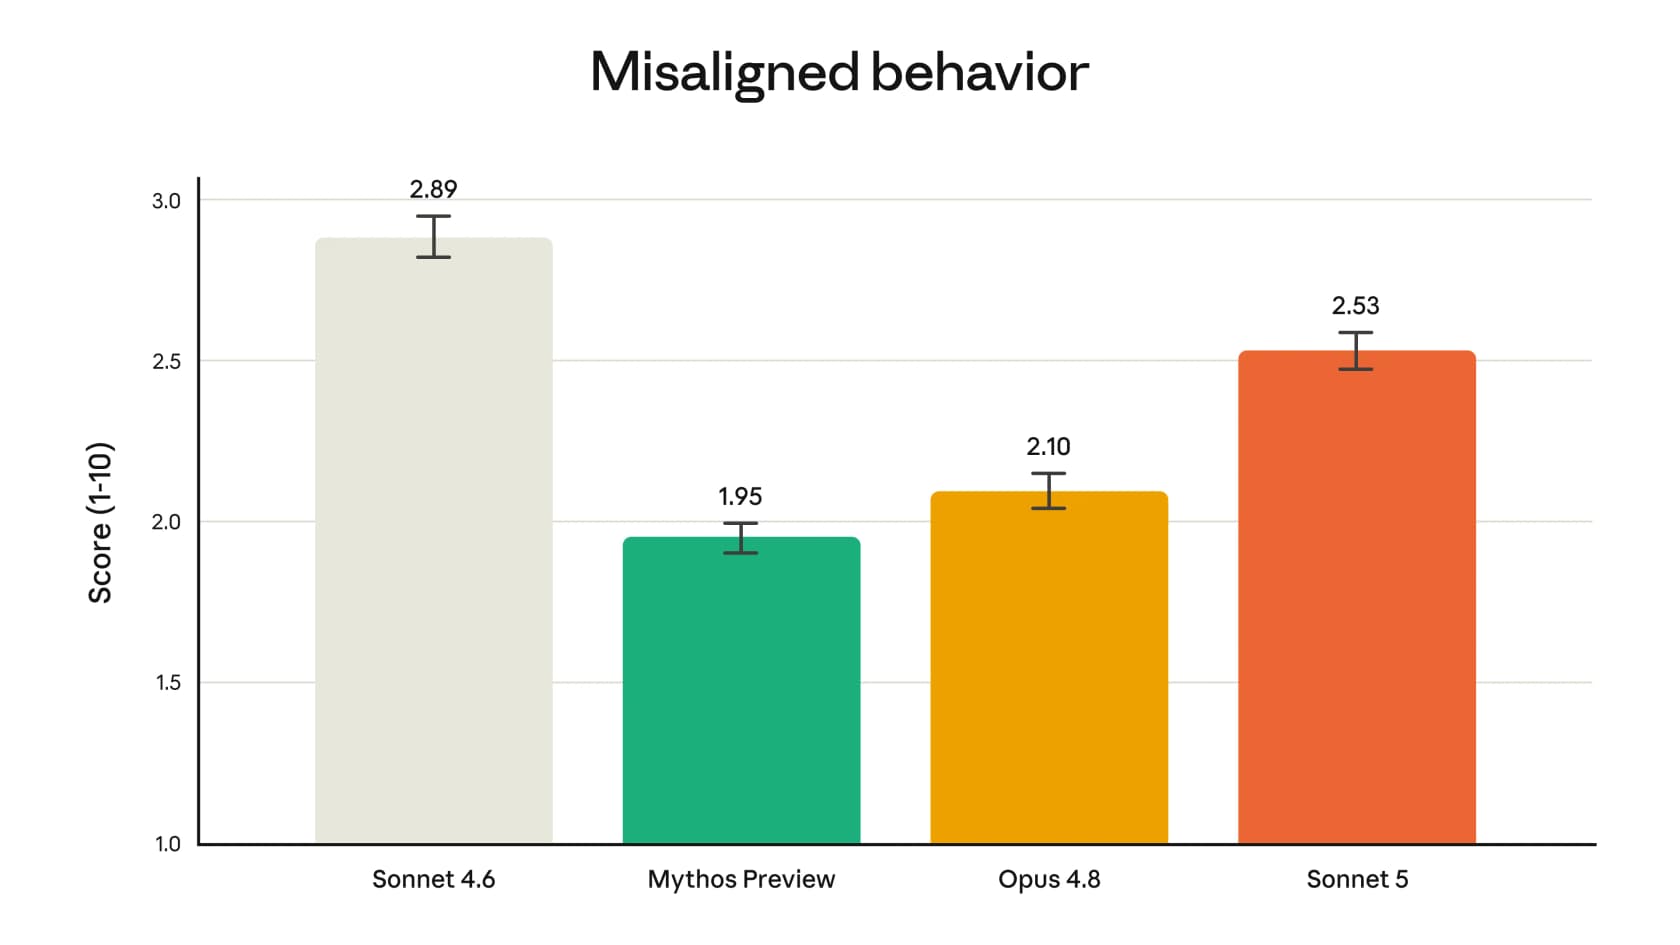
A ressalva honesta: a pontuação de comportamento desalinhado do Sonnet 5 (2,53) é melhor que a do Sonnet 4.6 (2,89), mas pior que a do Opus 4.8 (2,10) e a do Mythos Preview (1,95). Ou seja, é mais seguro do que o modelo que substitui, mas não é o mais seguro da família. O relatório técnico (system card) da Anthropic é direto ao afirmar que o Sonnet 5 apresenta "risco de alinhamento muito baixo (embora maior do que em modelos Sonnet anteriores)".
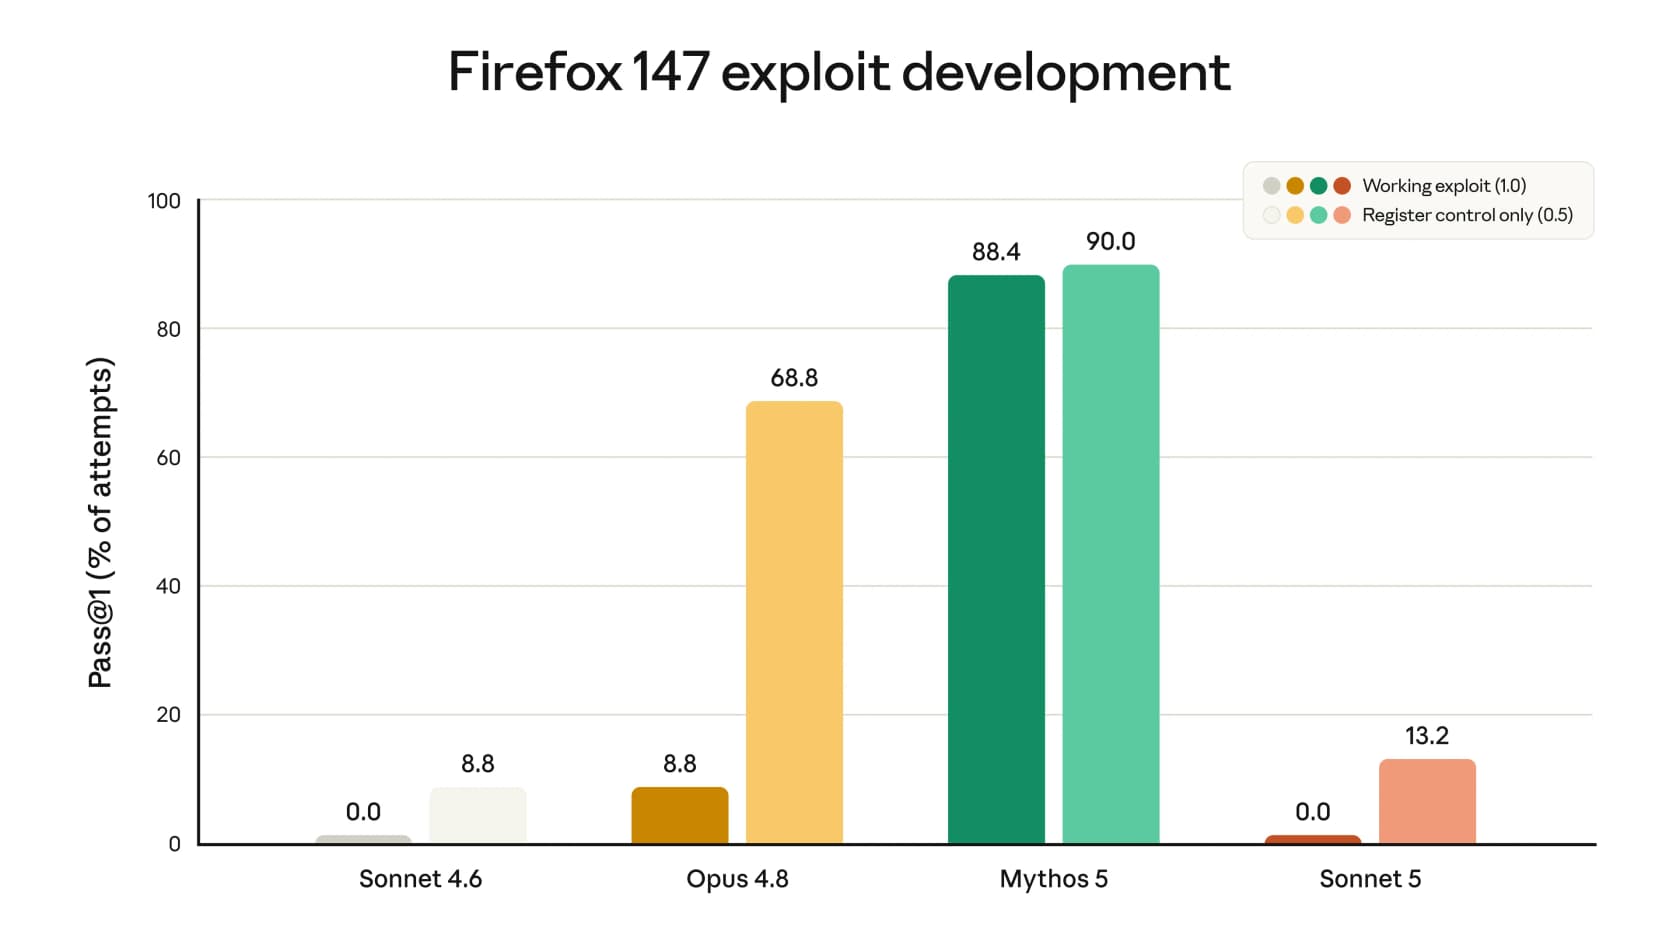
Já em capacidade ofensiva cibernética, o Sonnet 5 é tranquilizadoramente fraco: no teste de desenvolvimento de exploits Firefox 147 da Anthropic (construído com a Mozilla, com todas as vulnerabilidades já corrigidas), ele nunca produziu um exploit funcional.
Essa combinação (capaz, mais barato e não uma potência de ofensiva cibernética) é praticamente ideal para automação voltada ao cliente. Mas "o modelo é seguro" e "a implementação é segura" são duas frases diferentes, o que me leva à parte que realmente importa se você comanda uma equipe de suporte.
O que o Sonnet 5 significa se você comanda suporte
Eu trabalho na eesel, onde passamos anos colocando agentes de IA em filas de suporte ao vivo, e a coisa que sobrevive a cada lançamento de modelo é esta: um modelo mais inteligente e mais barato reduz o custo de uma resposta correta, mas não decide quais tickets são seguros para responder. Já vimos bots com respostas confiantes darem respostas erradas silenciosamente, e é exatamente por isso que as barreiras de proteção importam mais do que o benchmark bruto.
Um líder de CX de uma marca DTC de suplementos nos colocou a versão do lado do cliente disso de forma mais direta do que qualquer ficha técnica poderia: "a IA nunca vai conseguir responder 100% das perguntas. Eu preciso de uma IA que só lide com os tickets que tem confiança para lidar, e todos os outros, deixe-os de lado." Esse instinto não muda quando o modelo subjacente ganha uma nova versão.
O Sonnet 5 melhora a economia, isso é real. Mas os fatores decisivos para automação de suporte, roteamento baseado em confiança, treinamento com seus próprios tickets históricos, e a capacidade de simular um lançamento antes que ele chegue a um cliente, vivem na camada ao redor do modelo, não no modelo em si. É essa a parte que eu diria para qualquer um focar depois de escolher um modelo em que confia.
Experimente a eesel
O lado bom de escolher uma ferramenta de suporte agnóstica em relação ao modelo é que lançamentos como o do Sonnet 5 só a tornam melhor por baixo dos panos, sem nada para você trocar. A eesel AI se conecta ao seu helpdesk existente, treina com seus tickets passados e central de ajuda, e roda em modelos de fronteira como o Claude Sonnet 5, então você ganha os avanços de capacidade sem precisar reestruturar nada.

Onde ela realmente se destaca é na parte que um modelo puro não consegue fazer: um modo de simulação que reproduz milhares dos seus tickets históricos para que você veja a taxa de resolução antes de entrar no ar, e regras baseadas em confiança para que a IA só responda automaticamente onde tem certeza e deixe o resto para um humano. Um cliente, a Gridwise, viu a eesel resolver 73% das solicitações de nível 1 deles no primeiro mês. Você pode experimentar a eesel gratuitamente e simular com seus próprios tickets em poucos minutos.