

FLUX 3 Actionは、Black Forest Labsの新しい基盤モデルのうち、ピクセルではなく物理的なアクションを予測する部分です。ポイントは、動画を生成するのと同じモデルを別の方法でデコードしていることです。BFLの主張はこうです。説得力のある動画を生成するには、モデルはすでに世界の振る舞い(接触、重さ、因果関係)を学んでいなければなりません。だから、ロボットの次の動きを予測することは、その同じ理解を別の角度から見ているにすぎません。
mimic roboticsとFLUX-mimicとして製品化され、従来のロボットでは触れられなかった作業、たとえばケーブルや柔らかいシールの取り扱いでAudiにてテスト・導入されています。注目の数字は、柔らかい物体のキッティング作業で成功率の中央値95%を達成したことです。さらにバックボーンを固定した状態でも従来のロボットモデルを上回りました。この設定では、それまでの最高モデルは0%でした。
多くの読者にとっての注意点:FLUX 3 Actionはまだ使えません。選ばれたパートナーに限定されており、公開API、価格、ウェイトはありません。今日すぐ働かせられるAIエージェントを探してここに来たなら、FLUX 3はロボット向けのインフラであり、採用する相手ではありません。この違いを理解しておく価値があり、最後にそこへ着地します。
FLUX 3 Actionとは実際に何か
まず名前の整理をします。ここで混乱しやすいからです。FLUX 3は、FLUXの画像モデルを生んだBlack Forest Labsによる、単一のマルチモーダル基盤モデルです。画像、動画、音声をまたいで共同で学習されており、同社はこれを「one multimodal model for Image, Video, Audio and Action-Prediction」と説明しています。
Action-Predictionはその4つ目の機能です。視覚的な観測とテキストの指示を受け取り、物理的な結果をロボットの制御アクションとして予測します。つまり「FLUX 3 Action」はダウンロードできる別製品ではありません。FLUX 3のバックボーンの機能であり、mimicとの提携で実際のロボット向けに作られたバージョンがFLUX-mimicです。
面白いのはBFLの捉え方です。彼らの言葉では、動画の生成とロボットの制御の両方ができるモデルは「was never really only a content creation model. It is a model of how the world behaves, and content creation is one thing one can do with it.」とのことです。大きな主張なので、なぜそれが正しい可能性があるのかを順に見ていきます。
なぜ動画モデルでロボットを動かせるのか
ここが仕組みであり、アイデアのすべてです。リアルな動画を生成するようにモデルを学習させると、モデルは物理を学ぶしかありません。物体の重さ、手がそれをつかむ様子、2つのものがぶつかったときに何が起こるかを間違えると、動画は明らかに偽物に見えます。つまり、世界を正確にレンダリングすることを学ぶのは、内部的には世界の振る舞いを学ぶことなのです。
BFLはこれに具体的な数字を付けています。動画予測はFLUX 3の総学習計算量の95%以上を占めます。一方、音声は720pクリップのトークンの0.5%未満です。動画を理解すれば、唇の動きや衝撃音に音を合わせるのは比較的簡単だからです。アクションも同じ形です。ロボットの状態は低次元の信号で、カメラが見ているものと強く結びついています。フレーム、音声、アクションは、ひとつの物理的な現実の部分的なビューです。モデルが動画からその現実を学んでしまえば、アクション予測は新たな飛躍ではありません。
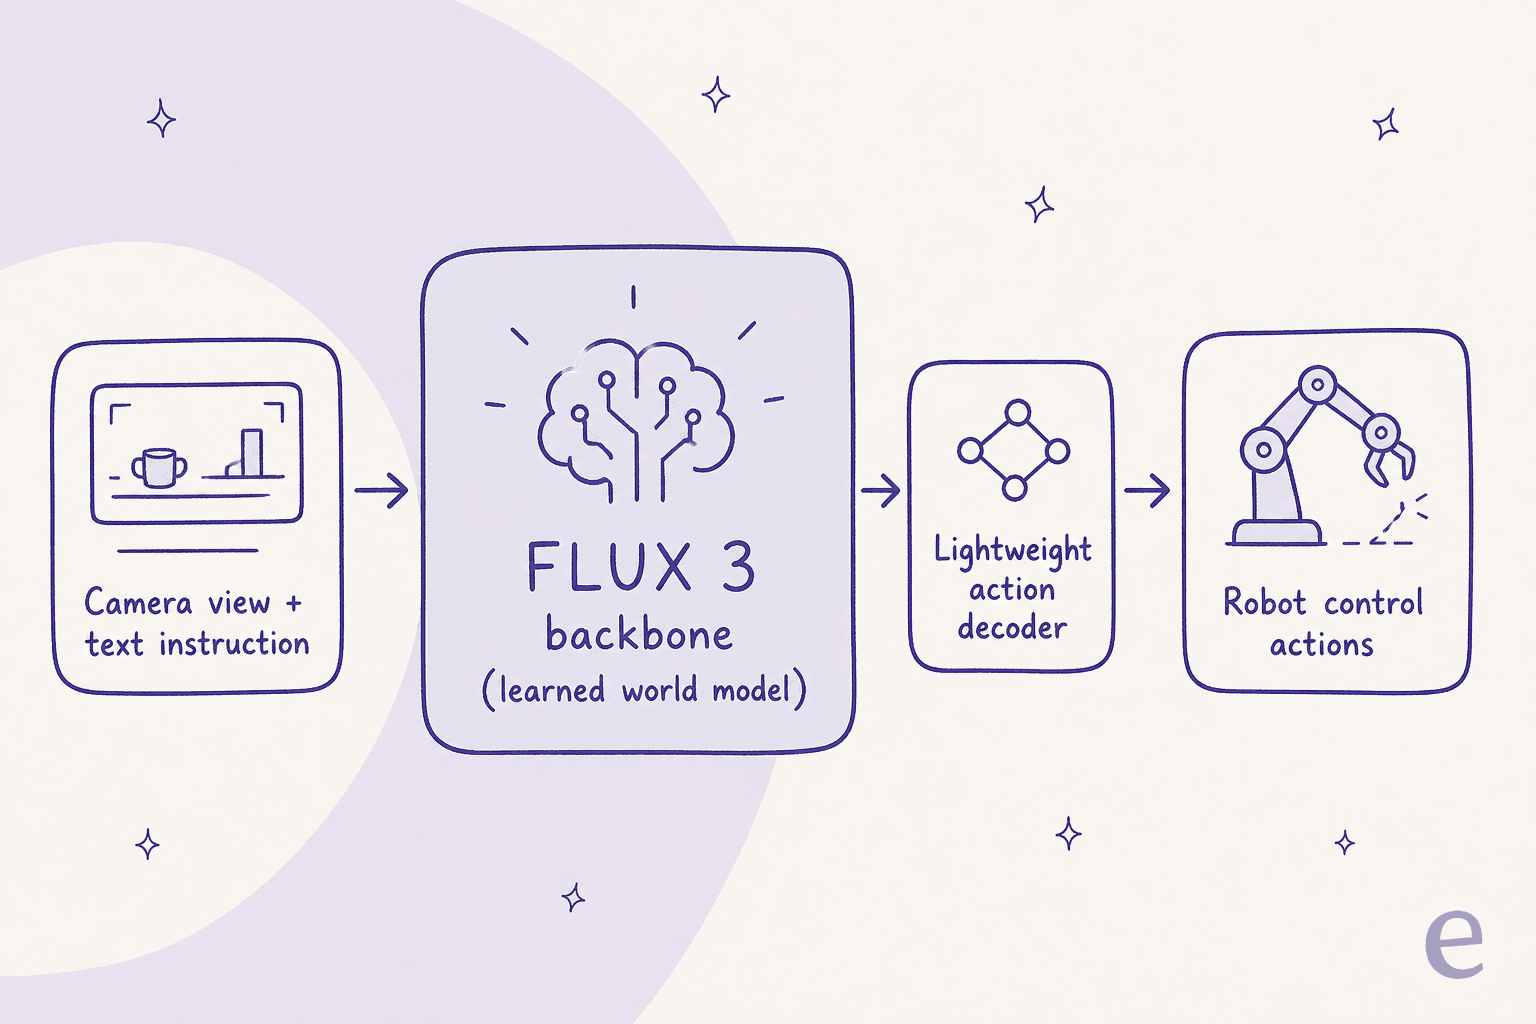
パイプラインは意図的に無駄がありません。カメラ映像と指示が、学習済みのワールドモデルを持つFLUX 3バックボーンに入ります。小さなアクションデコーダが動画予測の経路から中間特徴を直接読み取り、制御アクションに変換します。高コストな部分である世界の理解は、ロボットが動く前にすでに終わっています。これは、生成型バックボーンを再利用せず、エンドツーエンドでアクションを出力するよう学習される大半のビジョン・言語・アクションモデルとは異なるアプローチです。
アクションを追加するのにかかったコスト
アクションが本当に同じ世界の別のビューなら、FLUX 3にそれを予測させるのは安く済み、すでにできることを損なわないはずです。BFLが報告しているのはまさにそれです。大規模な学習の途中でアクション予測を追加したところ、モデルが新しいモダリティを吸収する間、テキストから動画、画像から動画の人間による評価は当初最大10%低下しました。3,500ステップ後には、動画品質は完全に元の水準に戻り、さらにアクション予測も備わりました。
この回復が「ひとつのバックボーン、ふたつの仕事」という仮説の証拠です。モデルは動画品質とロボット制御を恒久的にトレードしたわけではありません。新しいモダリティがすでに知っている世界にどう対応するかを理解する必要があっただけで、その後ペナルティは消えました。土台となる研究はSelf-Flowと呼ばれ、生成と表現学習を統合して、一方を改善すればもう一方も改善するようにします。
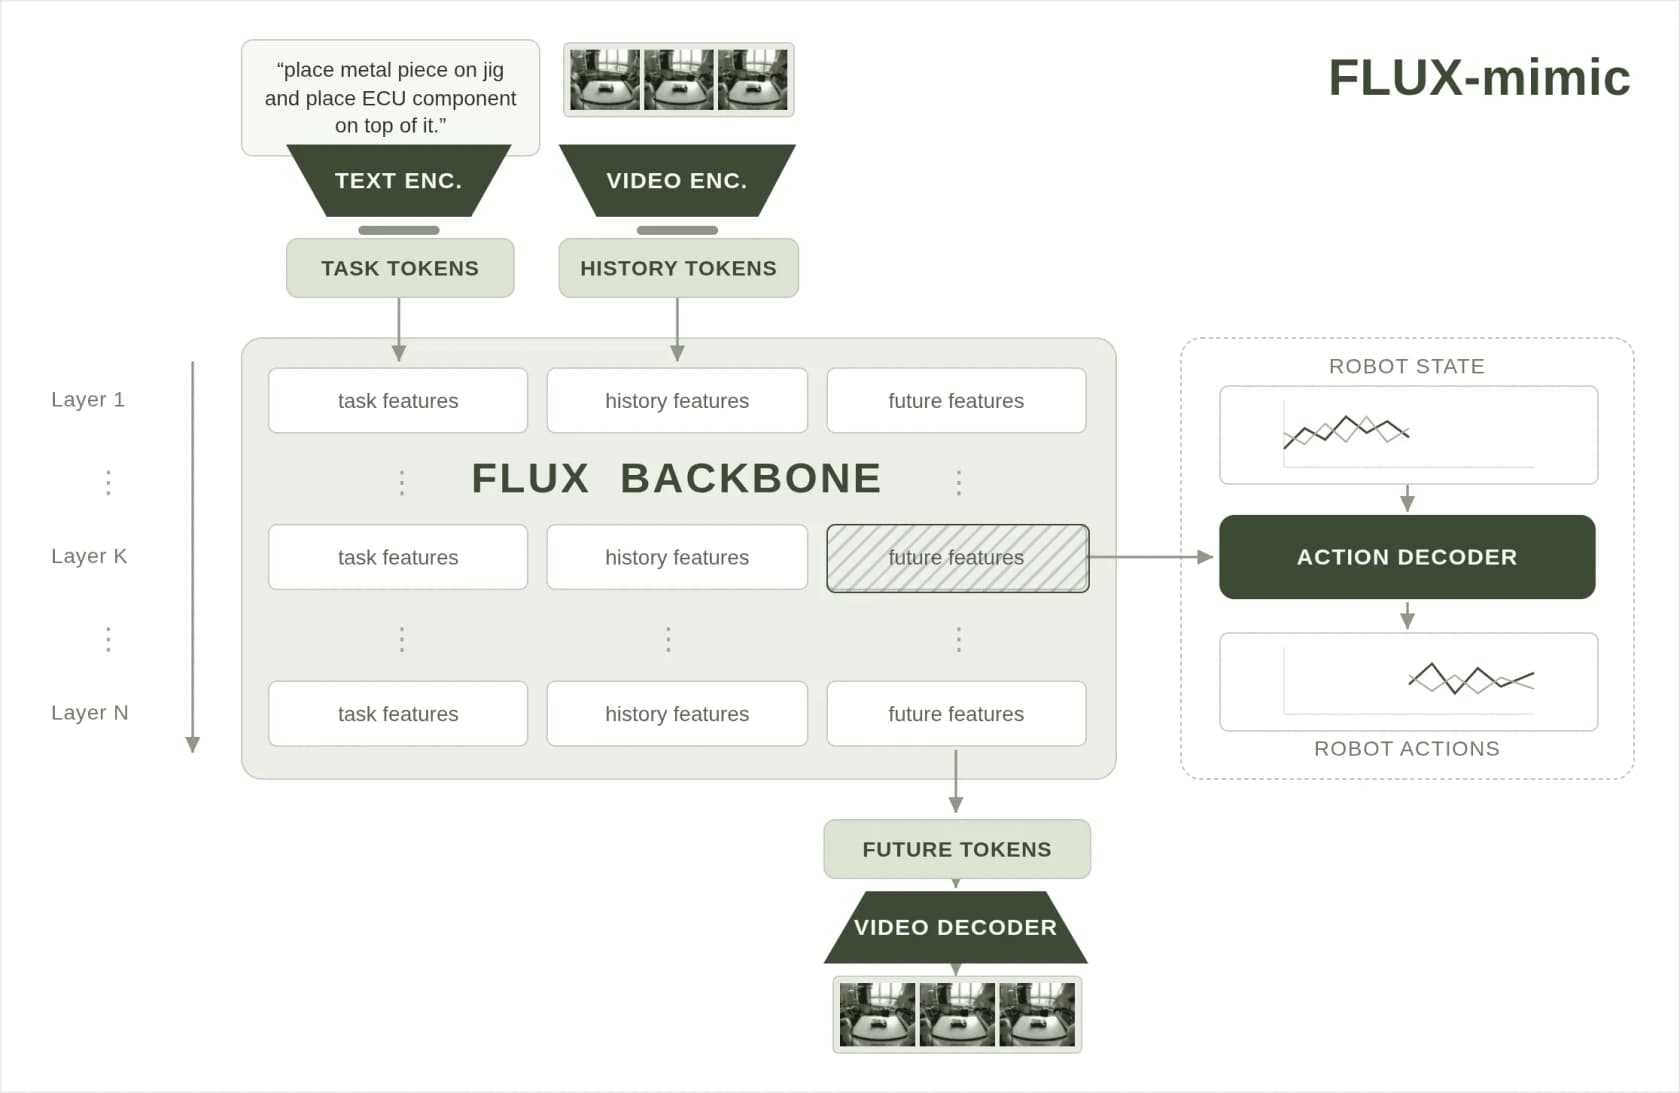
この分岐は、BFL自身のアーキテクチャ図で確認できます。テキストと動画のエンコーダが共有のFLUXバックボーンに入力され、同じ層が将来の特徴を2通りに生み出します。フレームを生成する動画デコーダと、ロボットのアクションを出力する軽量なアクションデコーダです。1本の幹に、2つの頭です。
ベンチマークが実際に示すもの
ここでFLUX 3 Actionは意外な結果を見せるので、数字を素通りせずじっくり見たいと思います。柔らかい物体のキッティング作業(従来のオートメーションが苦手としてきた柔軟な素材の取り扱い)で、BFLはモデルごとに20回の自律試行における成功率の中央値を測定しました。
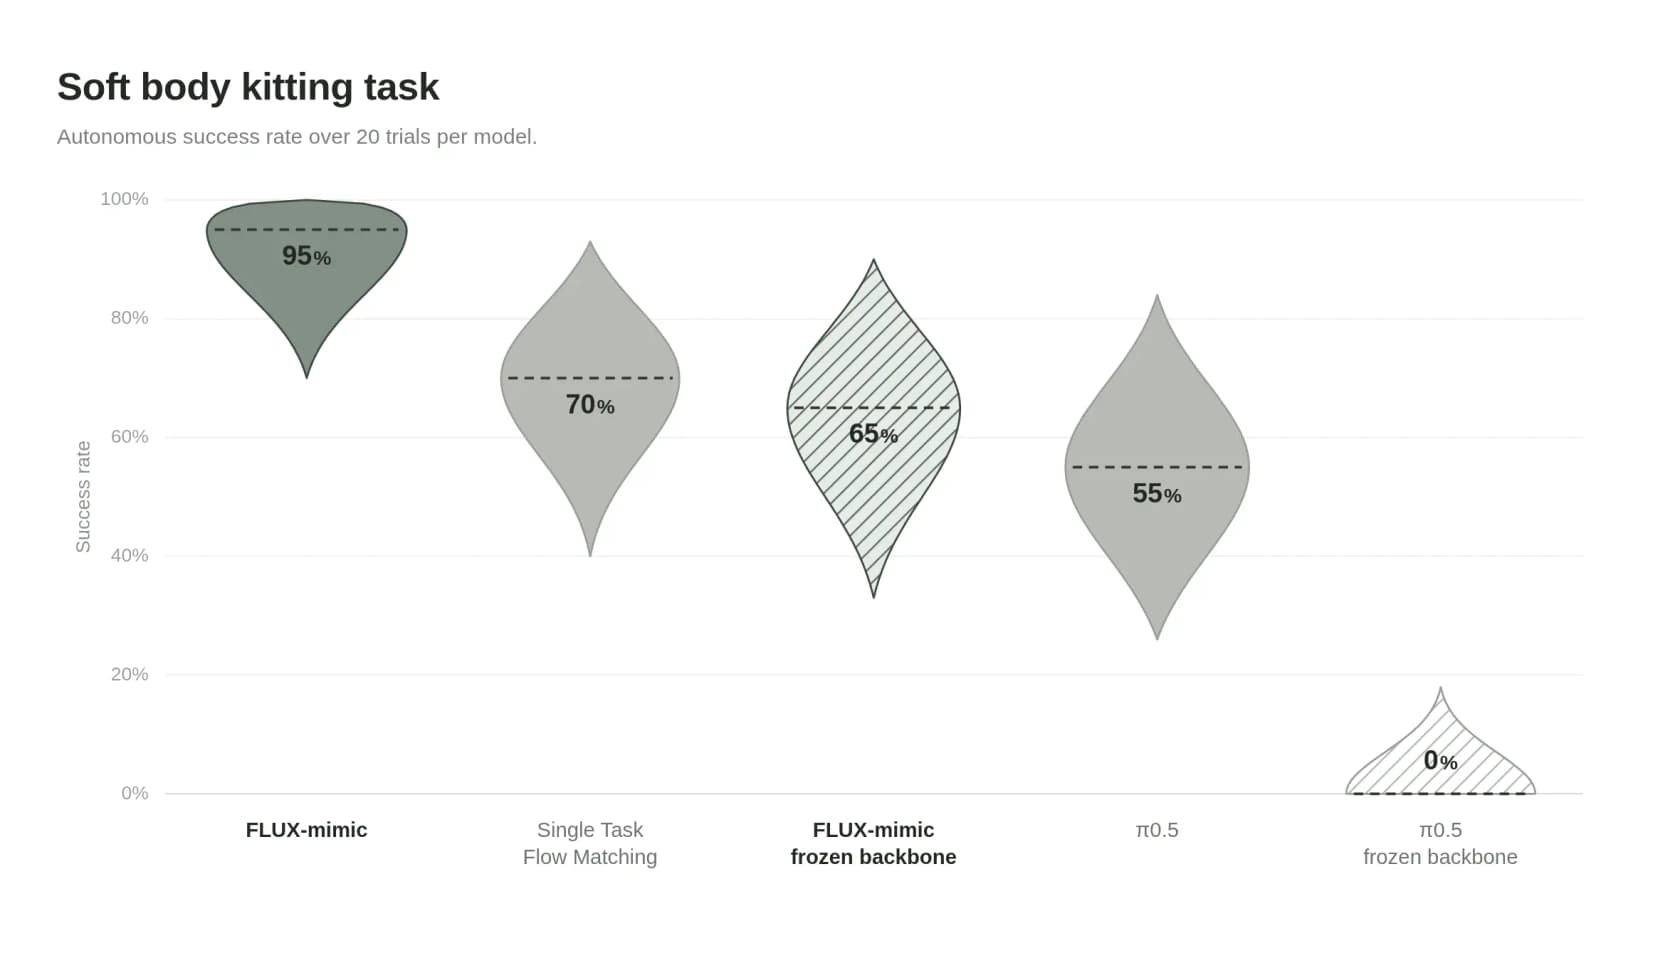
FLUX-mimicは95%に達しました。単一タスクのフローマッチングのベースラインは70%、強力な従来のビジョン・言語・アクションモデルであるπ0.5は55%でした。ただし最も重要なのは、バックボーン固定の列です。FLUX-mimicのバックボーンを固定する(ファインチューニングなし、事前学習済みのワールドモデルにデコーダを載せただけ)と、それでも65%を記録します。π0.5に同じことをすると0%です。言い換えれば、FLUX 3の事前学習済みの表現は、タスク固有の学習がほとんどなくてもロボットを動かせるほど優れており、これは以前のモデルには言えなかったことです。
さらに、複合的に効いてくる発見をいくつか挙げます。
- サンプル効率。 mimic-videoの研究では、物理がすでに表現の中にあるため、同じ能力に達するのに必要な例の数がビジョン・言語・アクションモデルの最大10分の1と報告されています。
- 自己回復。 つかみに失敗したロボットは、そうした回復を示すデモがなくても自分で修正して再挑戦します。それは学習データではなく、ワールドモデルから来ています。
- 速度。 バックボーンはカメラ入力から世界の表現まで、NVIDIA RTX 5090 1枚で80ms未満で動作し、mimicのロボット全体のループは101msで反応します。これはおおよそ人間の視覚反応時間です。
速度の点は地味ですが重要です。より良い表現はパラメータあたりの能力が高いことを意味するため、BFLはより小さい(したがってより速い)バックボーンを動かしながら精度の基準を満たせます。ロボティクスでは、レイテンシが導入を阻む制約になるので、現実世界についていける小さなバックボーンは、生の成功率以上に大きな意味を持ちます。
研究室から工場の現場へ
シミュレーションでしか動かないのであれば、どれも意味がありません。そのため、Audiでの導入が証明となります。Audiは自動車業界で最も自動化された生産ネットワークのひとつを運営しており、従来のロボットがどこで止まるかを正確に把握しています。柔軟な部品、精密な操作、そして、手でプログラムしたロボットセルをケースごとに再設計するには高すぎるプレミアム生産のバリエーションの多さです。
"In partnership with mimic, Audi has been testing and deploying FLUX-mimic. We have seen these robots solve complex soft-body manipulation work that would have been simply impossible with conventional robotics."
BFLが挙げる作業は具体的です。部品を構造化されたトレイにキッティングする、電子制御ユニットを狭い治具に挿入する、部品を組み立てる、シールやケーブルのような柔らかく柔軟な素材を取り扱う、などです。最後のカテゴリは何十年も頑なに手作業のままだったので、このアプローチが真価を発揮する場所を示す妥当なサインです。
FLUX 3 Actionは実際に使えるのか?
ここからは正直な現状です。期待が提供状況を追い越しているからです。Black Forest LabsはFLUX 3を段階的に提供しており、アクション予測は購入できるものではありません。
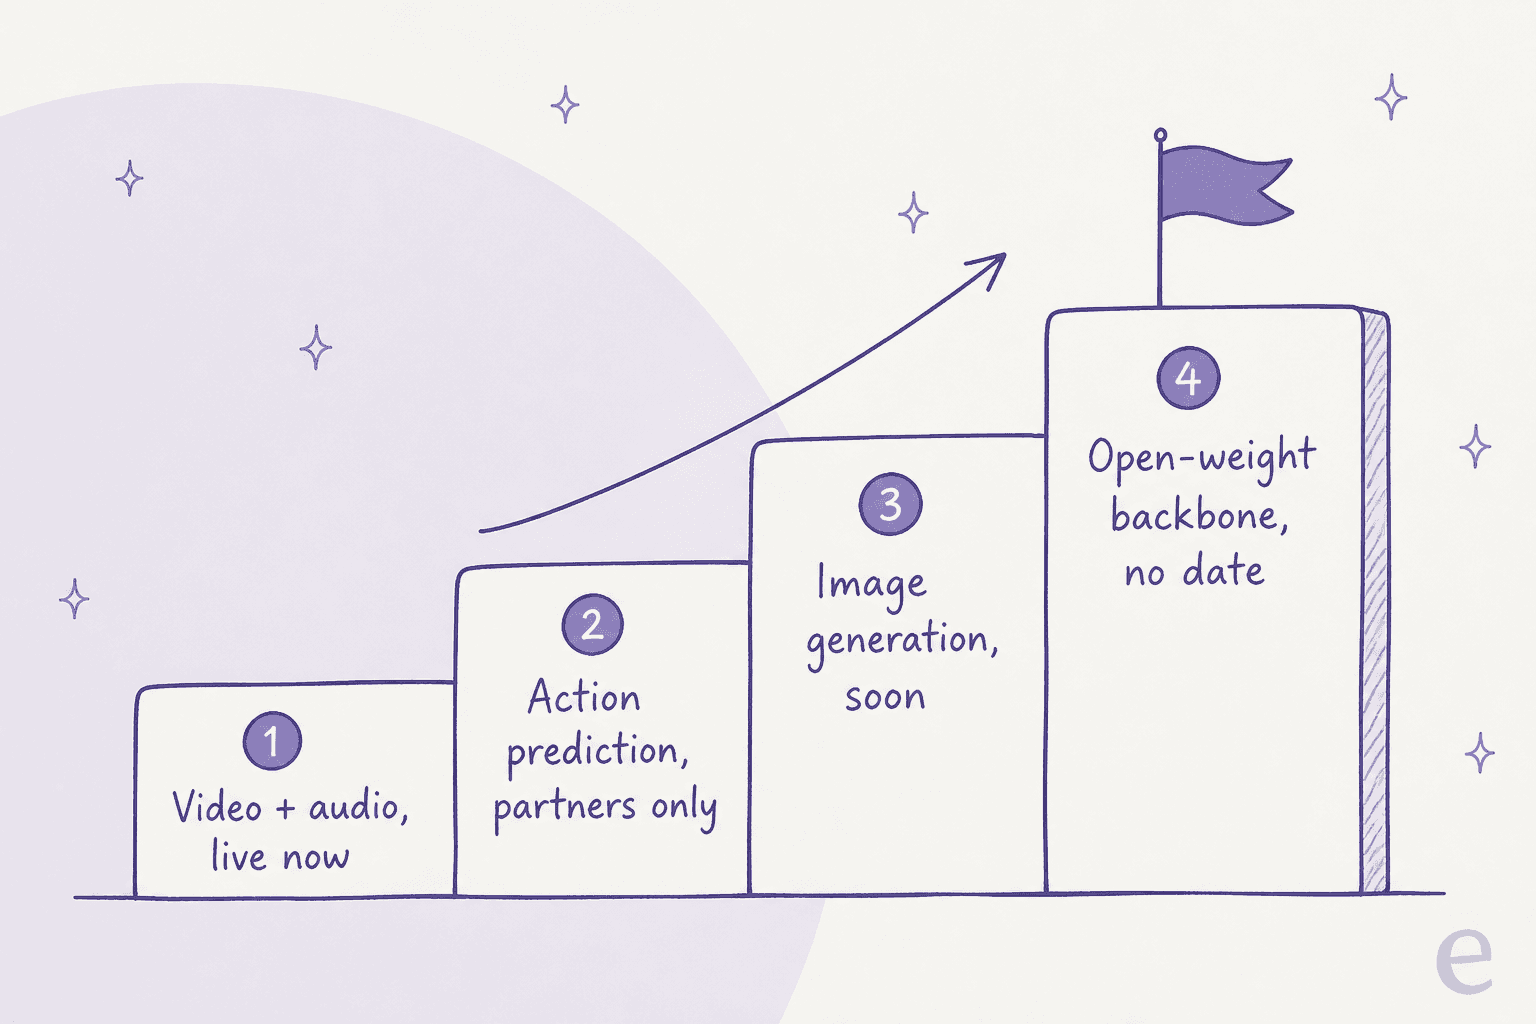
BFLが公表した展開順序は、動画の生成と編集が先、次に選ばれたパートナーとのアクション予測、その次に画像合成、最後にバックボーンへのオープンウェイトのアクセスです。現時点で一般提供されているのは音声付き動画のみです。アクション予測はパートナー限定(mimicが早期アクセス)で、公開API、公表された価格、オープンウェイトはありません。FLUX 3の画像生成はまだ「soon」と表示されており、オープンウェイトのバックボーンには日付すらありません。
そのため、今日FLUX 3に触れたい場合、実際にお金を払えるのは動画です。テキストから動画、画像から動画、動画から動画で最大20秒、ネイティブに同期した音声付きで、サブスクリプションなしの従量課金のBFL APIの料金で利用できます。ロボット関連については、製品ではなく、研究プレビューとパートナープログラムを眺めている段階です。これは批判ではなく、最前線がそこにあるというだけです。フィジカルAIが選ばれたパートナーから一般提供へゆっくり進むのには、もっともな理由があります。
インフラと、実際に雇うチームメイト
少し引いて見てみたいと思います。「FLUX 3 Action」と「AIエージェント」のような言葉は同じ箱に放り込まれがちですが、まったく別の棚に属するからです。
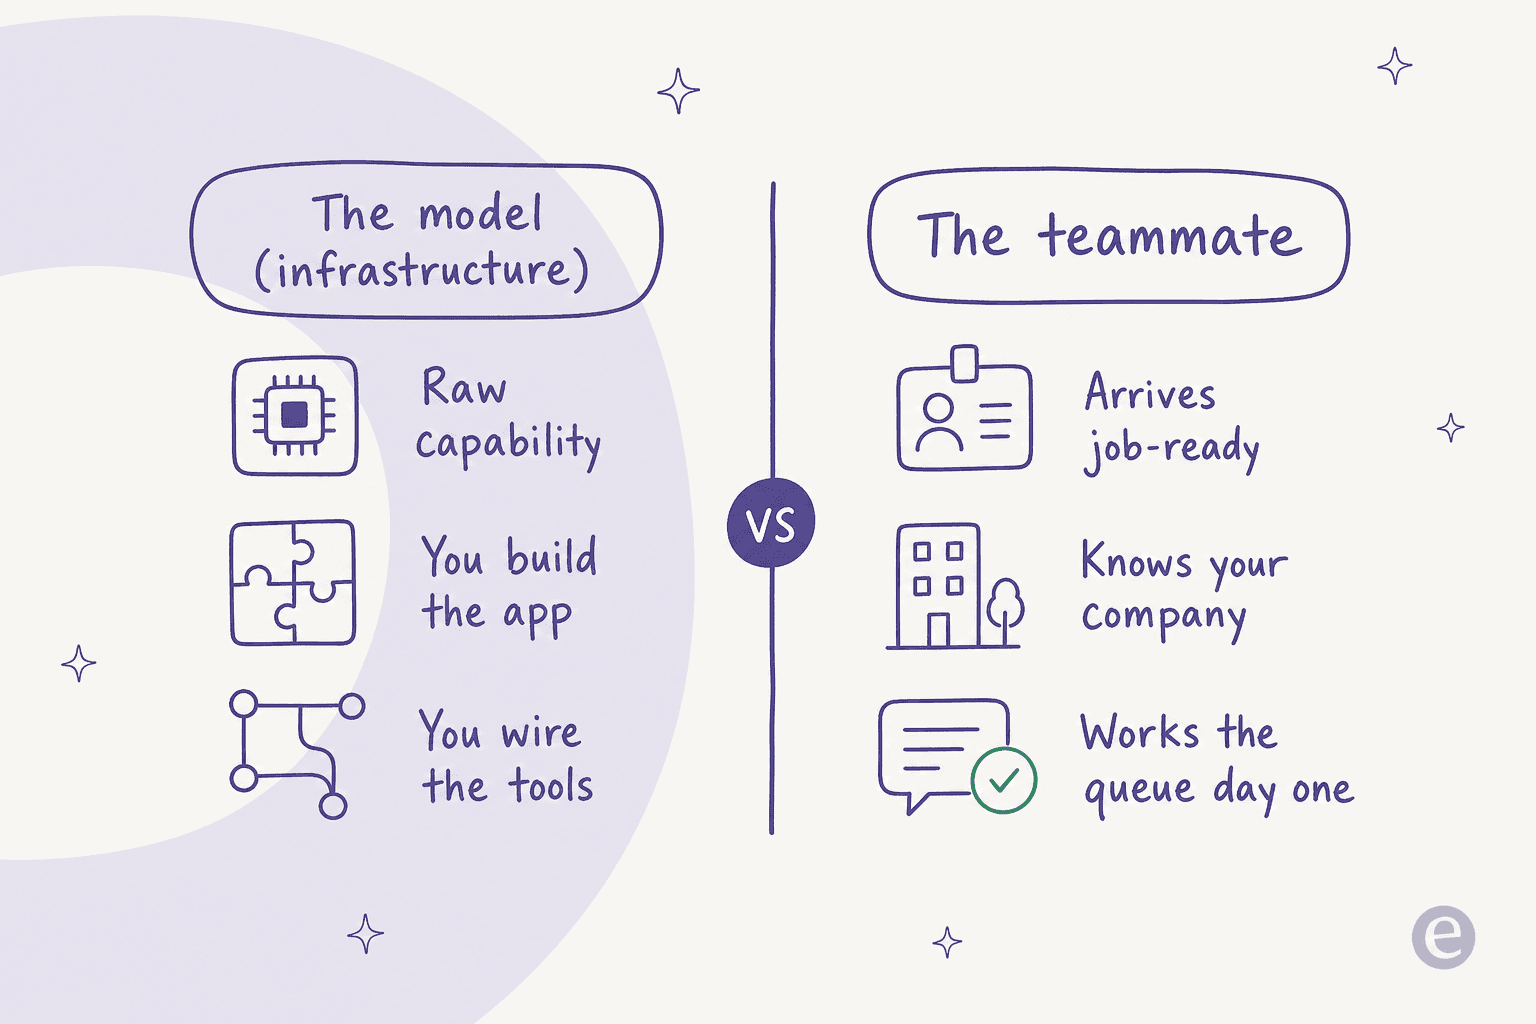
FLUX 3のような基盤モデルはインフラです。生の能力です。そこから価値を引き出すには、アプリケーションを作り、ツールをつなぎ、デプロイを処理し、(この場合は)物理ロボットに接続する必要があります。これは、エンジニアを抱えるロボティクスの研究室や自動車の生産チームにとってまさに適した形です。ただチケットに返信したいだけのサポートリーダーには、不向きな形です。
もう一方の棚はAIチームメイトです。すぐ働ける状態で到着し、すでに自社を理解していて、初日から働き始めます。周りにアプリを作るのではなく、新人に説明するように指示を与えます。それが私が取り組んでいるレイヤーで、モデルはチームメイトではないことをはっきりさせておく価値があります。エンジンが車ではないのと同じです。FLUX 3 ActionはフィジカルAIにとって素晴らしいエンジンです。ただ、雇う相手ではありません。
eeselとの関係
eeselでは、その線引きの「従業員であって、インフラではない」側を真剣に受け止めています。eeselはAIチームメイトのプラットフォームです。生のモデルを渡して上に何かを作ってもらうのではなく、特定の仕事のためにすぐ働けるチームメイトを雇います。現在のラインナップはAIヘルプデスクチームメイトとAIブログライターで、それぞれ役割に必要なスキル、連携、社内コンテキストを備えて到着します。
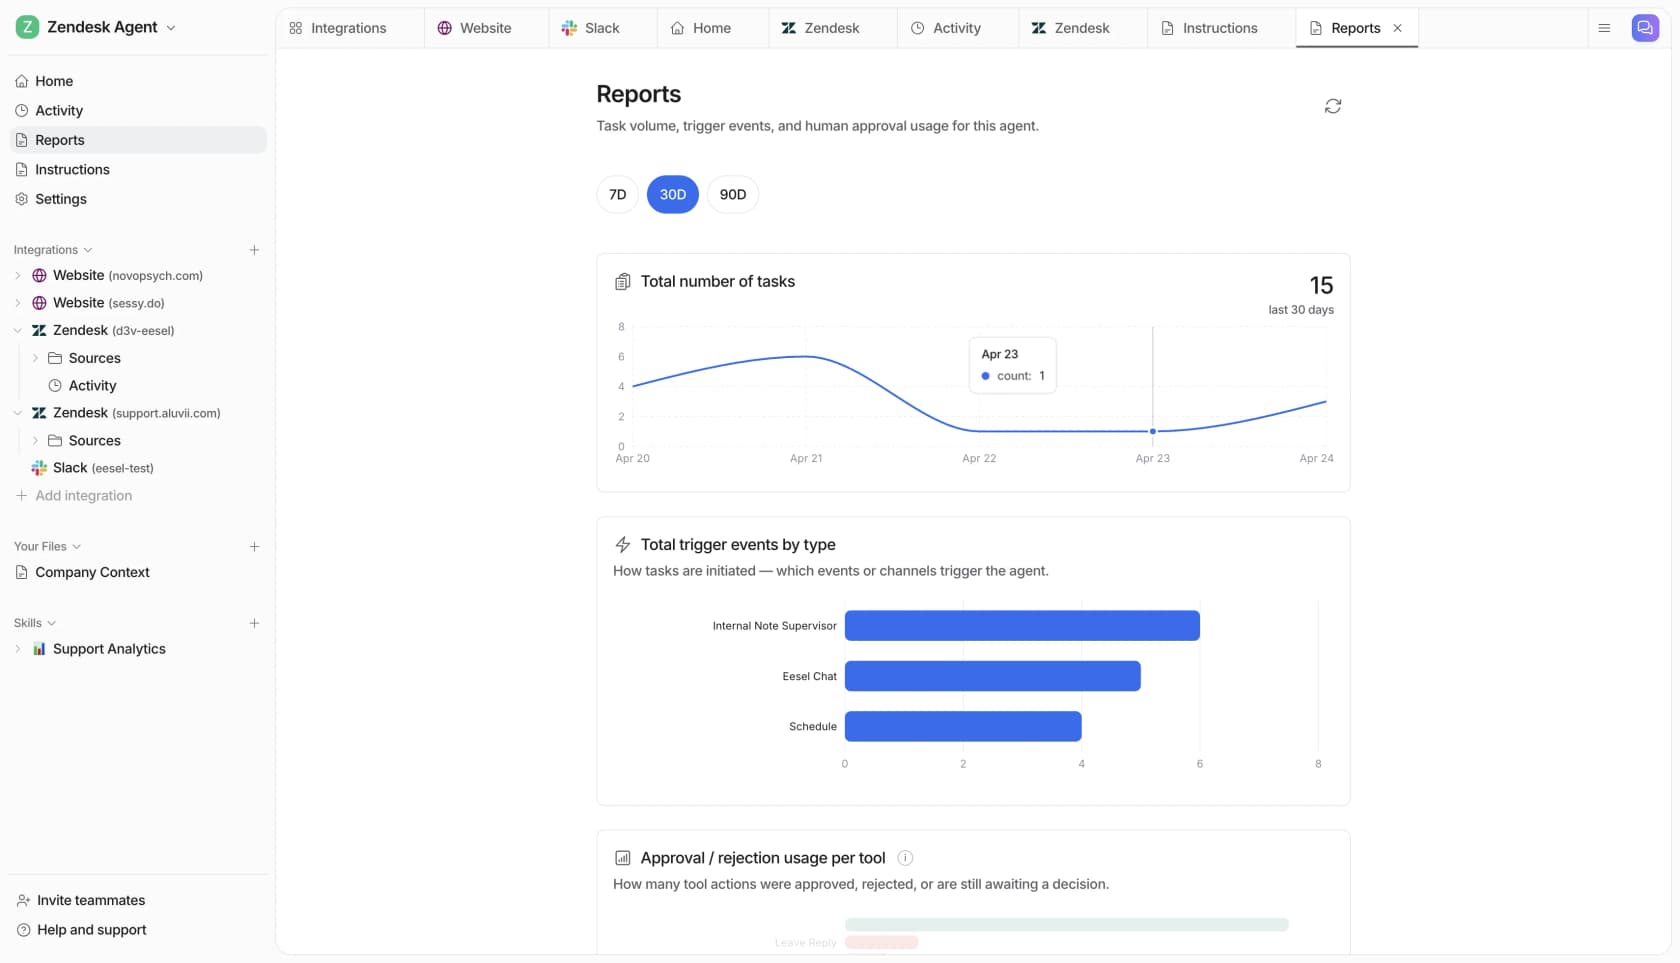
下にあるモデルは動く標的(今日はFLUX、来四半期は別のもの)なので、有用な抽象化は生の能力ではなくチームメイトです。ヘルプデスクのチームメイトは過去のチケットとヘルプセンターから学び、レビュー用に返信を下書きし、公開する前に自社の過去のチケットでシミュレーションできます。自信ありげなボットが静かに誤った答えを返すのを見てきたので、本番前のリハーサルで見つけたいのです。ターミナルから操作するのが好きなら、eesel CLIとそのMCPサーバーを使って、あなた(またはClaude Codeのようなコーディングエージェント)が連携の設定、ナレッジのアップロード、アクションの承認をJSONで行えるので、同じチームメイトをダッシュボードなしでプログラムできます。洗濯物をたたむことも、工場のラインに立つこともありません。ただし顧客対応とコンテンツ制作なら、それはインフラではなく、雇うべき相手です。無料で試せます。