

En bref
Lorsqu'un produit SaaS tombe en panne, le volume de support ne monte pas doucement, il explose. Les mêmes quelques questions (« c'est juste moi ? », « quand est-ce que ce sera réparé ? ») arrivent des centaines, voire des milliers de fois en une heure, et une équipe humaine les traite une par une pendant que les tickets vraiment inhabituels sombrent au fond de la file.
Le rôle de l'IA pendant une panne n'est pas d'être maligne, c'est d'absorber le flot répétitif pour que vos humains puissent traiter les quelques tickets qui demandent vraiment du jugement. Un agent IA de helpdesk bien cadré reconnaît les tickets liés à la panne, répond avec le message d'incident connu accompagné d'un lien vers la page de statut, les étiquette pour un nettoyage en masse ultérieur, et escalade tout ce qui ne correspond pas au schéma.
Le piège à éviter : une IA qui devine. Si elle invente une heure de rétablissement, confirme une mauvaise cause ou promet un remboursement, vous avez transformé un incident en deux. Gardez-la soumise à un seuil de confiance, et configurez votre mode incident avant d'en avoir besoin, pas à 2 h du matin quand l'alerte sonne. Si vous voulez que l'IA s'intègre au helpdesk que vous utilisez déjà, avec un prix mensuel fixe plutôt qu'un tarif par siège, c'est là qu'eesel trouve sa place.
Ce qu'une panne fait réellement à votre file de support
Je travaille dans la file de support, alors laissez-moi décrire la forme du phénomène plutôt que la théorie. Un jour normal, les tickets arrivent au compte-gouttes sur un large éventail de sujets : une question de facturation ici, un « comment faire » là, un rapport de bug de temps en temps. Vous pouvez trier au fil de l'eau.
Une panne réduit tout cela à un seul sujet. Dès que quelque chose d'essentiel casse, la courbe ne ressemble plus à un filet d'eau mais à un mur.
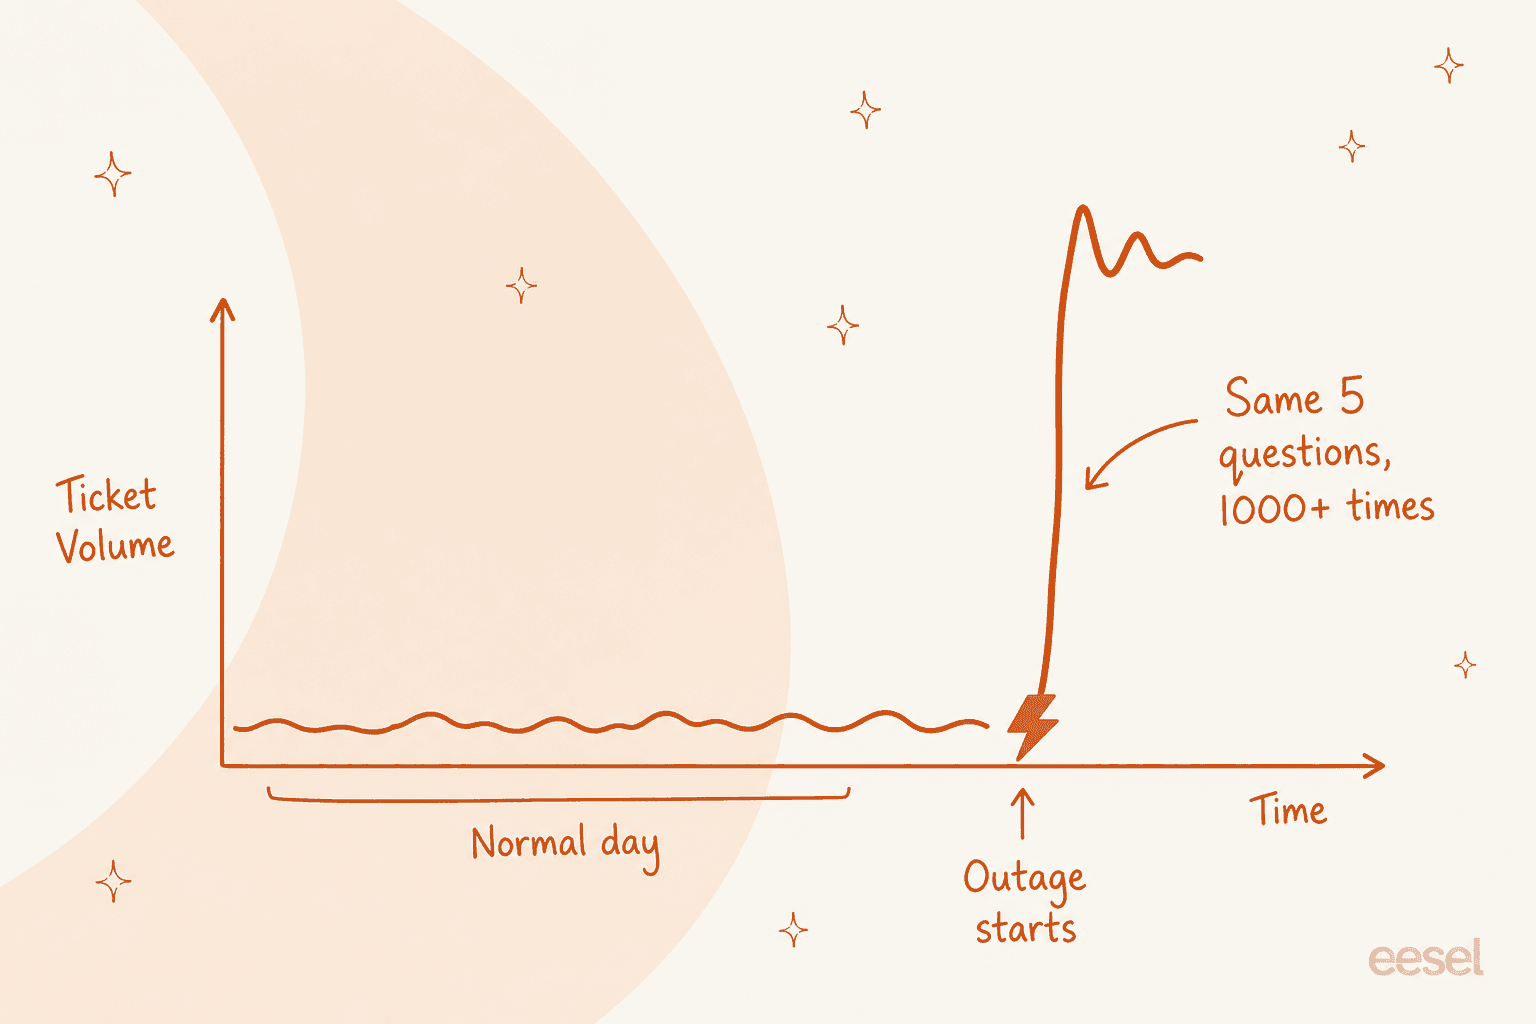
Le plus cruel, c'est que c'est presque toujours le même ticket. Un opérateur e-commerce multimarque dont j'ai vu les chiffres traite plus de 500 tickets par jour, surtout des demandes répétitives de remboursement, de désabonnement et de suivi de commande, même par temps calme. Ajoutez une panne à une telle base et la répétition devient verticale : les mêmes cinq questions, formulées de cinquante façons différentes, mille fois de suite.
Une équipe humaine est particulièrement mauvaise pour exactement ce genre de tâche. Répondre à la même question pour la quatre centième fois est épuisant, c'est lent parce que chaque réponse est encore tapée à la main, et pendant que vos agents s'en occupent, le client qui a un problème grave et vraiment différent est coincé en position 812 dans la file.
Pourquoi les humains atteignent le mur en premier
Les équipes de support sont généralement dimensionnées au plus juste, parce que le volume de tickets d'un jour moyen ne justifie pas d'être staffé pour le pire jour. Ce calcul tient la route jusqu'à l'arrivée du pire jour.
J'entends sans cesse la même chose de la part des responsables support : l'équipe est débordée et ne suit pas, et ce dont ils ont vraiment besoin, c'est qu'une machine prenne les tickets qu'une machine peut manifestement traiter. Un responsable support d'un service de suivi de bus, qui gère 200 à 250 tickets Zendesk par mois, nous a dit sans détour qu'il voulait que l'IA traite 60 % des tickets et, surtout, sache quand faire intervenir une vraie personne. Cette clause « savoir quand escalader » est tout l'enjeu pendant un incident.
Car le problème n'est pas seulement la lenteur des réponses. Vos profils les plus seniors, ceux qui devraient aider le canal d'incident à comprendre ce qui a cassé, passent à la place deux heures le nez dans leur clavier à copier-coller « nous avons connaissance du problème ». La panne vous coûte deux fois : une fois en indisponibilité, et une autre fois pour chaque personne qualifiée détournée vers la file.
Comment le support IA absorbe le flot
Voici le modèle mental que j'utilise. Pendant un incident, les tickets se répartissent en deux catégories : le flot (le même incident connu, encore et encore) et les exceptions (tout ce qui ne correspond pas). L'IA est très efficace sur la première catégorie et doit rester à l'écart de la seconde.
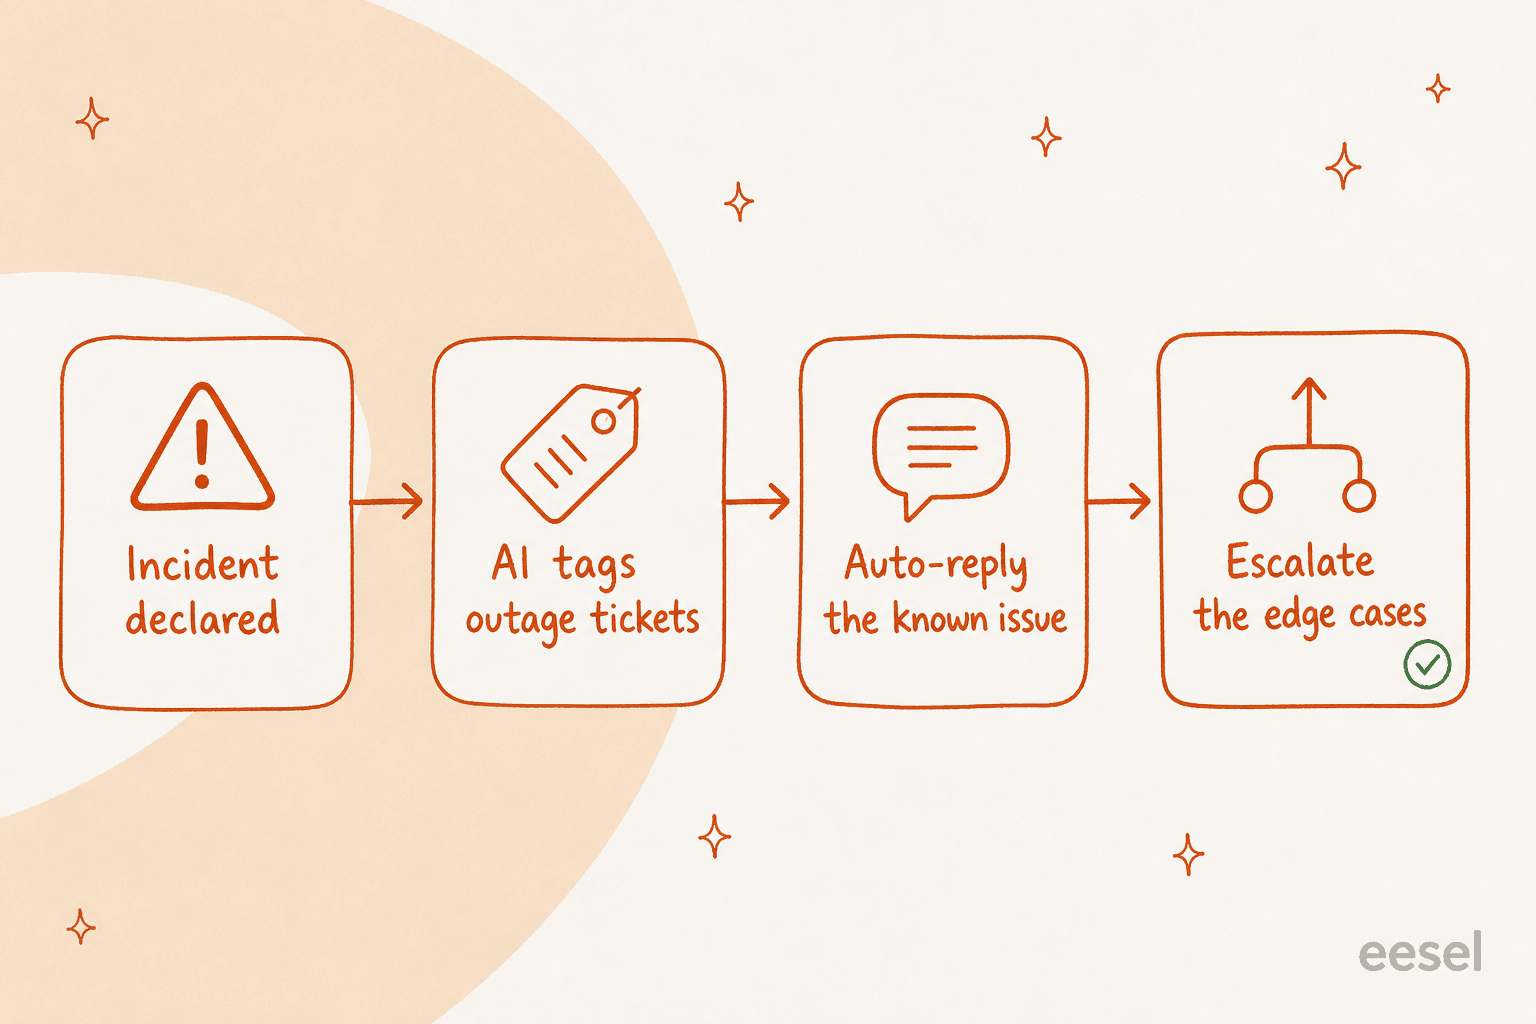
Voyons les étapes :
- Reconnaître le schéma. Une fois que vous savez ce qui est cassé, les tickets entrants qui le décrivent sont faciles à repérer. L'IA les compare à la description de l'incident connu que vous avez rédigée.
- Répondre, pas seulement dévier. Un ticket correspondant reçoit une vraie réponse : oui, nous avons connaissance du problème, voici ce qui est touché, voici la page de statut, nous vous tiendrons informé. C'est une vraie résolution pour ce client, pas une esquive.
- Étiqueter tout ce qu'elle traite. Chaque ticket lié à la panne est étiqueté pour que, lorsque le correctif est déployé, vous puissiez tous les clôturer d'un seul message de suivi « c'est maintenant résolu » au lieu de rouvrir chaque conversation.
- Escalader les exceptions. Un ticket qui mentionne la panne et un litige de facturation, ou un ticket qui ne ressemble en rien à l'incident connu, va à un humain sans y toucher.
C'est exactement la répartition pour laquelle un agent IA de helpdesk est conçu. Il se branche sur la file Zendesk ou Freshdesk que vous utilisez déjà (Gorgias et Help Scout aussi), la rejoint comme un coéquipier, et décharge votre équipe de la catégorie répétitive.
Parmi les comptes d'eesel, un client, Gridwise, a vu l'IA résoudre 73 % de ses demandes de niveau 1 dès le premier mois, et cela sur des jours ordinaires, pas seulement lors d'incidents. Pendant une panne, où les tickets sont encore plus uniformes, cette part grimpe.
L'aspect coût compte aussi, et il est facile de le manquer. Si votre outillage est facturé par siège, une journée à 10 fois le volume coûte la même chose en logiciel et une fortune en heures supplémentaires, car la seule façon pour des humains d'absorber un pic est de faire plus d'heures. Un prix mensuel fixe renverse la situation : eesel démarre à 299 $/mois pour 500 crédits (1 crédit par ticket ou chat) sans frais par siège ni frais de plateforme, de sorte que l'IA peut encaisser un flot de deux heures sans changement d'effectif, et le dépassement est facultatif avec un plafond que vous définissez.
Configurez un mode incident avant d'en avoir besoin
Le pire moment pour configurer tout cela, c'est en pleine panne. Faites-le maintenant, tant que c'est ennuyeux. Voici la configuration que je voudrais avoir en place avant le prochain incident.
- Rédigez la macro d'incident connu à l'avance. Vous ne connaîtrez pas la cause précise d'avance, mais vous pouvez pré-écrire la forme : « Nous avons connaissance d'un problème affectant [X]. Notre équipe s'en occupe. Suivez les mises à jour en direct sur [page de statut]. » Pendant l'incident, vous remplissez les blancs une seule fois, et l'IA l'utilise pour chaque ticket correspondant.
- Connectez le helpdesk et la page de statut. L'IA doit lire votre vrai centre d'aide et vos tickets passés pour que ses réponses sonnent comme les vôtres, et elle a besoin de l'URL de la page de statut pour orienter les clients vers une source faisant autorité.
- Limitez l'automatisation par type de ticket et niveau de confiance. Décidez à l'avance quelles catégories l'IA peut clôturer automatiquement et lesquelles elle doit laisser tranquilles. Remboursements, litiges et tout ce qui touche au juridique restent humains, toujours.
- Simulez sur des pannes passées. C'est l'étape que les gens sautent et regrettent. eesel fait tourner l'agent sur vos vrais tickets historiques avant sa mise en service, pour que vous puissiez voir comment il aurait géré votre dernier incident avant de lui confier le prochain. C'est ce qui se rapproche le plus d'un exercice d'évacuation pour le support.
- Câblez le circuit d'escalade. Vérifiez qu'un ticket escaladé arrive là où un humain le verra vite, pas dans un dossier que personne ne consulte avant lundi.
Si vous utilisez Slack comme canal d'incident, il vaut la peine de le connecter aussi, pour que l'IA puisse publier au même endroit que vos ingénieurs qui se coordonnent et que le support et l'ingénierie ne lisent pas deux histoires différentes.
Ce que l'IA ne devrait jamais faire pendant une panne
C'est la partie que je tatouerais sur le mur. Une panne est précisément le moment où une IA trop zélée fait le plus de dégâts, parce que les clients sont déjà stressés et qu'une réponse fausse donnée avec assurance fait mal.
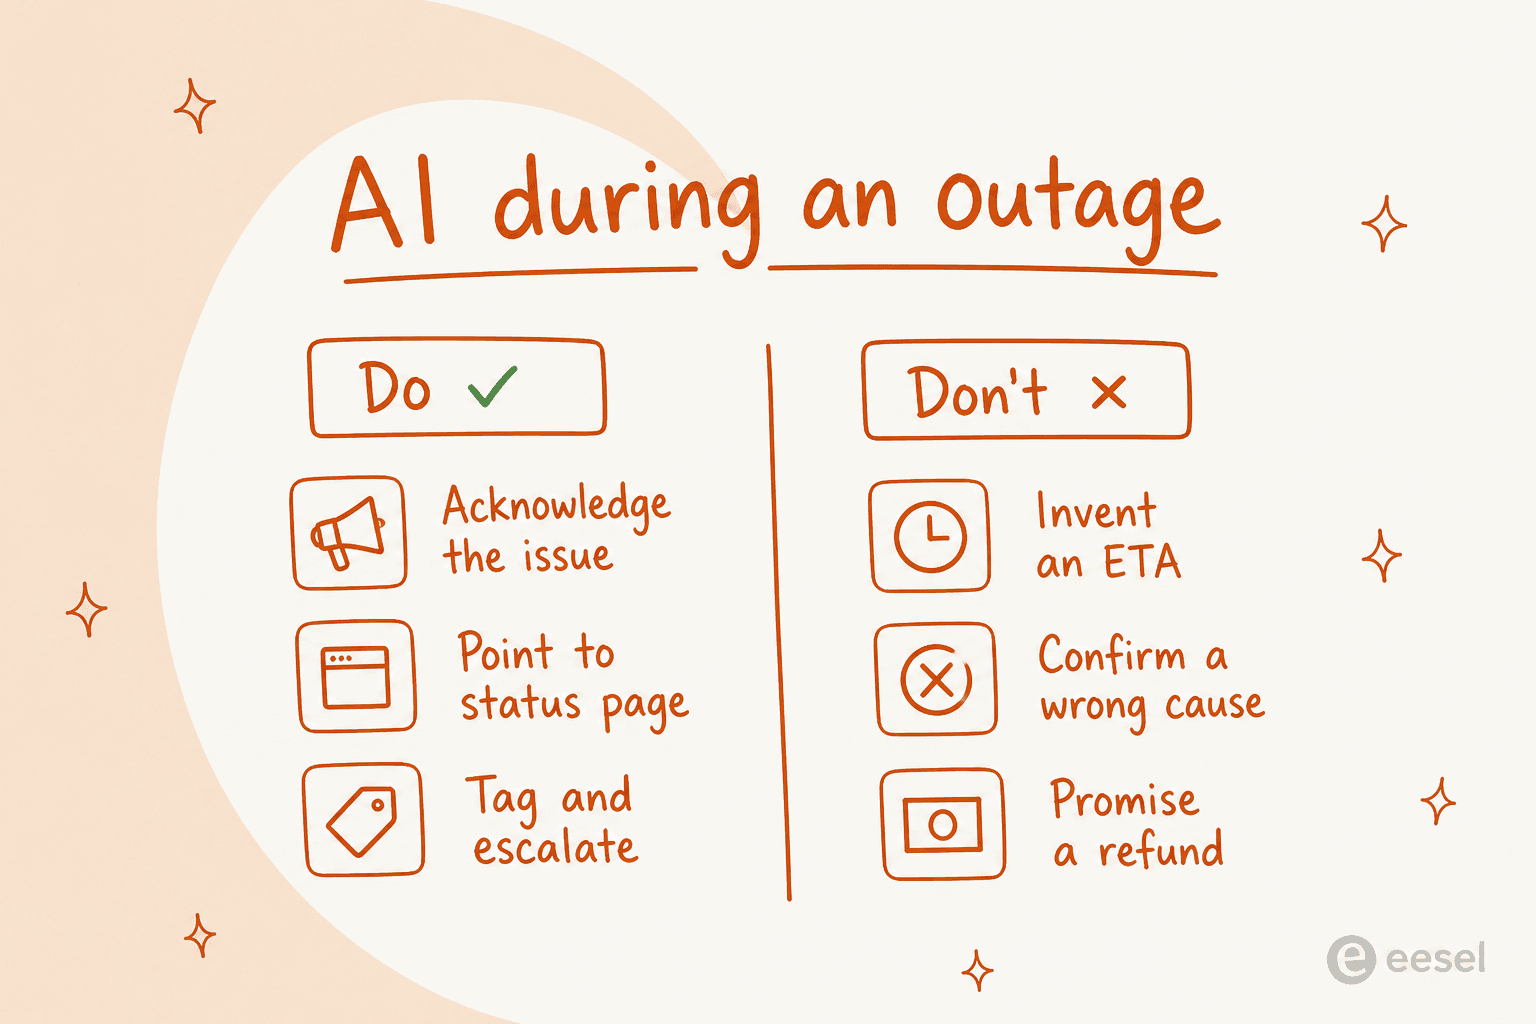
Tous les interdits sont des variantes du même péché : deviner. Une heure de rétablissement inventée devient une promesse que vous rompez. Une cause confirmée qui s'avère fausse est une correction publique que vous devez désormais. Un remboursement proposé par un bot, c'est de l'argent et un précédent que vous n'avez pas autorisés. Rien de tout cela n'est hypothétique, c'est ce qui arrive quand l'automatisation est trop largement définie et qu'on lui dit d'« être utile » sans limites.
On l'évite par le contrôle, pas par l'espoir. Une responsable CX, que je garderai anonyme, à la tête d'une marque de compléments alimentaires DTC, a formulé le principe mieux que je ne saurais le faire :
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est le réglage qui rend l'IA sûre pendant un incident : elle fait le travail répétitif dont elle est sûre, et elle a la discipline de ne pas toucher à tout le reste. Le cadrage par niveau de confiance n'est pas un plus ici, c'est la différence entre une IA qui raccourcit la panne et une IA qui l'allonge.
Essayez eesel pour votre prochain incident
Si vous voulez un coéquipier IA de helpdesk qui s'installe dans votre file existante, absorbe le flot d'incidents connus et escalade proprement dès qu'un ticket paraît inhabituel, c'est ce pour quoi eesel est conçu. Il s'entraîne sur vos tickets passés et votre centre d'aide pour que ses réponses de panne se lisent comme si votre équipe les avait écrites, il limite l'automatisation par type de ticket et niveau de confiance pour ne jamais deviner sur les tickets qui comptent, et il simule sur votre historique réel pour que vous puissiez répéter un incident avant d'en vivre un.

Et comme il est tarifé en crédits plutôt que par siège, vous pouvez le dimensionner pour un pic sans staffer pour la pire heure du pire jour. Vous pouvez connecter votre helpdesk, le pointer vers vos connaissances et démarrer gratuitement avec 100 crédits, sans carte bancaire ni appel commercial. La prochaine panne arrive que vous soyez prêt ou non, alors le geste utile est d'avoir votre mode incident construit et simulé avant qu'elle ne survienne.
Comment le support client IA gère-t-il une panne SaaS ?