O que as pessoas realmente querem quando dizem "gerenciar agentes de IA pelo terminal"
Eu desenvolvo as integrações e as APIs na eesel, então essa frase de busca é bem próxima da minha realidade. Quando alguém a digita, quase nunca está pedindo um prompt de chat no shell dela. É um engenheiro de plataforma, um líder de operações ou um founding engineer que já roda tudo o mais pela linha de comando, e que acabou de receber um agente de suporte com IA que vive inteiramente atrás de um painel web. Parece errado, do mesmo jeito que parece errado um servidor que só pode ser configurado clicando em botões.
O instinto está certo, e vários engenheiros já disseram isso de forma mais contundente do que eu diria:
"Devs spent decades building CI/CD, monitoring, rollbacks, and circuit breakers because deploying software and hoping it works was never acceptable. Then they built AI agents and somehow went back to hoping."

Essa é a coceira por trás da busca. Tudo o mais em um stack moderno é código que você pode versionar, revisar, fazer deploy e reverter. Aí o agente de IA aparece como uma página de configurações onde alguém alterna comportamentos em um navegador, sem trilha de auditoria e sem forma de testar uma mudança antes que clientes reais a encontrem. O terminal, aqui, é um atalho para toda uma disciplina: se é um sistema de produção, deveria ser operável como um.
Então a pergunta real não é "existe uma CLI". É "posso tratar esse agente do jeito que trato o resto da minha infraestrutura?". Isso reformula tudo, e é o enquadramento que vale a pena manter pelo resto deste post.
A mudança: um agente é um serviço que você opera, não um bot que você configura
A maior parte do conteúdo sobre agentes de suporte com IA para na configuração inicial. Conecte sua central de ajuda, escolha um tom, ative. Mas a configuração é o dia um. O trabalho que realmente importa é o dia dois e cada dia depois: a configuração vai se desviando, um artigo da base de conhecimento fica desatualizado, um produto novo é lançado e o agente começa a responder errado com toda a confiança. Gerenciar um agente é um loop, não um lançamento.
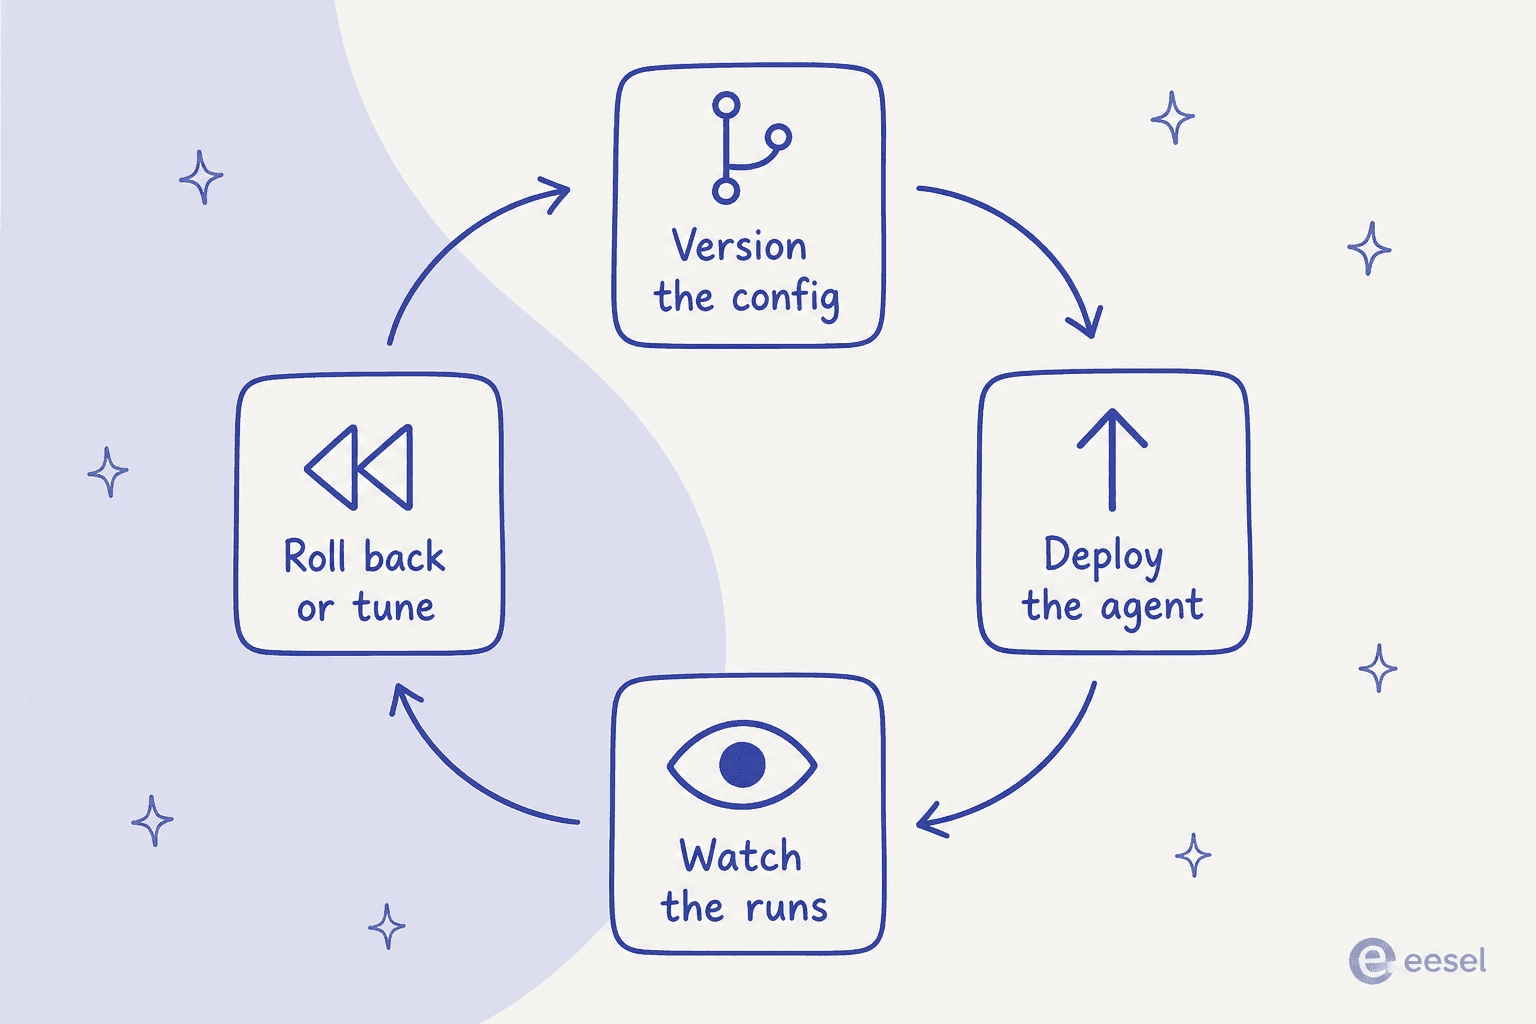
Esse loop é exatamente para o que o "ops-as-code" dá um lugar. Versione a configuração para que uma mudança seja um diff que alguém possa revisar. Faça deploy por um pipeline para que um rollout seja repetível. Acompanhe as execuções para saber o que o agente realmente fez. Reverta ou ajuste quando algo estiver errado. Nada disso é exótico; é assim que você operaria qualquer serviço. A única razão de isso parecer novidade para um agente de IA é que muitas ferramentas foram construídas primeiro como painéis e nunca desenvolveram uma superfície programável. Um time construindo um framework de agents-as-code colocou o objetivo de forma clara:
"Orloj treats agents the way infrastructure-as-code treats cloud resources. You write a manifest that declares an agent's model, tools, permissions, and execution limits."

Depois que você absorve esse enquadramento, o terminal deixa de ser o objetivo e passa a ser a interface para o objetivo. Você quer que o comportamento do agente seja algo em que você possa rodar diff, não algo que você precisa lembrar que mudou na terça passada.
O que você realmente consegue programar hoje
Aqui está a parte prática. Se sua ferramenta expõe uma API ou uma CLI, uma quantidade surpreendente de gerenciamento de agente já funciona a partir de um shell. O padrão universal, seja qual for o fornecedor, é o mesmo que você usaria para qualquer serviço: o arquivo de configuração é a fonte da verdade, a API é o alvo do deploy, e o controle de versão é o log de auditoria. Na forma crua, é só curl e jq, por exemplo para puxar o último dia de execuções e contar escalonamentos:
curl -s https://api.yourtool.com/v1/agent/runs \
  -H "Authorization: Bearer $AGENT_TOKEN" \
  --data-urlencode "since=$(date -u -v-1d +%FT%TZ)" \
| jq '[.runs[] | select(.outcome == "escalated")] | length'
Algumas ferramentas pulam a etapa de REST puro e te dão uma CLI de primeira classe. A eesel é uma delas: sua ferramenta de linha de comando é um binário npm de verdade (@eesel/cli), e a documentação é direta ao dizer que o terminal é a interface pretendida, não uma porta lateral: tudo no site "pode ser feito pelo terminal". Uma sessão típica se parece com isto:
eesel login                 # browser once, or set EESEL_API_TOKEN for CI
eesel status                # what's connected, is knowledge current, plan
eesel activity              # every run, newest first (JSON by default)
eesel instructions          # read or edit the agent's standing rules
eesel approvals list        # actions held, waiting on a human
Todo comando imprime JSON, os erros voltam como uma linha estruturada no stderr, e definir EESEL_API_TOKEN (mais EESEL_AGENT_ID) permite que tudo rode headless no CI, sem login por navegador. Coloque qualquer parte disso atrás de um cron job ou uma GitHub Action e você tem gerenciamento de agente agendado, revisável e versionado, sem precisar de painel.
O pega é o tamanho desse "se". Muitas IAs de suporte vêm sem uma API que mereça esse nome, então o teto do que você pode programar é definido inteiramente pelo fornecedor. Essa é a coisa mais importante a verificar antes de comprar: uma ferramenta sem superfície programável nunca poderá ser gerenciada pelo terminal, por mais que você queira. Vale a pena percorrer o espectro de gerenciabilidade antes de se comprometer.
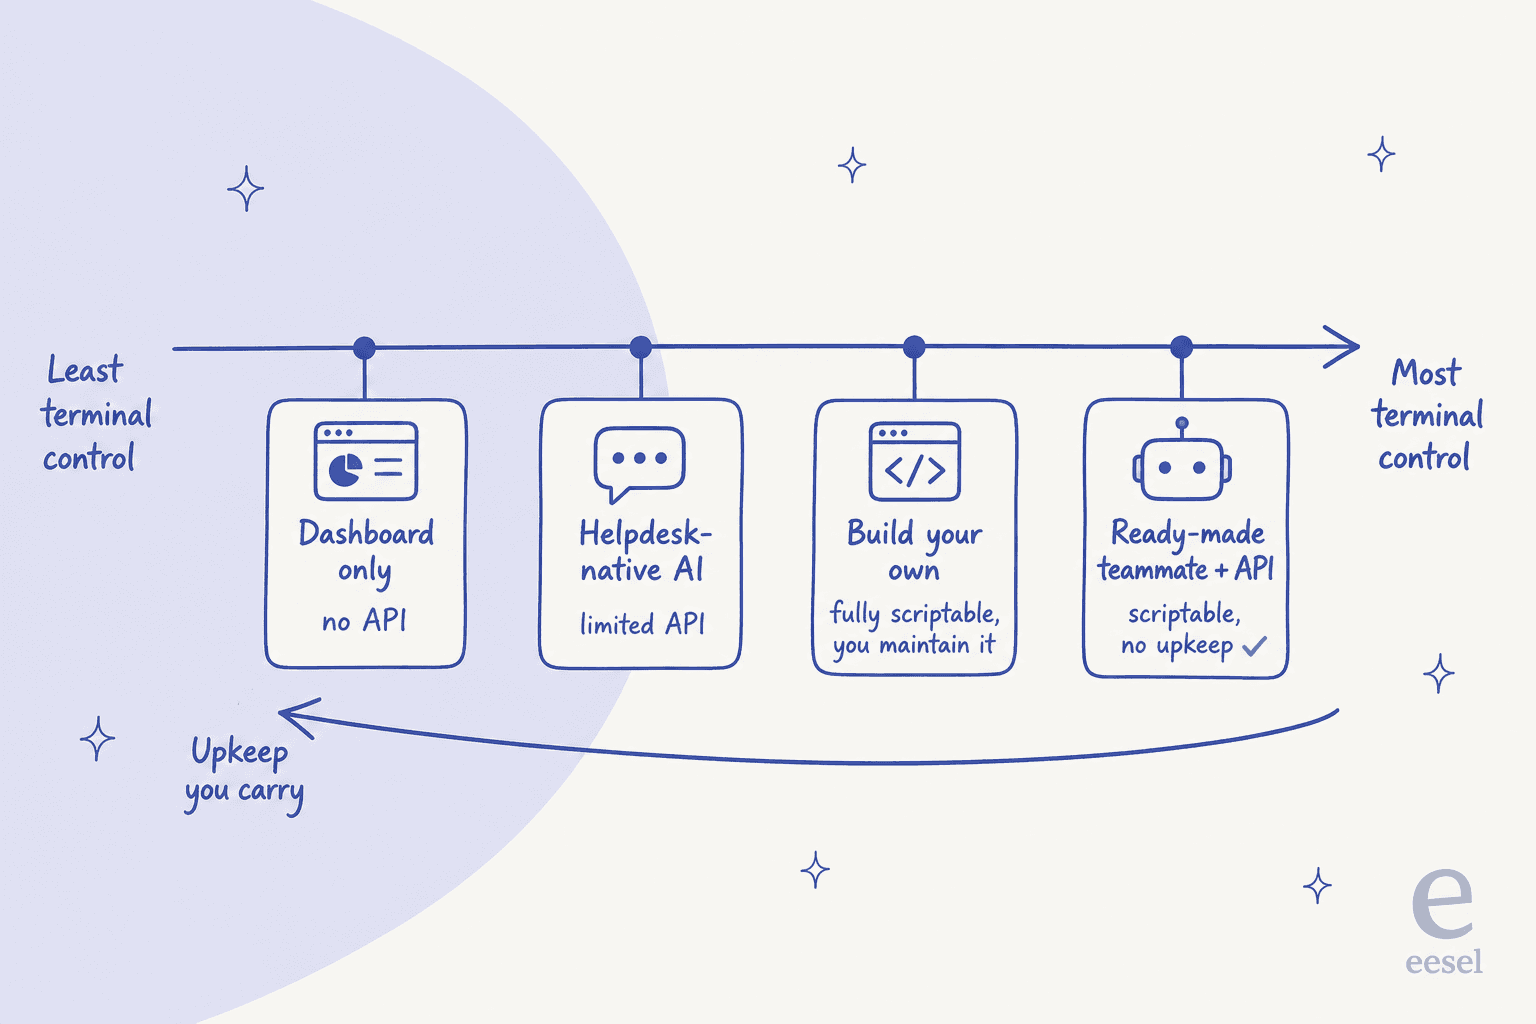
Há um trade-off real ao longo dessa linha. Construir seu próprio agente sobre uma API de modelo te dá controle total e manutenção total: você é dono da recuperação, das guardrails, do arcabouço de avaliação e de todo aviso às 2 da manhã quando uma regressão de prompt é enviada. Um agente pronto com uma API adequada te dá a maior parte da programabilidade sem a cauda de manutenção. Qual extremo você quer depende de gerenciar o agente ser o seu trabalho ou um imposto sobre o seu trabalho de verdade. (Se você está pesando o lado de construir, nós aprofundamos isso em nossos artigos sobre API de agente de suporte ao cliente e API de helpdesk com IA.)
A metade que o terminal não te dá: ver o que o agente fez
Aqui está a armadilha. Fazer deploy pela linha de comando é a metade fácil, e ela te faz achar que você está no controle. Seu script roda, a API retorna 200, seu terminal imprime exit 0, e você segue em frente. Mas um código de saída limpo te diz que a mudança foi enviada. Não te diz nada sobre se o agente está fazendo a coisa certa.
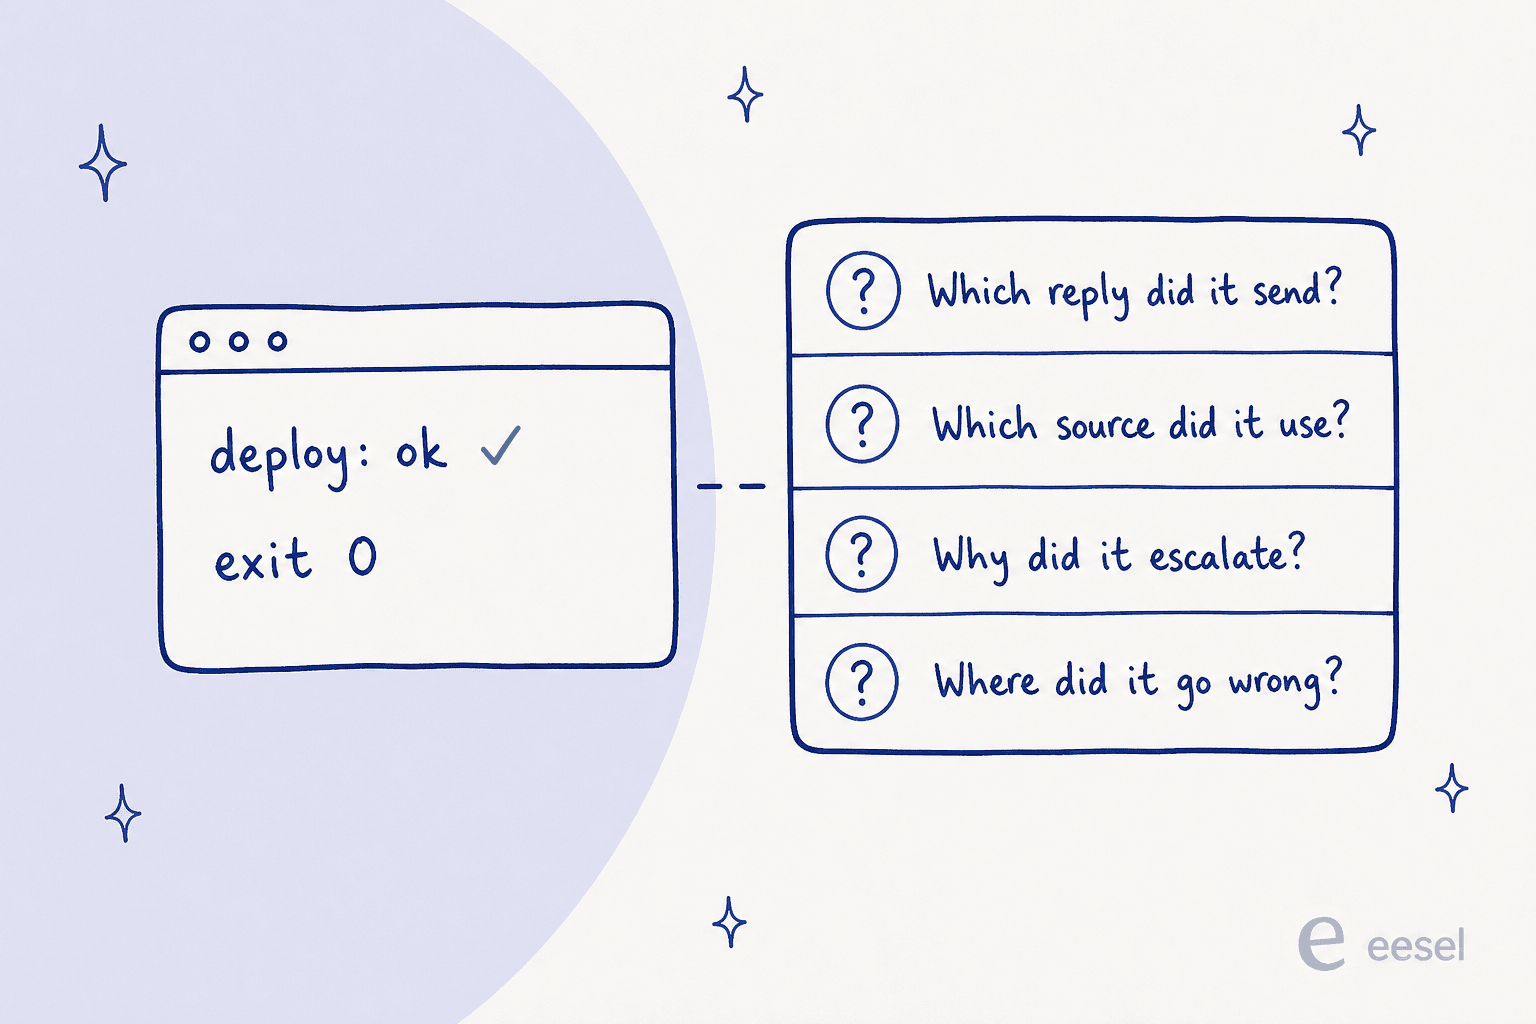
É aqui que muitos projetos de agentes caseiros silenciosamente desmoronam. Você pode automatizar o deploy em uma tarde; não pode automatizar a necessidade de saber qual resposta foi para qual cliente, em qual fonte de conhecimento o agente se apoiou, e por que ele decidiu escalar um ticket e responder outro. O relato de um engenheiro sobre seis meses de falhas em produção resumiu bem o padrão de falha:
"Agent works in testing. Works in the demo. Ships to production. Two weeks later - same input, different output. No error. No log that helps. Just a wrong answer delivered confidently."
Isso é observabilidade, e é a parte cara de construir e a parte fácil de pular. É também por isso que o sentimento nos fóruns de desenvolvedores mudou silenciosamente de "qual modelo" para "consigo ver o que ele fez":
"honestly I'm starting to think observability is becoming more important than the model itself"
A lição que continuamos reaprendendo: um terminal só é tão útil quanto o histórico de execuções por trás da ferramenta que ele está controlando. Se o agente consegue fazer deploy mas não consegue te mostrar o trabalho dele, você automatizou a parte que nunca foi o problema. Ao avaliar uma ferramenta, cobre tanto do lado de leitura quanto do lado de escrita. Você consegue puxar a transcrição completa de uma execução? Consegue ver a confiança e as fontes por trás de uma resposta? Consegue ser alertado quando algo se desvia? Um painel que mostra isso lindamente mas não expõe nada disso a um script ainda é uma caixa-preta para a sua automação.
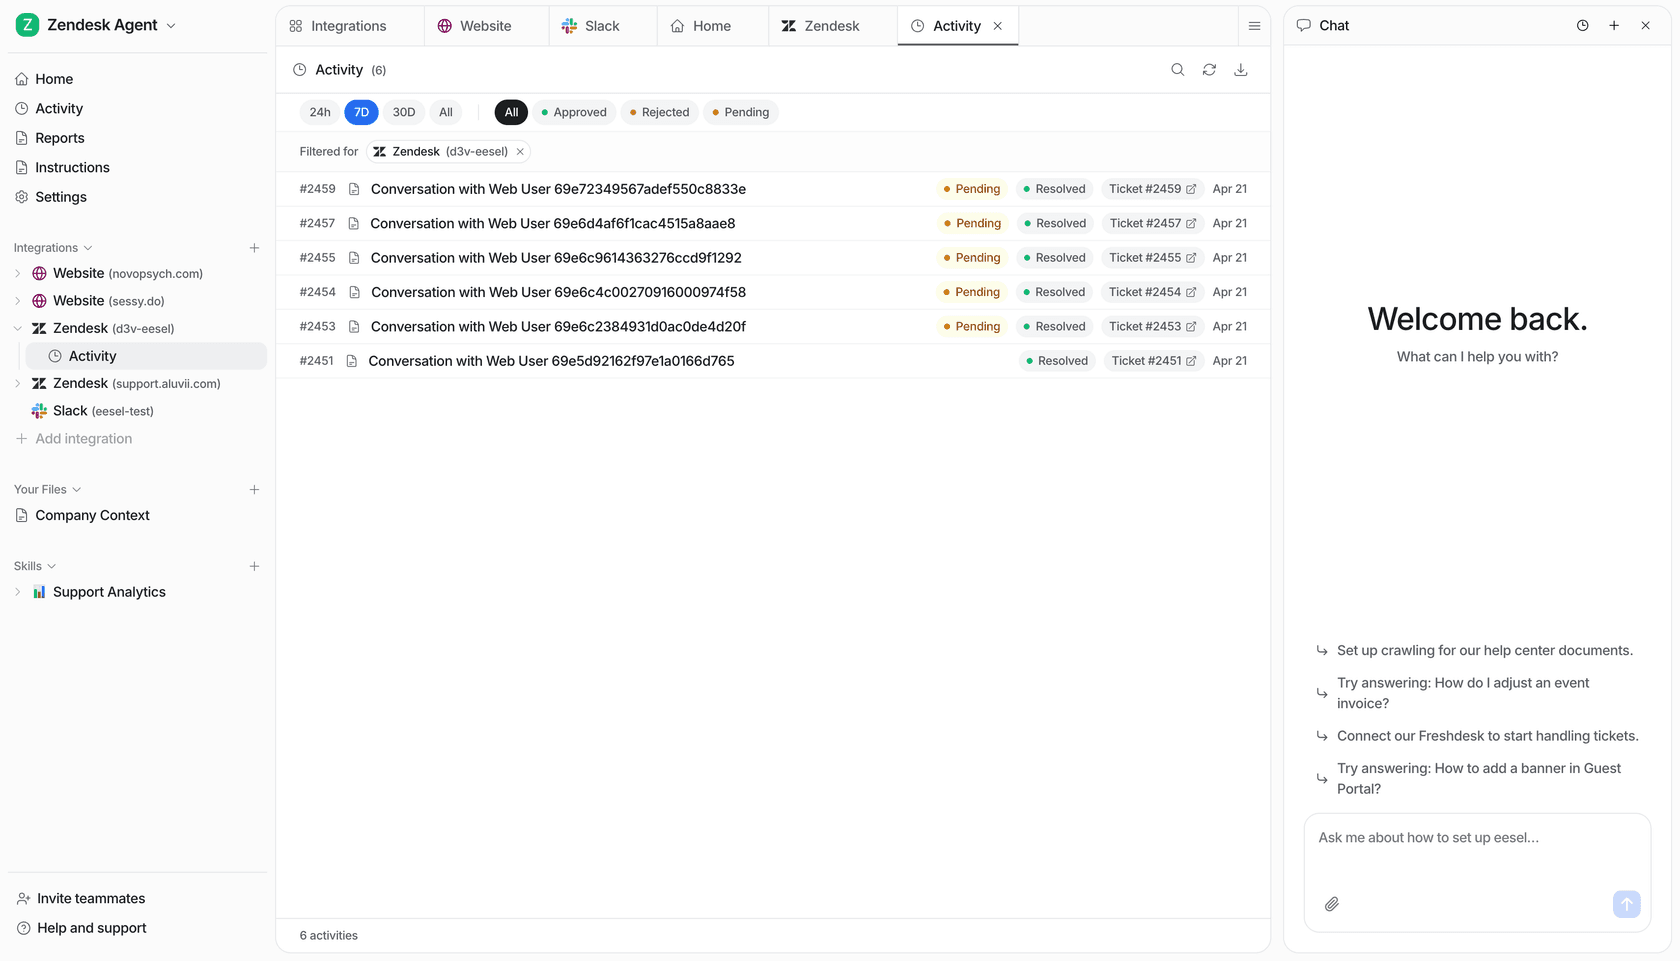
Essa é a parte da qual tenho mais orgulho no nosso lado: eesel activity lista cada execução da mais recente para a mais antiga e permite ler uma em detalhe completo, e como é o mesmo JSON que o painel mostra, uma resposta nunca é algo que simplesmente aconteceu em algum lugar que você não pode ver. Combine com eesel approvals, e um humano pode segurar, aprovar ou negar uma ação na fila sem nunca sair do shell.
Teste antes de fazer deploy: o ambiente de staging para agentes
Se você levar um hábito de operar serviços e aplicá-lo a agentes, que seja este: nunca envie uma mudança de configuração direto para os clientes. No software normal você tem um ambiente de staging. Para um agente de IA, o equivalente é reproduzir seus próprios tickets antigos contra a nova configuração e verificar o que teria acontecido, antes de um único cliente real vê-lo. Um desenvolvedor que passou por esse ciclo descreveu a solução como testes de snapshot:
"What finally fixed the cycle for me was treating agent behavior like snapshot tests. Record the trajectory when it's working, save it as baseline, diff after every change. If the tool path shifted or output drifted - block the deploy before it hits prod."
O motivo de isso importar não é teórico. No τ-bench, o benchmark de agentes com ferramentas da equipe de pesquisa da Sierra, o melhor agente marcou menos de 50% em tarefas de suporte realistas, e um agente GPT-4o que atingiu sua pontuação pass^1 caiu para cerca de 25% no pass^8, um colapso de confiabilidade de ~60% só de rodar a mesma tarefa oito vezes. A precisão de manchete não é o número assustador. A inconsistência entre execuções é, e a única forma de pegar isso antes dos seus clientes é rodar a nova configuração contra a realidade primeiro.
Aprendemos a mesma coisa da forma difícil ao longo de mais de três anos colocando IA em filas de suporte reais. Já vimos um bot de voz confiante entregar respostas erradas silenciosamente, e é por isso que todo rollout agora é simulado contra tickets históricos primeiro. Essa simulação é sua suíte de regressão. No nível do comando, uma flag --dry-run faz a versão pequena da mesma ideia: imprime a chamada exata que uma escrita faria sem enviá-la, para você ver o que uma mudança faz antes que ela faça.
Esse também é o limite honesto do que dá para programar. Você pode automatizar a repetição. Pode condicionar o deploy ao resultado. O que você não pode programar é o julgamento sobre se uma queda de 4 pontos em uma categoria de tickets é aceitável pelo ganho de 10 pontos em outra. O terminal torna o teste barato e repetível; uma pessoa ainda lê o resultado. Como já ouvi falar internamente: você pode programar o ticket, mas não pode programar a resposta.
Quanto custa rodar, e onde a conta se esconde
Rodar um agente tem um medidor, e esse medidor é onde "gerenciar pelo terminal" silenciosamente vira uma questão de orçamento. A unidade importa mais que o número, porque as unidades não são iguais. Algumas ferramentas cobram por resolução, algumas por conversa, algumas por token de API, e um script que dispara milhares de chamadas de API por dia para checar execuções pode gerar uma conta surpreendente se você é cobrado por chamada.
A versão honesta de uma tabela de custos para um agente de suporte se parece com isto:
| Abordagem | O que você programa | Quem mantém | Modelo de custo aproximado |
|---|---|---|---|
| Ferramenta só com painel | Nada, sem API | Fornecedor | Por resolução ou por assento |
| IA nativa de helpdesk | Configuração limitada via a API do helpdesk | Fornecedor | Por resolução (geralmente US$ 1,50 a US$ 2,00) |
| Construir a sua própria em uma API de modelo | Tudo | Você | Por token, em cada mensagem e retry |
| Agente pronto com CLI (eesel) | Configuração, execuções, ações | Fornecedor | US$ 0,40 por ticket atendido |
As duas pontas são as interessantes. Construir a sua própria te dá uma conta por token que é cobrada resolva-se o ticket ou não, mais o custo salarial da pessoa que mantém a recuperação e as guardrails. Um modelo por ticket como o da eesel é fixo por conversa atendida não importa quantas mensagens leve, sem taxa por assento ou por plataforma, o que torna o gasto previsível o bastante para realmente colocar em um script e em um orçamento. Em 1.000 tickets por mês isso dá cerca de US$ 400, e você só paga pelos tickets que encaminha para o agente, não pelos que seus humanos ainda atendem.
Experimente a eesel para um agente de suporte que você realmente consegue operar
Se todo o motivo pelo qual você buscou isso é que você quer rodar um agente de suporte como um serviço em vez de ficar babá de um painel, essa é a lacuna para a qual a eesel foi construída. É um colega de equipe com IA que entra no seu helpdesk atual (Zendesk, Freshdesk, Front, Gorgias, Help Scout e outros), treina nos seus tickets e documentos antigos, e te dá uma superfície programável genuína: uma CLI, um servidor MCP por workspace, webhooks e Network Access de saída para que o agente possa chamar seus próprios sistemas.
Você pode instalá-lo e operá-lo inteiramente a partir de um shell:
npx @eesel/cli init chat-bubble --site https://your-site.com
eesel chat "what's our refund policy?"   # test an answer before go-live
eesel activity                            # watch what it actually did
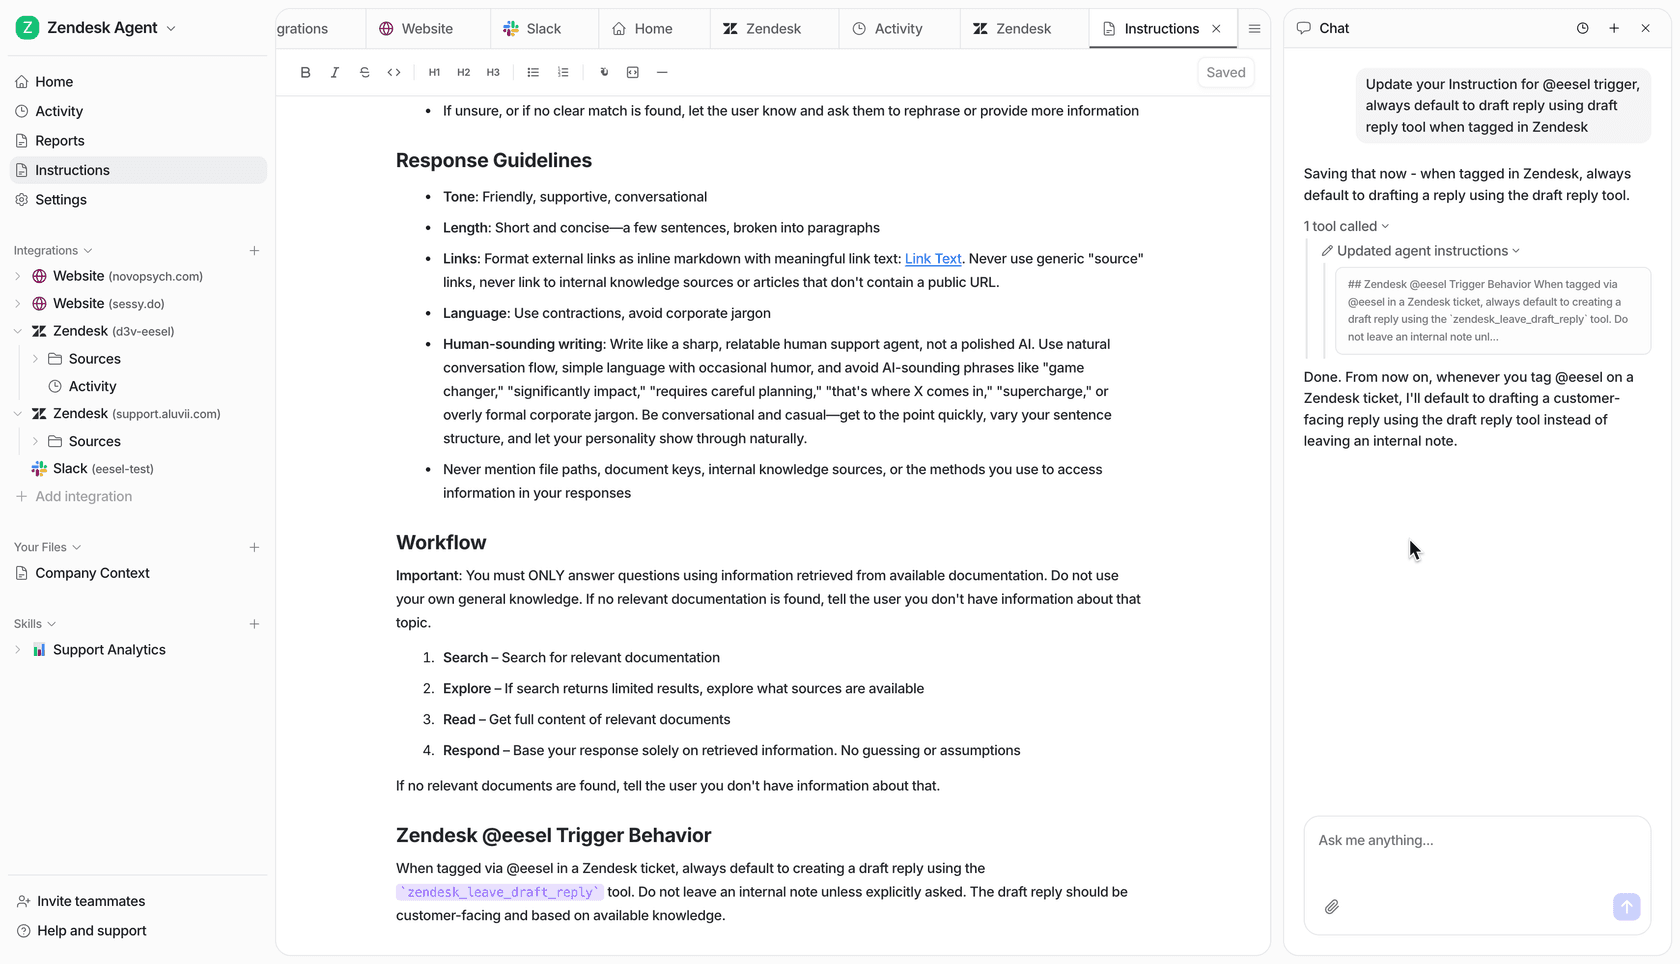
Os dois hábitos deste post que mais importam já vêm integrados: você simula contra seus tickets históricos antes do go-live, e faz o rollout aos poucos, mantendo cada resposta como rascunho até que ela ganhe o direito de enviar sozinha. E como custa US$ 0,40 por ticket sem taxa por assento, você pode começar com alguns tipos de ticket e escalar a partir de um script em vez de uma ligação de vendas.
Você pode começar de graça sem cartão de crédito, conectá-lo ao seu helpdesk em poucos minutos, e ver como ele lida com seus tickets reais antes de se comprometer com qualquer coisa. Esse é o ponto: um agente que você pode testar, observar e operar, não um em que você precisa confiar cegamente.
Perguntas frequentes
É possível realmente gerenciar agentes de IA pelo terminal?
O que significa 'ops-as-code' para um agente de suporte com IA?
Como faço deploy de mudanças em um agente de IA pela linha de comando?
Quanto custa rodar um agente de suporte com IA?
O que acontece se um agente de IA der uma resposta errada em produção?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.