

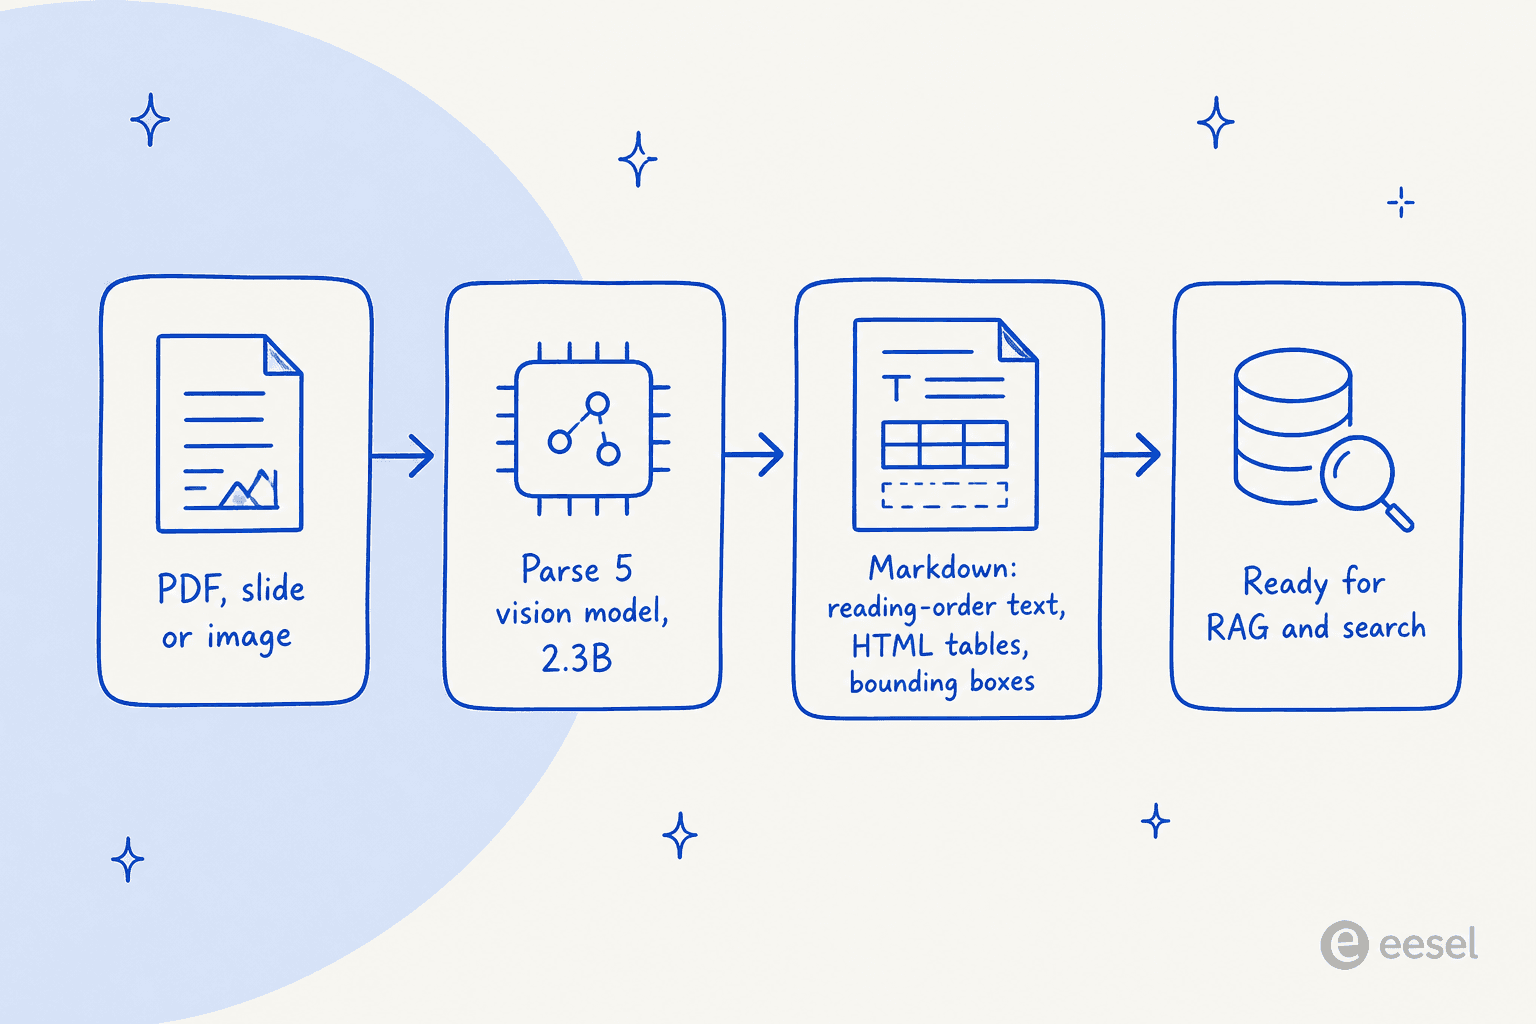
O Cohere Parse 5 (id do modelo parse-v5.0) é um modelo de visão pequeno, de 2,3 bilhões de parâmetros, que lê uma página de documento e devolve Markdown limpo: texto na ordem de leitura, tabelas em HTML e caixas delimitadoras para elementos visuais. Ele ficou disponível para o público geral em 27 de agosto de 2026.
O ponto principal: ele não tenta ser o analisador mais preciso. No ParseBench da própria Cohere, marca 79.2, atrás do GPT-5.5 (84.4), do Opus 4.8 (84.3) e do Gemini 3.5 Flash (81.8). Onde ele ganha é no preço. A $1.50 per 1,000 pages (ainda mais barato se você o hospedar por conta própria no Model Vault), ele fica no canto de "alta qualidade, baixo custo" que os grandes modelos de fronteira não alcançam. Se você analisa centenas de milhares a milhões de páginas, esse equilíbrio é todo o argumento.
O Parse é uma peça de infraestrutura, não um produto pronto. Ele entrega Markdown; você ainda precisa gerar embeddings, indexar, recuperar e construir algo que responda perguntas. Se o que você quer de fato é uma IA que leia seu conhecimento de suporte e resolva tickets, não precisa montar esse pipeline sozinho, e é aí que uma ferramenta como a eesel entra.
O que o Cohere Parse 5 realmente é
A Cohere é a empresa de IA corporativa conhecida pelos modelos de linguagem Command, pelos modelos de busca Embed e Rerank e por um forte foco em implantação privada e soberana. O Parse é sua entrada na análise de documentos, e o Parse 5 (parse-v5.0) é a versão atual, anunciada em 27 de agosto de 2026 sob o lema "enterprise document intelligence at scale".
O trabalho dele é restrito e específico: você entrega uma página e ele devolve dados estruturados e legíveis por máquina. A Cohere o descreve como algo que vai "beyond OCR" porque ele não apenas transcreve caracteres, mas entende tabelas, formulários, diagramas e imagens incorporadas, e devolve tudo como Markdown limpo pronto para o processamento seguinte. Essa saída é o objetivo. O Markdown é o que você alimenta em um índice de busca, em um pipeline de RAG ou em um agente de IA.
Por dentro, é um modelo compacto: 2,3 bilhões de parâmetros, cerca de 4,6 GB, com contexto de 8.192 tokens, construído sobre a arquitetura north-micro-vision-instruct da Cohere. Esse tamanho pequeno é proposital. Um modelo de 2,3B é barato de executar e rápido de servir, e a Cohere apostou nas duas coisas.
Como o Parse 5 funciona
A mecânica é mais simples do que a da maioria das stacks de análise, porque o modelo faz o trabalho pesado em uma única passada. Você envia a imagem de uma página, codificada como data URI em base64, para o endpoint co.parse da API v2 da Cohere. Ele devolve Markdown por padrão, ou um array blocks se você quiser cada região de texto, tabela e imagem separada, com suas coordenadas.
Uma chamada mínima fica assim:
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": f"data:image/png;base64,{b64}"},
)

for page in response.pages:
    print(page.markdown.content)
Alguns detalhes que vale conhecer antes de construir em cima dele. A documentação lista PDF, PowerPoint e JPEG como formatos aceitos, mas o endpoint em produção hoje aceita apenas imagens, um data URI ou uma URL de imagem remota, então uploads de PDF brutos ainda não estão disponíveis. As imagens têm limite de 20 MB, 50 megapixels ou 200 MB decodificadas. E as caixas delimitadoras vêm apenas para tabelas e imagens, não para cada linha de texto, o que é uma escolha intencional: o modelo preserva a ordem de leitura no Markdown em vez de despejar uma nuvem de coordenadas que você teria de remontar.
Ele é estável em nove idiomas (árabe, inglês, francês, alemão, italiano, japonês, coreano, português e espanhol), com tratamento zero-shot de outros com precisão menor. A Cohere o treinou com documentos empresariais de finanças, seguros e ciência, o que já indica para quem ele foi feito.
A história do benchmark: perde em pontos, ganha em preço
Esta é a parte em que todo mundo se fixou. A Cohere publicou um benchmark, o ParseBench, que avalia analisadores em três aspectos: quão bem extraem tabelas, quão fielmente reproduzem o texto sem omissões ou alucinações e quão bem preservam formatação semântica, como tachado e itálico. E o gráfico da própria Cohere mostra o Parse 5 atrás de três modelos maiores.
| Modelo | Média | Tabelas | Fidelidade do conteúdo | Formatação semântica |
|---|---|---|---|---|
| GPT-5.5 | 84.4 | 89.3 | 87.5 | 76.5 |
| Opus 4.8 | 84.3 | 89.7 | 89.0 | 74.1 |
| Gemini 3.5 Flash | 81.8 | 87.6 | 84.7 | 73.2 |
| Cohere Parse 5 | 79.2 | 87.0 | 86.6 | 64.0 |
| LlamaParse (cost-effective) | 78.3 | 81.4 | 90.9 | 62.7 |
| Chandra OCR 2 (open) | 77.7 | 89.2 | 83.7 | 60.3 |
| Mistral OCR 4 | 74.5 | 73.9 | 89.5 | 60.1 |
| Databricks AI Parse | 72.4 | 83.7 | 88.3 | 45.3 |
| Azure Document Intelligence | 69.3 | 86.0 | 84.9 | 37.0 |
| Google Document AI | 57.3 | 55.1 | 83.7 | 33.0 |
| AWS Textract | 53.3 | 82.3 | 74.8 | 2.8 |
Publicar um benchmark que você não lidera é incomum, e é a atitude honesta. O Parse 5 é forte em tabelas e fidelidade do conteúdo (87.0 e 86.6, perto dos modelos de fronteira) e mais fraco em formatação semântica (64.0). Ele supera os analisadores especializados, com o que a Cohere chama de "over 20-point improvement" sobre o AWS Textract e o Google Document AI. Só não é a ferramenta mais afiada em precisão bruta.
O argumento está no segundo gráfico. Ao traçar a pontuação contra o preço, o Parse 5 vai para o canto que ninguém mais ocupa.
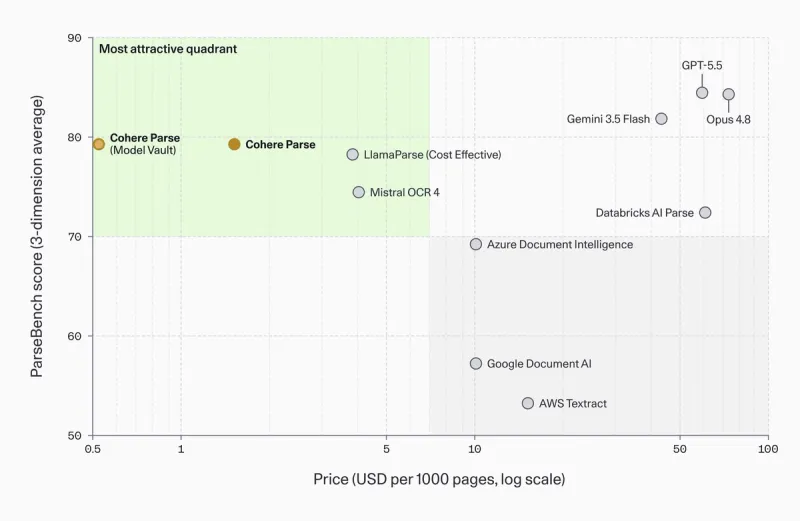
O GPT-5.5 e o Opus 4.8 marcam de três a cinco pontos a mais, mas ficam bem à direita, com cerca de 40 a 50 vezes o custo por página. Para uma revisão de contrato pontual, pague pela precisão. Para um pipeline de ingestão que processa um milhão de faturas por mês, cinco pontos de fidelidade de formatação não valem uma conta 40 vezes maior. Essa é a aposta do Parse 5, e para processamento de documentos em alto volume ela é razoável.
O jornalista de tecnologia corporativa Sean Kerner resumiu o clima em torno do lançamento:
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Esse ceticismo é justo. A análise de documentos não está "resolvida", e o Parse 5 não afirma resolvê-la. Ele promete reduzir bastante o custo de fazê-la em escala, uma promessa mais estreita e mais defensável.
Vazão e hospedagem própria
A outra metade da história do preço é a velocidade. Em uma única GPU H100, o Parse 5 processa 4,5 páginas por segundo, o que dá 36 páginas por segundo (cerca de 2.160 por minuto) em um nó com 8 GPUs. A Cohere o comparou com analisadores de código aberto servidos da mesma forma, no vLLM, e ele sai na frente.
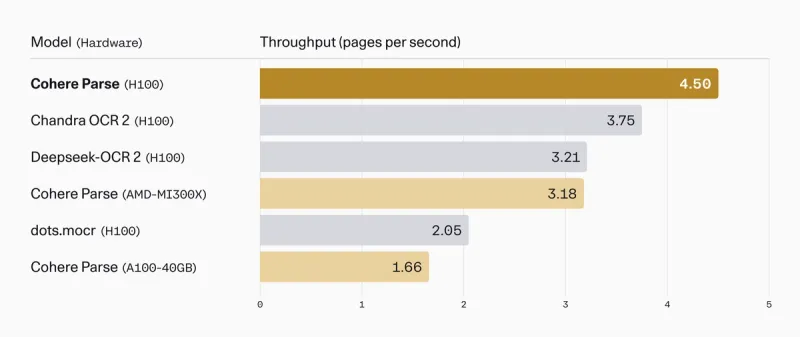
Alta vazão em um modelo pequeno é o que faz a conta fechar na hospedagem própria. E a hospedagem própria é justamente o ângulo da Cohere. Além da API padrão, o Parse 5 roda como instância dedicada do Model Vault, no Microsoft Foundry, no Amazon SageMaker ou de forma totalmente privada e isolada da rede, o que importa se você analisa documentos que legalmente não pode enviar a uma API de terceiros. Há também um Space de demonstração gratuito no Hugging Face, se você só quiser testar uma página.
Preços do Cohere Parse 5
O Parse 5 tem dois modelos de preço, e qual serve para você depende inteiramente do volume.
| Opção | Preço | Observações |
|---|---|---|
| API da Cohere | $1.50 / 1,000 pages | Pagamento por página. Limite de 500 requisições/minuto. A chave de teste gratuita permite 1.000 chamadas/mês. |
| Model Vault, instância Medium | $4.00 / hour ($2,500 / month) | Instância dedicada de locatário único. |
| Model Vault, instância XL | $7.00 / hour ($4,300 / month) | Instância dedicada de maior vazão. |
O preço por página é a manchete, e a $1.50 per 1,000 pages ele é de fato uma das opções hospedadas mais baratas. As instâncias dedicadas são onde a economia se acumula. A conta da Cohere: com 50% de utilização da GPU, o Model Vault sai 23% mais barato por página que a API, e com utilização total a diferença cresce para 61%.
O exemplo prático deles deixa isso concreto. Um fluxo de contas a pagar que processa cerca de 13 milhões de páginas por mês no Model Vault em vez da API economiza aproximadamente US$ 12.000 por mês, ou US$ 144.000 por ano. Comparado a um analisador de hiperescala de US$ 10 por 1.000 páginas, esse único fluxo economiza cerca de US$ 1,47 milhão por ano. São números da Cohere com premissas da Cohere, então trate-os como o melhor cenário, mas a direção é real: em alto volume, o custo de análise por página sobe rápido, e um modelo mais barato é uma grande alavanca.
O que ele não faz
Ser honesto sobre os limites é o que torna o argumento de preço confiável, então aqui estão eles. O Parse 5 gera apenas Markdown, não JSON estruturado, então se você precisa de um esquema rígido terá de analisar o Markdown depois. Ele não devolve pontuações de confiança, então você não consegue sinalizar automaticamente extrações de baixa certeza para revisão humana. E não classifica elementos do documento como cabeçalhos, rodapés ou hierarquia de fontes. Nenhum desses pontos é impeditivo para um trabalho de ingestão em massa, mas cada um é uma lacuna se você esperava encaixá-lo em um fluxo que exige indicadores de certeza ou um formato de saída rígido.
Onde o Parse 5 se encaixa (e onde não)
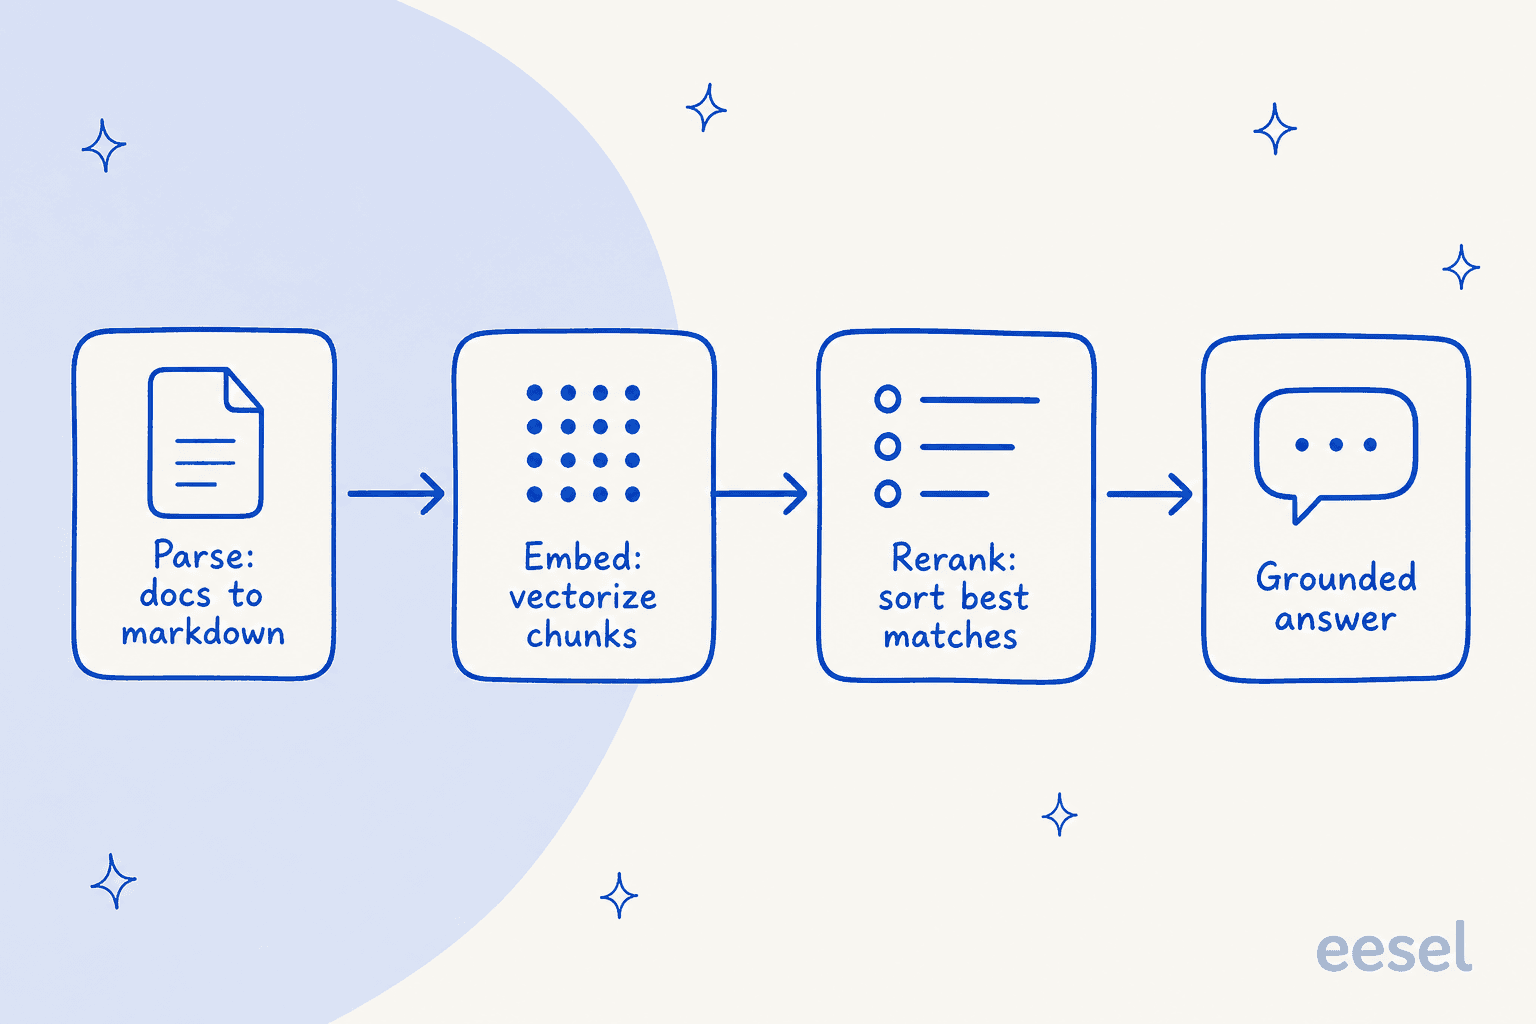
Esta é a parte que confunde as pessoas, então vale ser claro. O Parse 5 é uma camada de análise. Ele transforma páginas em texto. Sozinho, não responde a uma única pergunta. Para ir de "documentos" a "uma IA que ajuda alguém", você o encadeia em uma stack de recuperação: analisa os documentos, gera embeddings dos trechos como vetores, reordena as correspondências e entrega as melhores passagens a um modelo para gerar uma resposta fundamentada. A Cohere vende as três peças, reunidas na plataforma Compass.
É um ótimo conjunto de ferramentas se você é uma equipe de plataforma construindo inteligência documental sob medida e quer o máximo de controle sobre cada etapa. É muita montagem se seu objetivo real é algo mais cotidiano, como uma IA que leia sua central de ajuda e tickets anteriores e resolva as dúvidas dos clientes. Nesse caso você nem está procurando um analisador, está procurando o profissional pronto, e construir por conta própria o pipeline de análise, embedding, reordenação e geração é um desvio.
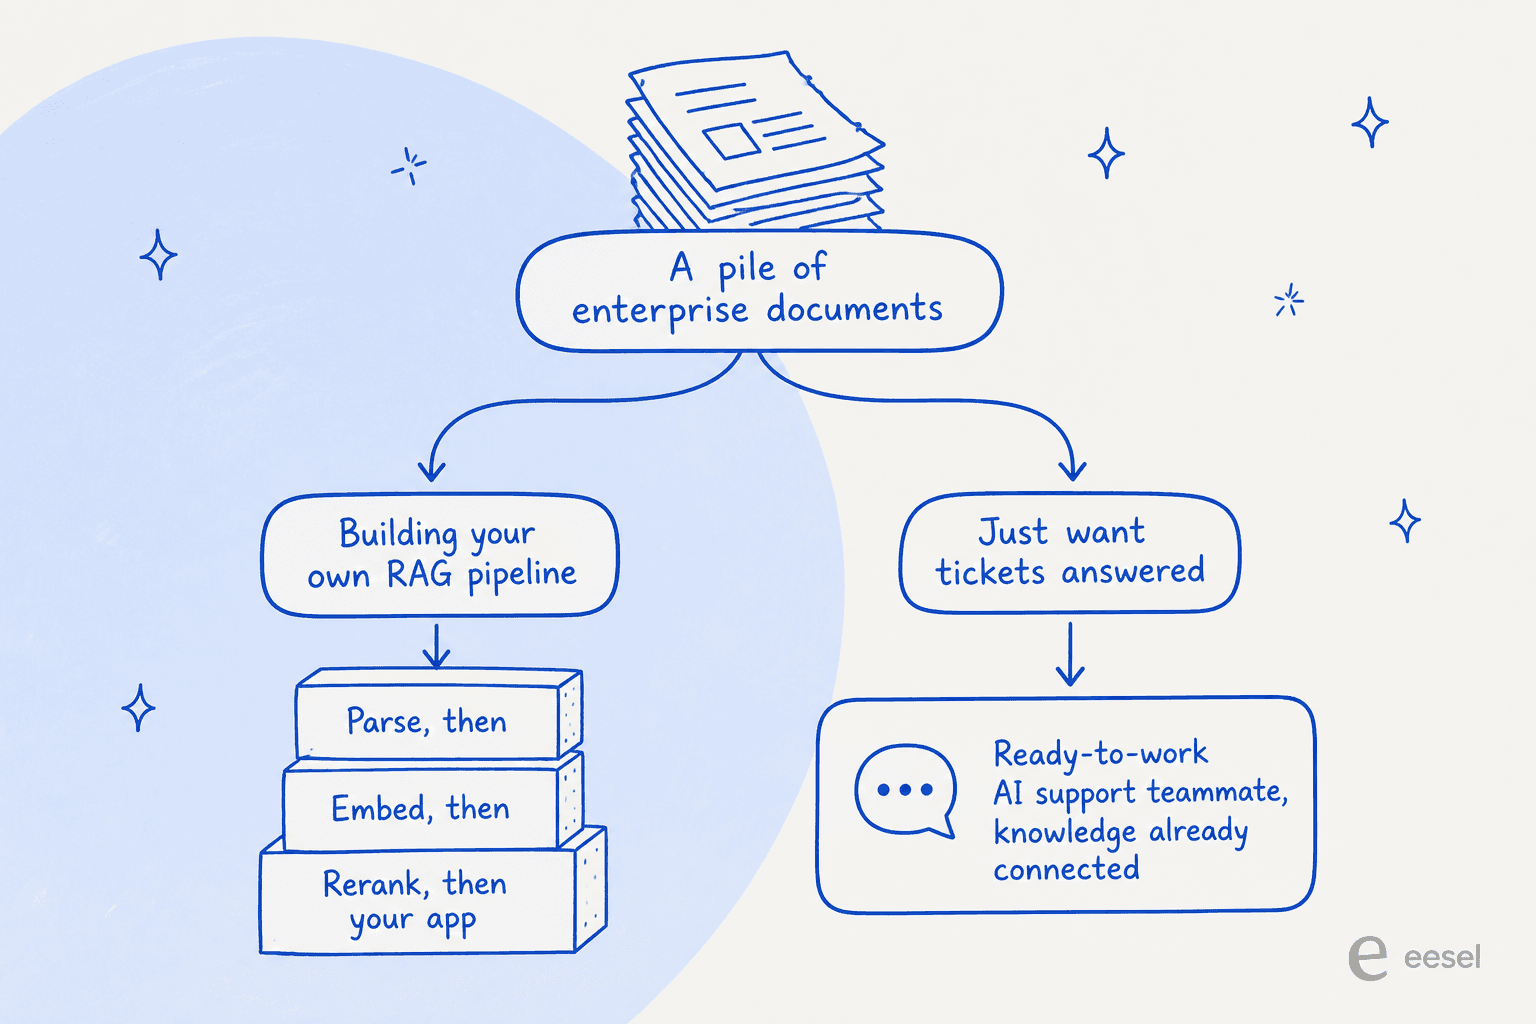
A distinção é a mesma que separa o motor de um carro do carro. O Parse 5 é um motor muito bom e muito barato. Se você quer construir o resto do carro em volta dele é a pergunta de verdade.
Experimente a eesel para um suporte que simplesmente responde
Se o seu interesse em um modelo de análise vem de um problema de suporte, essa lacuna entre motor e carro é exatamente a que a eesel fecha. A eesel é uma plataforma de colegas de IA, e seu colega de IA para helpdesk é uma versão pronta para trabalhar de toda a stack: ele se conecta diretamente à sua central de ajuda, Confluence, Google Docs e tickets anteriores, aprende com eles e resolve tickets dentro do Zendesk, do Freshdesk, do Gorgias, do Slack ou de um link de chat compartilhável. Sem pipeline de análise para montar, sem banco de dados vetorial para operar.

O que é mais difícil de fingir é a confiança para ligá-lo. Há anos rodamos IA em filas de suporte reais e vimos um bot de tom confiante dar respostas erradas sem alarde, por isso a eesel simula cada implantação com seus tickets históricos antes de tocar em um cliente de verdade, para que você veja a taxa de resolução e as respostas exatas que ele teria enviado. O Parse 5 pode ser uma peça de como uma equipe como a nossa movimenta documentos. Ele não é o colega. Você pode experimentar a eesel de graça.
Perguntas frequentes
O que é o Cohere Parse 5?
parse-v5.0) é um modelo de linguagem e visão de 2,3 bilhões de parâmetros que transforma páginas de documentos em Markdown limpo, com tabelas em HTML e caixas delimitadoras para elementos visuais. Foi criado para alimentar pipelines de RAG, índices de busca e agentes de IA em grande volume.Quanto custa o Cohere Parse 5?
$1.50 por 1,000 páginas. Para cargas pesadas, você pode executá-lo como uma instância dedicada do Model Vault (Medium a US$ 4,00/hora, XL a US$ 7,00/hora), o que, segundo a Cohere, reduz o custo por página em 23 a 61% em escala. Compare com um comparativo de custo entre agente de IA e agente humano antes de se comprometer.