

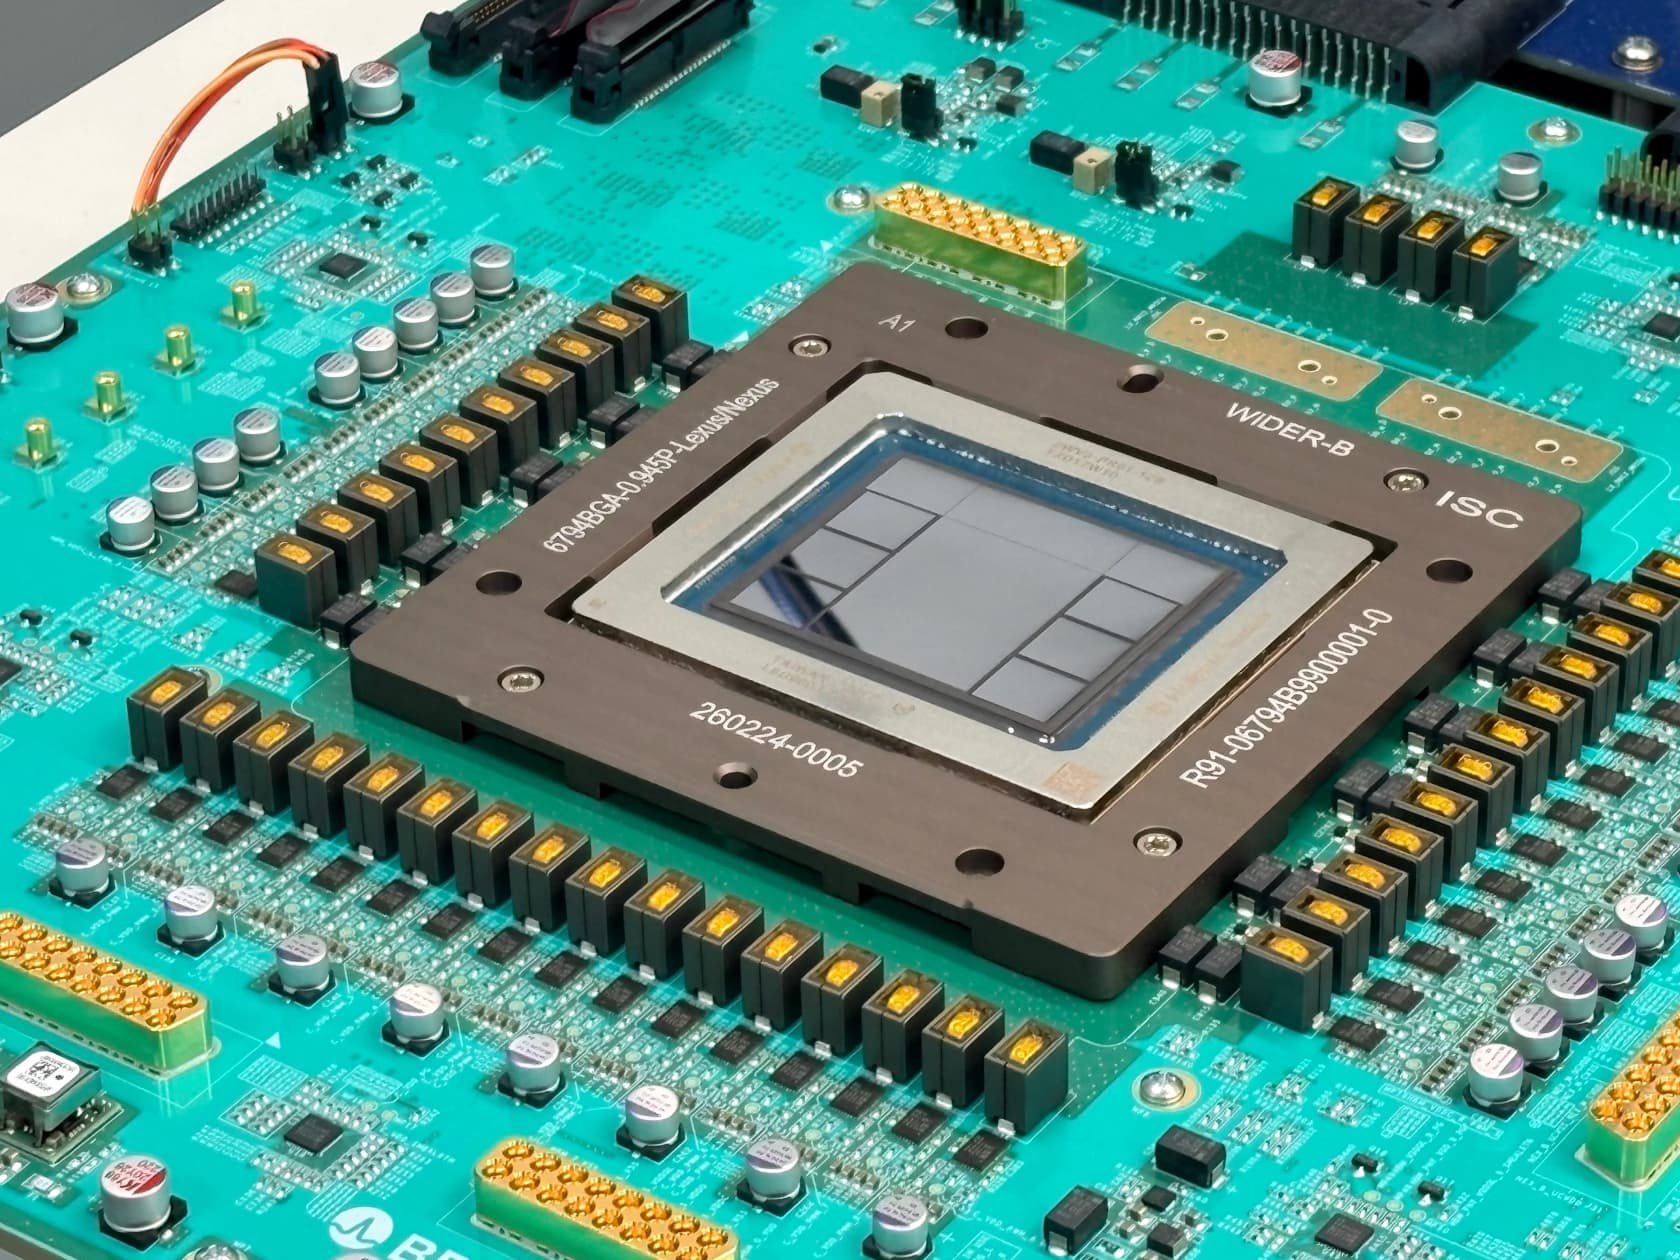
JalapeñoはOpenAI初の独自AIチップで、Broadcomと共同設計された推論用ASICです。2026年6月24日に発表されました。役割はただ一つ、ChatGPTやCodexのような大規模言語モデルを、できるだけ速く安く動かすことです。モデルの学習はしませんし、購入することもできません。
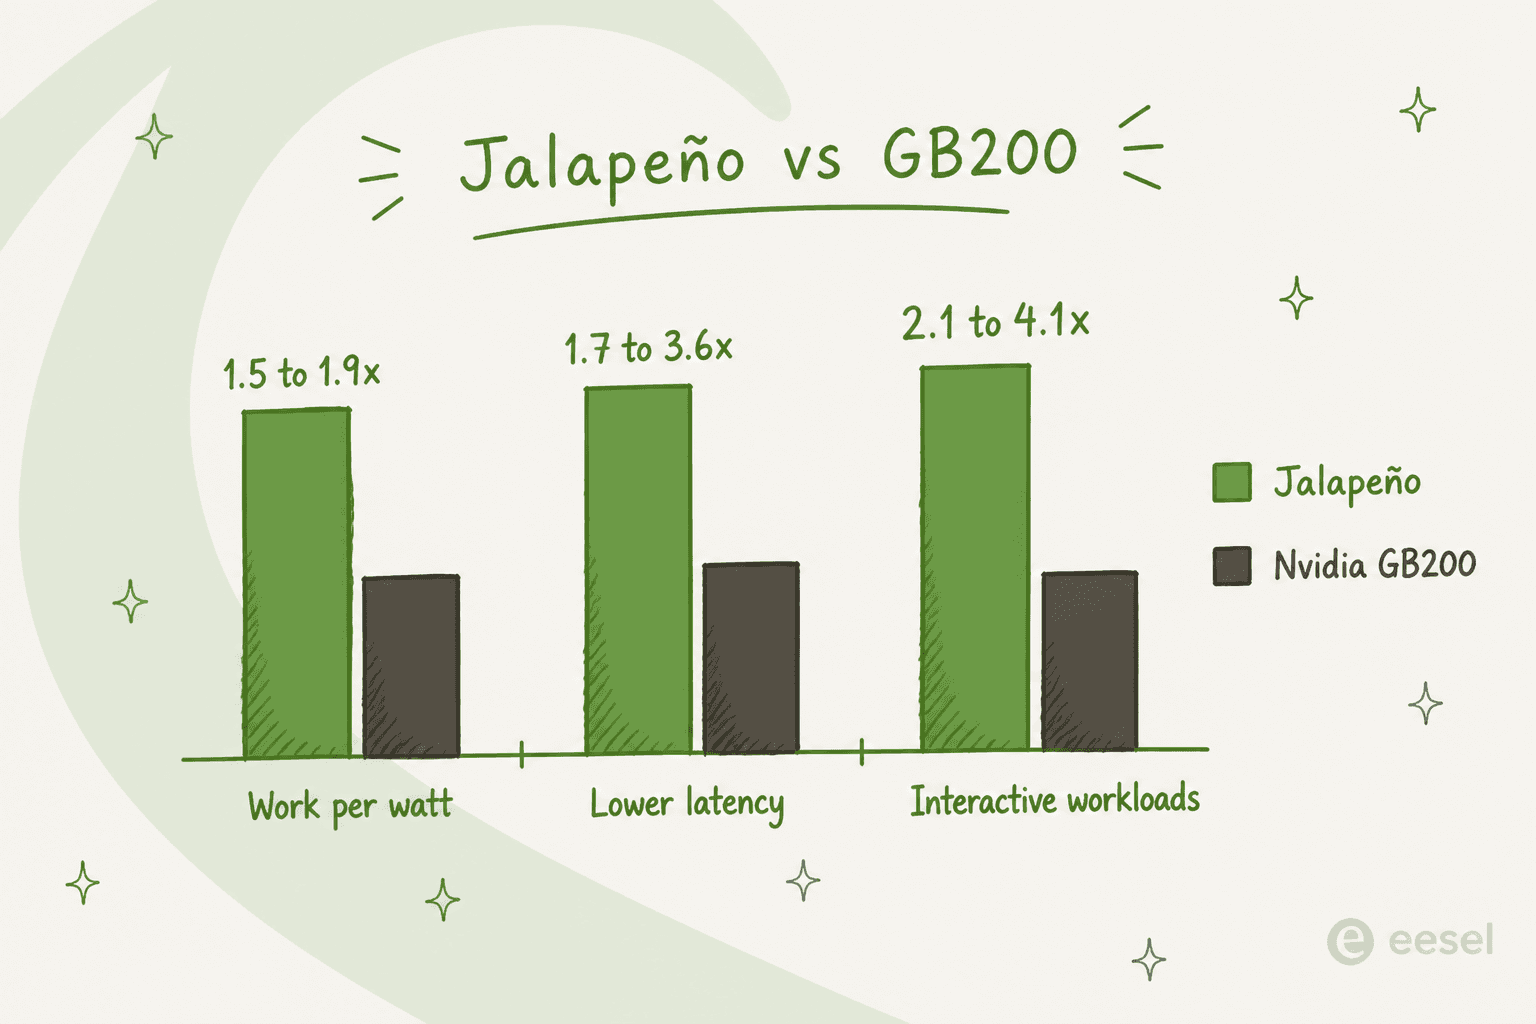
OpenAIの最初に公開されたベンチマーク(2026年8月25日)では、3つの公開モデルにおいて、比較対象のNvidia GB200システムに対し、Jalapeñoは1ワットあたりのAI処理量が1.5〜1.9倍、レイテンシが1.7〜3.6分の1でした。OpenAIは2026年末までに自社データセンターで稼働させる計画で、これはBroadcomとの10GW規模の構築に結びついた複数世代のロードマップの第1弾です。
OpenAIでない人にとっての要点は単純です。これはモデルの下にある配管であり、配管が安くなればAIも安くなります。同じ力が、大規模運用でAIエージェントが人間のエージェントより低コストになる理由でもあります。eeselのようなツールはこれらのモデル上で実際の仕事をこなすので、下のシリコンが効率化すれば、あなたが何もしなくてもAIサポートや自動化の採算は良くなります。
OpenAIが実際に発表したこと
私はAIエージェントを作る仕事をしているので、チップの発表は一つの観点で読みます。上で動くモデルにできることか、動かすコストのどちらかが変わるのか、という点です。Jalapeñoは明らかに後者で、しかも大きな変化です。
2026年6月24日、OpenAIとBroadcomはJalapeñoを発表しました。OpenAI初の自社チップです。名前は熱さと速さにかけたジョークですが、実質は、OpenAIがもはやコンピューティングのすべてを他社から借りているわけではないということです。独自のシリコンを設計したとTechCrunchが報じ、Bloombergは、すでに最初の物理サンプルを受け取ってテストしていると伝えました。
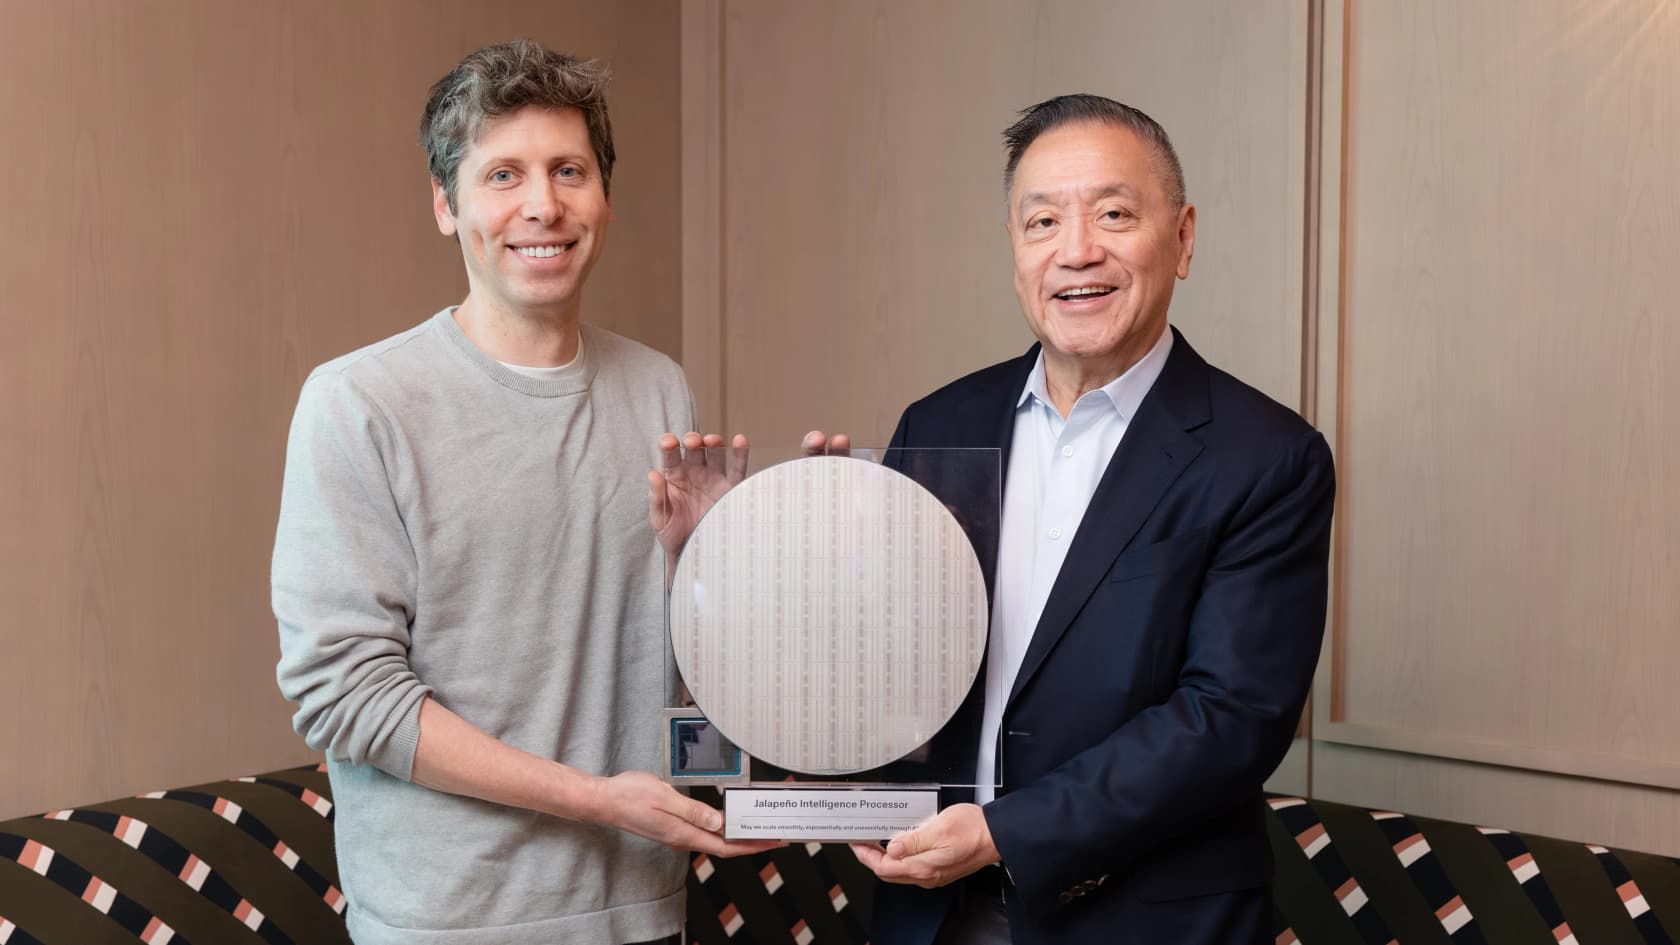
多くの人が見落としたのは規模という見出しです。このチップは、今後数年でOpenAI設計のアクセラレーターを10GW分展開するというパートナーシップの一部です。OpenAIはこれを、モデル、製品、サービング用ソフトウェア、チップ、メモリ、ネットワークのすべてを自社で握る、より広い"フルスタック"計画の一環と位置づけています。Jalapeñoは、その計画がスライドから動くシリコンに変わった場所です。
Jalapeñoとは何か、何ではないか
いくつか区別しておくべき点があります。「OpenAIがチップを作った」は「OpenAIがNvidiaと戦っている」と単純化されがちですが、それでは要点を外します。
JalapeñoはASIC、つまり特定用途向けチップです。Nvidia GPUはモデルの学習、グラフィックス、推論の提供までこなせる柔軟な汎用プロセッサですが、ASICは一つの狭い仕事を極めてうまくこなし、それ以外はしません。Jalapeñoの唯一の仕事は推論、つまり学習済みモデルがあなたのプロンプトを読んで回答を生成する提供側です。モデルの学習はしません。そちらにはOpenAIは今もNvidiaなどのパートナーを使っています。
そして購入はできません。Jalapeñoは製品ではなく、OpenAI自社のインフラ内でChatGPT、Codex、API、エージェント型製品を提供するために動いています。それ以外の人にとっては、ラックに置くハードウェアではなく、より速く安価なOpenAIモデルという形で間接的に現れます。実際にレンタルできる専用推論ハードウェアの話なら、その市場はBasetenのようなプラットフォームですでに存在します。
公平のためにもう一つ。これは速かったのです。OpenAIは設計からテープアウトまで9か月だったと述べています。カスタムシリコンとしては速く、業界の人材と資金がいま推論コストにどれだけ向かっているかを物語っています。
ベンチマークの数字
2026年8月25日、OpenAIはJalapeñoの最初の結果を公開しました。この発表が話題になった理由は、その数字です。
GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1Tの3つの公開モデルでテストし、OpenAIはJalapeñoが次の結果を出したと報告しました。
- ピーク時のスループットで1ワットあたりのAI処理量が1.5〜1.9倍
- エンドツーエンドのレイテンシが1.7〜3.6分の1
- 高いインタラクティブ性が求められるワークロードで性能が2.1〜4.1倍
OpenAI自身のグラフでの比較対象はNvidia GB200で、定格は1,200ワット、Jalapeñoは700ワットです。OpenAIが繰り返し強調するのは、一つの設計で高いスループットと低いレイテンシの両方を達成した点で、既存のハードウェアでは通常この二つのどちらかを諦める必要があります。
独立した見方は、OpenAIが使ったInferenceXベンチマークを持つSemiAnalysisから出ています。見出しから率直で「Better Than Nvidia Blackwell」とし、Jalapeñoがユーザーあたり毎秒ほぼ700トークンに達し、同等のインタラクティブ性目標で次点のチップの9倍以上だったと挙げています。一点、頭に置いておきたいのは、後述しますが、SemiAnalysisはOpenAIが実行を選んだベンチマークの持ち主だということです。
最も興味深い点:チップが自分自身を設計した
これは私なら一面に載せる詳細で、OpenAIはほとんど埋もれさせていました。9か月でのシリコン開発が可能だった理由は、OpenAIが自社のモデルを使ってチップを設計したことです。
以前のモデルはチップの立ち上げを助け、新しいモデルはそれを最適化しプログラミングしています。CodexとGPT-Astraを使い、チームは当初の計画になかった3つのオープンウェイトモデルを2か月で高性能に仕上げました。一部のアテンションとMixture-of-Expertsのブロックでは、AI生成の実装が人間の専門家による版より1.5〜1.8倍高速に動きました。
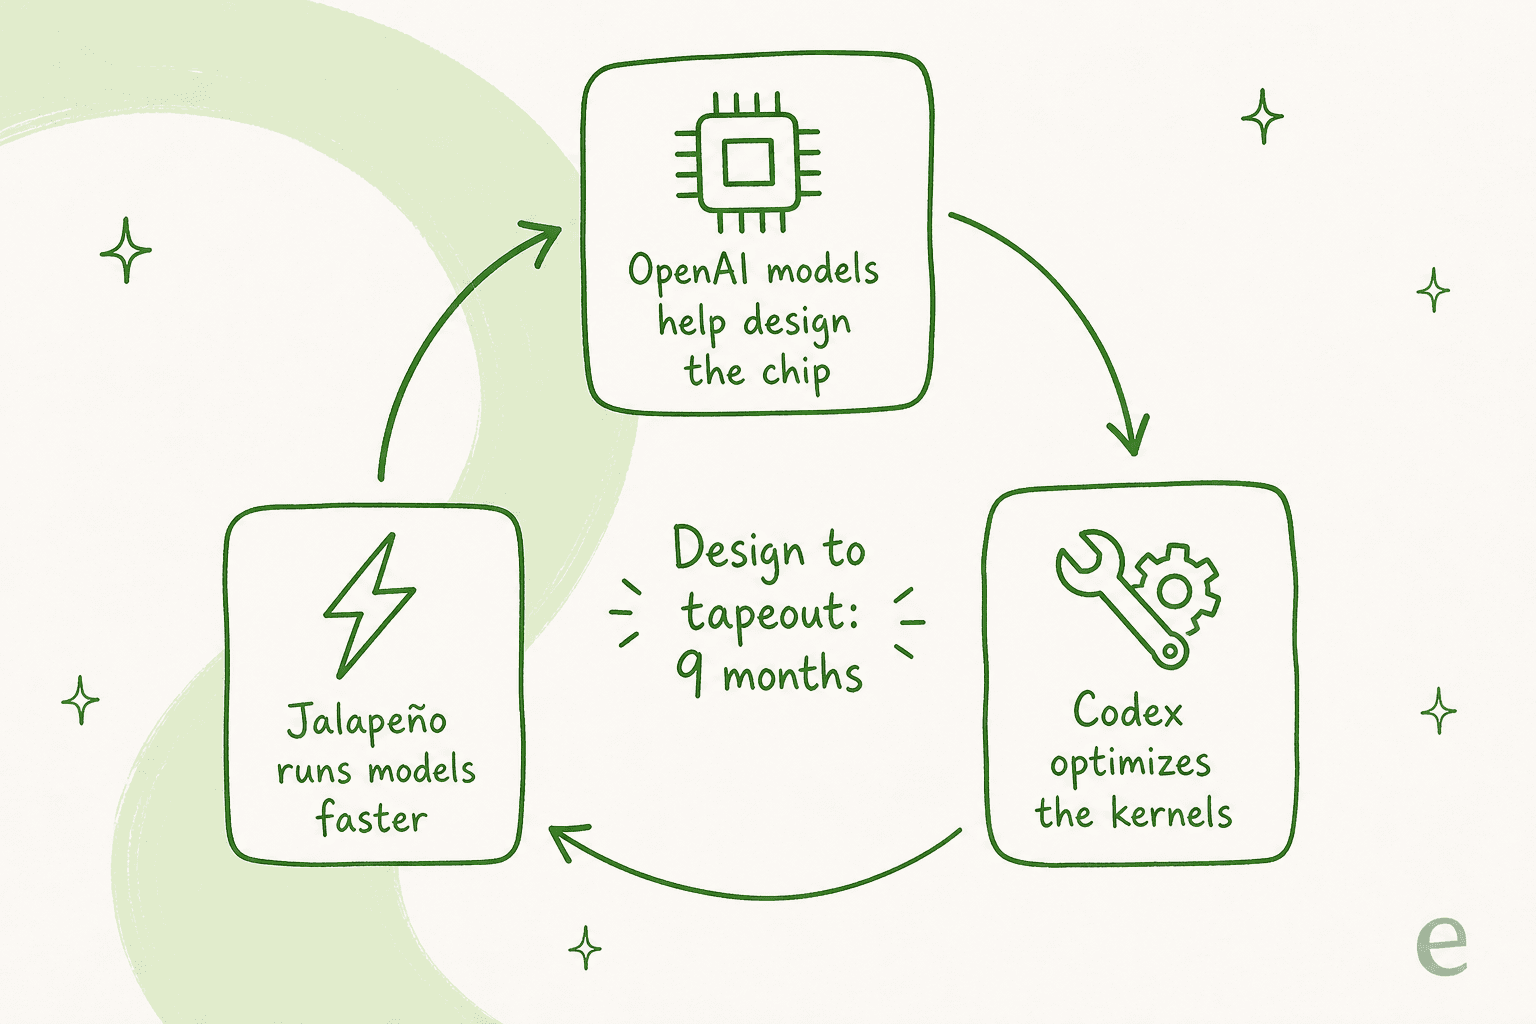
これはループです。モデルがシリコンの設計を助け、シリコンがモデルをより速く動かし、速くなったモデルが次のシリコンの設計を助けます。Gen 2は「deep in development」、Gen 3は「taking shape」です。ベンチマークをどう見るにせよ、この複利で効くフィードバックループこそが肝であり、AIコーディングアシスタントが実際の製品づくりでますます発言力を増している理由と同じです。
コミュニティの反応
反応は一方的な祝賀ムードではなく、懐疑的な声ももっともなので紹介します。
Hacker Newsで最も鋭い批判は、これは同条件の比較ではないというものでした。
"OpenAI's chip is targeting inference (FP8, FP4), while most of the chips it is being compared to are general purpose."

専用設計の推論ASICが、ワット当たりの推論で汎用GPUに勝つのは当然です。それが特化によって得られるものなので、勝利は本物ですが、ある程度は想定内でもあります。また、スコアカードを誰が書いたかを指摘する声もありました。
"This semi-analysis article reads a lot more like an OpenAI press release than a real analysis."
Redditの投資家側では、話題はトークンよりも利益率でした。r/NVDA_Stockは、カスタムシリコンを、一夜で来る脅威ではなく、Nvidiaの価格決定力に対するじわじわ効く脅威として捉えていました。私の見方はその中間です。数字は方向性としてはおそらく正しく、OpenAIのワークロードでは実際の値であり、同時に、開発元自身のテストで測定された特化型チップに期待される数字そのものでもあります。
OpenAIでなくてもチップの発表が重要な理由
あなたがJalapeñoを導入することはありません。では、なぜ気にするのか。推論コストは、あなたが使う、あるいは作るあらゆるAI製品の下にある静かな数字だからです。
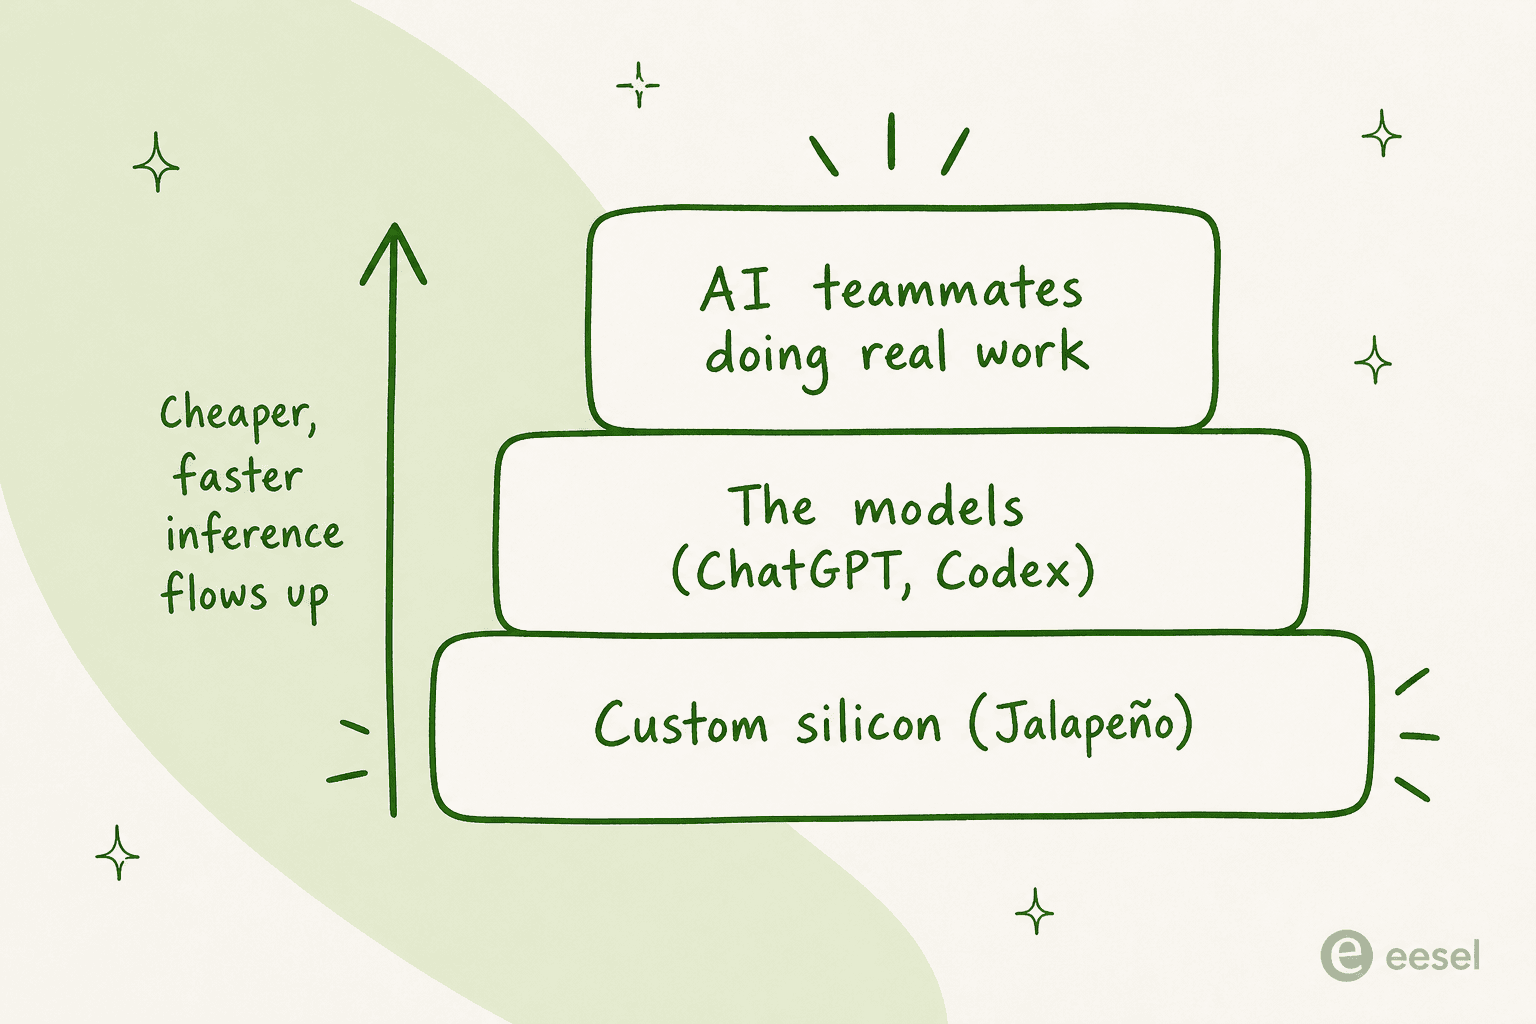
AIサポートの返信、下書きされたメール、注文を読んで顧客に答えるAIエージェントの一つひとつが、提供に実際のお金がかかる推論呼び出しです。OpenAIがそのコストを下げると、まず自社の利益率が改善しますが、時間とともにその効果はスタックを上へ流れ、API価格の低下や、1ドルあたりでより多くをこなすモデルとして現れます。これがAIサポートをデモから、明らかに元が取れる費用項目へと変え続ける追い風であり、AIがカスタマーサポートで実際にどれだけ節約できるかの背後にあるのと同じ計算です。
これは、ほとんどのチームにとって本当のレバレッジがどこにあるかを思い出させるものでもあります。シリコンを持つことで競うのではなく、モデルをあなたの実際の課題に働かせることで競います。チップは工場のフロアです。チケットを処理するAIエージェントは従業員で、その従業員こそ、あなたが採用できる部分です。
eeselを試す
Jalapeñoはインフラ、モデルの下の層です。eeselはその上の層で、実際に働かせる部分です。AIチームメイトのプラットフォームで、特定の業務向けにすぐ働けるチームメイトを採用します。AIヘルプデスクのチームメイトは、既存のZendesk、Freshdesk、Gorgiasのキューに加わり、過去のチケットとヘルプセンターから学び、返信の下書きや送信を始めます。
私が差別化要素として挙げたいのは、実際の顧客に回答する前に、過去のチケットでチームメイトをシミュレーションできる点です。スイッチを入れて祈るのではなく、事前にどう動くかが分かります。料金は月299ドルから500クレジット(チケットまたはチャット1件につき1クレジット)で、ユーザー数に応じた課金はなく、100クレジットで無料で始められます。内部のシリコンが安くなるのは結構ですが、今日試せるチームメイトこそ、あなたの1週間を変える部分です。