「カスタマーサポートエージェントAPI」で人々が本当に意味していること
「customer support agent API」を検索すると、互いにほとんど関係のない結果が返ってくる。それは、この言葉が本質的に異なる3つの仕事を1つの文字列に押し込めているからで、それぞれの検索結果の先にいる読者は違うものを求めている。
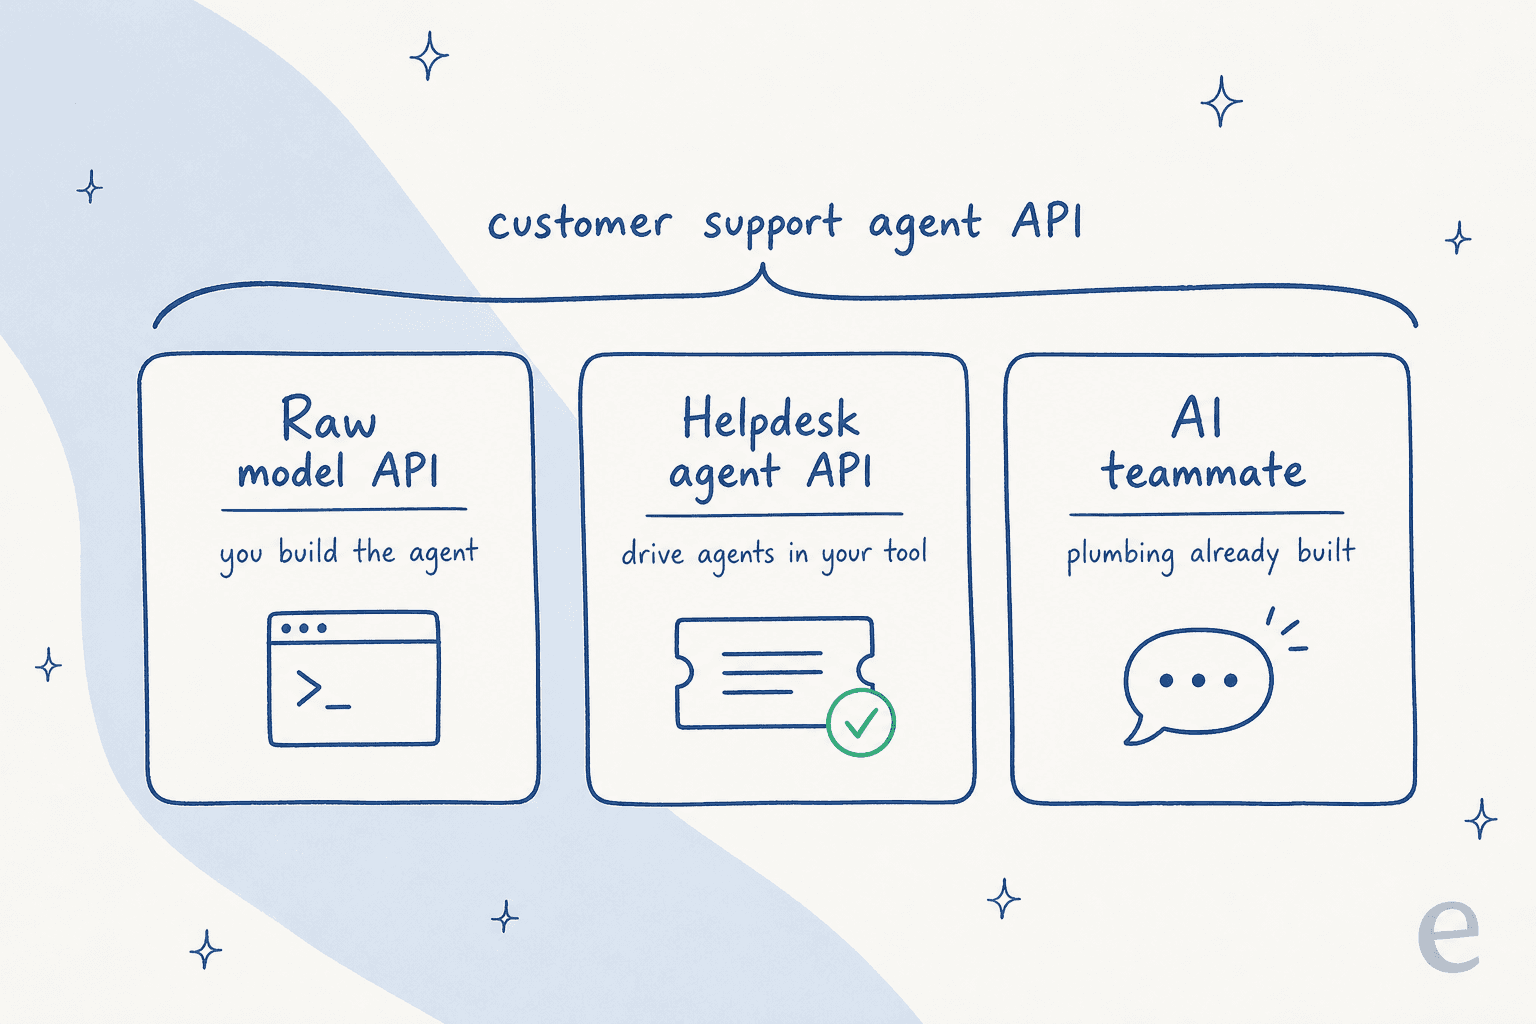
3つのルートを、自分でどれだけ構築するかの順に並べるとこうなる。
- 自分で構築する — 基盤モデルAPIの上に。モデルと基本要素を手に入れ、自分でエージェントを組み立てる。
- ヘルプデスクを操作する — そのエージェント、会話、またはMCP APIを通じて。ベンダーがサポート基盤を所有し、あなたはそこにエージェントを向ける。
- 完成済みのチームメイトを雇う — すでにサポートのやり方を知っている。基盤はすでに構築済みで、設定して稼働させるだけだ。
それぞれを順に見ていき、実際に何が手に入り、隠れた作業がどこに潜んでいるかを説明する。この記事から一つだけ持ち帰るとすれば、APIは決してエージェントそのものではないということだ。その理由を見ていこう。
ルート1: 生のモデルAPIの上に自分で構築する
これは多くのエンジニアが最初に思い浮かべるルートであり、静かに9か月がかりのプロジェクトへと変わっていくルートでもある。OpenAIもAnthropicも、完成したサポートエージェントではなく、モデルインフラを販売している。どちらも自分たちのやることに関しては非常に優れている。ただ、彼らがカバーするのは「カスタマーサポートエージェント」という言葉が示唆するよりもずっと小さな範囲だ。
具体的に手に入るものを見てみよう。OpenAIのResponses APIが主な呼び出しインターフェースであり、オープンソースのAgents SDKが自分のプロセス内でエージェントループを実行する。OpenAI自身のドキュメントはこの役割分担について率直だ。「デプロイメント、ツール実装、状態の保存、承認判断」はあなたが所有し、「SDKはエージェントループを実行する」。Anthropicの構造も同様だ。Messages APIとツール使用を組み合わせると、構造化されたツール呼び出しが手に入り、それを実行するのは自分のコードだ。Claude Agent SDKはセッション、フック、サブエージェント、権限管理を追加するが、ループは依然として自分のプロセス内で動き、永続化は自分の統合作業だ。
どちらも同じ基本要素を提供する。モデル、ツールを定義する仕組み、エージェントループ、ホスト型の検索プリミティブ(OpenAIのファイル検索、Anthropicのサーバーサイドツール使用)、そして音声サポート向けにはOpenAIのRealtime API。どちらも与えてくれないのは、実際のサポートエージェントそのものだ。
APIが与えてくれるものと、自分で構築すべきもの
このギャップは、クイックスタートで見るよりも実際にはずっと大きい。「注文を検索して返金を実行する」という機能は、モデルが発行するツール呼び出しにすぎない。Shopifyや自社の請求システムと実際にやり取りするコードは、完全に自分自身のものだ。サポートエージェントを支えるその他すべての要素についても同じことが言える。
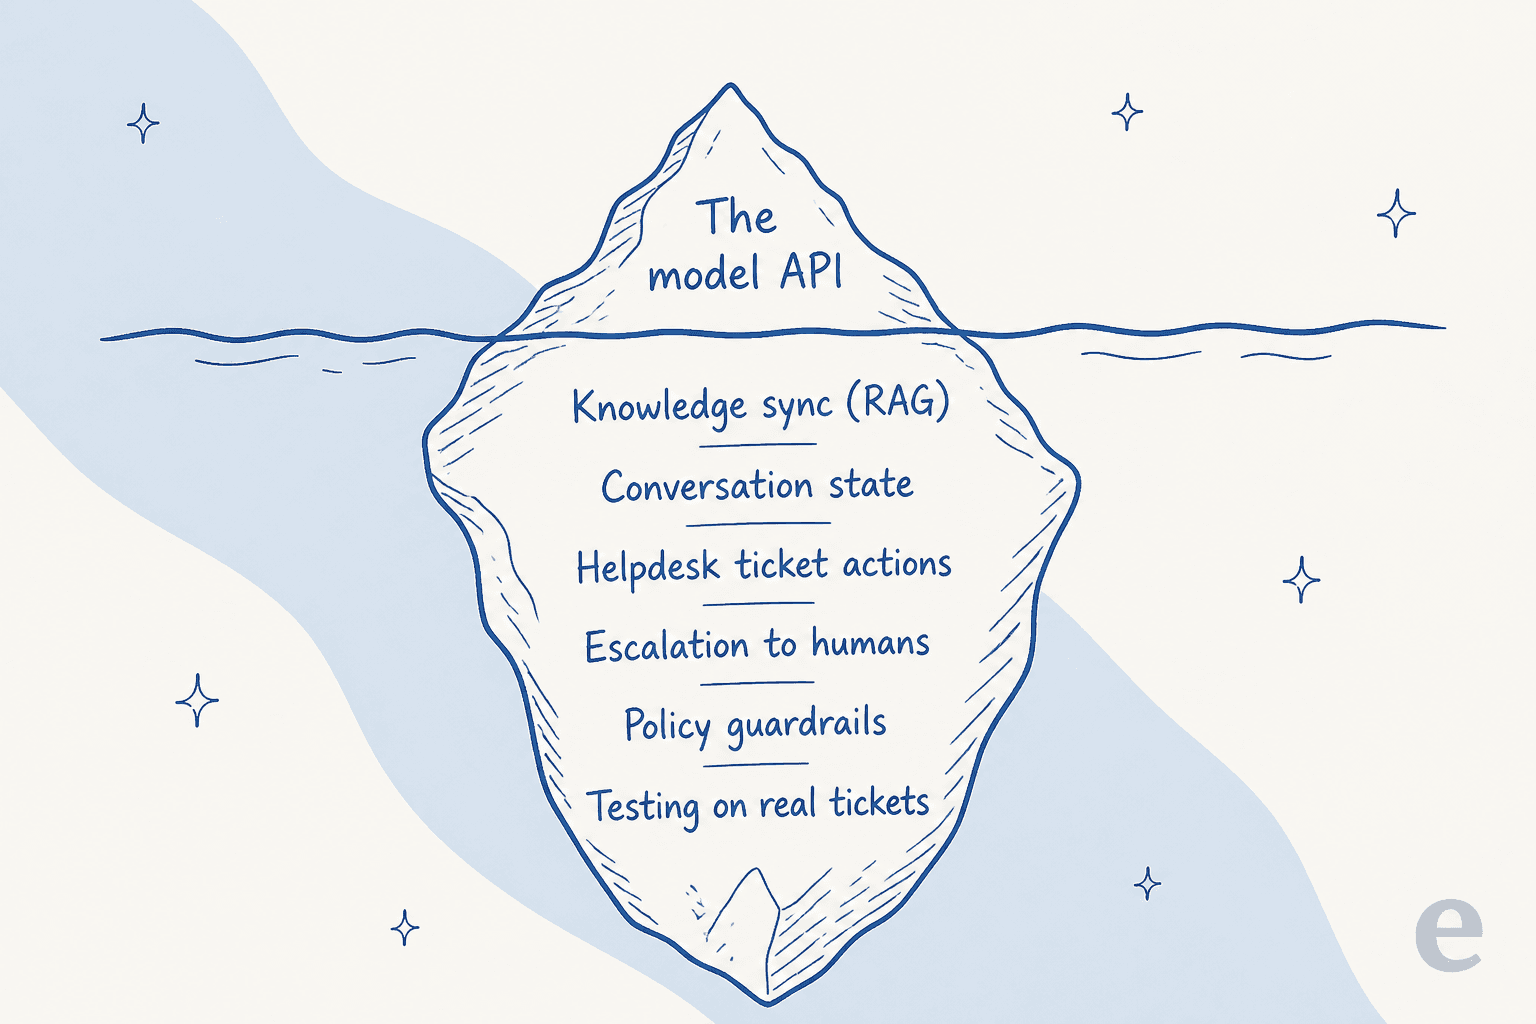
水面下にあるものはすべて、自分自身のエンジニアリング作業だ。
- ナレッジ同期と検索。 ファイル検索やツール使用はある種の検索メカニズムを提供してくれるが、それを本番のヘルプセンターと同期させ続けること、加えてチャンキング、リランキング、アクセス制御は自分の仕事だ。
- 会話の状態管理。 基盤となるAPIは呼び出しごとに状態を持たない。履歴は自分で保存し、再送信する必要がある。
- チケットへのアクション。 Zendeskのチケットを更新する、ティア2にエスカレーションする、タグを付ける — これらはすべて自分で実装する関数ツールだ。
- ガードレールとエスカレーション。 両SDKとも入力、出力、ツールのガードレールと人間による承認を提供するが、それぞれのポリシーごとに自分でコードを書く必要がある。
- 実際のチケットに対するテスト。 トレーシングと評価用フックは手に入る。だが過去の履歴を再生し回答を採点するテストスイート自体は、自分で構築するものだ。
これはモデルプロバイダーへの批判ではない。単に率直な実態を述べているだけだ。より詳細なプリミティブの比較を知りたければ、AgentKit vs Anthropic APIの記事がツールごとに解説している。
誰も予測していないトークン課金の請求書
コストモデルこそが最も鋭い驚きだ。チケットが最終的に解決されるかどうかに関わらず、すべてのメッセージに対してトークン単位で支払うことになる。システムプロンプト、検索されたナレッジチャンク、ツール呼び出しの往復、モデルの推論、そしてすべてのリトライに対してだ。
標準ティアにおける、100万トークンあたりのおおよそのファーストパーティ価格は以下のとおり。
| モデル | 入力 | キャッシュ入力/ヒット | 出力 |
|---|---|---|---|
| OpenAI gpt-6-astra | $10.00 | $1.00 | $50.00 |
| OpenAI gpt-5.6-terra | $2.00 | $0.20 | $12.00 |
| Anthropic Claude Opus 5 | $5.00 | $0.50 | $25.00 |
| Anthropic Claude Sonnet 5 | $2.00 | $0.20 | $10.00 |
| Anthropic Claude Haiku 4.5 | $1.00 | $0.10 | $5.00 |
プロンプトキャッシュは、毎ターン同じヘルプセンターのコンテキストを再送信するサポート業務において大いに役立つ。キャッシュヒットは標準入力価格の約10%で読み取られる。しかしキャッシュは金額を和らげるだけで、課金単位そのものを変えるわけではない。10ターン続き、毎ターン12個のチャンクを検索し、2回リトライするサポート会話は、顧客が不満なまま去ったとしても、そのすべてに対して課金される。
ルート2: ヘルプデスク自体のエージェントAPIを操作する
2つ目のルートは、エージェント全体を構築する作業を省き、代わりにすでに使っているヘルプデスクにエージェントを向けるというものだ。主要なヘルプデスクはすべてプログラム的なインターフェースを公開しており、そのインターフェースの形はこの1年で大きく変化した。
古典的な形はREST APIとWebhookの組み合わせだ。Zendeskを例にとろう。外部モデルを接続するには4つのルートがある。自分の鍵を使うファーストパーティコネクタ、トリガーから自分のサービスへ、そしてREST API経由で戻ってくるWebhook、Zendeskのプロキシ経由でモデルを呼び出すサイドバーアプリ、あるいはMCPサーバーだ。これは機能するが、DIYパイプライン(ルート2)を選ぶということは、認証、ポーリング、リトライ、そして何より重要なレート制限を自分で負うことを意味する。これらの制限は、あらゆる統合における実質的な上限になる。
| Zendesk Suiteプラン | APIリクエスト数/分 |
|---|---|
| Team | 200 |
| Growth | 400 |
| Professional | 400 |
| Enterprise | 700 |
| Enterprise Plus | 2,500 |
エンリッチメント、書き戻し、過去チケットの再処理はすべて同じ1分あたりの予算を消費する。大量の再処理ジョブがそれを超えるまで、うっかり忘れがちなポイントだ。
MCPが静かにこのルートを変えつつある
より大きな変化は、ヘルプデスクが「これがREST APIだ、あとは自分で作れ」という姿勢から、独自のModel Context Protocolサーバーを提供する方向へと移行していることだ。MCPはAnthropicが提唱したオープンな標準規格であり、ツールごとに個別の統合を作る代わりに、標準化された1つのプロトコルでエージェントを外部システムに接続する。Zendesk自身が従来の課題をどう表現しているかは示唆的だ。リアルタイムデータを今日AIに接続するには「APIと、経験豊富な開発者(1人か2人)、そして長いリードタイムが必要」だとし、現在は「APIとは異なり、MCP統合は一度セットアップすればよい」というZendesk MCPクライアントを売り込んでいる。
ファーストパーティサーバーのリストは急速に増えている。
- Gorgiasは
mcp.gorgias.com/mcpで無料のMCPサーバーを提供しており、現在オープンベータ中で、任意のMCP対応クライアントにワークスペースを接続できる。 - Frontは
mcp.frontapp.com/mcpのサーバーを文書化しており、珍しく整理された権限モデルを備えている。PKCE付きのOAuth 2.1、ユーザーごとのトークン、そしてread、write、sendのスコープにより、「エージェントの実効的な権限は、まさに承認したチームメイト本人の権限そのもの」になる。 - Atlassianは公式のリモートMCPサーバーを運用しており、Jira、Confluence、Jira Service ManagementをOAuth経由でエージェントに接続する。ITSM向けにとっては、これがエージェントからサービスデスクを操作する主要な手段だ。
これは購入か構築かという判断にとって本当に良いニュースだ。以前は手作業で書く必要があったインフラを、今はベンダーが保守してくれる。しかしMCPが解決しないのはエージェントそのものだ。サーバーはツールを公開するが、頭脳、検索の質、そして実際にその返金を実行すべきかどうかを判断するガードレールは、依然として自分で用意する必要がある。モデルをヘルプデスクに接続するノーコード版が欲しければ、ChatGPTとZendeskの統合に関するガイドで解説している。
ルート3: 基盤部分を持ち込んでくれるチームメイトを雇う
3つ目のルートは、「customer support agent API」と検索する多くの人が実際に求めているものに最も近い。すでにサポートのやり方を知っているエージェントを、自社のスタックに向けて設定するだけで、組み立てる必要がないというものだ。eeselのようなツールはここに位置しており、これが最初の2つのルートの単なる見栄えの良いラッパーではなく、まったく異なるカテゴリーである理由を正確に理解しておく価値がある。
AIヘルプデスクチームメイトは、氷山全体があらかじめ構築された状態で登場する。過去のチケットとヘルプセンターから学習し、すでに使っているヘルプデスク内のキューに加わり、注文を検索し、タグ付けとトリアージを行い、返信を下書きまたは送信する。検索スタック、会話の状態管理、チケットへのアクション、エスカレーションロジックはすべて処理済みだ。あなたはインフラを実装するのではなく、振る舞いを設定するだけでいい。
開発者にとって最も重要なのは、「完成済み」が「閉じたブラックボックス」を意味しないということだ。eeselは、デフォルト設定ではカバーしきれない周辺部分のために、実際にプログラム可能なインターフェースを維持している。
- **Network Access**により、許可した任意のREST APIをGET、POST、PATCH、DELETEで呼び出せる。ドメインごとの認証ヘッダーも設定できる。認証情報はヘッダーとして保存され、モデルには一切表示されない。
- **Webhooks**により、どんなツールにも固有のURLが与えられ、送信されたものでエージェントを起動できる。
- **CLI**とカスタムスキルにより、自分でコントロールしたい部分をスクリプト化でき、1つのスキルが1回の実行で複数のツールにまたがることもできる。ヘルプデスクを読み取り、Shopifyを確認し、Slackに投稿する、といった具合だ。
私が持ち続けたい区別はこうだ。生のモデルAPIはインフラであり、eeselは従業員だ。コードが価値を生む部分では引き続き自分でコードを書けばいい。ただ、そこにたどり着くために、検索、状態管理、ヘルプデスクコネクタをゼロから再構築する必要はない。
「API」という言葉が常に隠している90%
ここで、自作したいという本能に一度立ち止まって異を唱えたい。実際にサポートエージェントを世に出した開発者たちの合意は驚くほど一致しており、それは「絶対に自作するな」ではない。モデル呼び出しは簡単な部分にすぎず、コストの本体は継続的なメンテナンスにあるということだ。
まず誰もが過小評価している検索から見てみよう。Hacker Newsで最もエンゲージメントの高いRAGスレッド(551ポイント)は、500万件以上のドキュメントを処理した際のポストモーテムであり、人気のオープンソースRAGテンプレートを保守するMicrosoftのエンジニアは「とりあえずベクターDBを追加すればいい」という本能に強く反論している。
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

元の投稿者自身の結論は、1回きりの検索では不十分で、結局は結果を評価しフォローアップクエリを行うエージェント的なループが必要になるというものだった。それは設定フラグではなく、実際のシステムだ。
次に、サポートエージェントは話すだけでなく行動できるという問題がある。本番環境でのハルシネーション防止についてのAsk HNスレッドで、最も鋭い指摘はまさにこの点についてだった。
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
返金を実行したりアカウントの状態を変更したりできるエージェントには、優れたプロンプト以上に、制約されたアクション空間と許可/拒否リストが必要だ。そして、ほとんど誰も適切に行っていないテストなしには、ガードレールが実際に機能するかどうかを知ることはできない。あるr/AI_Agentsスレッドが指摘したように、「エラーは投げられなかった」と「タスクは完了した」は、回答が重要な点で間違っていたとしても両方とも真でありうる。これこそシミュレーションを支持する最も強力な論拠だ。実際の過去チケットを再生し、自分のチームが実際に送った内容と照らし合わせてエージェントの回答をサンドボックス内で採点する、本番キューに触れる前にだ。これはまさにこの理由からeeselの中核スキルの1つになっており、ゼロからの構築ではほぼ確実に欠落してしまう部分でもある。
最後に、継続的なメンテナンスという、本当の意味での数字の話だ。460件以上のコメントが付いたr/AI_Agentsスレッドから、最も引用されている現実的な指摘は、それを直接言い当てている。
"The hardest part wasn't the LLM or voice quality - it was keeping the agent's knowledge current as policies changed and edge cases emerged."

それこそ、ほとんどの自作計画が予算に組み込まないメンテナンスだ。我々は何年もの間、本番のサポートキューでAIを運用してきたが、エッジケースこそが仕事のすべてだ。先週変わったポリシー、昨日ローンチされた製品ライン、あらゆる汎用エージェントを壊す一つの奇妙な返金フロー。それはまさに、クイックスタートには決して現れず、決して終わらない作業だ。
トークン単位 対 成果単位: 本当に判断を左右するコストモデル
視点を引くと、3つのルートは1つの軸できれいに分かれる。それは支払い方だ。ルート1とルート2はトークン単位の課金メーターに乗せられる。完成済みエージェントは通常、代わりに解決済みの作業単位ごとに価格を設定する。
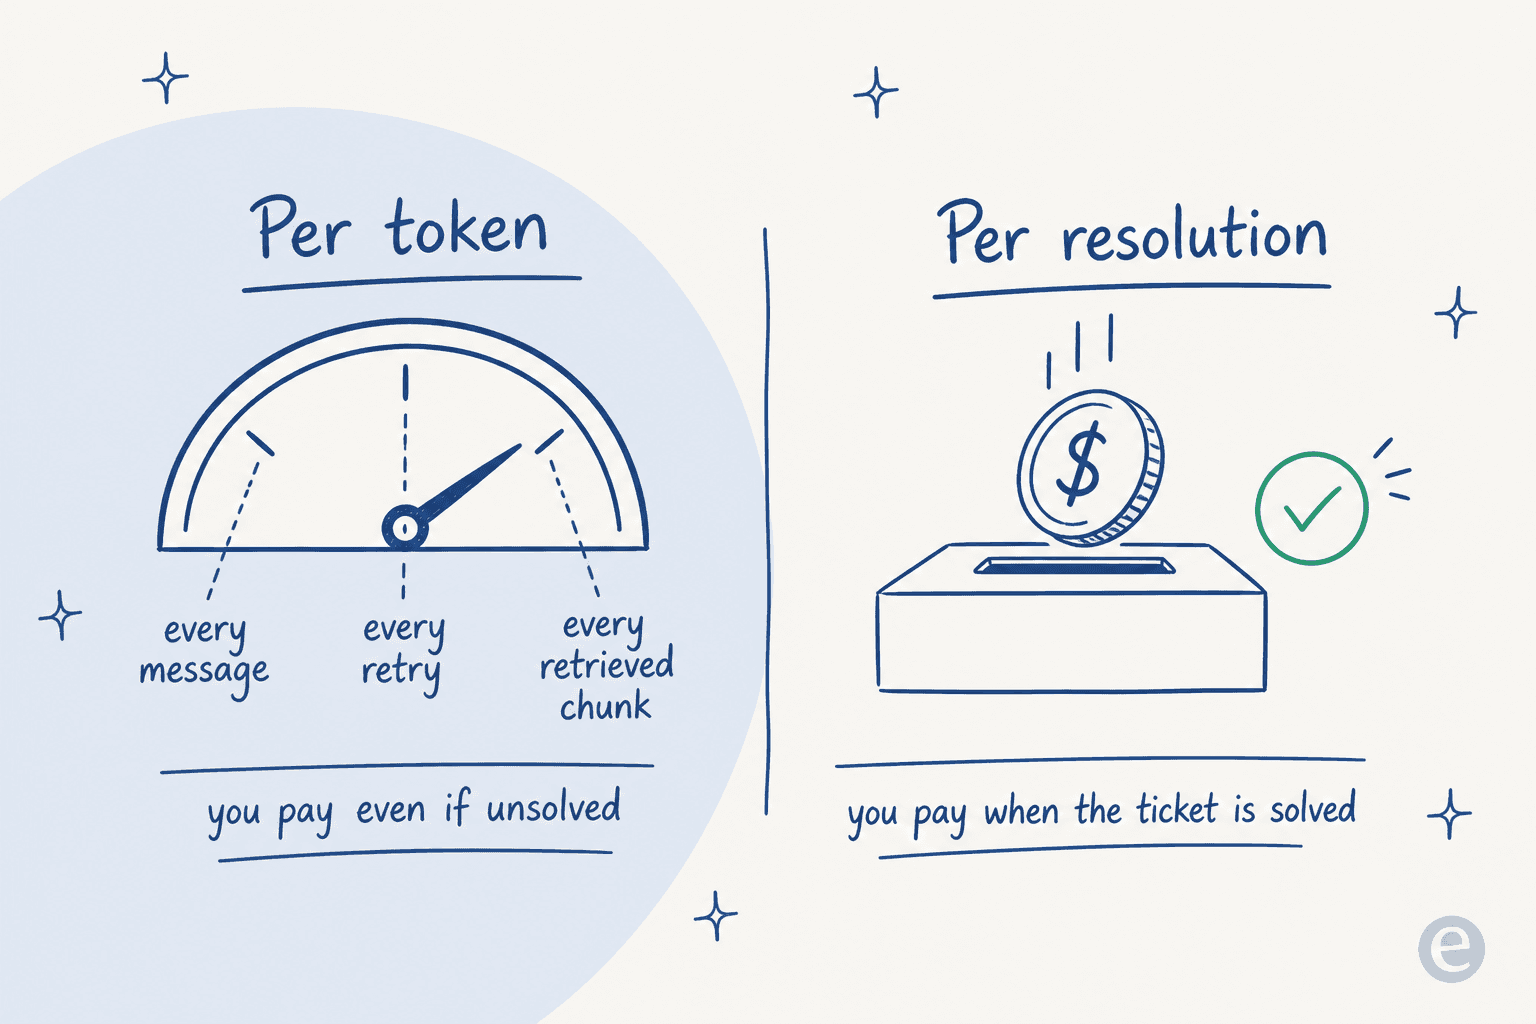
この違いは机上の空論ではない。トークン単位は、予測して上限を設定しなければならない、青天井で使用量に応じた請求を意味し、解決されようとされまいと、リトライや長い会話のたびに膨らんでいく。成果ベースの価格設定は、支出を実際に行われた作業に結びつける。例えばeeselは使用量ベースで、1チケット処理あたり約40セント、返信単位ではなくチケットまたはヘルプデスクの会話単位で課金され、席数料金もプラットフォーム料金も月額最低料金もない。自作エージェントを支えるエンジニアの給与と、毎週それが食いつぶすメンテナンス時間を加えると、「より安い」はずのDIYルートは、しばしばそうではなくなる。ある開発者が言ったように、「1日10分節約するが、毎週静かに数時間分のメンテナンスコストを食う」エージェントこそが罠であり、本当のコストは決して構築そのものにはない。
では、実際にどのルートを選ぶべきか
これらのルートはどれも間違っているわけではない。それぞれ異なるチームに適している。まずは短いバージョンを、その後で自分の立ち位置を素早く把握する方法を紹介する。
そして同じトレードオフを表にまとめるとこうなる。
| 観点 | 生のモデルAPI | ヘルプデスクエージェント/MCP API | 完成済みのチームメイト |
|---|---|---|---|
| エージェントを構築するのは誰か | すべて自分 | 頭脳とガードレール | 自分は設定するだけ |
| 検索/ナレッジ同期 | 自分の担当 | 自分の担当 | 組み込み済み |
| ヘルプデスクコネクタ | 自分の担当 | ベンダー(1プラットフォーム分) | 組み込み済み(1000以上) |
| 本番稼働前のテスト | 自分でテスト基盤を構築 | 自分でテスト基盤を構築 | 過去チケットでのシミュレーション |
| 課金単位 | トークン単位 | トークン単位+プラン上限 | 処理したチケット単位 |
| 最初の解決済みチケットまでの時間 | 数週間〜数か月 | 数日〜数週間 | 数分〜数時間 |
| カスタムコードは可能か | 完全に可能 | 完全に可能 | Network Access、CLI、スキル |
より広い選択肢を検討している場合は、最良のAIエージェントやチケットトリアージ向け最良のAIのまとめ記事がツールごとに解説している。
eeselを試す
ここまで読んで「モデルAPIの上に構築する」か「エージェントを購入する」かを天秤にかけているなら、ほとんどのサポートチームにとっての正直な答えはこうだ。自作はクイックスタートの時点では安く見えるが、2年目にはより多くのコストがかかる。eeselは、この第3のルートを正しく実現したものだ。すでに使っているヘルプデスクに接続し、過去のチケットとドキュメントから学習し、そしてゼロからの構築ではほぼ必ず省かれてしまう部分、つまり本番のチケットに答える前に実際の過去チケット履歴でシミュレーションを行う、AIサポートチームメイトだ。
検索、状態管理、コネクタを先に再構築することなく、重要な部分ではプログラム可能なインターフェース、任意のREST API向けのNetwork Access、Webhook、CLI、カスタムスキルを維持できる。無料で始められ、クレジットカードも営業電話も不要で、料金は処理したチケット単位なので、消費したトークンではなく実際に行われた作業に対して支払うことになる。四半期をかけてエージェントを構築するよりも、既存のキューにエージェントを向けたいなら、これが自分自身のチケットでそれを確認する最も速い方法だ。
よくある質問
カスタマーサポートエージェントAPIとは何ですか?
サポートエージェントはモデルAPIで自作すべきですか、それとも購入すべきですか?
カスタマーサポートエージェントAPIの費用はどれくらいですか?
MCPとは何で、サポートエージェントAPIとどう関係しますか?
既存のヘルプデスクにAPI経由でAIエージェントを接続できますか?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.