

FLUX 3 Action es la parte del nuevo modelo fundacional de Black Forest Labs que predice acciones físicas en lugar de píxeles. El truco es que es el mismo modelo que genera video, decodificado de otra manera. El argumento de BFL es que, para generar video convincente, un modelo ya tiene que aprender cómo se comporta el mundo (contacto, peso, causa y efecto), así que predecir el siguiente movimiento de un robot es solo otra vista de esa misma comprensión.
Convertido en producto como FLUX-mimic junto con mimic robotics, se ha probado y desplegado en Audi en trabajos que los robots convencionales nunca podrían tocar, como manipular cables y juntas blandas. La cifra principal: alcanzó una tasa de éxito mediana del 95 % en una tarea de kitting con objetos blandos, y superó a modelos de robots anteriores incluso con el backbone congelado, una configuración en la que el mejor anterior obtuvo 0 %.
El problema para la mayoría de los lectores: todavía no puedes usar FLUX 3 Action. Está limitado a socios seleccionados, sin API pública, precio ni pesos. Si llegaste buscando un agente de IA que puedas poner a trabajar hoy, FLUX 3 es infraestructura para robots, no una contratación. Esa distinción vale la pena entenderla, y es donde aterrizaré al final.
Qué es realmente FLUX 3 Action
Primero aclaro los nombres, porque confunden a mucha gente. FLUX 3 es un único modelo fundacional multimodal de Black Forest Labs, el mismo laboratorio detrás de los modelos de imagen FLUX. Se entrena de forma conjunta con imagen, video y audio, y la empresa lo describe como "one multimodal model for Image, Video, Audio and Action-Prediction".
Action-Prediction es esa cuarta capacidad. Toma observaciones visuales más una instrucción de texto y predice resultados físicos como acciones de control de robots. Así que "FLUX 3 Action" no es un producto aparte que se descargue. Es una capacidad del backbone de FLUX 3, y la versión creada para robots reales, en alianza con mimic, se llama FLUX-mimic.
El enfoque que usa BFL es la parte interesante. En sus palabras, un modelo que puede tanto generar video como controlar robots "was never really only a content creation model. It is a model of how the world behaves, and content creation is one thing one can do with it." Es una afirmación grande, así que vale la pena ver por qué podría ser cierta.
Por qué un modelo de video puede manejar un robot
Este es el mecanismo, porque es toda la idea. Cuando entrenas un modelo para generar video realista, no tiene más remedio que aprender física. Si se equivoca con el peso de un objeto, con la forma en que una mano se cierra a su alrededor o con lo que pasa cuando dos cosas chocan, el video se ve obviamente falso. Aprender a renderizar el mundo con precisión es, en el fondo, aprender cómo se comporta el mundo.
BFL pone cifras reales a esto. La predicción de video representa más del 95 % del cómputo total de entrenamiento de FLUX 3. El audio, en comparación, es menos del 0,5 % de los tokens de un clip de 720p, porque una vez que entiendes el video, hacer coincidir el sonido con el movimiento de los labios y los impactos es comparativamente fácil. Las acciones siguen la misma forma: el estado de un robot es una señal de baja dimensión muy acoplada a lo que ve la cámara. Los fotogramas, el audio y las acciones son vistas parciales de una misma realidad física subyacente, así que una vez que el modelo ha aprendido esa realidad a partir del video, la predicción de acciones no es un salto nuevo.
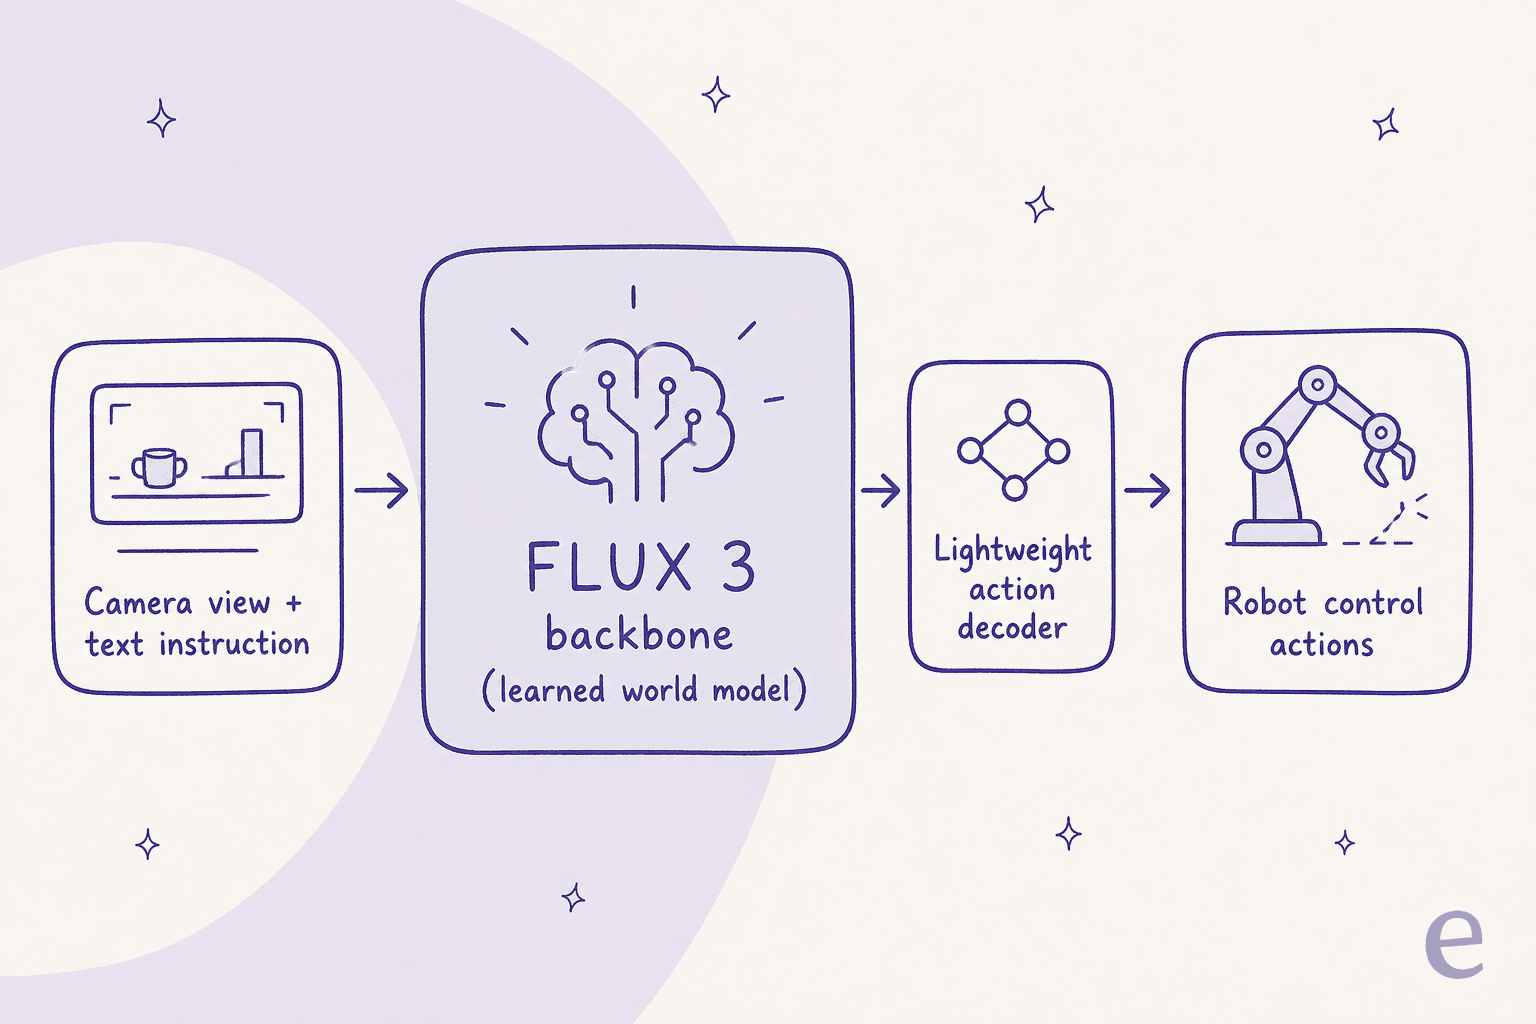
El pipeline es deliberadamente ligero. Una vista de cámara y una instrucción entran en el backbone de FLUX 3, que contiene el modelo de mundo aprendido. Un pequeño decodificador de acciones lee características intermedias directamente de la ruta de predicción de video y las convierte en acciones de control. La parte cara, entender el mundo, ya está hecha antes de que el robot se mueva. Es un enfoque distinto al de la mayoría de los modelos de visión-lenguaje-acción, que se entrenan de extremo a extremo para producir acciones en lugar de reutilizar un backbone generativo.
Lo que costó añadir acciones
Si las acciones realmente son otra vista del mismo mundo, enseñarle a FLUX 3 a predecirlas debería ser barato y no dañar lo que ya hace. Eso es exactamente lo que reporta BFL. Cuando añadieron la predicción de acciones a un entrenamiento grande, las valoraciones humanas de texto a video e imagen a video cayeron inicialmente hasta un 10 % mientras el modelo absorbía la nueva modalidad. Tras 3.500 pasos, la calidad de video volvió por completo a donde estaba, ahora con predicción de acciones encima.
Esa recuperación es la evidencia de la tesis de "un backbone, dos trabajos". El modelo no cambió de forma permanente calidad de video por control de robots. Solo tuvo que averiguar cómo la nueva modalidad se asignaba al mundo que ya conocía, y entonces la penalización desapareció. La investigación en la que se apoya se llama Self-Flow, que unifica la generación y el aprendizaje de representaciones para que mejorar una mejore la otra.
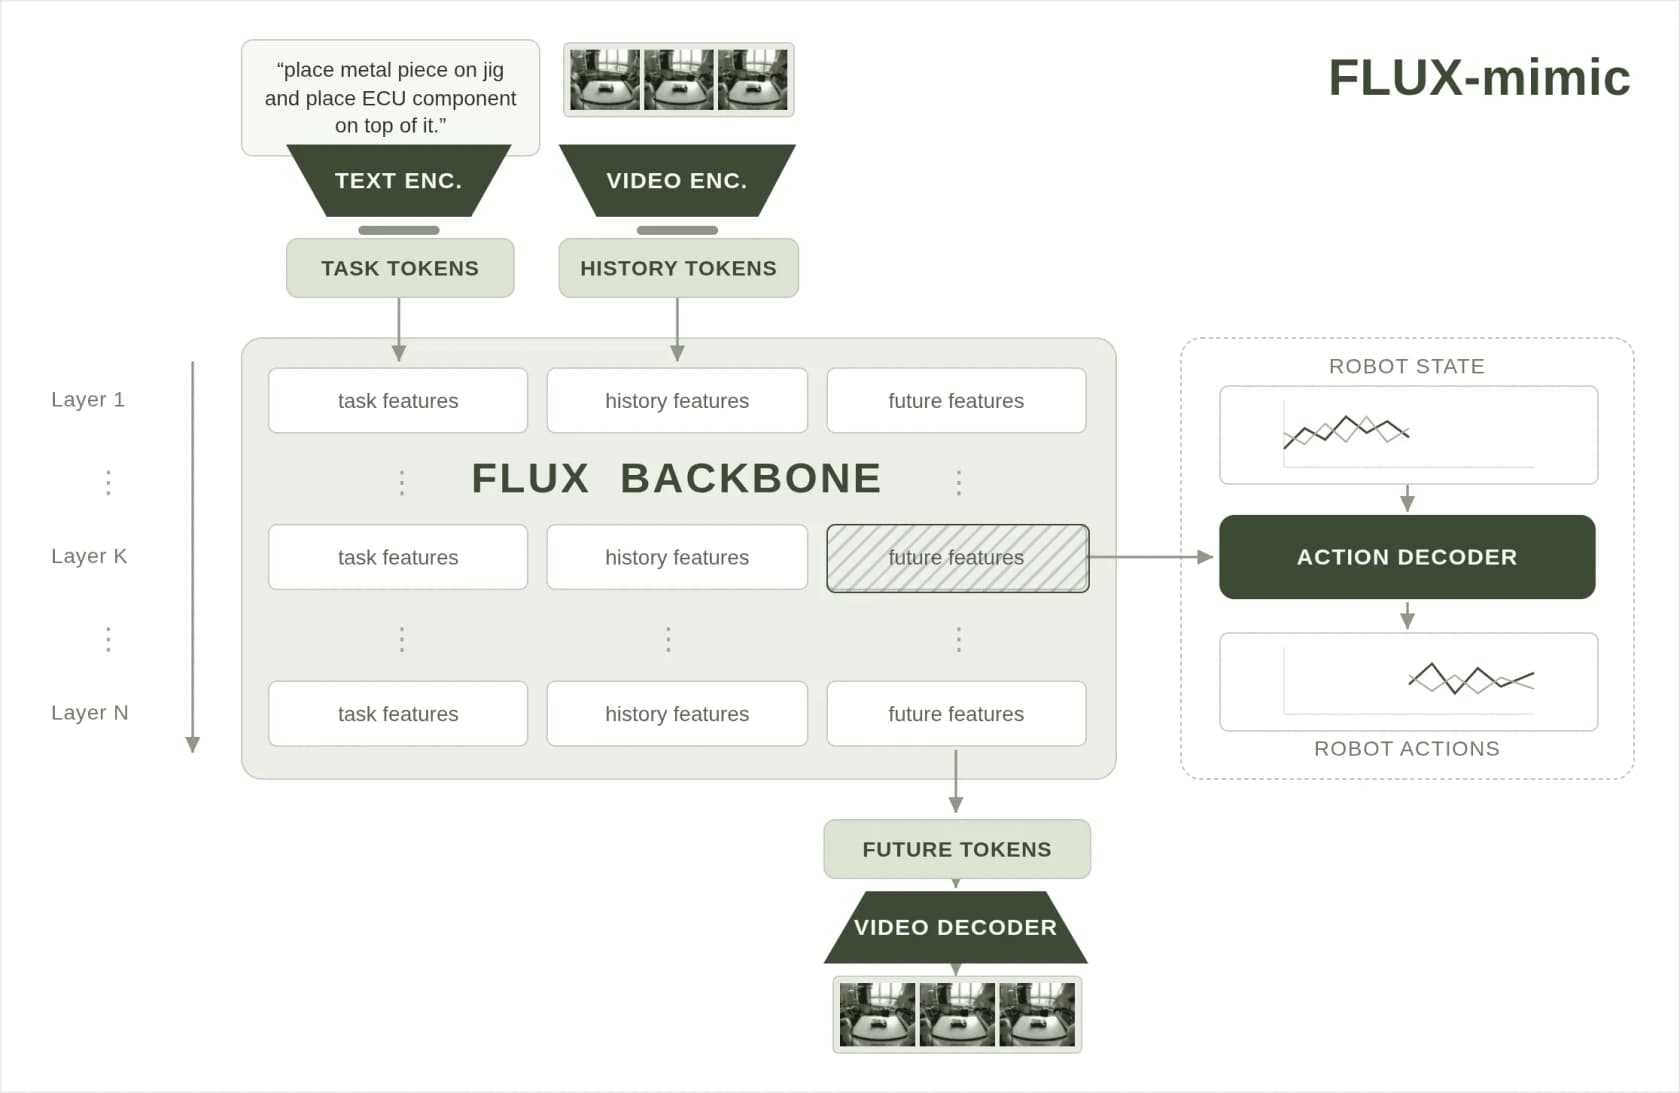
Puedes ver la división en el propio diagrama de arquitectura de BFL. Los codificadores de texto y video alimentan el backbone FLUX compartido, y las mismas capas producen características futuras de dos maneras: mediante un decodificador de video para generar fotogramas y mediante un decodificador de acciones ligero para producir acciones de robot. Un tronco, dos cabezas.
Qué muestran realmente los benchmarks
Aquí es donde FLUX 3 Action sorprende, así que quiero detenerme en las cifras en lugar de pasar de largo. En una tarea de kitting con objetos blandos (el tipo de manipulación de materiales flexibles con la que la automatización convencional siempre ha tenido problemas), BFL midió el éxito mediano en 20 ensayos autónomos por modelo.
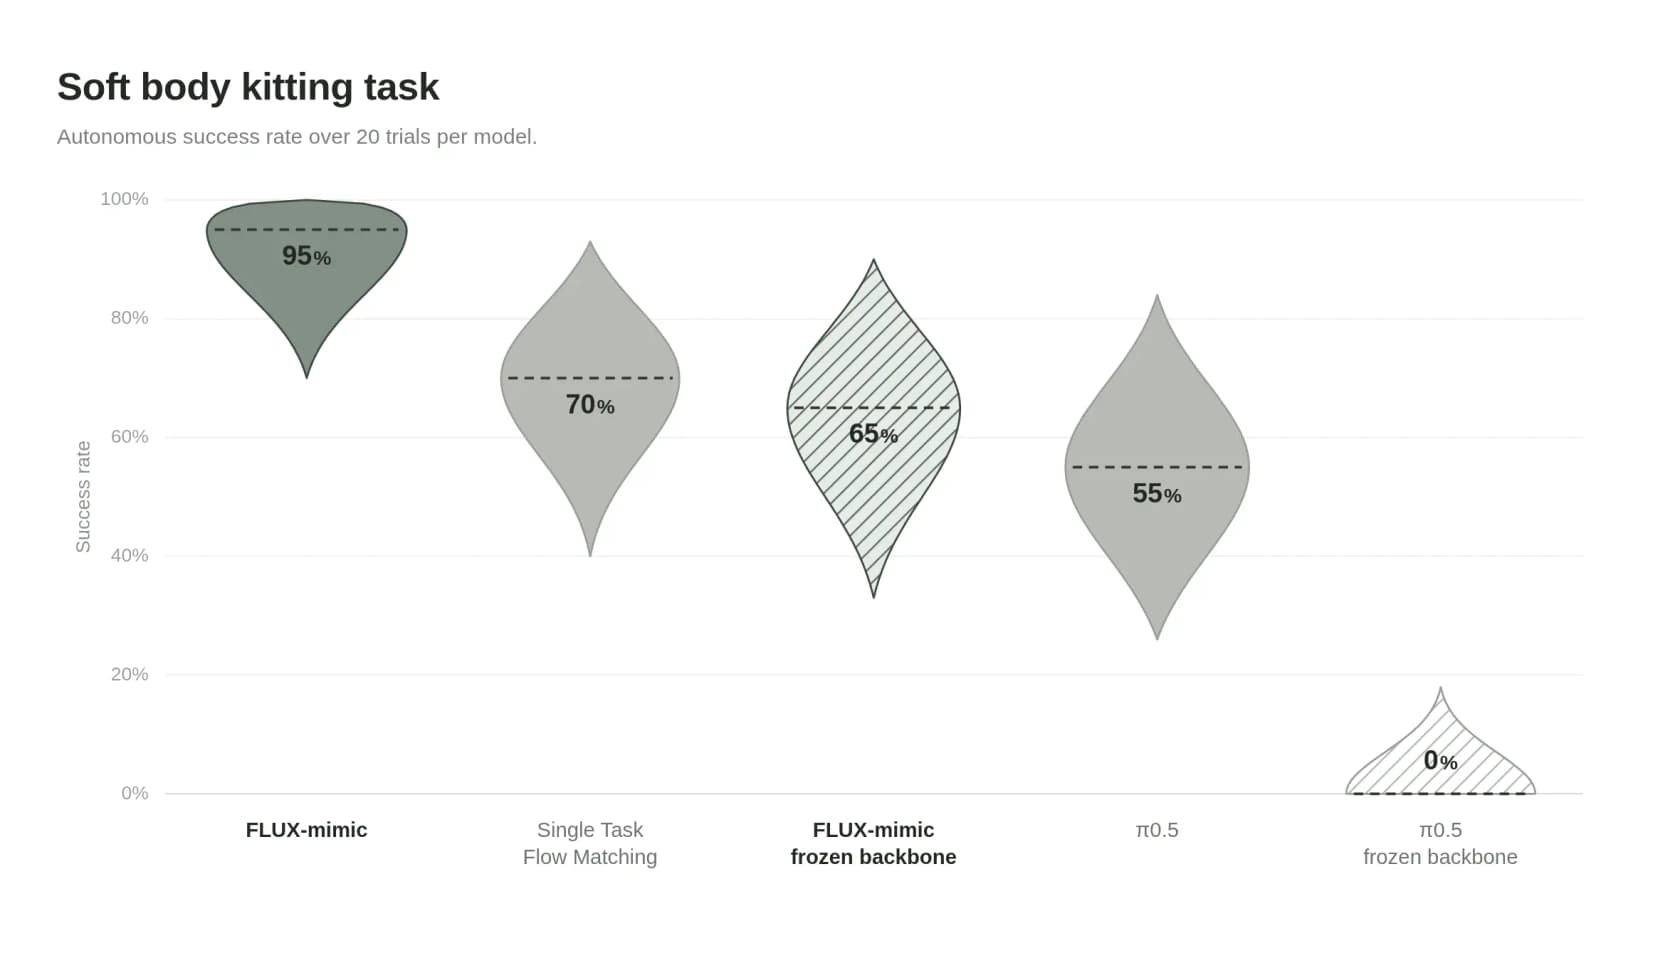
FLUX-mimic llegó a 95 %. Una línea base de flow matching de una sola tarea alcanzó 70 %, y π0.5, un modelo previo sólido de visión-lenguaje-acción, 55 %. Sin embargo, el número que más importa es la columna del backbone congelado. Cuando congelas el backbone de FLUX-mimic (sin ajuste fino, solo el modelo de mundo preentrenado con un decodificador encima), aún obtiene 65 %. Haz lo mismo con π0.5 y obtiene 0 %. En otras palabras, la representación preentrenada de FLUX 3 es lo bastante buena para manejar un robot con casi nada de entrenamiento específico de la tarea, algo que los modelos anteriores no podían afirmar.
Algunos hallazgos más que vale la pena destacar, porque se acumulan:
- Eficiencia de muestras. El trabajo de mimic-video reporta hasta 10 veces menos ejemplos que un modelo de visión-lenguaje-acción para alcanzar la misma capacidad, porque la física ya está en la representación.
- Autorrecuperación. Un robot que falla un agarre se corrige y vuelve a intentarlo, aunque ninguna demostración mostró esa recuperación. Viene del modelo de mundo, no del conjunto de entrenamiento.
- Velocidad. El backbone va de la entrada de cámara a la representación del mundo en menos de 80 ms en una sola NVIDIA RTX 5090, y el bucle completo del robot de mimic reacciona en 101 ms, aproximadamente el tiempo de reacción visual humano.
El punto de la velocidad es sutil pero importante. Como mejores representaciones significan más capacidad por parámetro, BFL puede ejecutar un backbone más pequeño (y por tanto más rápido) y aun así alcanzar el nivel de precisión. En robótica, la latencia es la restricción que mata los despliegues, así que un backbone más pequeño que sigue el ritmo del mundo real importa más que la tasa de éxito bruta.
Del laboratorio a la planta de fábrica
Nada de esto importaría si solo funcionara en simulación, así que el despliegue en Audi es la prueba. Audi opera una de las redes de producción más automatizadas de la industria del automóvil, lo que significa que tiene una visión precisa de dónde se detienen aún los robots convencionales: piezas flexibles, manipulación fina y la diversidad de variantes de la producción premium, que hace demasiado caro reingeniar por caso las celdas de robots programadas a mano.
"In partnership with mimic, Audi has been testing and deploying FLUX-mimic. We have seen these robots solve complex soft-body manipulation work that would have been simply impossible with conventional robotics."
Las tareas que menciona BFL son concretas: colocar piezas en bandejas estructuradas, insertar unidades de control electrónicas en fijaciones ajustadas, ensamblar componentes y manipular materiales blandos y flexibles como juntas y cables. Esa última categoría es la que ha seguido siendo obstinadamente manual durante décadas, así que es una señal justa de dónde este enfoque demuestra su valor.
¿Puedes usar realmente FLUX 3 Action?
Este es el estado honesto, porque el entusiasmo supera a la disponibilidad. Black Forest Labs está lanzando FLUX 3 por fases, y la predicción de acciones no es algo que puedas comprar.
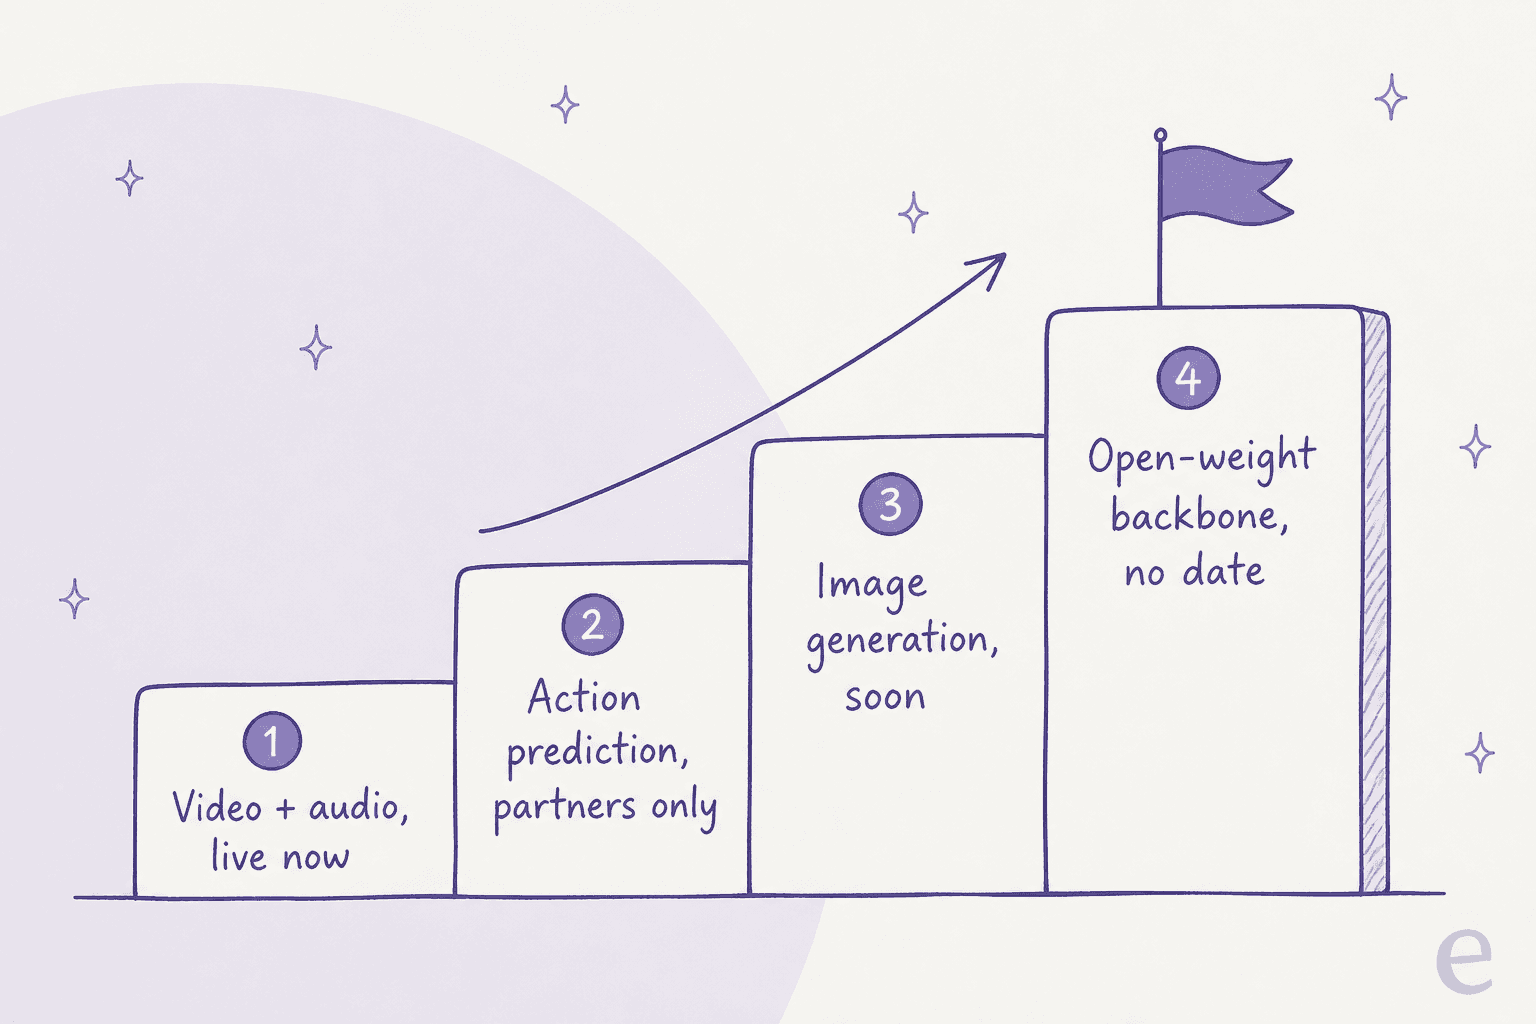
El orden de lanzamiento publicado por BFL es: primero generación y edición de video, luego predicción de acciones con socios seleccionados, después síntesis de imágenes y por último acceso de pesos abiertos al backbone. Hoy solo el video con audio está disponible de forma general. La predicción de acciones está limitada a socios (mimic tiene acceso anticipado), con sin API pública, sin precio publicado y sin pesos abiertos. La generación de imágenes de FLUX 3 sigue marcada como "soon", y el backbone de pesos abiertos no tiene fecha alguna.
Así que si quieres tocar FLUX 3 hoy, lo que realmente puedes pagar es video: texto a video, imagen a video y video a video de hasta 20 segundos, con audio sincronizado nativo, con precios de la API de BFL de pago por uso y sin suscripción. Para cualquier cosa relacionada con robots, estás viendo una vista previa de investigación y un programa de socios, no un producto. No es una crítica, es simplemente dónde está la frontera. La IA física pasa de socios seleccionados a disponibilidad general despacio y por buenas razones.
Infraestructura frente al compañero que realmente contratas
Quiero tomar perspectiva, porque "FLUX 3 Action" y frases como "agente de IA" se meten en el mismo saco, y pertenecen a estantes completamente distintos.
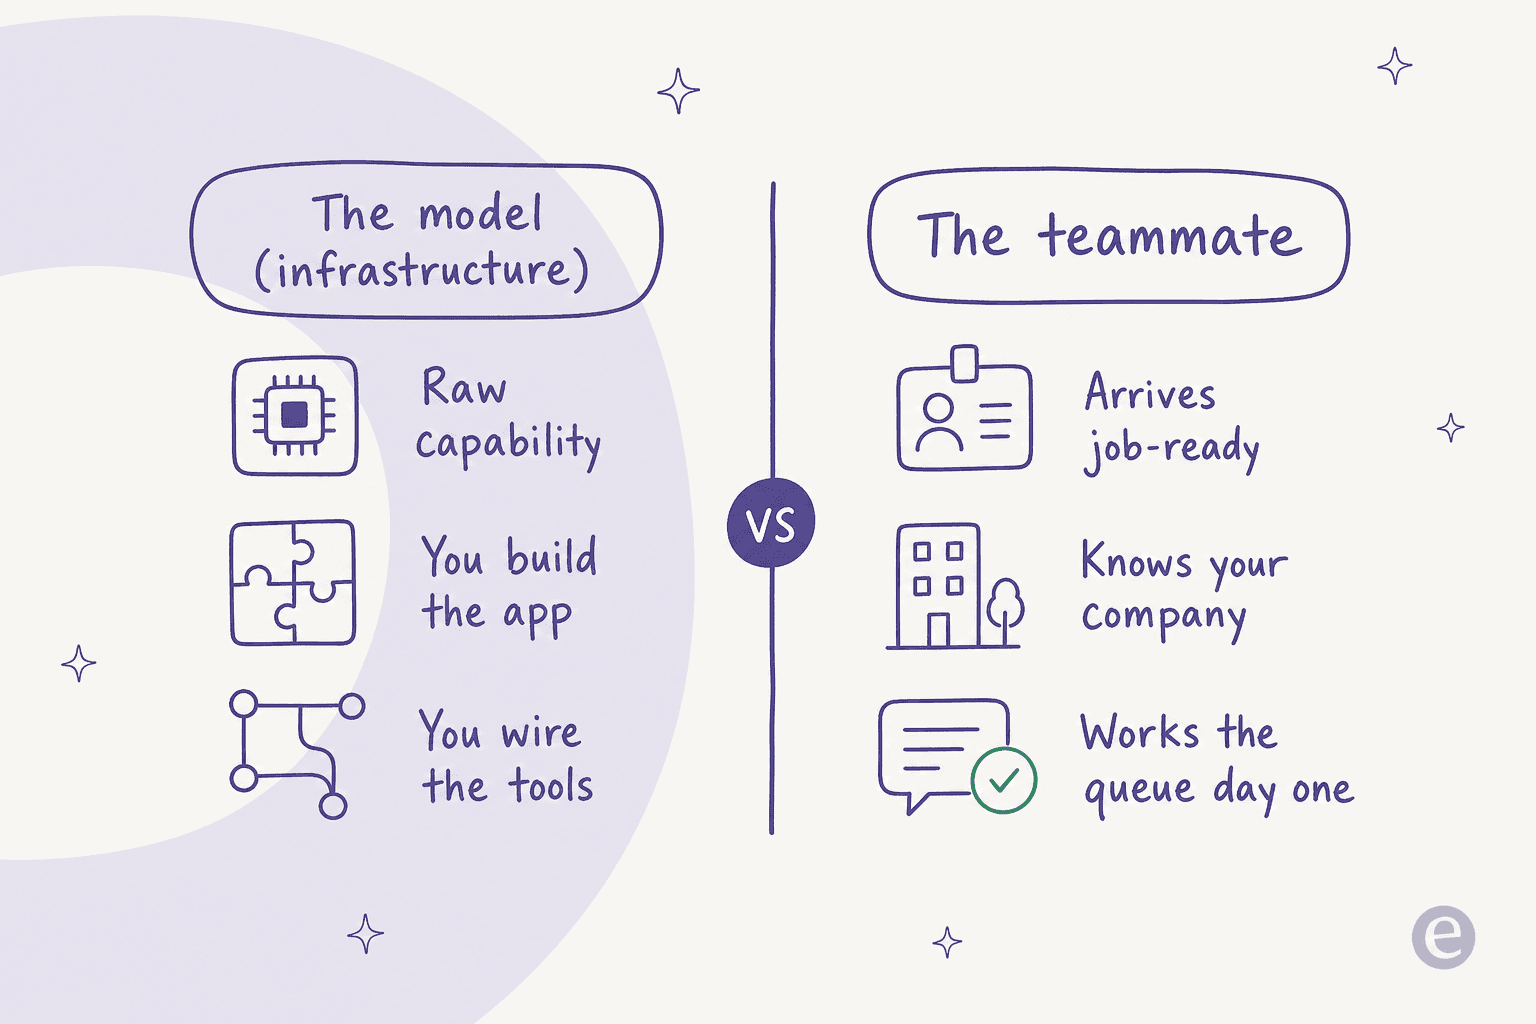
Un modelo fundacional como FLUX 3 es infraestructura. Es capacidad en bruto. Para sacarle valor construyes la aplicación, conectas las herramientas, te encargas del despliegue y (en este caso) lo acoplas a robots físicos. Esa es exactamente la forma adecuada para un laboratorio de robótica o un equipo de producción automotriz con ingenieros. Es la forma equivocada para un responsable de soporte que solo necesita que se respondan los tickets.
El otro estante es el compañero de IA: algo que llega listo para el trabajo, ya conoce tu empresa y empieza a trabajar el primer día. No construyes una app a su alrededor, lo orientas como a una persona nueva en el equipo. Esa es la capa en la que trabajo, y vale la pena dejar claro que un modelo no es un compañero, igual que un motor no es un coche. FLUX 3 Action es un motor notable para la IA física. Simplemente no es lo que contratas.
Cómo encaja esto con eesel
En eesel nos tomamos en serio el lado de "empleado, no infraestructura" de esa línea. eesel es una plataforma de compañeros de IA: en lugar de darte un modelo en bruto para construir encima, contratas compañeros listos para trabajar en tareas concretas. El equipo actual es un compañero de IA para helpdesk y un redactor de blog con IA, cada uno con las habilidades, integraciones y contexto de empresa que necesita su rol.
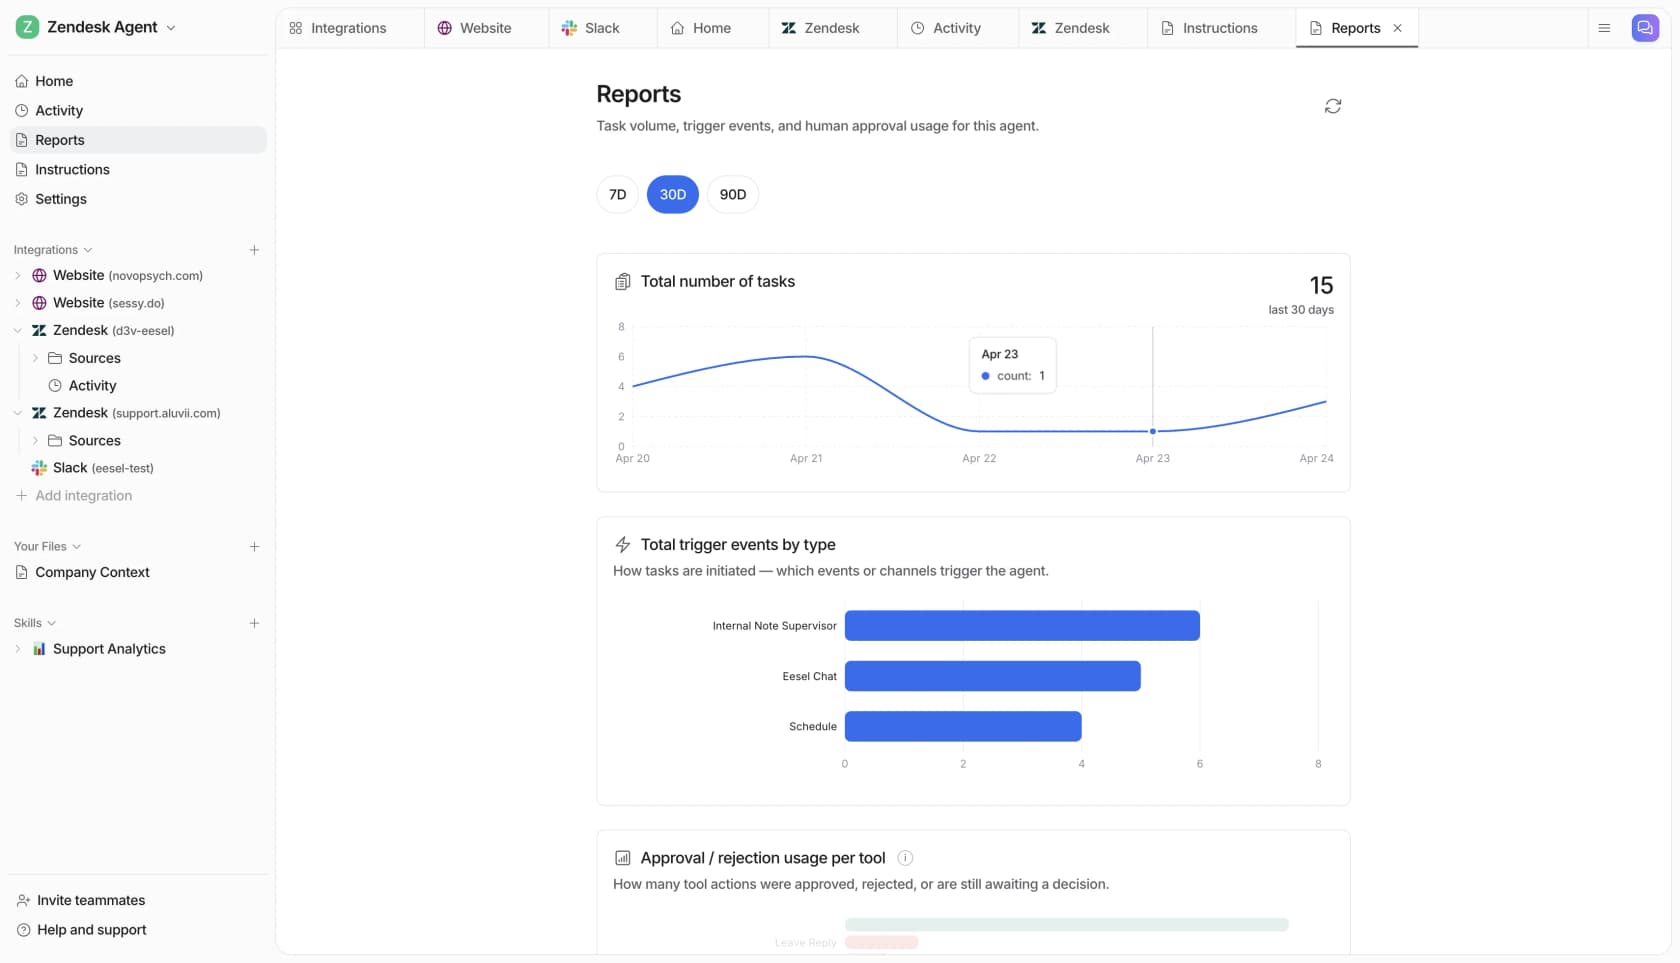
Como el modelo de debajo es un blanco móvil (FLUX hoy, otra cosa el próximo trimestre), la abstracción útil es el compañero, no la capacidad en bruto. El compañero de helpdesk aprende de tus tickets anteriores y tu centro de ayuda, redacta respuestas para revisión, y puedes simularlo con tus propios tickets históricos antes de que salga en vivo, porque he visto bots de tono seguro dar respuestas erróneas en silencio y prefiero detectarlo en un ensayo. Si te gusta trabajar desde la terminal, la CLI de eesel y su servidor MCP te permiten a ti (o a un agente de programación como Claude Code) configurar integraciones, subir conocimiento y aprobar acciones como JSON, de modo que el mismo compañero es programable sin el panel. No doblará tu ropa ni atenderá una línea de fábrica. Pero para atender a clientes y escribir contenido, es la contratación, no la infraestructura. Es gratis para probar.