

Jalapeño ist OpenAIs erster eigener KI-Chip, ein gemeinsam mit Broadcom entwickelter Inferenz-ASIC, der am 24. Juni 2026 angekündigt wurde. Er hat nur eine Aufgabe: große Sprachmodelle wie ChatGPT und Codex so schnell und günstig wie möglich auszuführen. Er trainiert keine Modelle, und du kannst ihn nicht kaufen.
In OpenAIs ersten veröffentlichten Benchmarks (25. August 2026) lieferte Jalapeño bei drei öffentlichen Modellen 1,5- bis 1,9-mal mehr KI-Leistung pro Watt und eine 1,7- bis 3,6-mal geringere Latenz als das Vergleichssystem Nvidia GB200. OpenAI plant, ihn bis Ende 2026 in den eigenen Rechenzentren einzusetzen, als ersten Schritt einer Roadmap über mehrere Generationen, die an einen Ausbau von 10 GW mit Broadcom gekoppelt ist.
Wenn du nicht OpenAI bist, ist die Pointe einfach: Das ist die Technik unter den Modellen, und günstigere Technik bedeutet günstigere KI. Dieselbe Kraft macht einen KI-Agenten im großen Maßstab günstiger als einen menschlichen Agenten. Tools wie eesel laufen auf diesen Modellen und erledigen echte Arbeit. Wird der Chip darunter effizienter, verbessert sich also die Wirtschaftlichkeit von KI-Support und Automatisierung, ohne dass du etwas tun musst.
Was OpenAI tatsächlich angekündigt hat
Ich baue beruflich KI-Agenten und lese Chip-Ankündigungen deshalb mit einer einzigen Frage: Ändert das, was die Modelle darüber leisten können oder was sie im Betrieb kosten? Jalapeño gehört klar zur zweiten Sorte, und zwar zu einer großen.
Am 24. Juni 2026 haben OpenAI und Broadcom Jalapeño vorgestellt, OpenAIs ersten eigenen Chip aus Eigenentwicklung. Der Name ist ein Witz über Hitze und Tempo; entscheidend ist, dass OpenAI seine Rechenleistung nicht mehr komplett von anderen mietet. Das Unternehmen hat sein eigenes Silizium entworfen, berichtete TechCrunch, und laut Bloomberg hatte es bereits die ersten physischen Muster erhalten und testete sie.
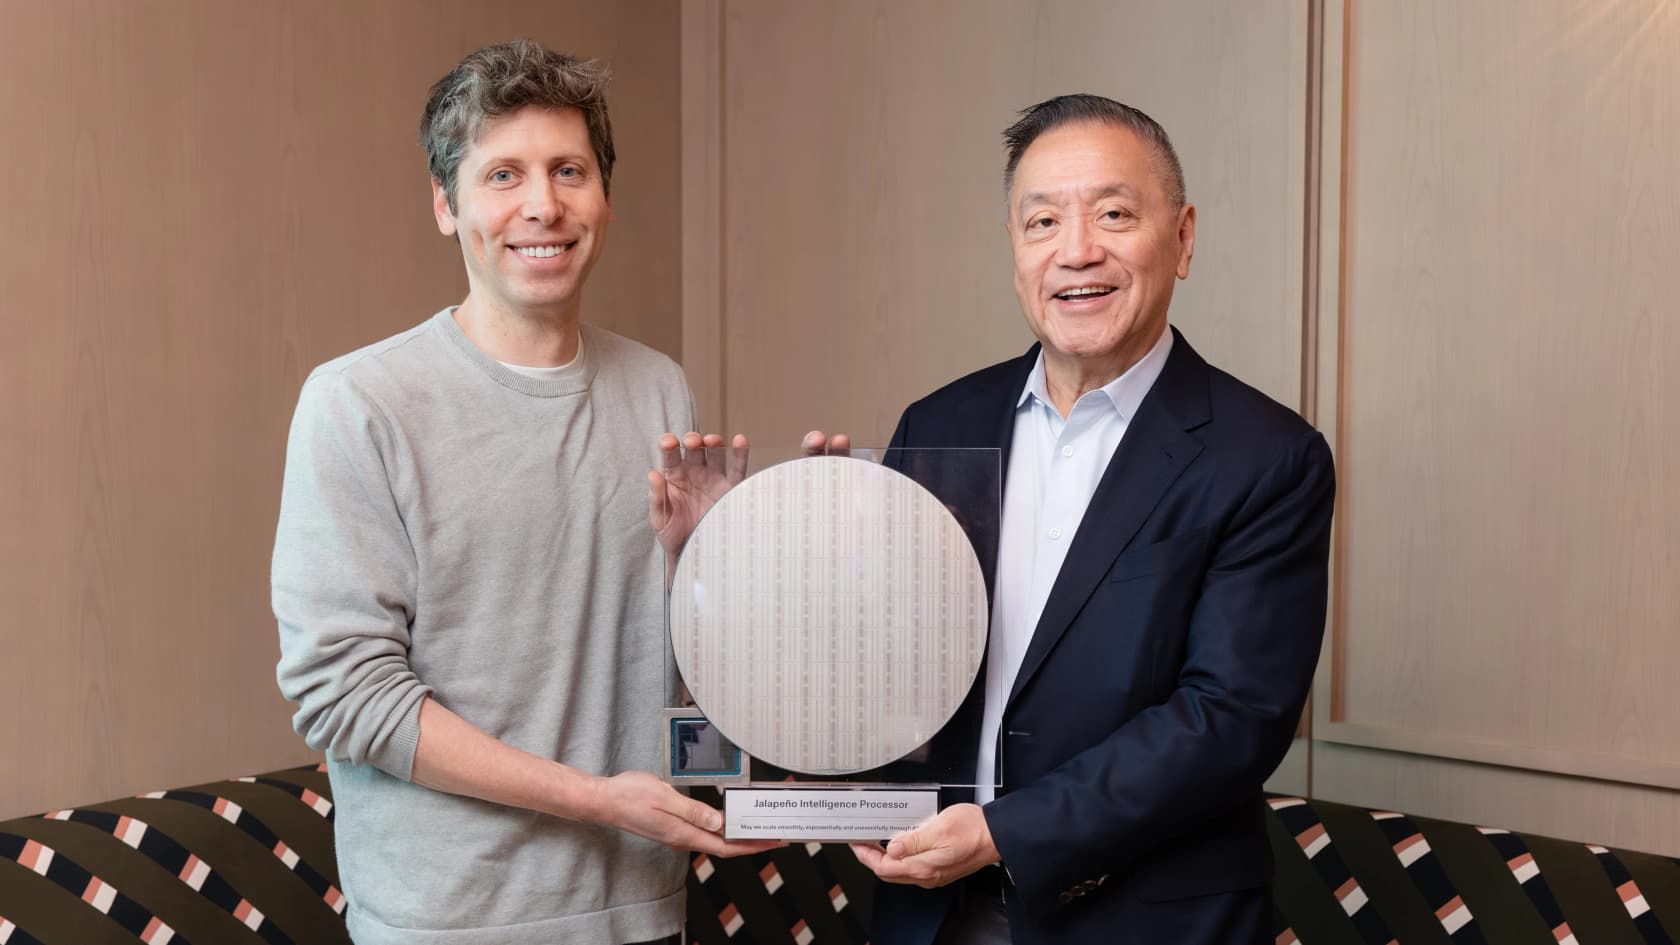
Die Größenordnung ist die Schlagzeile, die die meisten übersehen haben. Dieser Chip ist ein Baustein einer Partnerschaft, um in den nächsten Jahren 10 GW an von OpenAI entworfenen Beschleunigern bereitzustellen. OpenAI sieht das als Teil seines umfassenderen "Full-Stack"-Plans, alles selbst in der Hand zu haben: Modelle, Produkte, Serving-Software, Chips, Speicher und Netzwerk. Mit Jalapeño wird dieser Plan von einer Folie zu funktionierendem Silizium.
Was Jalapeño ist und was nicht
Ein paar Unterscheidungen sind wichtig, denn aus „OpenAI hat einen Chip gebaut“ wird schnell „OpenAI kämpft gegen Nvidia“, und das verfehlt den Kern.
Jalapeño ist ein ASIC, ein anwendungsspezifischer Chip. Eine Nvidia-GPU ist ein flexibler Allzweckprozessor, der Modelle trainieren, Grafik berechnen und Inferenz ausliefern kann. Ein ASIC erledigt dagegen eine enge Aufgabe extrem gut und sonst nichts. Jalapeños einzige Aufgabe ist die Inferenz, also die Auslieferungsseite, auf der ein trainiertes Modell deinen Prompt liest und eine Antwort erzeugt. Modelle trainiert er nicht. Dafür nutzt OpenAI weiterhin Nvidia und andere Partner.
Und du kannst ihn nicht kaufen. Jalapeño ist kein Produkt; er läuft in OpenAIs eigener Infrastruktur, um ChatGPT, Codex, die API und agentische Produkte auszuliefern. Für alle anderen zeigt sich der Chip indirekt, als schnellere und günstigere OpenAI-Modelle, nicht als Hardware im eigenen Rack. Wenn du die Variante dieser Geschichte mit spezialisierter Inferenz-Hardware suchst, die du tatsächlich mieten kannst: Diesen Markt gibt es bereits, etwa bei Plattformen wie Baseten.
Fairerweise noch etwas: Das ging schnell. OpenAI sagt, es habe den Weg vom Design bis zum Tapeout in neun Monaten geschafft. Das ist für eigene Chips schnell und zeigt, wie viel Know-how und Geld der Branche inzwischen auf die Inferenzkosten gerichtet ist.
Die Benchmark-Zahlen
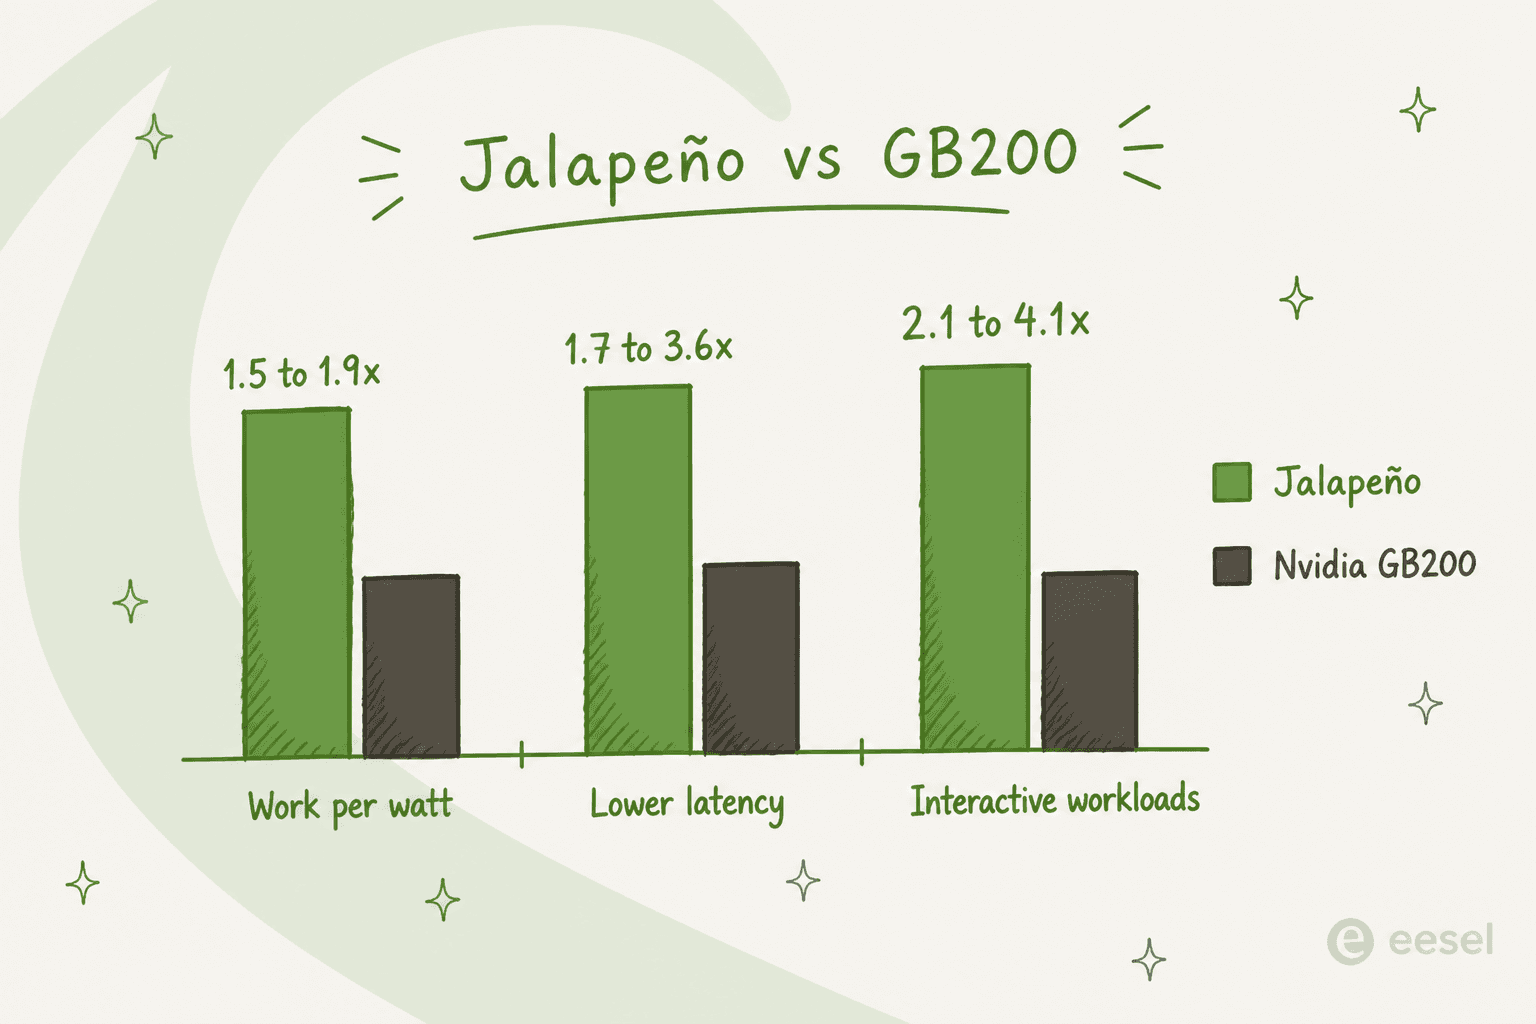
Am 25. August 2026 hat OpenAI Jalapeños erste Ergebnisse veröffentlicht, und diese Zahlen sind der Grund, warum über die Ankündigung gesprochen wurde.
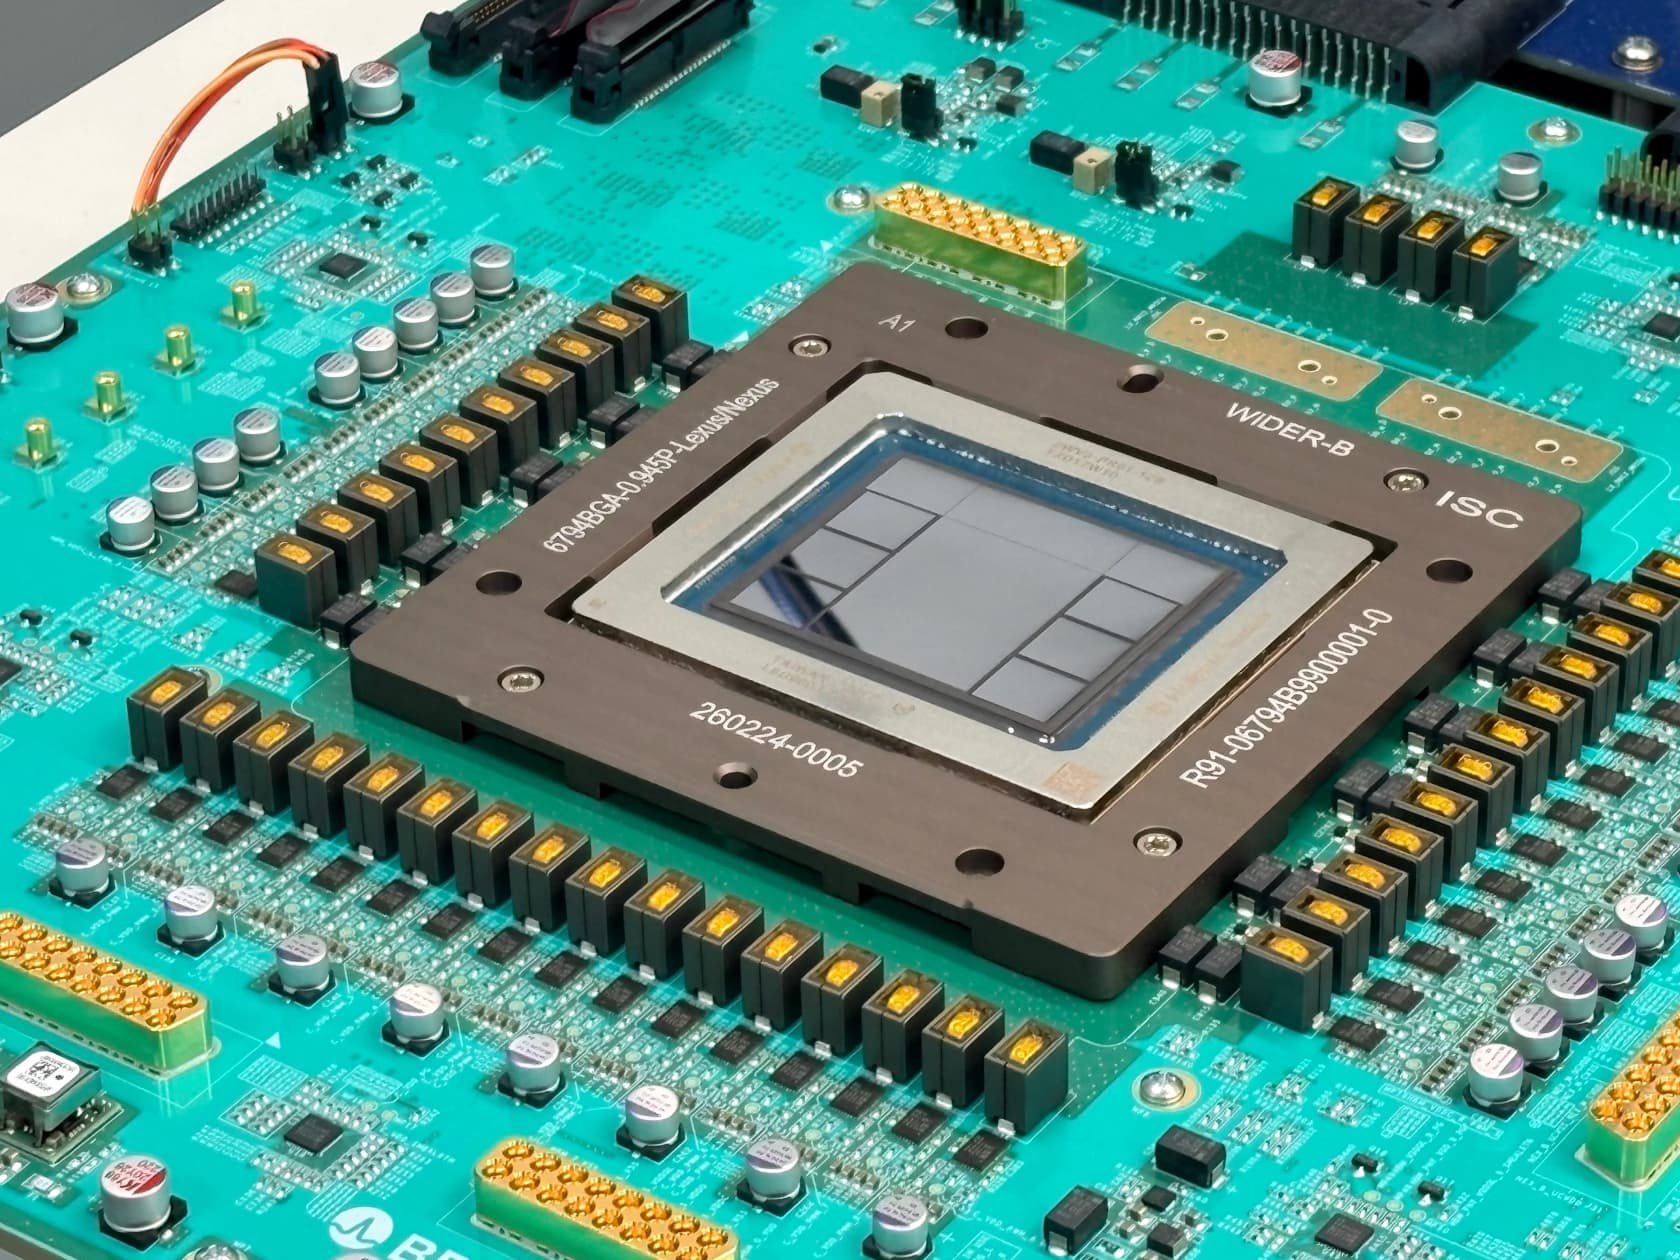
Getestet mit drei öffentlichen Modellen, GPT-OSS 120B, DeepSeek R1 670B und Kimi K2.5 1T, meldete OpenAI für Jalapeño:
- 1,5- bis 1,9-mal mehr KI-Leistung pro Watt bei maximalem Durchsatz
- 1,7- bis 3,6-mal geringere End-to-End-Latenz
- 2,1- bis 4,1-mal höhere Leistung bei hochinteraktiven Workloads
Der Vergleichschip in OpenAIs eigenen Diagrammen ist der Nvidia GB200 mit 1.200 Watt gegenüber 700 Watt bei Jalapeño. OpenAI betont immer wieder, dass ein einziges Design sowohl höheren Durchsatz als auch geringere Latenz erreicht, während bestehende Hardware meist einen Kompromiss zwischen beidem erzwingt.
Die unabhängige Einschätzung kommt von SemiAnalysis, dessen InferenceX-Benchmark OpenAI verwendet hat. Ihr Urteil war schon in der Überschrift deutlich, „Better Than Nvidia Blackwell“, mit Verweis darauf, dass Jalapeño fast 700 Tokens pro Sekunde und Nutzer erreicht und bei gleichem Interaktivitätsziel mehr als das 9-Fache des nächstbesten Chips. Eines sollte man im Hinterkopf behalten, dazu komme ich unten: SemiAnalysis gehört der Benchmark, den OpenAI sich ausgesucht hat.
Der interessanteste Teil: Der Chip hat sich selbst entworfen
Das ist das Detail, das ich auf die Titelseite setzen würde und das OpenAI fast vergraben hat. Dass Silizium in neun Monaten überhaupt möglich war, liegt daran, dass OpenAI seine eigenen Modelle zum Entwurf des Chips eingesetzt hat.
Frühere Modelle halfen beim Hochfahren des Chips; neuere optimieren und programmieren ihn. Mit Codex und GPT-Astra brachte das Team drei Open-Weight-Modelle, die nicht im ursprünglichen Plan standen, in zwei Monaten auf hohe Leistung. Bei ausgewählten Attention- und Mixture-of-Experts-Blöcken liefen KI-generierte Implementierungen 1,5- bis 1,8-mal schneller als die Versionen menschlicher Experten.
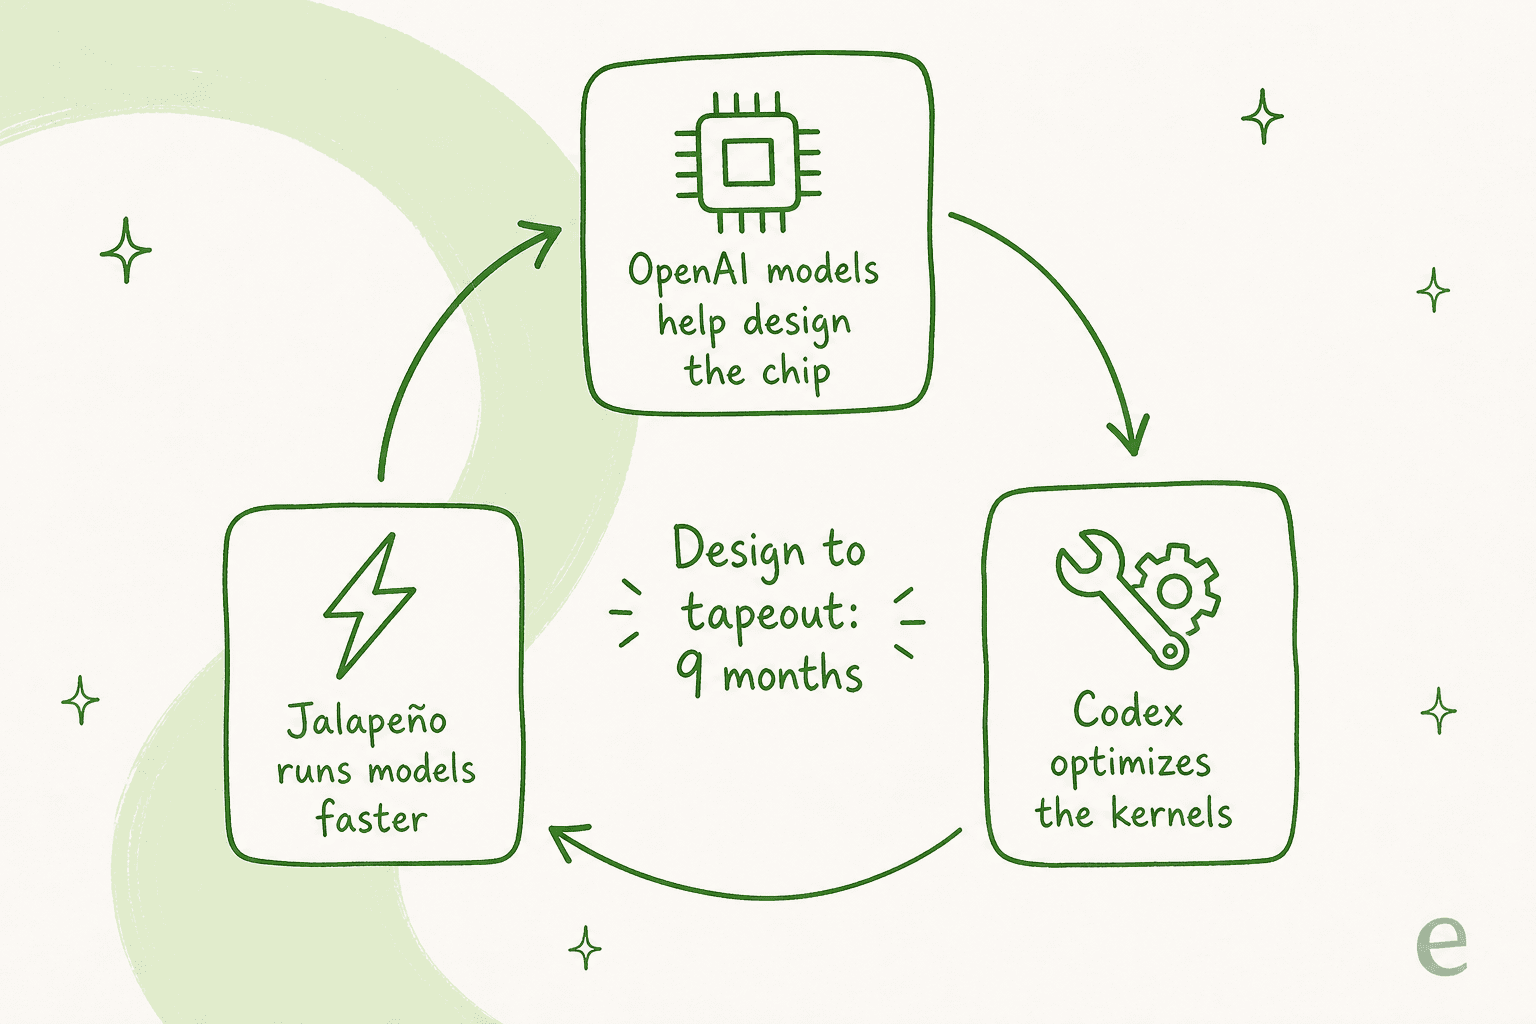
Das ist eine Schleife: Modelle helfen beim Entwurf des Siliziums, das Silizium führt die Modelle schneller aus, und die schnelleren Modelle helfen beim Entwurf des nächsten Siliziums. Gen 2 ist „deep in development“ und Gen 3 „taking shape“. Was auch immer du von den Benchmarks hältst: Diese Rückkopplung ist der Teil, der sich aufschaukelt, und es ist derselbe Grund, warum KI-Coding-Assistenten immer mehr mitreden, wenn echte Produkte gebaut werden.
Was die Community davon hielt
Die Reaktion war kein glatter Ehrenlauf, und die Skepsis ist fair genug, um sie hier aufzunehmen.
Die schärfste Kritik auf Hacker News war, dass dies kein Vergleich auf Augenhöhe ist:
"OpenAI's chip is targeting inference (FP8, FP4), while most of the chips it is being compared to are general purpose."

Ein speziell gebauter Inferenz-ASIC sollte eine Allzweck-GPU bei der Inferenz pro Watt schlagen. Das ist es, was Spezialisierung bringt: Der Gewinn ist real, aber auch ein Stück weit erwartbar. Andere verwiesen darauf, wer die Bewertung geschrieben hat:
"This semi-analysis article reads a lot more like an OpenAI press release than a real analysis."
Auf der Anlegerseite von Reddit ging es weniger um Tokens als um Margen: r/NVDA_Stock sah eigene Chips als schleichende statt als plötzliche Bedrohung für Nvidias Preismacht. Meine eigene Einschätzung liegt in der Mitte: Die Zahlen stimmen vermutlich in der Tendenz und gelten real für OpenAIs Workloads, und sie sind genau das, was man von einem spezialisierten Chip erwarten würde, der mit dem Test seines eigenen Entwicklers gemessen wird.
Warum eine Chip-Ankündigung wichtig ist, wenn du nicht OpenAI bist
Du wirst Jalapeño nicht installieren. Warum also interessieren? Weil die Inferenzkosten die stille Zahl unter jedem KI-Produkt sind, das du nutzt oder baust.
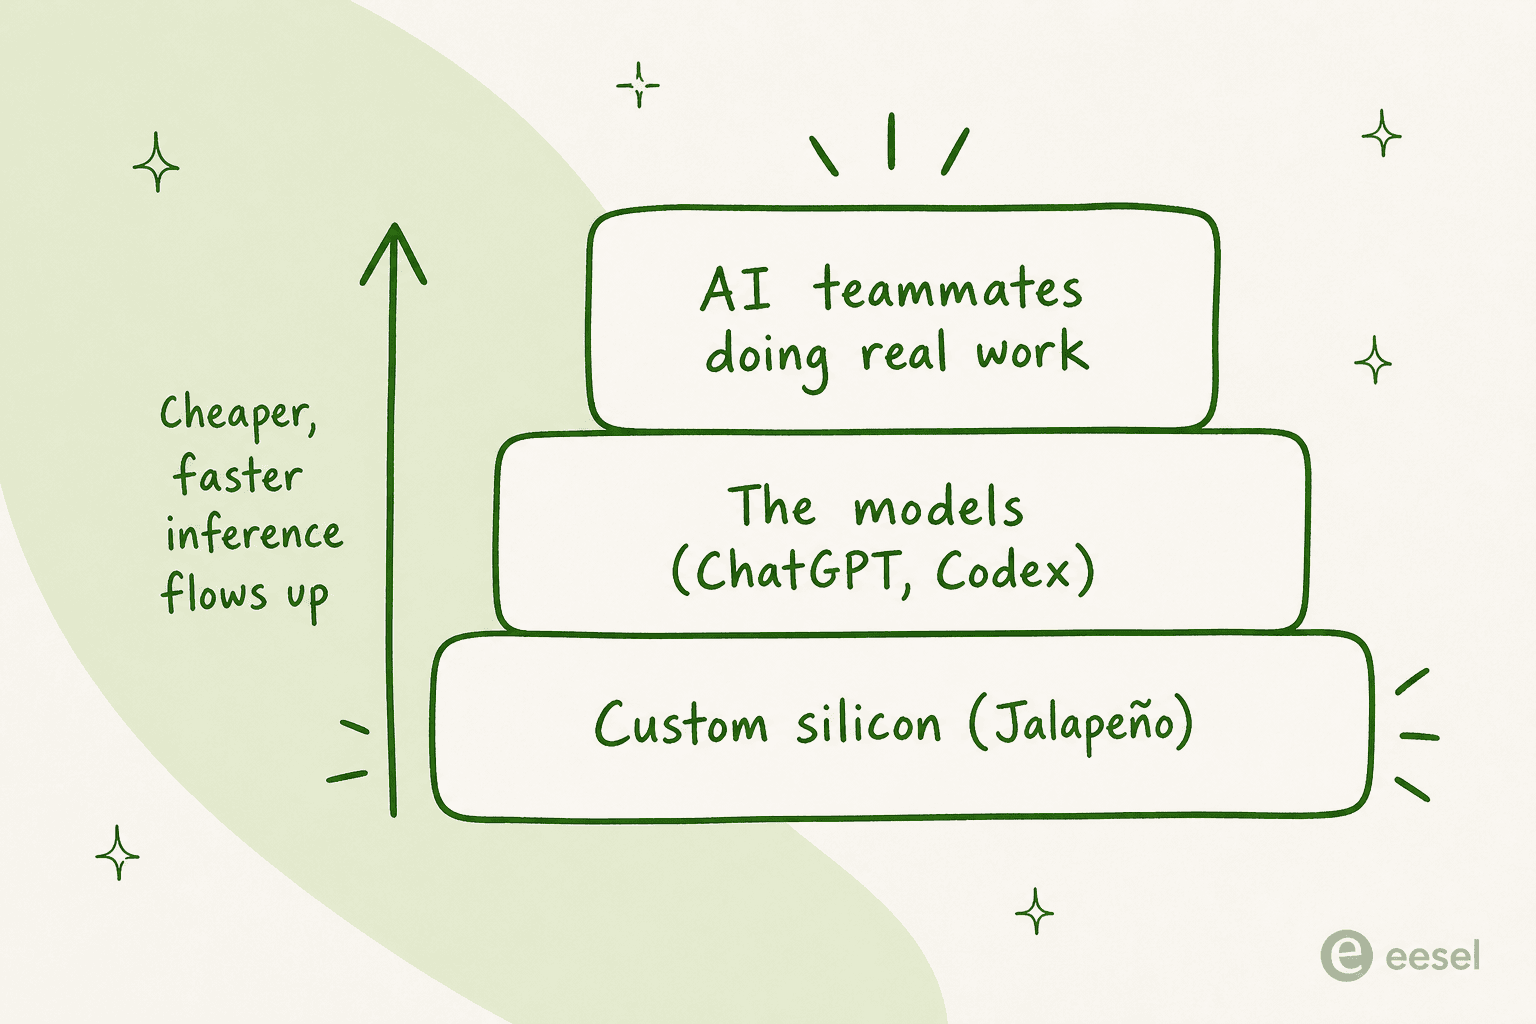
Jede KI-Support-Antwort, jede entworfene E-Mail, jeder KI-Agent, der eine Bestellung liest und einen Kunden beantwortet, ist ein Inferenzaufruf, dessen Betrieb echtes Geld kostet. Wenn OpenAI diese Kosten senkt, verbessert es zuerst die eigenen Margen, doch der Effekt wandert mit der Zeit den Stack hinauf, in günstigere API-Preise und Modelle, die pro Dollar mehr leisten. Das ist der Rückenwind, der KI-Support von der Demo zu einem Posten macht, der sich offensichtlich selbst bezahlt, dieselbe Rechnung wie hinter dem, was KI im Kundensupport tatsächlich einsparen kann.
Es ist auch eine Erinnerung daran, wo für die meisten Teams der eigentliche Hebel liegt. Du konkurrierst nicht dadurch, dass du Silizium besitzt; du konkurrierst, indem du die Modelle an deinen echten Problemen arbeiten lässt. Der Chip ist die Fabrikhalle. Der KI-Agent, der deine Tickets bearbeitet, ist der Mitarbeiter, und den Mitarbeiter darfst du einstellen.
eesel ausprobieren
Jalapeño ist Infrastruktur, die Ebene unter den Modellen. eesel ist die Ebene darüber, der Teil, den du tatsächlich einsetzt. Es ist eine Plattform für KI-Teammitglieder: Du stellst einsatzbereite Teammitglieder für bestimmte Aufgaben ein, und das KI-Helpdesk-Teammitglied steigt in deine bestehende Zendesk-, Freshdesk- oder Gorgias-Warteschlange ein, lernt aus deinen früheren Tickets und deinem Help Center und beginnt, Antworten zu entwerfen oder zu senden.
Als Unterscheidungsmerkmal würde ich hervorheben, dass du ein Teammitglied anhand deiner historischen Tickets simulieren kannst, bevor es je einem echten Kunden antwortet. So siehst du vorab, wie es abschneiden wird, statt einen Schalter umzulegen und zu hoffen. Die Preise beginnen bei 299 $/Monat für 500 Credits (1 Credit pro Ticket oder Chat), ohne Gebühren pro Nutzer, und du kannst kostenlos mit 100 Credits starten. Günstigeres Silizium unter der Haube ist schön; ein Teammitglied, das du heute ausprobieren kannst, ist der Teil, der deine Woche verändert.