

FLUX 3 Action ist der Teil des neuen Foundation-Modells von Black Forest Labs, der physische Aktionen statt Pixel vorhersagt. Der Kniff: Es ist dasselbe Modell, das Videos erzeugt, nur anders decodiert. BFL argumentiert: Um überzeugende Videos zu erzeugen, muss ein Modell bereits lernen, wie sich die Welt verhält (Kontakt, Gewicht, Ursache und Wirkung). Den nächsten Zug eines Roboters vorherzusagen ist dann nur eine weitere Sicht auf dasselbe Verständnis.
Als FLUX-mimic mit mimic robotics produktisiert, wurde es bei Audi getestet und eingesetzt, bei Aufgaben, die konventionelle Roboter nie anfassen könnten, etwa Kabel und weiche Dichtungen. Die Kernzahl: Es erreichte eine mediane Erfolgsquote von 95 % bei einer Kommissionieraufgabe mit weichen Teilen und schlug frühere Robotermodelle sogar mit eingefrorenem Backbone, einem Setting, in dem das bisher beste Modell 0 % erreichte.
Der Haken für die meisten Leser: Du kannst FLUX 3 Action noch nicht nutzen. Es ist ausgewählten Partnern vorbehalten, ohne öffentliche API, Preis oder Gewichte. Wenn du einen KI-Agenten suchst, den du heute tatsächlich einsetzen kannst: FLUX 3 ist Infrastruktur für Roboter, keine Neueinstellung. Dieser Unterschied ist wichtig, und dort lande ich am Ende.
Was FLUX 3 Action eigentlich ist
Zuerst zur Benennung, denn sie verwirrt viele. FLUX 3 ist ein einziges multimodales Foundation-Modell von Black Forest Labs, dem Labor hinter den FLUX-Bildmodellen. Es wird gemeinsam über Bild, Video und Audio trainiert, und das Unternehmen beschreibt es als „one multimodal model for Image, Video, Audio and Action-Prediction".
Action-Prediction ist die vierte Fähigkeit. Sie nimmt visuelle Beobachtungen plus eine Textanweisung und sagt physische Ergebnisse als Robotersteuerbefehle voraus. „FLUX 3 Action" ist also kein separates Produkt zum Herunterladen. Es ist eine Fähigkeit des FLUX-3-Backbones, und die für echte Roboter gebaute Version, in Partnerschaft mit mimic, heißt FLUX-mimic.
Interessant ist die Rahmung von BFL. In ihren Worten war ein Modell, das sowohl Videos erzeugen als auch Roboter steuern kann, „was never really only a content creation model. It is a model of how the world behaves, and content creation is one thing one can do with it." Das ist eine große Behauptung, deshalb lohnt es sich zu prüfen, warum sie stimmen könnte.
Warum ein Videomodell einen Roboter steuern kann
Das ist der Mechanismus, und er ist die ganze Idee. Wenn du ein Modell trainierst, realistische Videos zu erzeugen, bleibt ihm nichts anderes übrig, als Physik zu lernen. Liegt es beim Gewicht eines Objekts falsch, bei der Art, wie sich eine Hand darum schließt, oder bei dem, was bei einer Kollision passiert, sieht das Video offensichtlich gefälscht aus. Die Welt akkurat zu rendern heißt also im Kern zu lernen, wie sich die Welt verhält.
BFL nennt dazu konkrete Zahlen. Videovorhersage macht über 95 % der gesamten Trainingsrechenleistung von FLUX 3 aus. Audio dagegen macht weniger als 0,5 % der Tokens eines 720p-Clips aus, weil es vergleichsweise einfach ist, Ton zu Lippenbewegungen und Aufprällen zu passen, sobald man Video versteht. Aktionen haben dieselbe Form: Der Zustand eines Roboters ist ein niedrigdimensionales Signal, eng gekoppelt an das, was die Kamera sieht. Bilder, Audio und Aktionen sind alle Teilansichten einer zugrunde liegenden physischen Realität. Hat das Modell diese Realität aus Video gelernt, ist die Aktionsvorhersage kein Neuanfang.
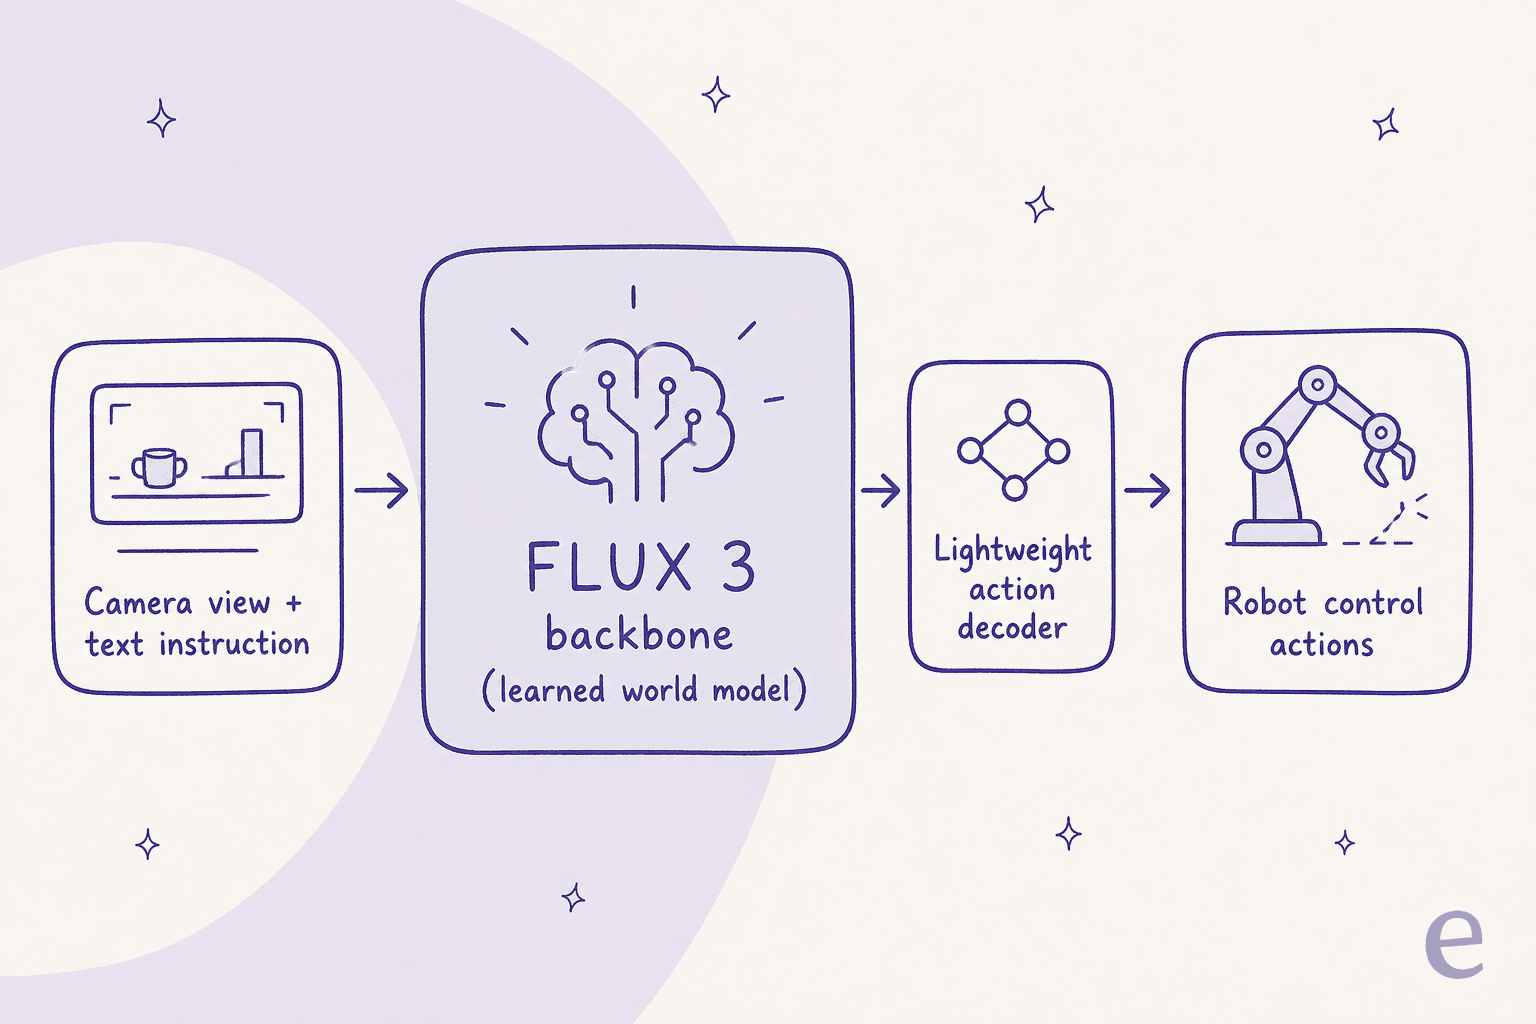
Die Pipeline ist bewusst schlank. Eine Kameraansicht und eine Anweisung gehen in das FLUX-3-Backbone, das das gelernte Weltmodell enthält. Ein kleiner Aktions-Decoder liest Zwischenfeatures direkt aus dem Videovorhersagepfad und macht daraus Steuerbefehle. Der teure Teil, die Welt zu verstehen, ist erledigt, bevor sich der Roboter überhaupt bewegt. Das unterscheidet sich von den meisten Vision-Language-Action-Modellen, die Ende-zu-Ende darauf trainiert werden, Aktionen auszugeben, statt ein generatives Backbone wiederzuverwenden.
Was es kostete, Aktionen hinzuzufügen
Wenn Aktionen wirklich nur eine weitere Sicht auf dieselbe Welt sind, sollte es günstig sein, FLUX 3 beizubringen, sie vorherzusagen, ohne dabei zu schaden, was es schon kann. Genau das berichtet BFL. Als sie einem großen Trainingslauf die Aktionsvorhersage hinzufügten, fielen die menschlichen Bewertungen für Text-zu-Video und Bild-zu-Video zunächst um bis zu 10 %, während das Modell die neue Modalität aufnahm. Nach 3.500 Schritten war die Videoqualität vollständig auf dem Ausgangsniveau zurück, nun mit Aktionsvorhersage obendrauf.
Diese Erholung ist der Beleg für die These „ein Backbone, zwei Aufgaben". Das Modell hat Videoqualität nicht dauerhaft gegen Robotersteuerung eingetauscht. Es musste nur herausfinden, wie die neue Modalität auf die schon bekannte Welt abgebildet wird, dann verschwand der Abschlag. Die zugrunde liegende Forschung heißt Self-Flow und vereint Generierung und Repräsentationslernen, sodass die Verbesserung des einen das andere verbessert.
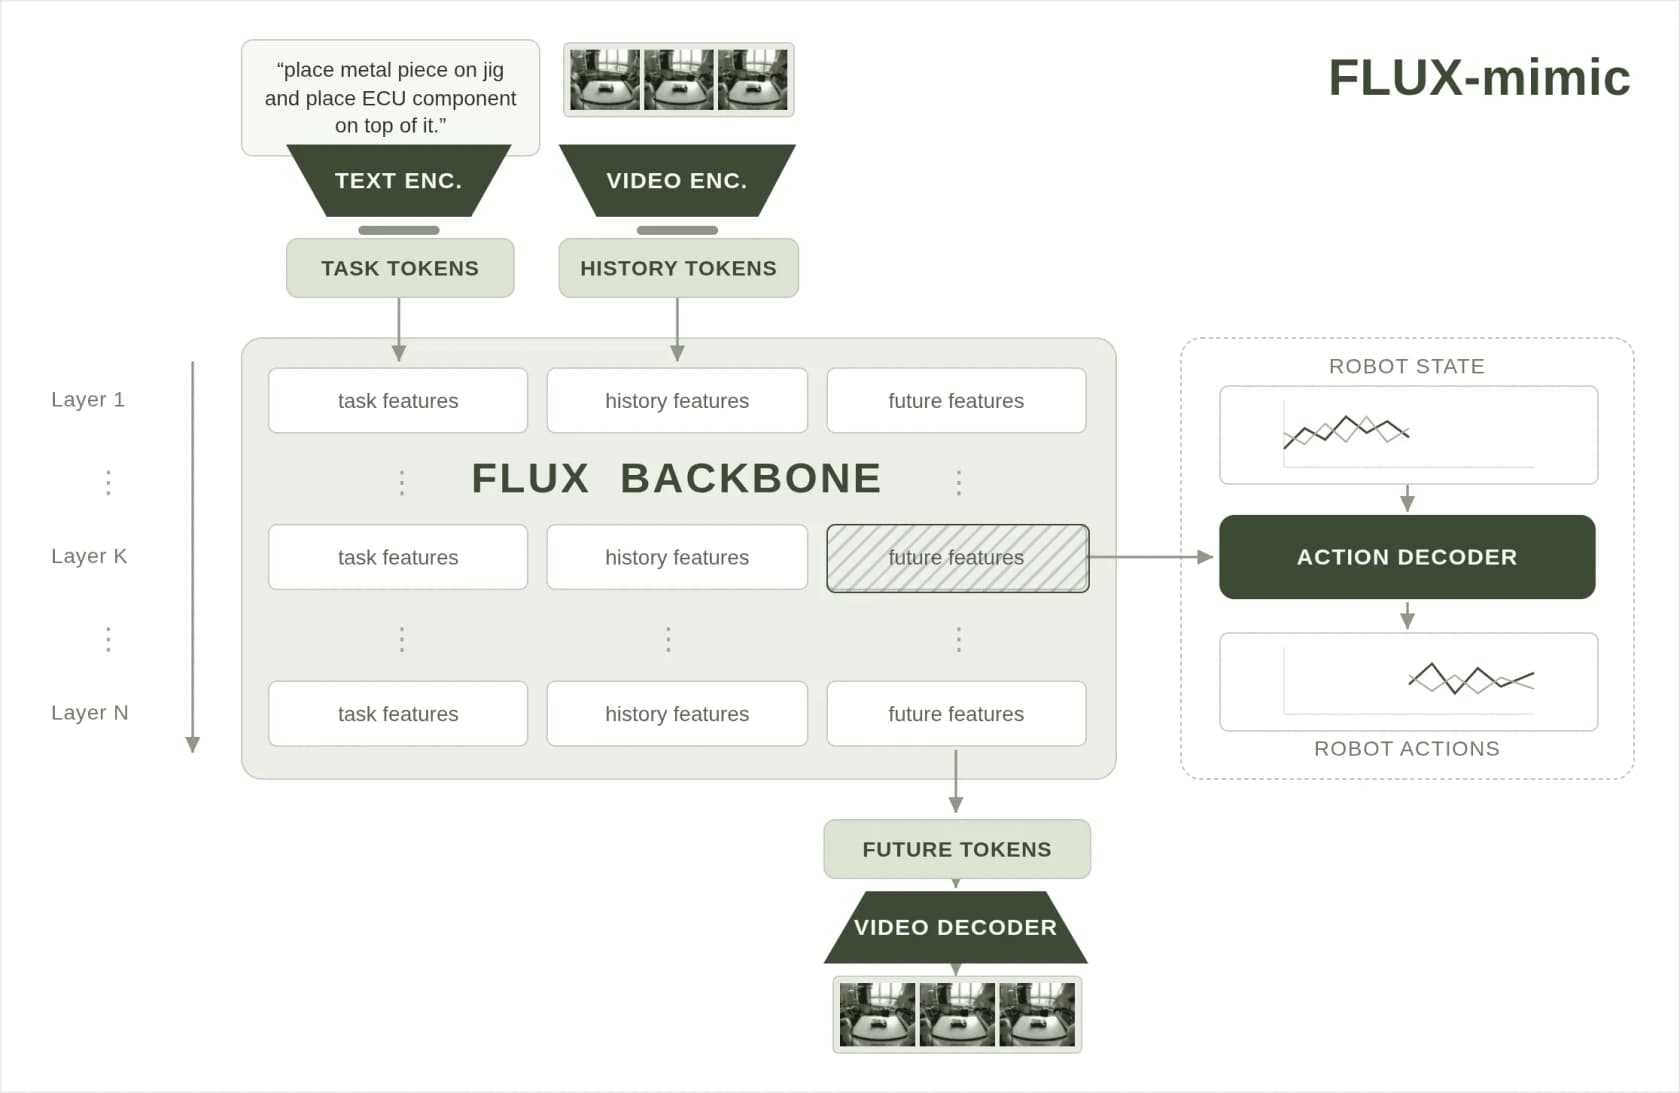
Die Aufteilung sieht man im Architekturdiagramm von BFL. Text- und Video-Encoder speisen das gemeinsame FLUX-Backbone, und dieselben Schichten erzeugen zukünftige Features auf zwei Wegen: über einen Video-Decoder, um Frames zu erzeugen, und über einen schlanken Aktions-Decoder, um Roboteraktionen auszugeben. Ein Stamm, zwei Köpfe.
Was die Benchmarks tatsächlich zeigen
Hier wird FLUX 3 Action überraschend, deshalb möchte ich bei den Zahlen verweilen, statt nur darauf zu zeigen. Bei einer Kommissionieraufgabe mit weichen Teilen (die Art Handhabung flexibler Materialien, mit der sich konventionelle Automatisierung immer schwergetan hat) maß BFL den Median der Erfolgsquote über 20 autonome Versuche pro Modell.
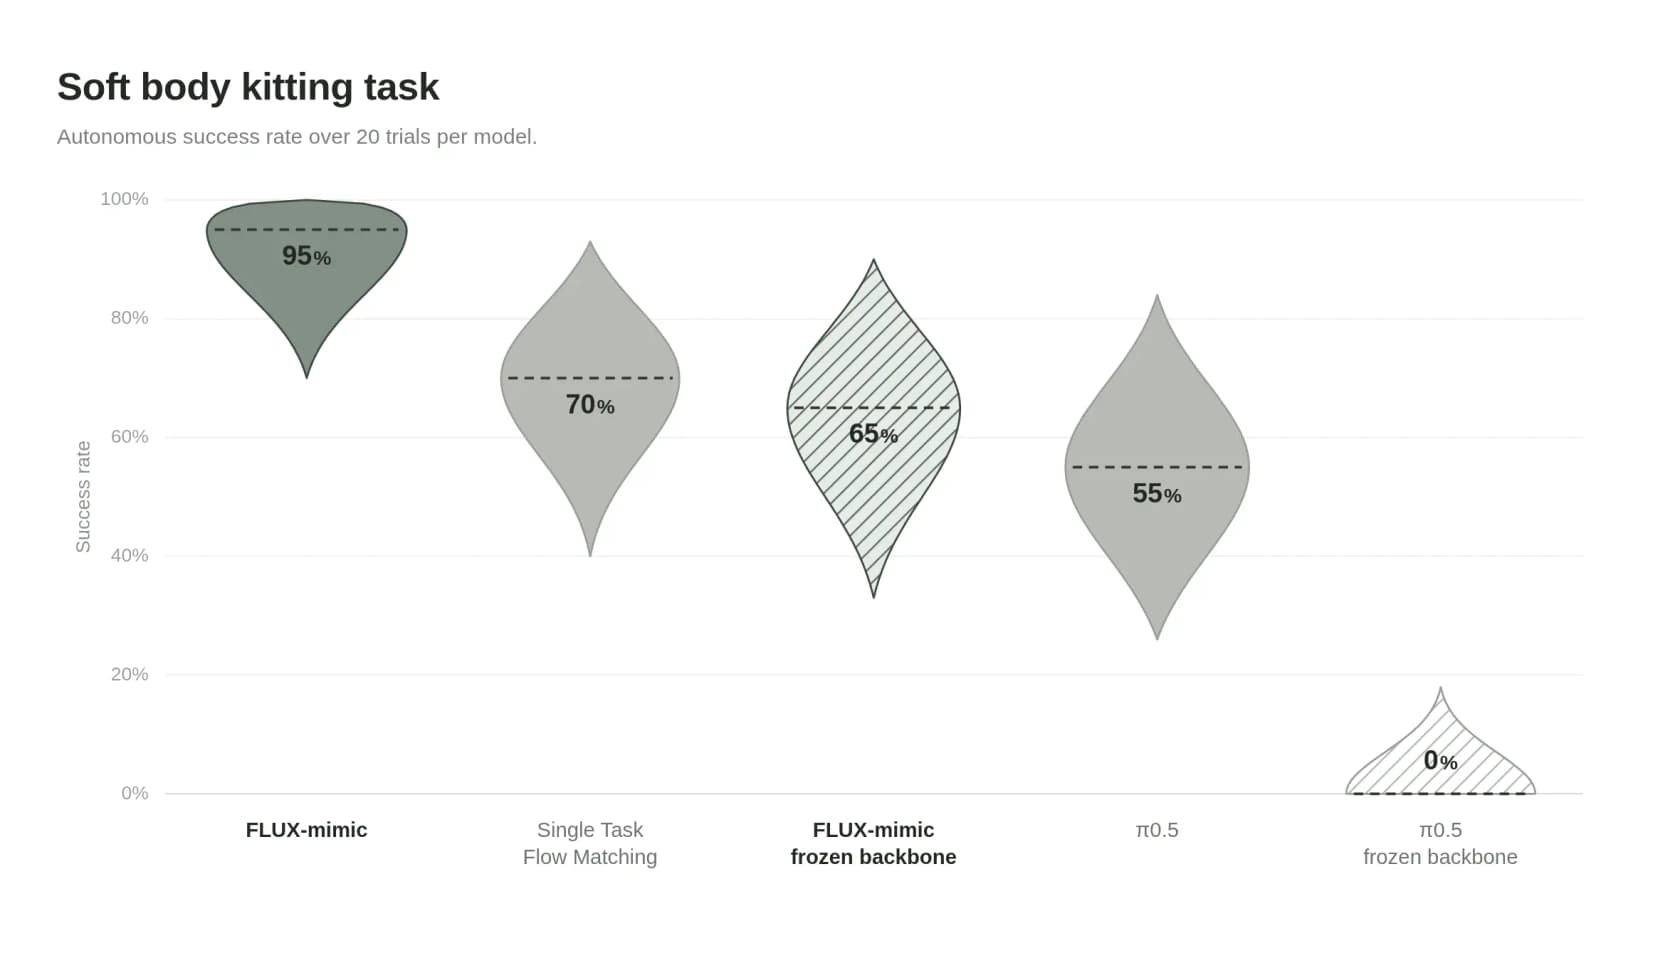
FLUX-mimic landete bei 95 %. Eine Single-Task-Flow-Matching-Baseline kam auf 70 %, und π0.5, ein starkes früheres Vision-Language-Action-Modell, auf 55 %. Am wichtigsten ist jedoch die Spalte mit eingefrorenem Backbone. Friert man das Backbone von FLUX-mimic ein (kein Fine-Tuning, nur das vortrainierte Weltmodell mit einem Decoder obendrauf), erreicht es immer noch 65 %. Macht man dasselbe mit π0.5, sind es 0 %. Mit anderen Worten: Die vortrainierte Repräsentation von FLUX 3 ist gut genug, um einen Roboter mit fast keinem aufgabenspezifischen Training zu steuern, was frühere Modelle nicht von sich behaupten konnten.
Ein paar weitere Befunde, die sich summieren:
- Stichprobeneffizienz. Die mimic-video-Arbeit berichtet von bis zu 10-mal weniger Beispielen als bei einem Vision-Language-Action-Modell, um dieselbe Fähigkeit zu erreichen, weil die Physik bereits in der Repräsentation steckt.
- Selbstkorrektur. Ein Roboter, der einen Griff verfehlt, korrigiert sich und versucht es erneut, obwohl keine Demonstration diese Korrektur gezeigt hat. Sie stammt aus dem Weltmodell, nicht aus dem Trainingsdatensatz.
- Geschwindigkeit. Das Backbone arbeitet von der Kameraeingabe bis zur Weltrepräsentation in unter 80 ms auf einer einzelnen NVIDIA RTX 5090, und die gesamte Roboterschleife von mimic reagiert in 101 ms, etwa der menschlichen visuellen Reaktionszeit.
Der Geschwindigkeitspunkt ist subtil, aber wichtig. Weil bessere Repräsentationen mehr Fähigkeit pro Parameter bedeuten, kann BFL ein kleineres (und damit schnelleres) Backbone betreiben und trotzdem die Genauigkeitsmarke erreichen. In der Robotik ist Latenz die Beschränkung, die Einsätze scheitern lässt, deshalb ist ein kleineres Backbone, das mit der echten Welt mithält, wichtiger als die reine Erfolgsquote.
Vom Labor in die Fabrikhalle
Nichts davon würde zählen, wenn es nur in der Simulation funktionierte, daher ist der Audi-Einsatz der Beweis. Audi betreibt eines der am stärksten automatisierten Produktionsnetzwerke der Autoindustrie und hat daher einen genauen Blick darauf, wo konventionelle Roboter noch aufhören: flexible Teile, feine Manipulation und die Variantenvielfalt der Premiumproduktion, die handprogrammierte Roboterzellen zu teuer macht, um sie pro Fall neu zu konstruieren.
"In partnership with mimic, Audi has been testing and deploying FLUX-mimic. We have seen these robots solve complex soft-body manipulation work that would have been simply impossible with conventional robotics."
Die von BFL genannten Aufgaben sind konkret: Teile in strukturierte Trays kommissionieren, elektronische Steuergeräte in enge Vorrichtungen einsetzen, Komponenten montieren und weiche, flexible Materialien wie Dichtungen und Kabel handhaben. Letztere Kategorie ist seit Jahrzehnten hartnäckig manuell geblieben und damit ein faires Signal dafür, wo dieser Ansatz seinen Wert zeigt.
Kannst du FLUX 3 Action tatsächlich nutzen?
Hier der ehrliche Stand, denn die Begeisterung eilt der Verfügbarkeit voraus. Black Forest Labs liefert FLUX 3 in Phasen aus, und die Aktionsvorhersage kann man nicht kaufen.
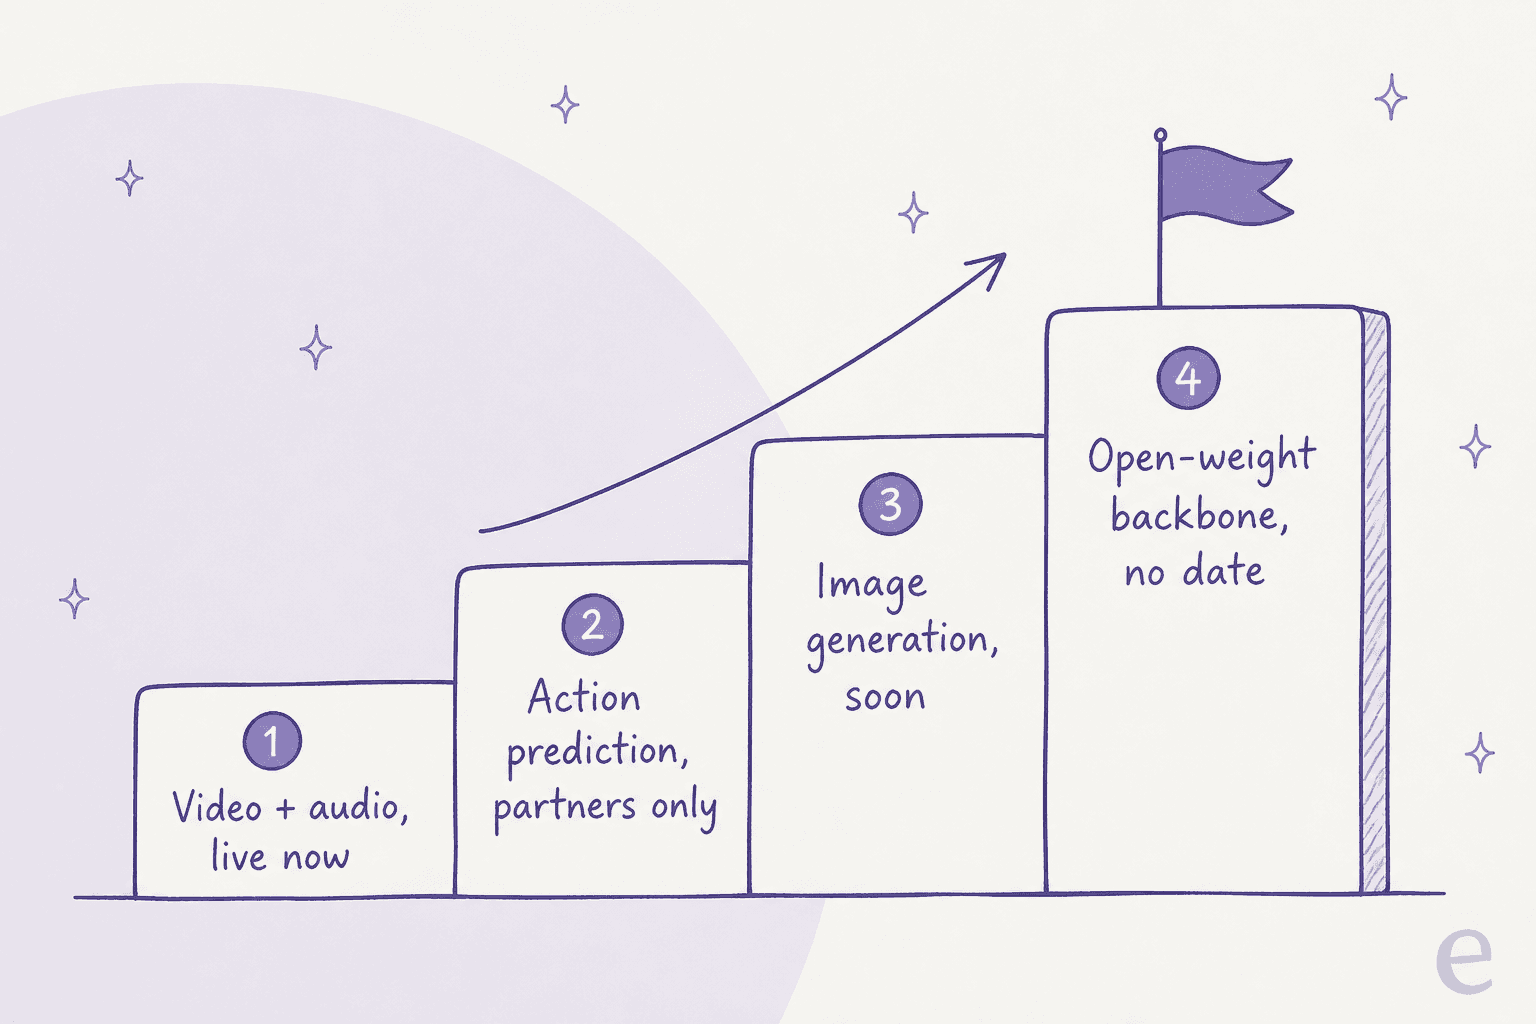
Die von BFL veröffentlichte Reihenfolge lautet: zuerst Videogenerierung und -bearbeitung, dann Aktionsvorhersage mit ausgewählten Partnern, dann Bildsynthese, dann Open-Weight-Zugang zum Backbone. Heute ist nur Video mit Audio allgemein verfügbar. Die Aktionsvorhersage ist partnerbeschränkt (mimic hat Early Access), mit keiner öffentlichen API, keinem veröffentlichten Preis und keinen offenen Gewichten. Die FLUX-3-Bildgenerierung ist weiterhin mit „soon" markiert, und für das Open-Weight-Backbone gibt es gar keinen Termin.
Wenn du FLUX 3 heute anfassen willst, kannst du also tatsächlich für Video bezahlen: Text-zu-Video, Bild-zu-Video und Video-zu-Video bis zu 20 Sekunden, mit nativ synchronisiertem Audio, per Pay-as-you-go-BFL-API-Preisen ohne Abo. Für alles rund um Roboter beobachtest du eine Research Preview und ein Partnerprogramm, kein Produkt. Das ist keine Kritik, sondern einfach der Stand der Front. Physical AI wandert aus guten Gründen nur langsam von ausgewählten Partnern zur allgemeinen Verfügbarkeit.
Infrastruktur versus das Teammitglied, das du tatsächlich einstellst
Ich möchte kurz herauszoomen, denn „FLUX 3 Action" und Begriffe wie „KI-Agent" landen im selben Topf, gehören aber in völlig verschiedene Regale.
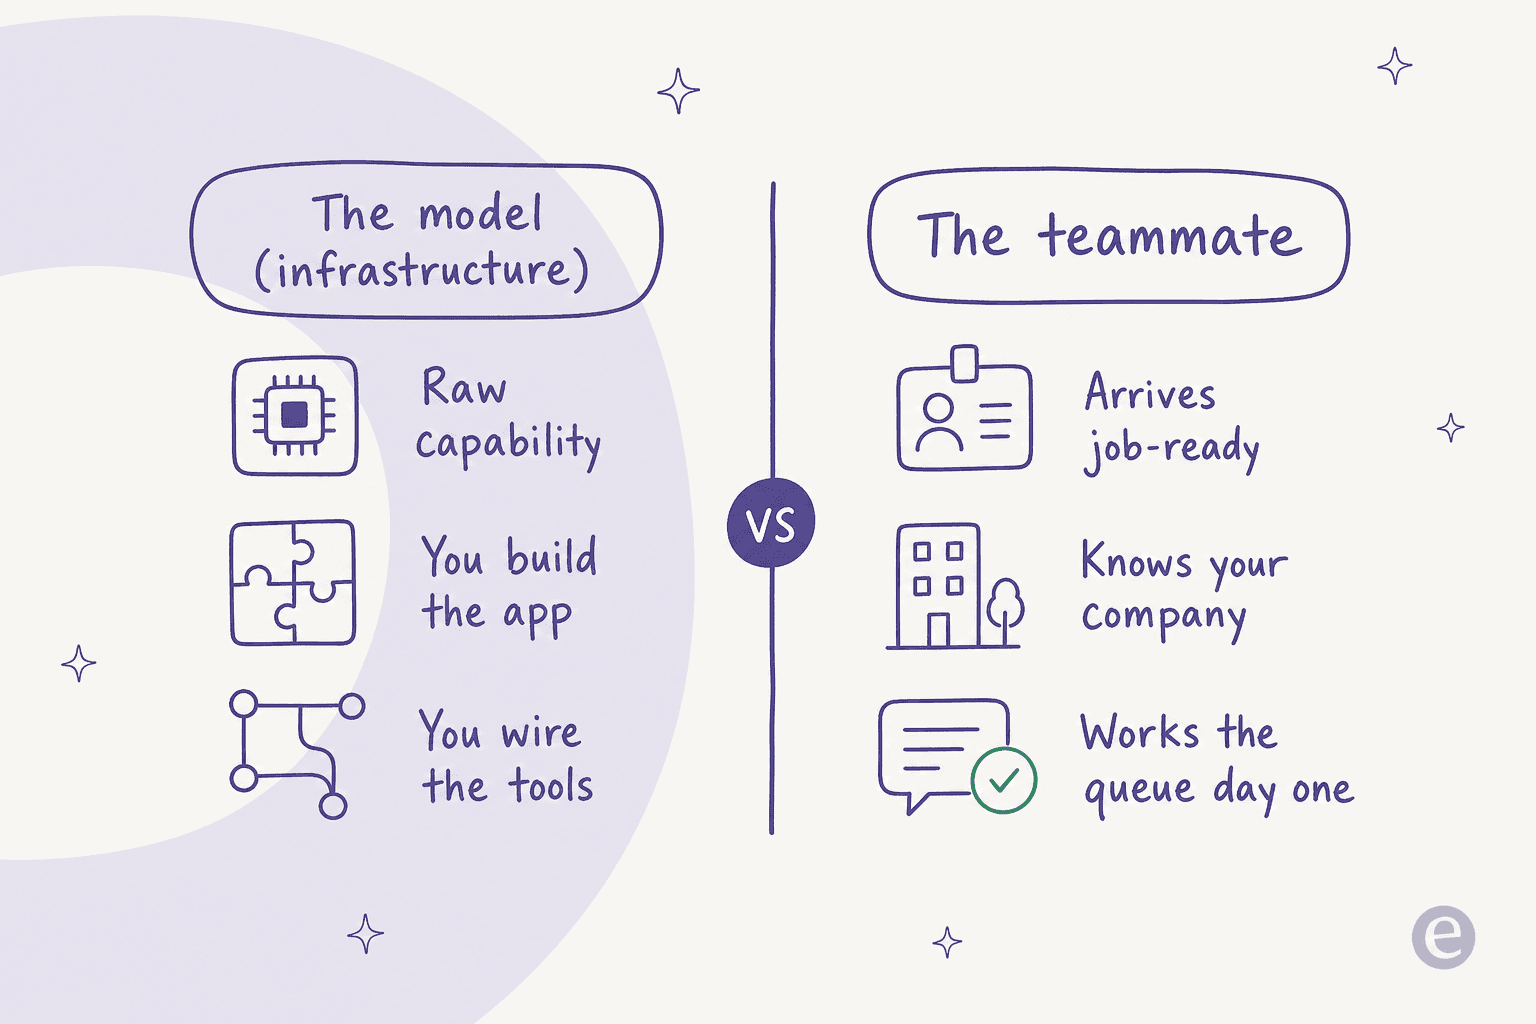
Ein Foundation-Modell wie FLUX 3 ist Infrastruktur. Es ist rohe Fähigkeit. Um daraus Nutzen zu ziehen, baust du die Anwendung, verdrahtest die Tools, kümmerst dich um das Deployment und (in diesem Fall) bindest es an physische Roboter an. Das ist genau die richtige Form für ein Robotiklabor oder ein Automobilproduktionsteam mit Ingenieuren. Für eine Support-Leitung, die einfach nur Tickets beantwortet haben will, ist es die falsche Form.
Das andere Regal ist das KI-Teammitglied: etwas, das einsatzbereit ankommt, dein Unternehmen schon kennt und am ersten Tag loslegt. Du baust keine App darum herum, du briefst es wie eine neue Kollegin oder einen neuen Kollegen. Das ist die Ebene, an der ich arbeite, und es ist wichtig klarzustellen, dass ein Modell kein Teammitglied ist, genauso wenig wie ein Motor ein Auto ist. FLUX 3 Action ist ein bemerkenswerter Motor für Physical AI. Es ist nur nicht das, was du einstellst.
Wie das zu eesel passt
Bei eesel nehmen wir die Seite „Mitarbeiter, nicht Infrastruktur" dieser Trennlinie ernst. eesel ist eine Plattform für KI-Teammitglieder: Statt dir ein rohes Modell zum Daraufbauen zu geben, stellst du einsatzbereite Teammitglieder für bestimmte Aufgaben ein. Das aktuelle Angebot besteht aus einem KI-Helpdesk-Teammitglied und einem KI-Blogschreiber, die jeweils mit den Fähigkeiten, Integrationen und dem Unternehmenskontext kommen, den ihre Rolle braucht.
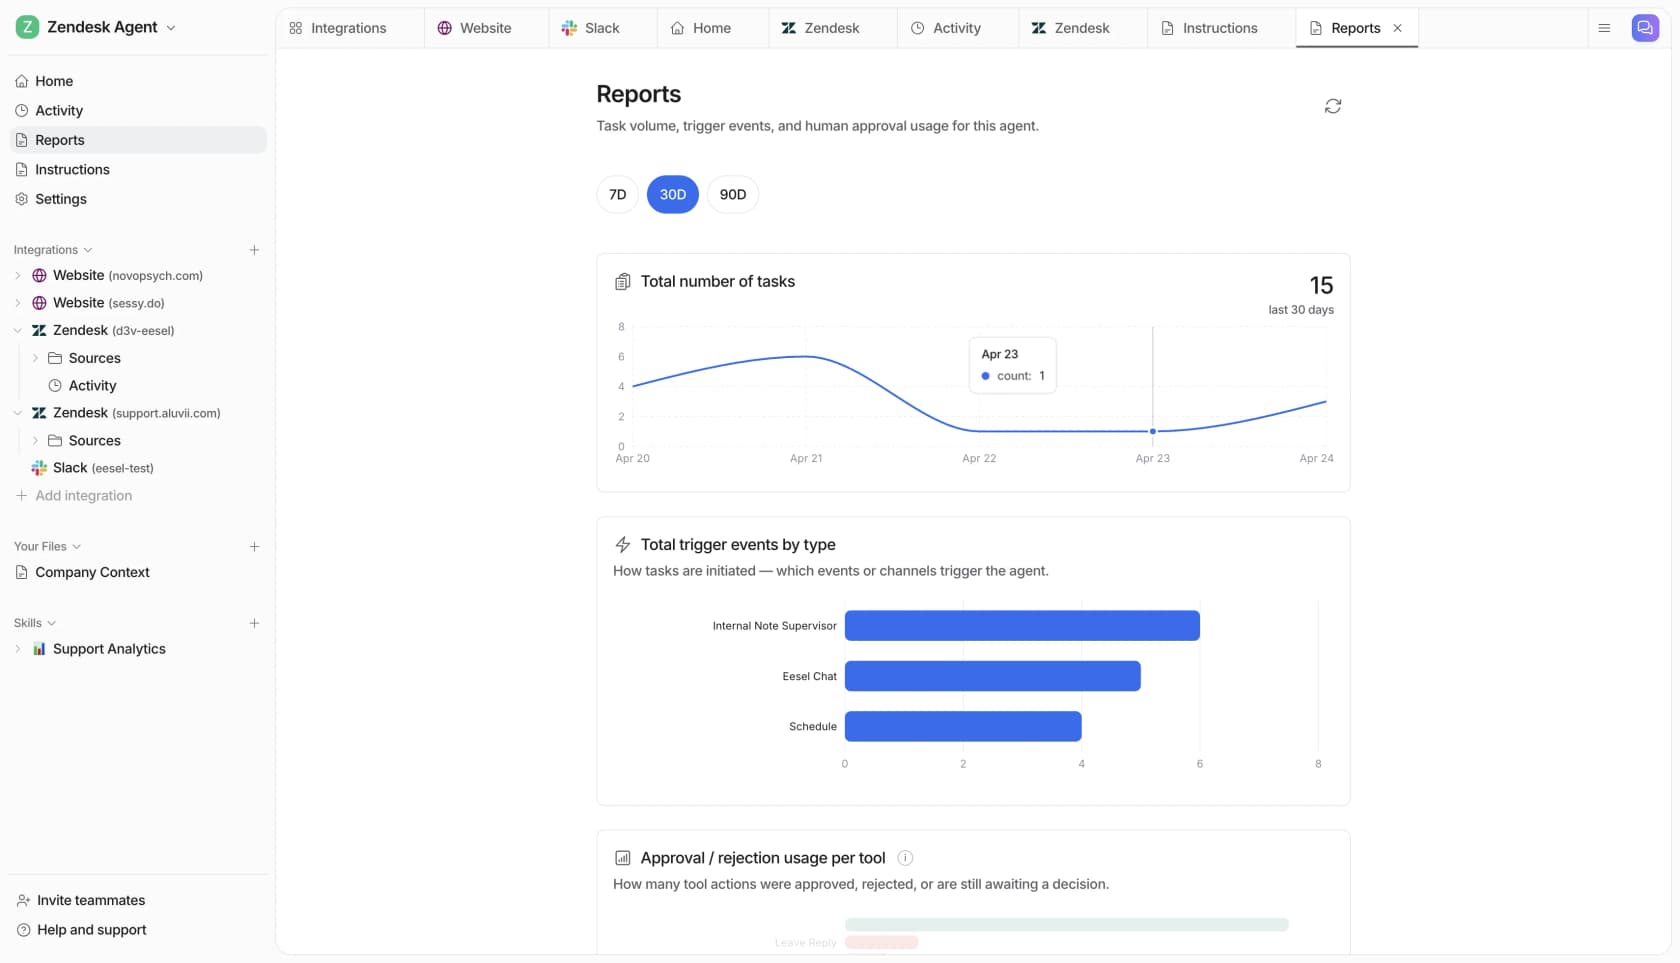
Weil das Modell darunter ein bewegliches Ziel ist (heute FLUX, nächstes Quartal etwas anderes), ist die nützliche Abstraktion das Teammitglied, nicht die rohe Fähigkeit. Das Helpdesk-Teammitglied lernt aus deinen früheren Tickets und deinem Help Center, entwirft Antworten zur Prüfung, und du kannst es an deinen eigenen historischen Tickets simulieren, bevor es live geht, denn ich habe gesehen, wie selbstsicher klingende Bots leise falsche Antworten geben, und fange das lieber im Probelauf ab. Wenn du gern im Terminal arbeitest, lassen dich die eesel-CLI und ihr MCP-Server (oder einen Coding-Agenten wie Claude Code) Integrationen einrichten, Wissen hochladen und Aktionen als JSON freigeben, sodass dasselbe Teammitglied ohne Dashboard programmierbar ist. Es wird deine Wäsche nicht falten und keine Fertigungslinie besetzen. Für das Beantworten von Kundenanfragen und das Schreiben von Inhalten ist es aber die Neueinstellung, nicht die Infrastruktur. Du kannst es kostenlos testen.