

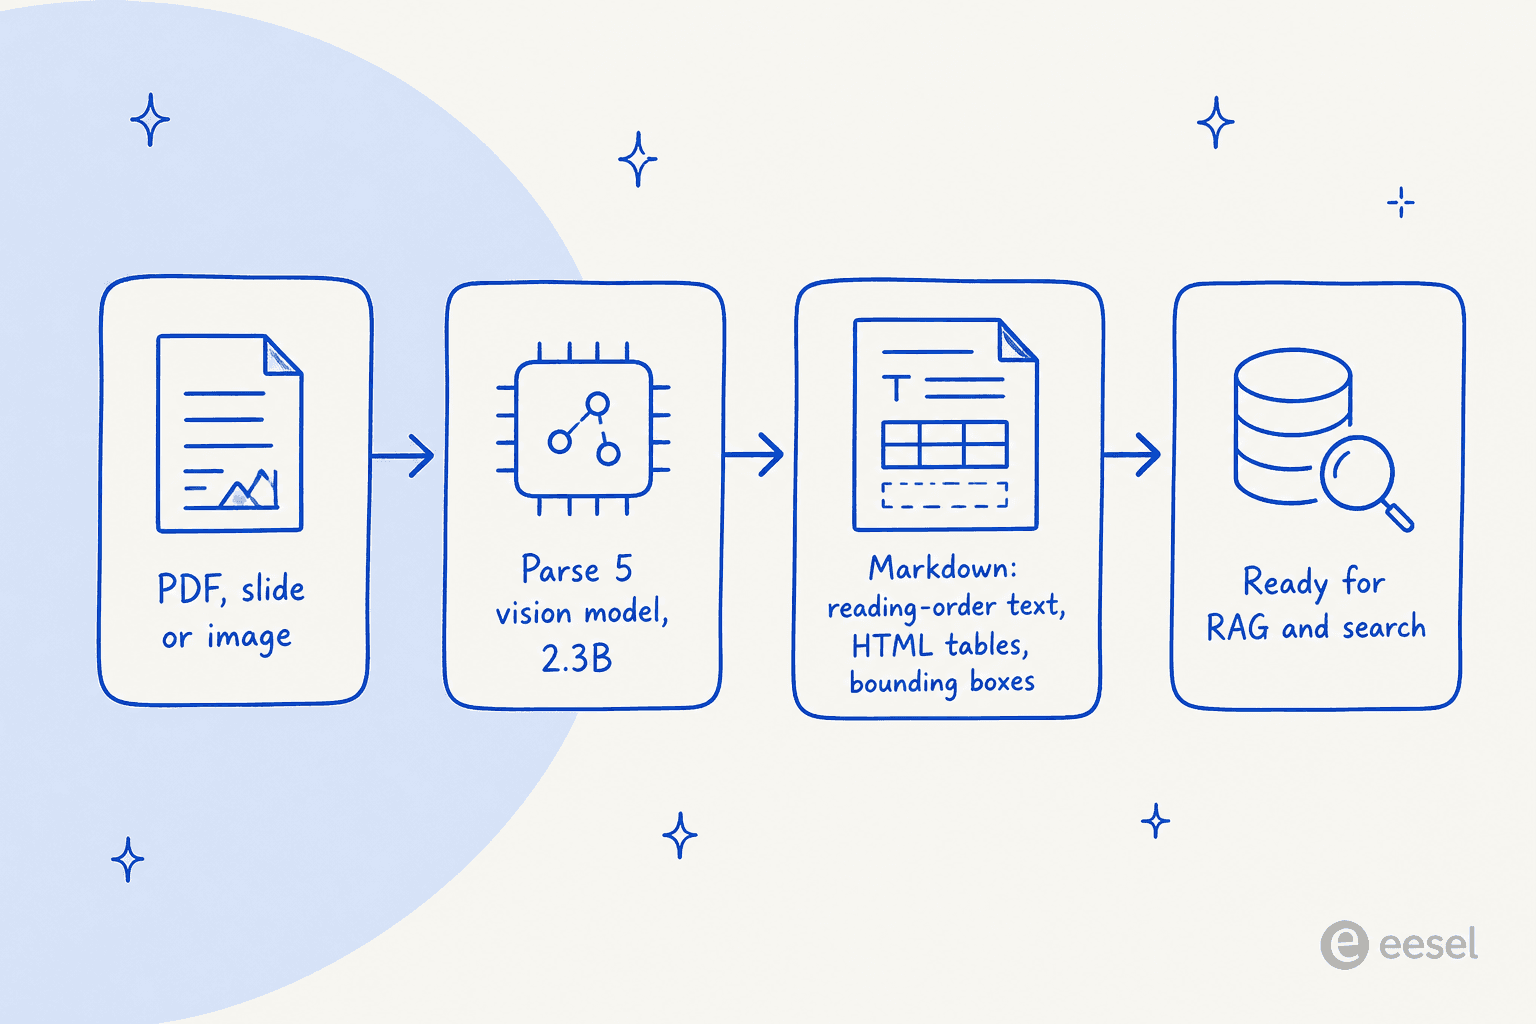
Cohere Parse 5 (Modell-ID parse-v5.0) ist ein kleines Vision-Modell mit 2,3 Milliarden Parametern, das eine Dokumentseite liest und sauberes Markdown zurückgibt: Text in Lesereihenfolge, Tabellen als HTML und Begrenzungsrahmen für visuelle Elemente. Es wurde am 27. August 2026 allgemein verfügbar.
Das Wichtigste vorweg: Es will nicht der genaueste Parser sein. In Coheres eigenem ParseBench erreicht es 79.2 und liegt damit hinter GPT-5.5 (84.4), Opus 4.8 (84.3) und Gemini 3.5 Flash (81.8). Seine Stärke ist der Preis. Mit $1.50 per 1,000 pages (noch günstiger, wenn Sie es selbst auf Model Vault betreiben) liegt es in der Ecke „hohe Qualität, niedrige Kosten“, die die großen Frontier-Modelle nicht erreichen. Wenn Sie Hunderttausende bis Millionen Seiten parsen, ist dieser Kompromiss das ganze Argument.
Parse ist ein Infrastruktur-Baustein, kein fertiges Produkt. Es liefert Ihnen Markdown; Sie müssen es noch einbetten, indexieren, daraus abrufen und etwas bauen, das Fragen beantwortet. Wenn Sie eigentlich eine KI wollen, die Ihr Support-Wissen liest und Tickets löst, müssen Sie diese Pipeline nicht selbst zusammenbauen. Hier kommt ein Tool wie eesel ins Spiel.
Was Cohere Parse 5 eigentlich ist
Cohere ist das Enterprise-KI-Unternehmen, bekannt für seine Command-Sprachmodelle, seine Embed- und Rerank-Suchmodelle und einen starken Fokus auf private, souveräne Bereitstellung. Parse ist der Einstieg in die Dokumentenverarbeitung, und Parse 5 (parse-v5.0) ist die aktuelle Version, angekündigt am 27. August 2026 unter dem Motto „enterprise document intelligence at scale“.
Die Aufgabe ist eng und konkret: Sie geben eine Seite hinein und erhalten strukturierte, maschinenlesbare Daten zurück. Cohere beschreibt es als „beyond OCR“, weil es nicht nur Zeichen transkribiert, sondern Tabellen, Formulare, Diagramme und eingebettete Bilder versteht und alles als sauberes Markdown für die Weiterverarbeitung zurückgibt. Genau diese Ausgabe ist der Punkt. Markdown speisen Sie in einen Suchindex, eine RAG-Pipeline oder einen KI-Agenten.
Unter der Haube ist es ein kompaktes Modell: 2,3 Milliarden Parameter, rund 4,6 GB, mit 8.192 Token Kontext, gebaut auf Coheres Architektur north-micro-vision-instruct. Die geringe Größe ist Absicht. Ein 2,3B-Modell ist günstig im Betrieb und schnell im Serving, und Cohere hat beides konsequent ausgereizt.
Wie Parse 5 funktioniert
Die Mechanik ist einfacher als bei den meisten Parsing-Stacks, weil das Modell die schwere Arbeit in einem Durchgang erledigt. Sie senden ein Seitenbild, kodiert als Base64-Data-URI, an den Endpunkt co.parse der v2-API von Cohere. Standardmäßig kommt Markdown zurück, oder ein blocks-Array, wenn Sie jeden Text-, Tabellen- und Bildbereich einzeln mit seinen Koordinaten haben möchten.
Ein minimaler Aufruf sieht so aus:
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": f"data:image/png;base64,{b64}"},
)

for page in response.pages:
    print(page.markdown.content)
Ein paar Details, die Sie vor dem Bauen kennen sollten. Die Dokumentation nennt PDF, PowerPoint und JPEG als unterstützte Formate, doch der Live-Endpunkt akzeptiert derzeit nur Bilder, also einen Data-URI oder eine Bild-URL, sodass rohe PDF-Uploads noch nicht angebunden sind. Bildeingaben sind auf 20 MB, 50 Megapixel oder 200 MB dekodiert begrenzt. Und Begrenzungsrahmen gibt es nur für Tabellen und Bilder, nicht für jede Textzeile. Das ist Absicht: Das Modell bewahrt die Lesereihenfolge im Markdown, statt eine Wolke von Koordinaten auszugeben, die Sie wieder zusammensetzen müssten.
Es ist in neun Sprachen stabil (Arabisch, Englisch, Französisch, Deutsch, Italienisch, Japanisch, Koreanisch, Portugiesisch und Spanisch), mit Zero-Shot-Verarbeitung weiterer Sprachen bei geringerer Genauigkeit. Cohere hat es mit Geschäftsdokumenten aus Finanzwesen, Versicherung und Wissenschaft trainiert, was verrät, für wen es gedacht ist.
Die Benchmark-Geschichte: Es verliert bei den Punkten, gewinnt beim Preis
Hier setzten alle an. Cohere hat mit ParseBench einen Benchmark veröffentlicht, der Parser in drei Punkten bewertet: wie gut sie Tabellen extrahieren, wie originalgetreu sie Text ohne Auslassungen oder Halluzinationen wiedergeben und wie gut sie semantische Formatierung wie Durchstreichungen und Kursivschrift erhalten. Und Coheres eigene Grafik zeigt Parse 5 hinter drei größeren Modellen.
| Modell | Durchschnitt | Tabellen | Inhaltstreue | Semantische Formatierung |
|---|---|---|---|---|
| GPT-5.5 | 84.4 | 89.3 | 87.5 | 76.5 |
| Opus 4.8 | 84.3 | 89.7 | 89.0 | 74.1 |
| Gemini 3.5 Flash | 81.8 | 87.6 | 84.7 | 73.2 |
| Cohere Parse 5 | 79.2 | 87.0 | 86.6 | 64.0 |
| LlamaParse (cost-effective) | 78.3 | 81.4 | 90.9 | 62.7 |
| Chandra OCR 2 (open) | 77.7 | 89.2 | 83.7 | 60.3 |
| Mistral OCR 4 | 74.5 | 73.9 | 89.5 | 60.1 |
| Databricks AI Parse | 72.4 | 83.7 | 88.3 | 45.3 |
| Azure Document Intelligence | 69.3 | 86.0 | 84.9 | 37.0 |
| Google Document AI | 57.3 | 55.1 | 83.7 | 33.0 |
| AWS Textract | 53.3 | 82.3 | 74.8 | 2.8 |
Einen Benchmark zu veröffentlichen, den man nicht anführt, ist ungewöhnlich und ehrlich. Parse 5 ist stark bei Tabellen und Inhaltstreue (87.0 und 86.6, nah an den Frontier-Modellen) und schwächer bei der semantischen Formatierung (64.0). Es lässt die spezialisierten Parser hinter sich, mit einer von Cohere so genannten „over 20-point improvement“ gegenüber AWS Textract und Google Document AI. Beim reinen Genauigkeitswert ist es einfach nicht das schärfste Werkzeug im Schuppen.
Das Argument liegt in der zweiten Grafik. Sobald man die Punktzahl gegen den Preis aufträgt, rückt Parse 5 in die Ecke, die sonst niemand besetzt.
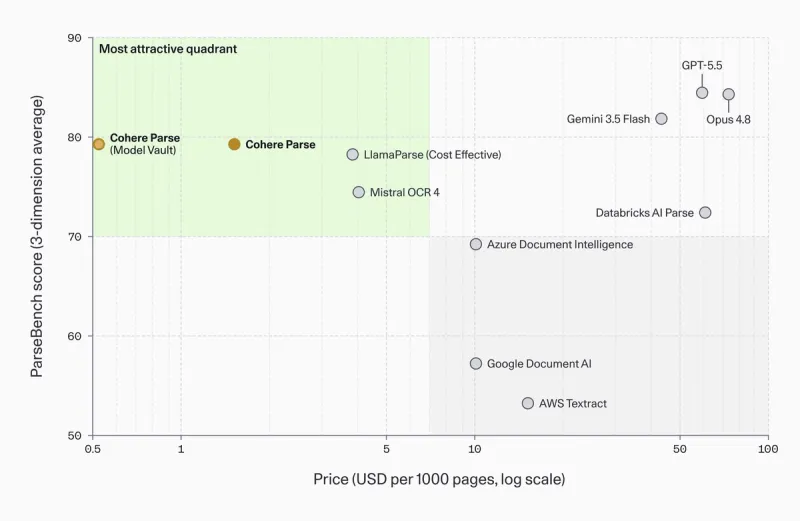
GPT-5.5 und Opus 4.8 erreichen drei bis fünf Punkte mehr, liegen aber weit rechts, bei etwa dem 40- bis 50-Fachen der Kosten pro Seite. Für eine einmalige Vertragsprüfung zahlen Sie für die Genauigkeit. Für eine Ingestion-Pipeline, die eine Million Rechnungen im Monat verarbeitet, sind fünf Punkte Formatierungstreue keine 40-fache Rechnung wert. Auf diese Wette setzt Parse 5, und für die Dokumentenverarbeitung in großen Mengen ist sie vernünftig.
Der Enterprise-Tech-Journalist Sean Kerner fasste die Stimmung rund um den Launch zusammen:
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Diese Skepsis ist berechtigt. Parsing ist nicht „gelöst“, und Parse 5 behauptet das auch nicht. Es verspricht, die Kosten im großen Maßstab deutlich zu senken, ein engeres und besser vertretbares Versprechen.
Durchsatz und Self-Hosting
Die andere Hälfte der Preisgeschichte ist die Geschwindigkeit. Auf einer einzelnen H100-GPU verarbeitet Parse 5 4,5 Seiten pro Sekunde, also 36 Seiten pro Sekunde (rund 2.160 pro Minute) auf einem 8-GPU-Knoten. Cohere hat es mit Open-Source-Parsern verglichen, die auf dieselbe Weise mit vLLM betrieben wurden, und es liegt vorn.
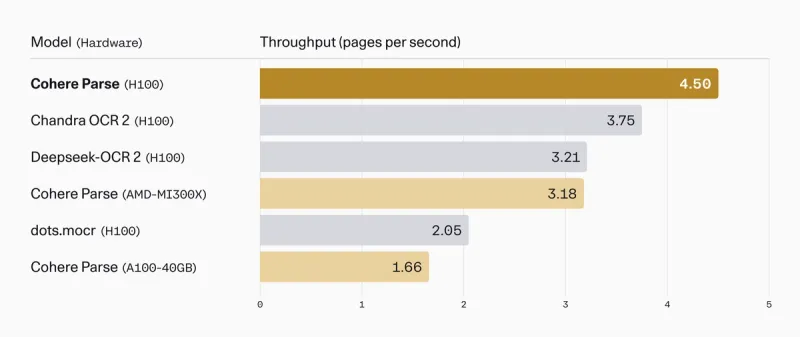
Hoher Durchsatz bei einem kleinen Modell macht die Wirtschaftlichkeit beim Self-Hosting aus. Und Self-Hosting ist genau Coheres Ansatz. Neben der Standard-API läuft Parse 5 als dedizierte Model-Vault-Instanz, auf Microsoft Foundry, auf Amazon SageMaker oder vollständig privat und Air-Gapped, was wichtig ist, wenn Sie Dokumente parsen, die Sie rechtlich nicht an eine Drittanbieter-API senden dürfen. Es gibt auch einen kostenlosen Demo-Space auf Hugging Face, wenn Sie einfach eine Seite ausprobieren möchten.
Cohere Parse 5 Preise
Parse 5 hat zwei Preismodelle, und welches das richtige ist, hängt ganz vom Volumen ab.
| Option | Preis | Hinweise |
|---|---|---|
| Cohere API | $1.50 / 1,000 pages | Abrechnung pro Seite. Limit 500 Anfragen/Minute. Der kostenlose Testschlüssel erlaubt 1.000 Aufrufe/Monat. |
| Model Vault, Medium-Instanz | $4.00 / hour ($2,500 / month) | Dedizierte Single-Tenant-Instanz. |
| Model Vault, XL-Instanz | $7.00 / hour ($4,300 / month) | Dedizierte Instanz mit höherem Durchsatz. |
Der Preis pro Seite ist die Schlagzeile, und mit $1.50 per 1,000 pages gehört er tatsächlich zu den günstigeren gehosteten Optionen. Bei den dedizierten Instanzen summieren sich die Einsparungen. Coheres Rechnung: Bei 50 % GPU-Auslastung ist Model Vault pro Seite 23 % günstiger als die API, bei voller Auslastung wächst der Abstand auf 61 %.
Das Rechenbeispiel macht es greifbar. Ein Kreditorenbuchhaltungs-Workflow mit ~13 Millionen Seiten im Monat spart auf Model Vault statt der API grob 12.000 $ im Monat bzw. 144.000 $ im Jahr. Gemessen an einem Hyperscaler-Parser zu 10 $ pro 1.000 Seiten spart allein dieser Workflow rund 1,47 Millionen $ pro Jahr. Das sind Coheres Zahlen auf Coheres Annahmen, also behandeln Sie sie als Bestfall, doch die Richtung stimmt: Bei hohem Volumen summieren sich die Parsing-Kosten pro Seite schnell, und ein günstigeres Modell ist ein großer Hebel.
Was es nicht kann
Ehrlichkeit über die Grenzen macht das Preisargument glaubwürdig, deshalb hier die Liste. Parse 5 gibt nur Markdown aus, kein strukturiertes JSON. Wenn Sie ein striktes Schema brauchen, parsen Sie das Markdown anschließend selbst. Es liefert keine Konfidenzwerte, sodass Sie unsichere Extraktionen nicht automatisch zur menschlichen Prüfung markieren können. Und es klassifiziert keine Dokumentelemente wie Kopfzeilen, Fußzeilen oder Schrifthierarchie. Für einen Massen-Ingestion-Job ist nichts davon ein Ausschlusskriterium, aber jedes ist eine Lücke, wenn Sie es in einen Workflow einbauen wollten, der Sicherheitsmarkierungen oder ein starres Ausgabeformat braucht.
Wo Parse 5 passt (und wo nicht)
Hier stolpern viele, deshalb ein klares Wort. Parse 5 ist eine Parsing-Schicht. Es verwandelt Seiten in Text. Für sich allein beantwortet es keine einzige Frage. Um von „Dokumenten“ zu „einer KI, die jemandem hilft“ zu kommen, verketten Sie es zu einem Retrieval-Stack: Dokumente parsen, die Abschnitte als Vektoren einbetten, die Treffer neu ranken und die besten Passagen an ein Modell übergeben, das eine fundierte Antwort erzeugt. Cohere verkauft alle drei Teile gebündelt als Compass-Plattform.
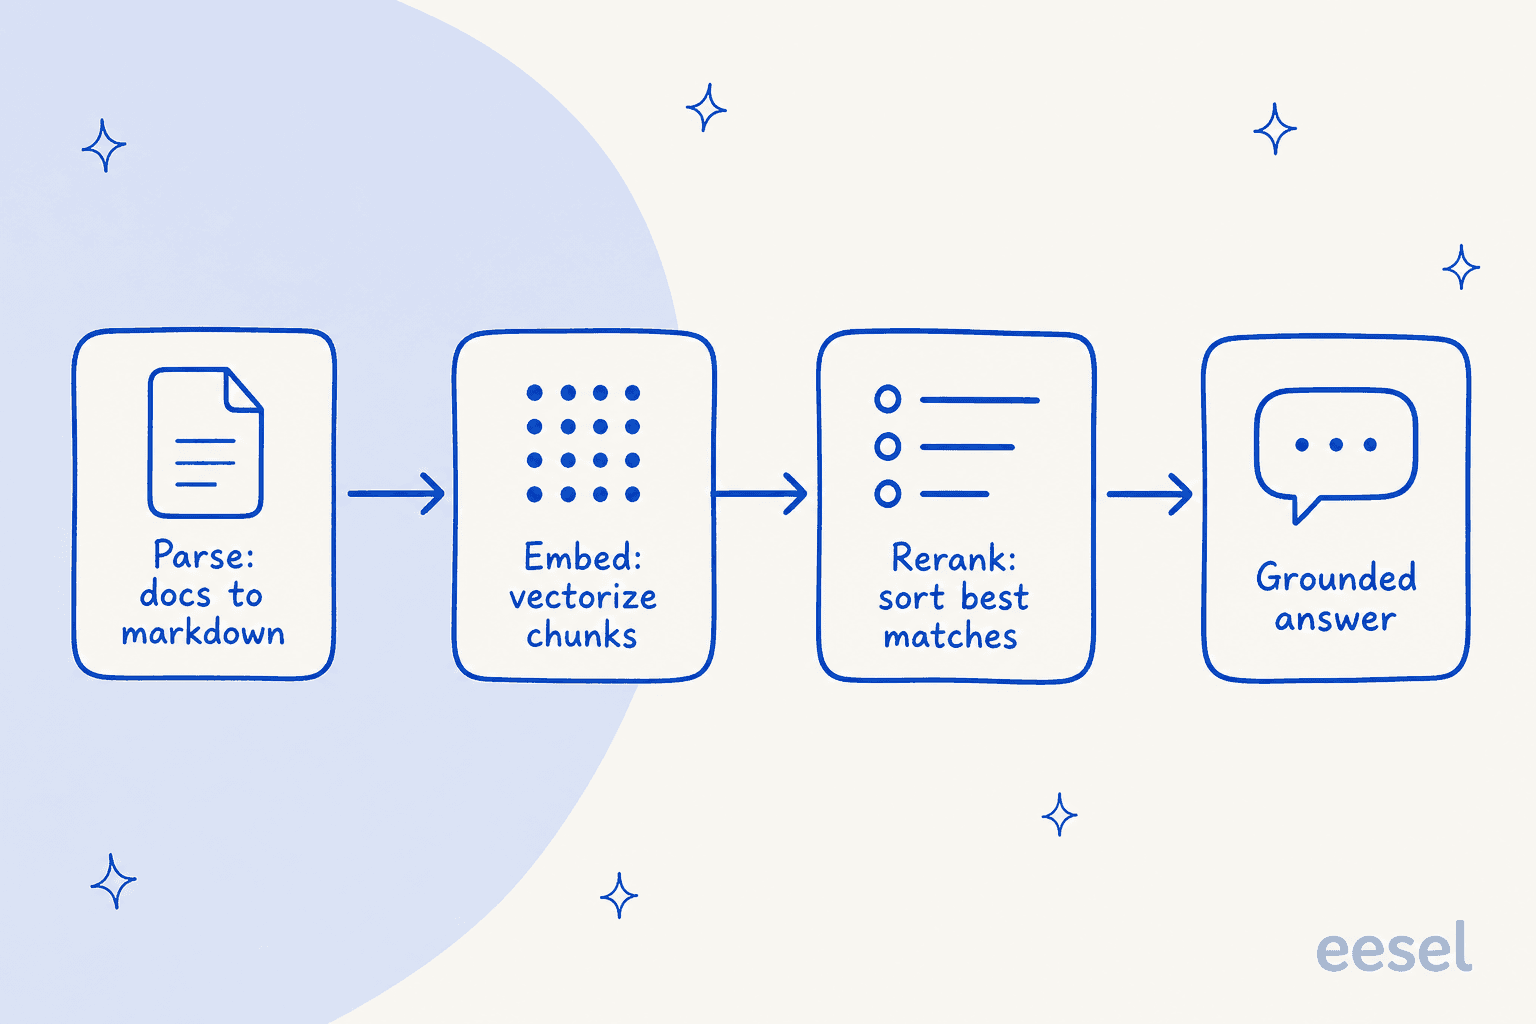
Das ist ein großartiges Toolkit, wenn Sie ein Plattformteam sind, das maßgeschneiderte Dokumentenintelligenz baut und maximale Kontrolle über jede Stufe will. Es ist viel Montage, wenn Ihr eigentliches Ziel etwas Alltäglicheres ist, etwa eine KI, die Ihr Help Center und frühere Tickets liest und Kundenfragen löst. Dann suchen Sie gar keinen Parser, sondern den fertigen Mitarbeiter, und die Parse-Embed-Rerank-Generate-Pipeline selbst zu bauen ist ein Umweg.
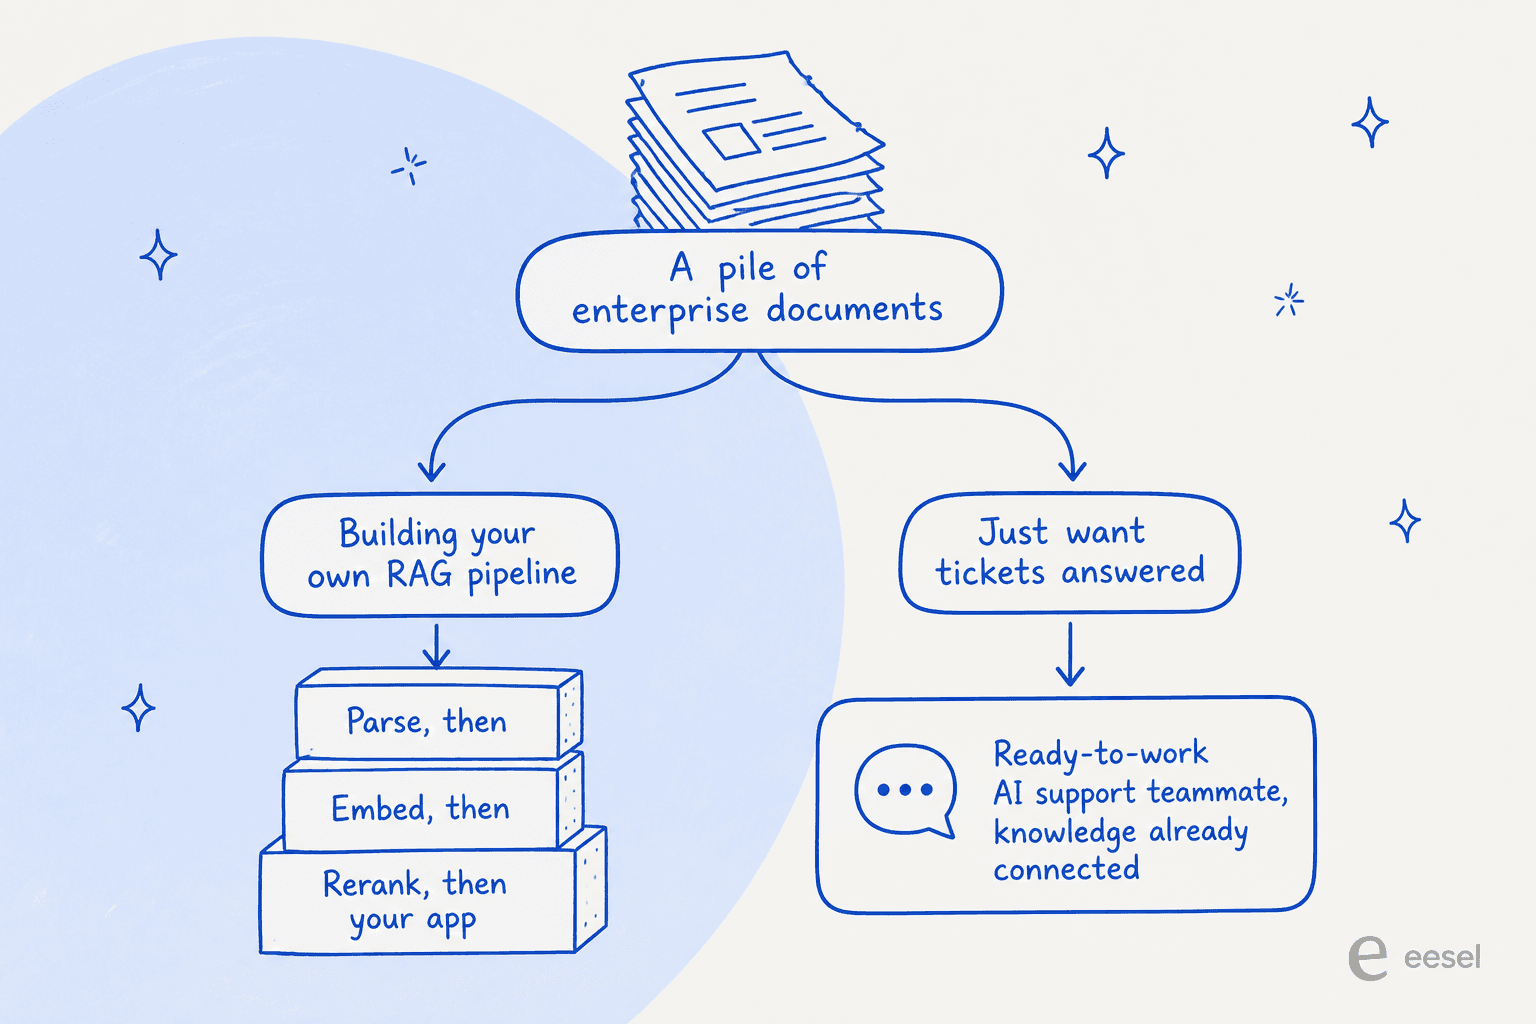
Der Unterschied ist derselbe wie zwischen einem Automotor und einem Auto. Parse 5 ist ein sehr guter, sehr günstiger Motor. Ob Sie den Rest des Autos darum herum bauen wollen, ist die eigentliche Frage.
Probieren Sie eesel für Support, der einfach antwortet
Wenn Ihr Interesse an einem Parsing-Modell aus einem Support-Problem stammt, schließt eesel genau diese Lücke zwischen Motor und Auto. eesel ist eine Plattform für KI-Teammitglieder, und ihr AI-Helpdesk-Teammitglied ist eine einsatzbereite Version des gesamten Stacks: Es verbindet sich direkt mit Ihrem Help Center, Confluence, Google Docs und früheren Tickets, lernt daraus und löst Tickets in Zendesk, Freshdesk, Gorgias, Slack oder über einen teilbaren Chat-Link. Keine Parsing-Pipeline zusammenzustecken, keine Vektordatenbank zu betreiben.

Am schwersten zu fälschen ist das Vertrauen, es einzuschalten. Wir lassen seit Jahren KI auf echten Support-Warteschlangen laufen und haben erlebt, wie ein selbstsicher klingender Bot stillschweigend falsche Antworten gibt. Deshalb simuliert eesel jeden Rollout anhand Ihrer historischen Tickets, bevor er einen echten Kunden berührt, sodass Sie die Lösungsquote und die genauen Antworten sehen, die er gesendet hätte. Parse 5 mag ein Teil davon sein, wie ein Team wie unseres Dokumente bewegt. Es ist nicht das Teammitglied. Sie können eesel kostenlos testen.
Häufig gestellte Fragen
Was ist Cohere Parse 5?
parse-v5.0) ist ein Vision-Sprachmodell mit 2,3 Milliarden Parametern, das Dokumentseiten in sauberes Markdown umwandelt, mit Tabellen als HTML und Begrenzungsrahmen für visuelle Elemente. Es wurde gebaut, um RAG-Pipelines, Suchindizes und KI-Agenten in großem Umfang zu versorgen.Was kostet Cohere Parse 5?
1,50 $ pro 1.000 Seiten. Für große Workloads können Sie es als dedizierte Model-Vault-Instanz betreiben (Medium für 4,00 $/Stunde, XL für 7,00 $/Stunde), was laut Cohere die Kosten pro Seite im großen Maßstab um 23 bis 61 % senkt. Vergleichen Sie das mit einer Kostenaufstellung KI-Agent vs. menschlicher Agent, bevor Sie sich festlegen.