

要点
SaaSプロダクトが停止すると、サポートへの問い合わせは緩やかに増えるのではなく、一気に急増します。「自分だけですか?」「いつ直りますか?」といった同じ数個の質問が1時間に何百、何千件と届き、人間のチームはそれを1件ずつ片付けていく一方で、本当に特殊なチケットは底に沈んでしまいます。
障害時のAIの役割は賢くあることではなく、繰り返しの洪水を吸収して、人が判断を要する少数のチケットに集中できるようにすることです。範囲を適切に絞ったAIヘルプデスクエージェントは、障害に関するチケットを見分け、既知の問題として認識済みであることを伝えるメッセージとステータスページへのリンクを返信し、後で一括整理できるようにタグを付け、パターンに合わないものはエスカレーションします。
避けるべき落とし穴は、推測するAIです。根拠のない復旧見込み時刻を伝えたり、誤った原因を断定したり、返金を約束したりすれば、1つのインシデントが2つになります。信頼度で制限をかけ、午前2時にポケベルが鳴ってからではなく、必要になる前にインシデントモードを整えておきましょう。すでに使っているヘルプデスクの中にAIを組み込み、席数ではなく月額固定料金で利用したいなら、そこが eesel の出番です。
障害はサポートキューに実際に何をもたらすのか
私はサポートのキューを日々担当しているので、理論ではなく実際の様子をお伝えします。普段は、請求の質問、使い方の質問、ときどきバグ報告と、幅広いトピックのチケットがぽつぽつと届きます。対応しながら振り分けていけます。
障害はそのすべてを1つのトピックに押し込めます。コア機能が壊れた瞬間、グラフはぽつぽつとした流れではなく、壁のように立ち上がります。
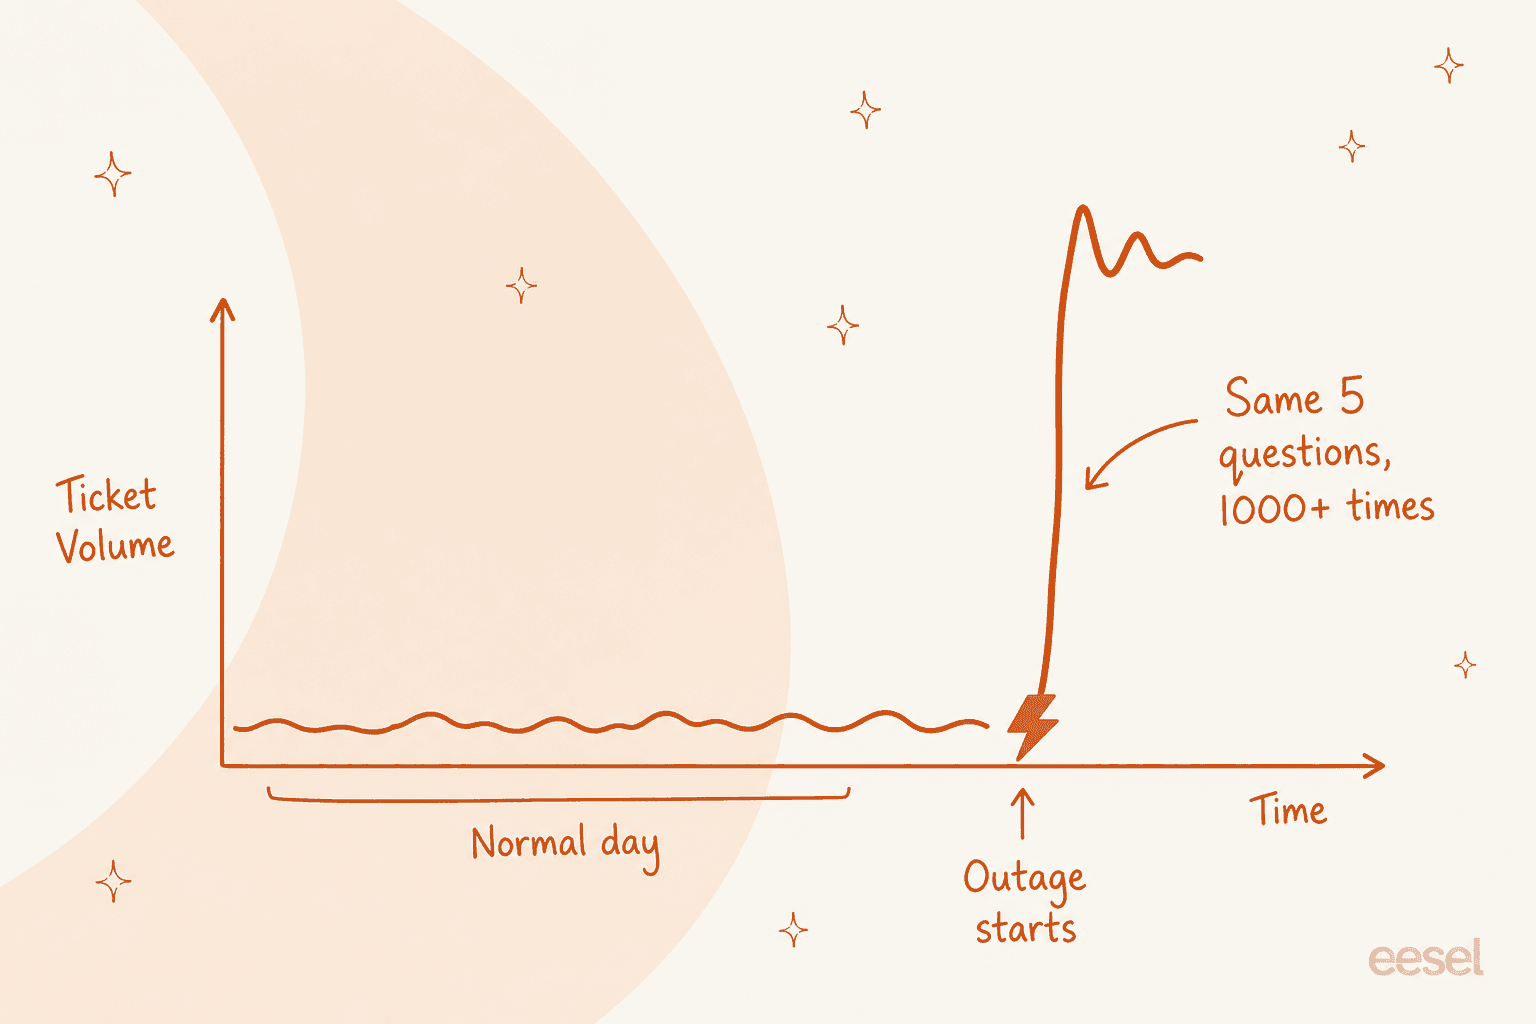
厄介なのは、ほぼすべてが同じチケットだということです。私が数字を見たことのある、複数ブランドを運営するEコマース事業者では、平穏な日でも返金、配信停止、注文追跡といった繰り返しの問い合わせが1日500件以上あります。そのベースラインに障害が重なると、繰り返しは垂直に跳ね上がります。同じ5つの質問が、50通りの言い回しで、1,000回も届くのです。
人間のチームは、まさにこの作業が最も苦手です。同じ質問に400回目の返信をするのは精神をすり減らしますし、返信がすべて手入力なので遅く、その間に、本当に別の深刻な問題を抱えたお客様は812番目で待たされたままになります。
なぜ最初に人間が限界を迎えるのか
サポートチームは通常、許される範囲で最小限の人数です。平均的な日のチケット数では、最悪の日に合わせた人員配置は正当化できないからです。その計算は、最悪の日が来るまでは問題ありません。
サポートリーダーからは同じ話を何度も聞きます。チームは過負荷で追いつけず、本当に必要なのは、機械が明らかに処理できるチケットを機械に引き受けてもらうことだ、と。月に200〜250件のZendeskチケットを扱うバス追跡サービスのサポートマネージャーは、チケットの60%をAIに処理してほしい、そして何より人を呼び込むべきタイミングを見極めてほしいと率直に語っていました。この「エスカレーションすべきときを知る」という条件こそ、インシデント中のすべてです。
失敗は返信が遅いことだけではないからです。障害の原因究明を手伝うべきシニアメンバーが、2時間ずっと「問題を認識しています」をコピー&ペーストし続けることになります。障害は二重の損失をもたらします。ダウンタイムそのものと、キュー対応に回された優秀な人材の時間です。
AIサポートはどうやって洪水を吸収するのか
私が使っているメンタルモデルはこうです。インシデント中、チケットは2つに分かれます。洪水(同じ既知の問題が何度も届く)と、例外(それ以外のすべて)です。AIは前者が非常に得意で、後者には手を出さないのが正解です。
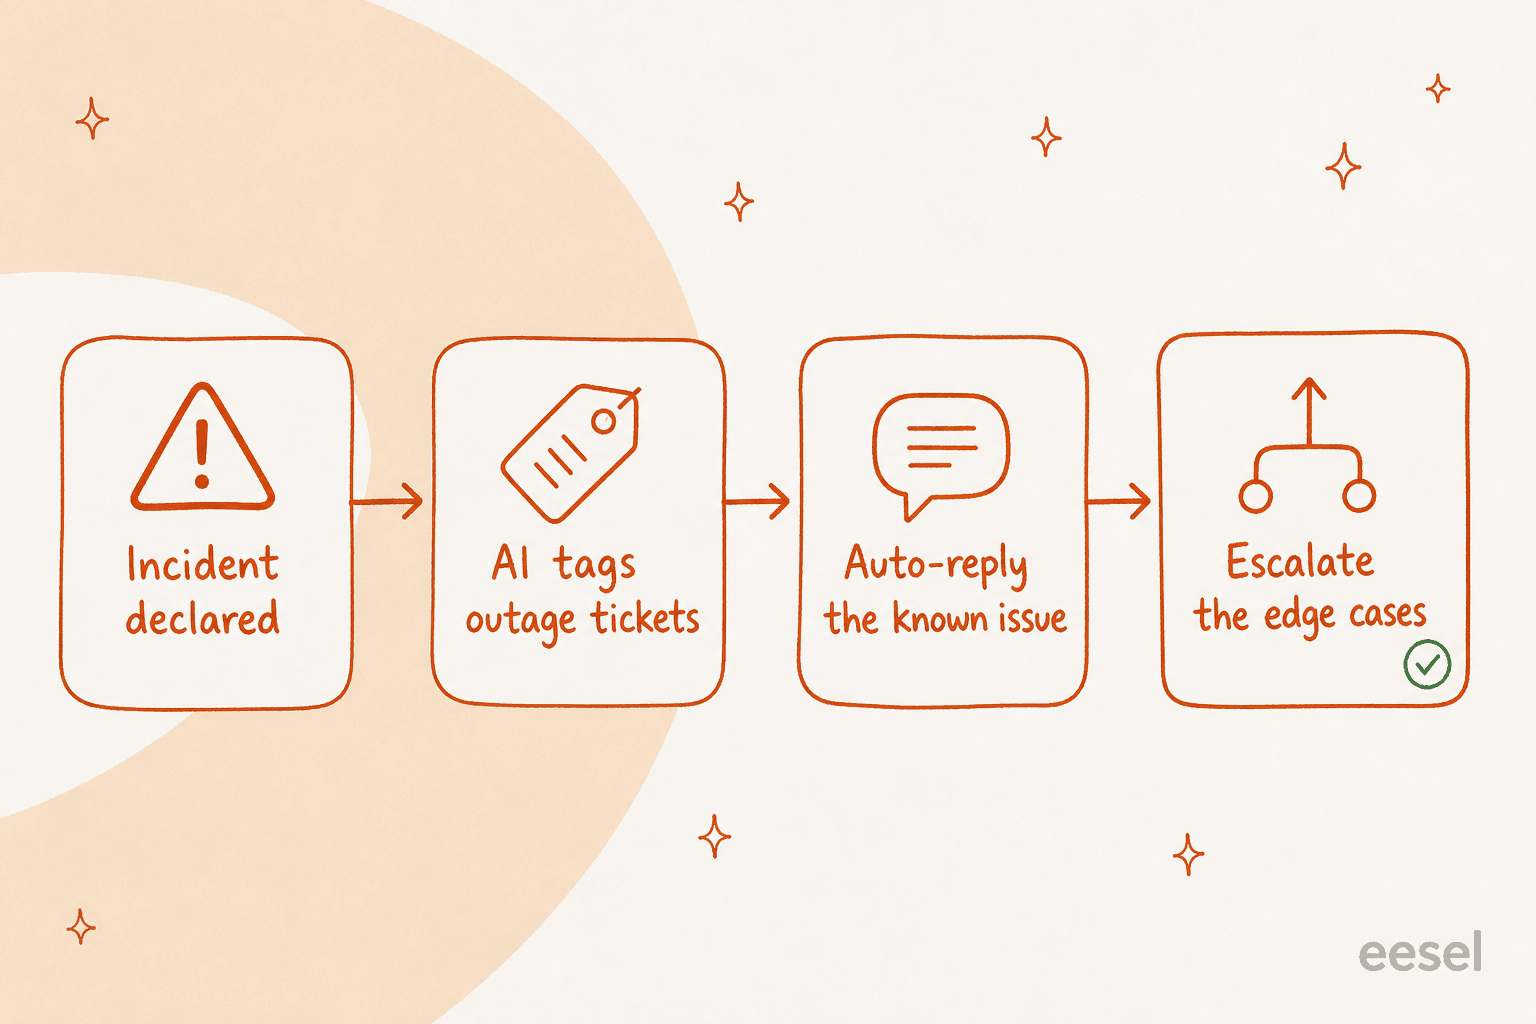
流れを追ってみましょう。
- パターンを認識する。 何が壊れたか分かれば、それを説明する受信チケットは簡単に見つかります。AIは、あなたが書いた既知の問題の説明と照合します。
- ただ受け流すのではなく、返信する。 一致したチケットには、きちんとした回答を返します。はい、把握しています。影響範囲はこちらです。こちらがステータスページです。続報をお知らせします、と。これはそのお客様にとって本物の解決であり、はぐらかしではありません。
- 触れたものすべてにタグを付ける。 すべての障害チケットにタグを付けておけば、修正がリリースされたときに、スレッドを1つずつ開き直さなくても、「解決しました」というフォローアップ1通でまとめてクローズできます。
- 例外をエスカレーションする。 障害に加えて課金トラブルにも触れているチケットや、既知の問題とまったく似ていないチケットは、手を加えずに人へ回します。
これはまさに、AIヘルプデスクエージェントが想定している役割分担です。すでに運用中のZendeskやFreshdeskのキュー(GorgiasやHelp Scoutにも対応)に接続し、チームメイトのように加わって、繰り返しの多いチケットをチームの手から引き受けます。
eesel自身のアカウントの中では、お客様の1社であるGridwiseで、AIが最初の月にティア1のリクエストの73%を解決しました。これはインシデント時ではなく、通常の日の数字です。チケットがさらに均一になる障害時には、この割合はもっと上がります。
コストの観点も重要ですが、見落とされがちです。ツールが席数課金だと、チケットが10倍の日でもソフトウェア費用は変わらず、残業代だけが膨らみます。人間が急増に対応する手段は、労働時間を増やすことしかないからです。月額固定料金ならこれが逆転します。eesel は500クレジットで月額299ドルから(チケットまたはチャット1件につき1クレジット)で、席数課金やプラットフォーム料金はありません。そのため、人員体制を変えずに2時間の洪水をAIで受け止められ、従量課金の利用は任意で、上限も自分で設定できます。
必要になる前にインシデントモードを整える
これらを設定するのに最悪のタイミングは、障害の最中です。今、退屈なうちに済ませておきましょう。次のインシデントの前に用意しておきたい設定は次のとおりです。
- 既知の問題用マクロを事前に書いておく。 具体的な原因は事前には分かりませんが、文面の型は書いておけます。「[X]に影響する問題を把握しています。担当チームが対応中です。最新情報は[ステータスページ]でご確認ください。」インシデント中は空欄を一度埋めるだけで、AIが一致するすべてのチケットにそれを使います。
- ヘルプデスクとステータスページを接続する。 AIが自社らしい回答をするには、実際のヘルプセンターと過去のチケットを読み込む必要があります。また、お客様を信頼できる場所へ誘導するために、ステータスページのURLも必要です。
- チケットの種類と信頼度で自動化の範囲を絞る。 AIが自動でクローズしてよいカテゴリと、触れてはいけないカテゴリを事前に決めておきます。返金、トラブル、法務に関わりそうなものは、常に人が担当します。
- 過去の障害に対してシミュレーションする。 多くの人が飛ばして後悔するステップです。eesel は本番稼働の前に、実際の過去チケットに対してエージェントを実行します。次のインシデントを任せる前に、前回のインシデントをどう処理していたかを確認できます。サポートにとって、避難訓練に最も近いものです。
- エスカレーション経路をつなぐ。 エスカレーションされたチケットが、月曜まで誰も確認しないフォルダではなく、人がすぐ目にする場所に届くことを確認しておきます。
Slackをインシデント用チャンネルとして使っているなら、そちらも接続しておく価値があります。エンジニアが調整している同じ場所にAIが投稿でき、サポート側とエンジニア側が別々の話を読むことがなくなります。
障害中にAIが絶対にしてはいけないこと
ここは壁に刻んでおきたい部分です。障害は、やりすぎなAIが最も大きな損害を与える瞬間です。お客様はすでにストレスを感じており、自信満々の誤った回答は強く突き刺さります。
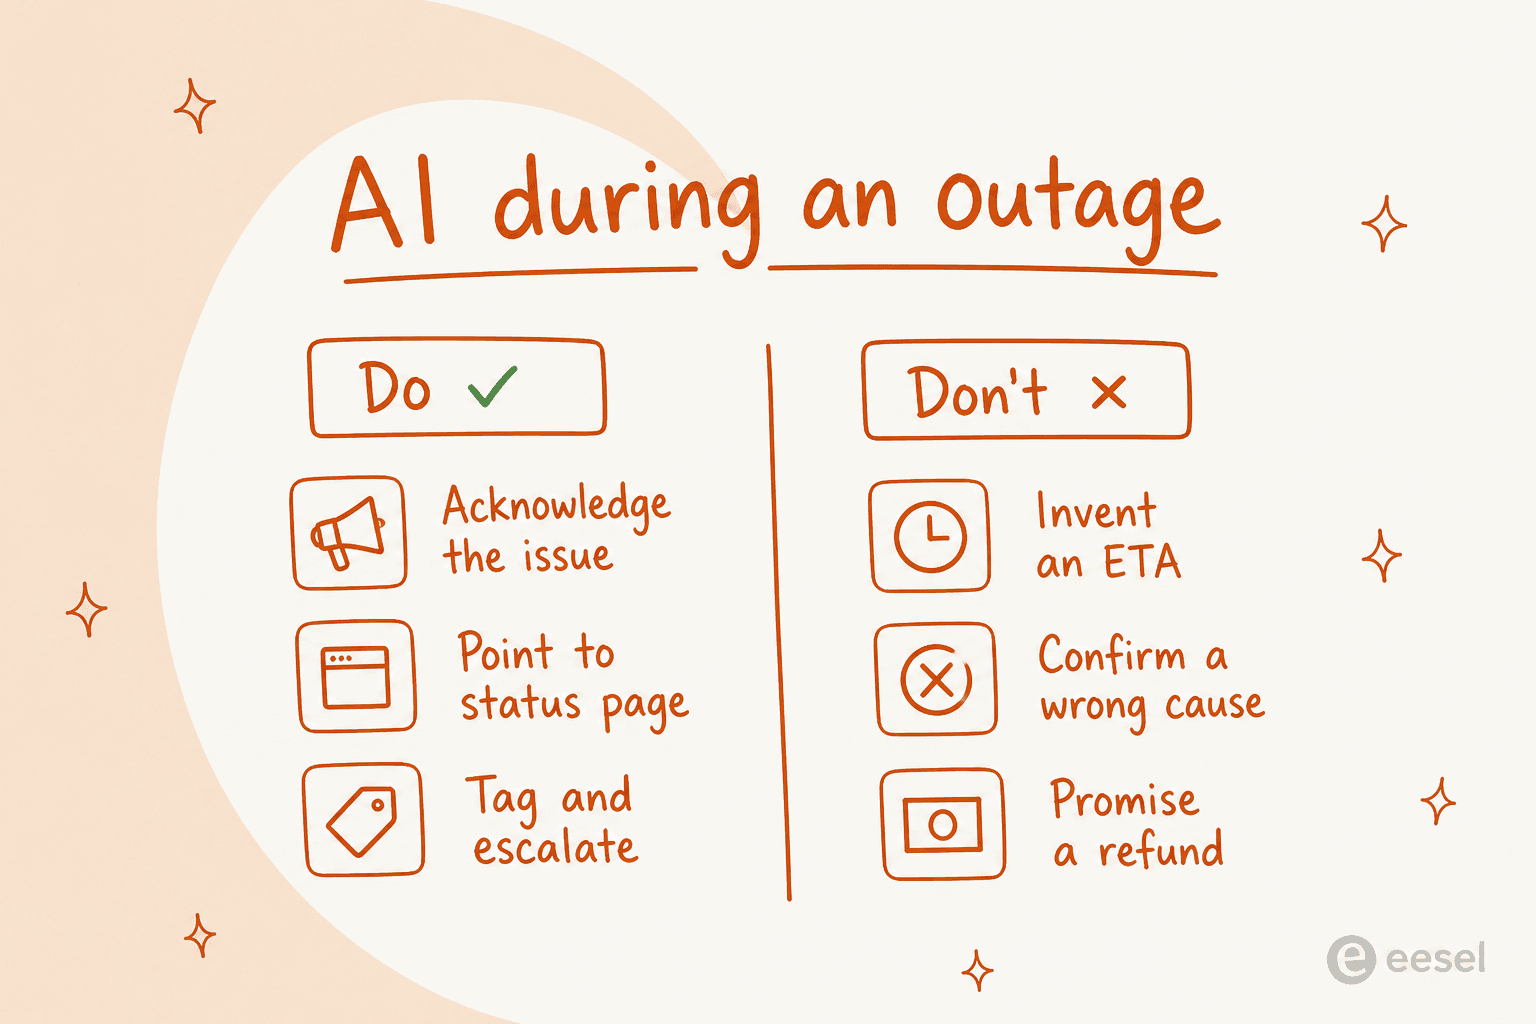
してはいけないことは、すべて同じ過ちの変形です。推測することです。でっち上げた復旧見込み時刻は、破ることになる約束になります。断定した根本原因が間違っていれば、公に訂正する義務が生じます。ボットが提示した返金は、あなたが承認していない金額と前例です。どれも仮定の話ではありません。自動化の範囲を広げすぎて、制限なく「役に立つように」と指示したときに実際に起こることです。
避ける方法は、期待ではなく制御です。DTCサプリメントブランドを運営している、匿名とさせていただくCXリーダーは、この原則を私よりもうまく言い表していました。
「AIが質問の100%に答えられることは決してありません。私が必要なのは、自信を持って対応できるチケットだけを扱い、それ以外は触れずに残してくれるAIです。」
インシデント中にAIを安全にするのは、この設定です。自信のある繰り返しの作業をこなし、それ以外には手を出さない規律を持つこと。信頼度に基づく範囲設定は、ここでは「あると便利」なものではなく、AIが障害を短くするか長引かせるかの分かれ目です。
次のインシデントに eesel を
既存のキューの中に入り込み、既知の問題の洪水を吸収し、チケットが普段と違うと見えた瞬間にきれいにエスカレーションするAIヘルプデスクのチームメイトが欲しいなら、それこそが eesel の役割です。過去のチケットとヘルプセンターで学習するので、障害時の返信は自社のチームが書いたように読めます。チケットの種類と信頼度で自動化の範囲を絞るので、重要なチケットで推測することはありません。さらに実際の履歴に対してシミュレーションするので、実際に経験する前にインシデントのリハーサルができます。

また、料金は席数ではなくクレジット制なので、最悪の日の最悪の1時間のために人員を確保しなくても、急増に合わせて規模を決められます。ヘルプデスクを接続し、ナレッジを指定して、クレジットカード不要・営業電話なしで100クレジットから無料で始められます。準備ができていてもいなくても、次の障害は来ます。ですから、有効な一手は、その前にインシデントモードを構築し、シミュレーションしておくことです。