

Qwen Image 2.1 est le nouveau modèle d'image à poids ouverts d'Alibaba, sorti le 20 septembre 2026, et son grand atout est la transparence native : il génère des images RGBA avec un vrai canal alpha directement à partir d'un prompt, sans étape manuelle de suppression du fond (blog Qwen). Il est aussi bien plus petit qu'avant, un générateur visuel de 7B contre l'ancien modèle de 20B, donc il tourne sur une seule GPU grand public, et il peut éditer avec jusqu'à 10 images de référence en 2K natif.
Il y a un piège à connaître avant de construire dessus. La licence est passée de l'Apache 2.0 qui couvrait le Qwen-Image d'origine à une licence réservée à la recherche qui interdit l'usage commercial sans autorisation distincte (LICENSE). Et il n'existe pas d'API payante qwen-image-2.1 ; l'API d'image commerciale d'Alibaba tourne sur le plus récent qwen-image-3.0.
Alors, pour qui est-il fait ? Si tu veux générer des PNG transparents en local, bricoler ou faire de la recherche, c'est une sortie vraiment enthousiasmante et gratuite à exécuter. Si tu livres du travail créatif commercial, lis d'abord la licence, ou prends l'API payante.
Ce qu'est vraiment Qwen Image 2.1
Qwen Image 2.1 est le dernier modèle d'image de l'équipe Qwen d'Alibaba, et il fait deux métiers avec un seul jeu de poids : la génération texte-vers-image et l'édition d'image. La partie qui dessine est un diffusion transformer de seulement 7B de paramètres, construit à partir de 32 couches Single-Stream DiT (blog Qwen). Il est sorti le 20 septembre 2026 sur Hugging Face, ModelScope et GitHub en même temps, avec une prise en charge dès le premier jour dans ComfyUI, Diffusers, vLLM-Omni et SGLang.
Le chiffre à retenir est ce 7B. Le précédent modèle d'image ouvert de Qwen faisait 20B, avec un transformer d'image de 40,9 GB, et celui-ci tombe à 7B / 14,2 GB (7,26 GB en INT8), comme un testeur l'a détaillé sur X :
"Qwen's Image 2.1 released but it come with lots of improvements but just as many caveats. The old Qwen-Image-2512 was a 20B model with a massive 40.9GB BF16 image transformer. But the new Qwen-Image-2.1 comes with 7B visual generator, 14.2GB BF16, 7.26GB INT8"
Cette réduction est toute l'histoire de la sortie : Alibaba a gardé l'essentiel de ce que faisait le grand modèle, ajouté une fonction phare, et l'a fait tourner sur du matériel que les gens possèdent vraiment.
La transparence native est le vrai titre
Tous les modèles d'image savent dessiner une image. Presque aucun ne sait te livrer un détourage transparent propre. Le flux habituel : générer d'abord, passer le résultat dans un outil de suppression de fond, puis espérer que les bords autour des cheveux et du verre survivent. Qwen Image 2.1 simplifie tout ça : il décide à partir de ton prompt s'il produit une image normale ou une image RGBA avec un vrai canal alpha, et génère directement la version transparente (blog Qwen).
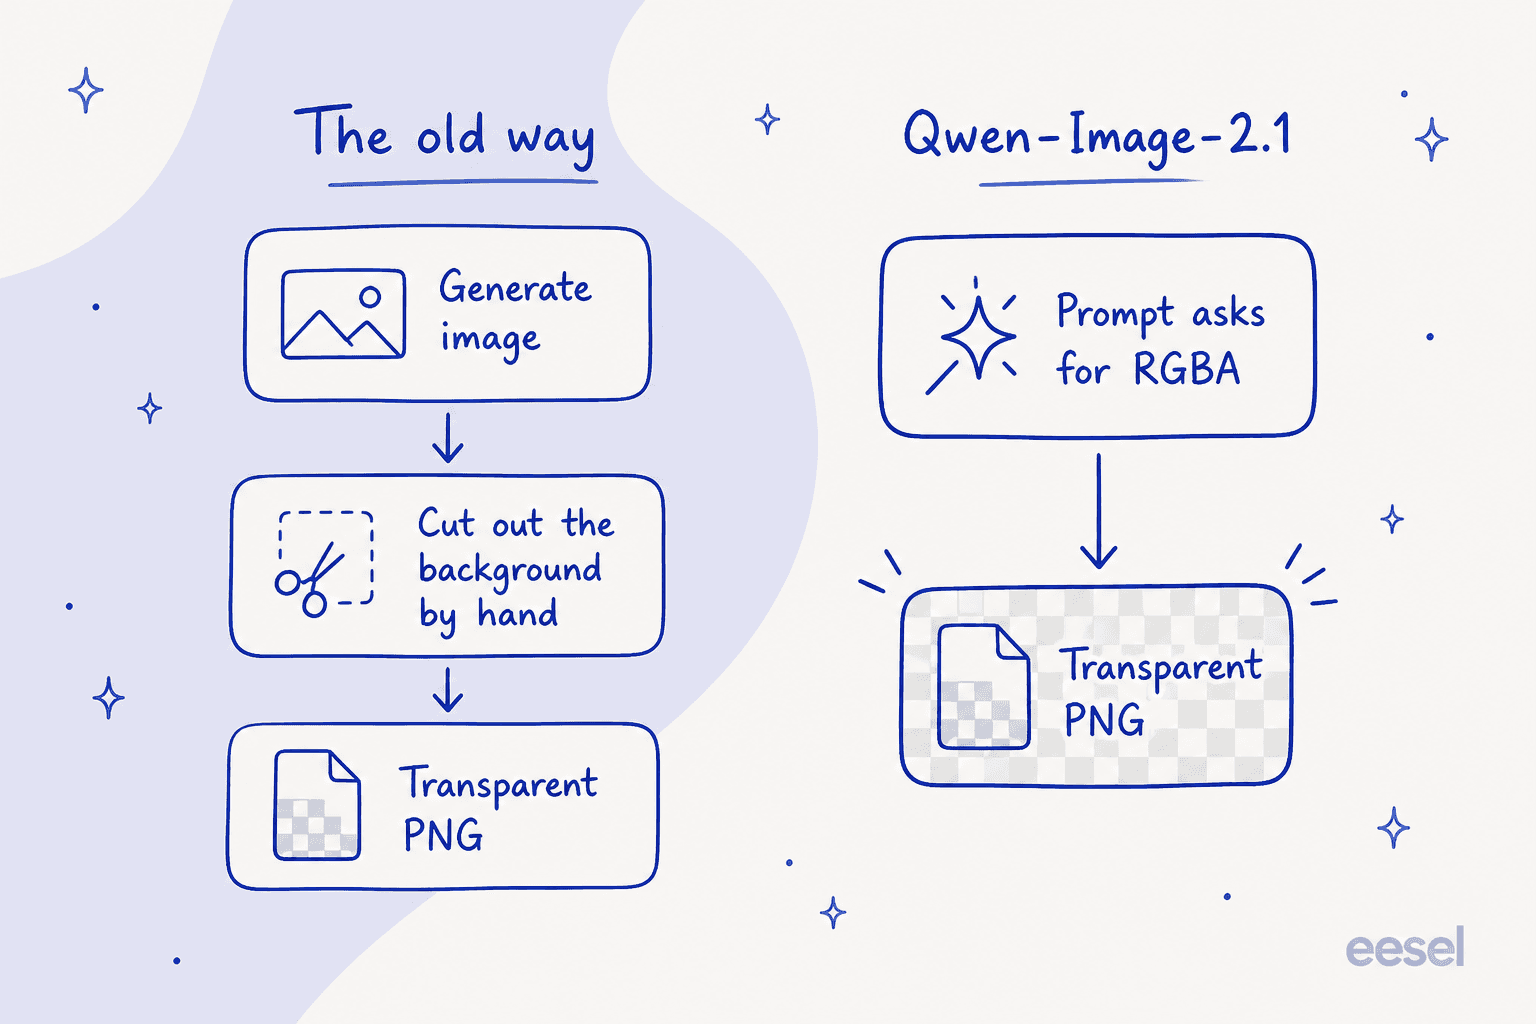
Ce n'est pas une science totalement nouvelle pour Qwen. En décembre 2025, l'équipe avait sorti cette fonction comme un modèle distinct nommé Qwen-Image-Layered ; la 2.1 intègre cette capacité dans le modèle unifié pour que tu n'aies pas à jongler avec deux checkpoints (blog Qwen). En pratique, cela veut dire quatre choses : générer un élément transparent à partir de texte, éditer une image transparente en gardant son fond clair, éditer le texte à l'intérieur d'un calque transparent, et extraire un sujet d'une photo ordinaire sous forme de calque RGBA. La model card suggère même la formulation du prompt pour le déclencher, du genre "This is an RGBA image with transparency ... the background is transparent" (model card HF).
Si tu fais des miniatures, des stickers, des photos produit ou des éléments d'interface, cette seule fonction est la raison de t'y intéresser. C'est ce qu'un créateur IA sur X a signalé comme le plus prometteur, et c'est la chose la plus nette que Qwen Image 2.1 fait et que les grands modèles fermés te font encore faire à la main.
Quoi d'autre s'est amélioré
La transparence fait le titre, mais les améliorations d'édition sont là où la plupart des gens passeront leur temps.
- Jusqu'à 10 images de référence. Tu peux donner au modèle jusqu'à dix entrées et lui demander de les composer en une scène cohérente : une photo de groupe faite à partir de six portraits séparés, un essayage virtuel à partir d'un mannequin plus vêtements, chaussures, sac et chapeau, ou une pièce assemblée à partir de dix photos de mobilier (blog Qwen).
- Édition locale flexible. Tu indiques ce qu'il faut changer avec des cercles colorés, des annotations peintes ou une paire image d'origine plus masque, et l'option masque préserve intact le reste de l'image (blog Qwen).
- Préservation de la fidélité. Les visages restent reconnaissables d'une édition à l'autre, et les produits gardent leur texte, leur texture et leur forme, ce qui est justement ce qui casse d'habitude quand on demande à un modèle de restyliser un objet étiqueté (blog Qwen).
- 2K natif, sept formats d'image. La sortie va jusqu'à 2048x2048 en 1:1 et 2752x1536 en 16:9, donc tu n'as pas à agrandir après coup un rendu de 1 MP (model card HF).
Le rendu du texte mérite sa propre ligne, parce que c'est ce à quoi la communauté des poids ouverts revient sans cesse. Le modèle pèse non seulement les mots mais aussi leur style typographique et leur mise en page par rapport à toute la composition (blog Qwen), et sur Hacker News le verdict a été net :
"The text rendering definitely is much, much better than anything else on the open weights market right now. Small text fidelity is quite good. It seems like the text encoder however gets a little bit overloaded with larger prompts"

Ce "much, much better" vient avec un astérisque, que j'aborde dans la section sur les avis, parce que tout le monde n'est pas d'accord pour dire que le texte est propre.
Comment ça marche sous le capot
Voici la partie qui explique pourquoi un modèle de 7B peut tenir tête à de bien plus gros. Qwen Image 2.1 s'appuie sur deux astuces d'efficacité plutôt que sur la taille brute.
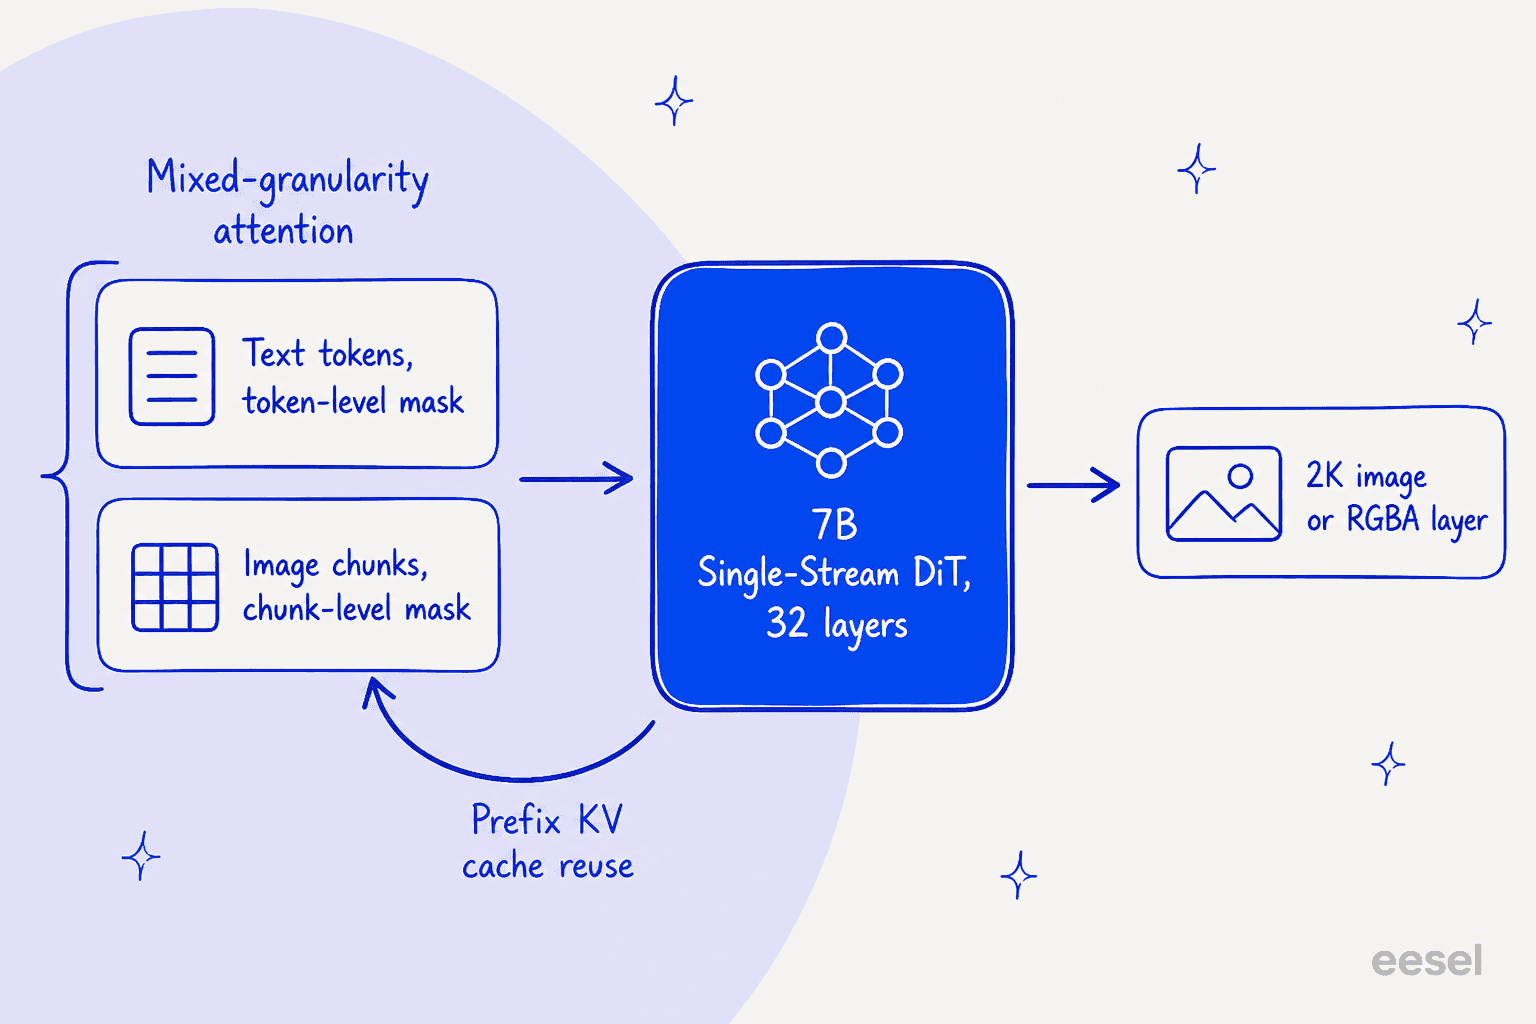
La première est l'attention à granularité mixte. Les tokens de texte, c'est-à-dire le préfixe système et tes instructions d'édition, reçoivent un masque causal fin au niveau du token, tandis que l'image elle-même est traitée avec un masque plus grossier au niveau du chunk. C'est dans le texte que la précision compte, donc il a droit au traitement détaillé ; l'image reçoit le moins coûteux (blog Qwen). La seconde est la réutilisation du cache KV de préfixe : tes images d'entrée et tes instructions sont un contexte statique, donc le modèle les calcule une fois, les met en cache et les réutilise à chaque étape suivante au lieu de les recalculer (blog Qwen). Les deux visent directement le coût de l'édition avec plusieurs images de référence, exactement là où un modèle naïf s'étoufferait.
Si tu veux construire dessus, le modèle a déjà un écosystème : entraînement LoRA via DiffSynth-Studio de ModelScope, plus des adaptateurs communautaires, des finetunes et des quantifications listés dans l'arbre de modèles. ControlNet, notamment, n'est mentionné dans aucun document officiel, donc considère-le comme absent tant qu'un portage communautaire n'apparaît pas.
Le piège de la licence
C'est la partie que je lirais avant de t'y attacher. Le Qwen-Image d'origine est sorti sous Apache 2.0, la licence permissive qui te laisse faire à peu près tout, travail commercial compris. Qwen Image 2.1, non. Il sort sous la Qwen Research License, qui accorde une "non-exclusive, worldwide ... royalty-free limited license ... for non-commercial purposes only", l'usage commercial exigeant une autorisation distincte d'Alibaba.
La communauté open source l'a remarqué tout de suite, et la réaction sur Hacker News a été cinglante :
"Calling open-weights as open-source in marketing materials is the usual misrepresentation. But now with the restriction on commercial use (which is against opensource definition) it is not even open-weights, technically it would be more accurate to call it weights-available."
C'est une lecture juste. Tu peux télécharger les poids, les exécuter, les affiner et partager tes modifications, tant que c'est pour la recherche ou l'évaluation et que tu conserves les mentions d'attribution. Ce que tu ne peux pas faire, c'est mettre la sortie dans un produit commercial sans écrire à Alibaba pour obtenir une licence. C'est un vrai changement dans ce que "ouvert" veut dire ici, et c'est le plus gros reproche fait à cette sortie. Pour être juste envers Qwen, beaucoup de labos vont dans cette direction, et une licence de recherche reste plus que ce qu'offrent la plupart des modèles fermés. Ce n'est simplement pas le grand bazar libre d'Apache auquel les gens s'attendaient.
Comment y accéder, et ce que ça coûte
Il y a plusieurs entrées, et la bonne dépend entièrement de ce que tu en fais.
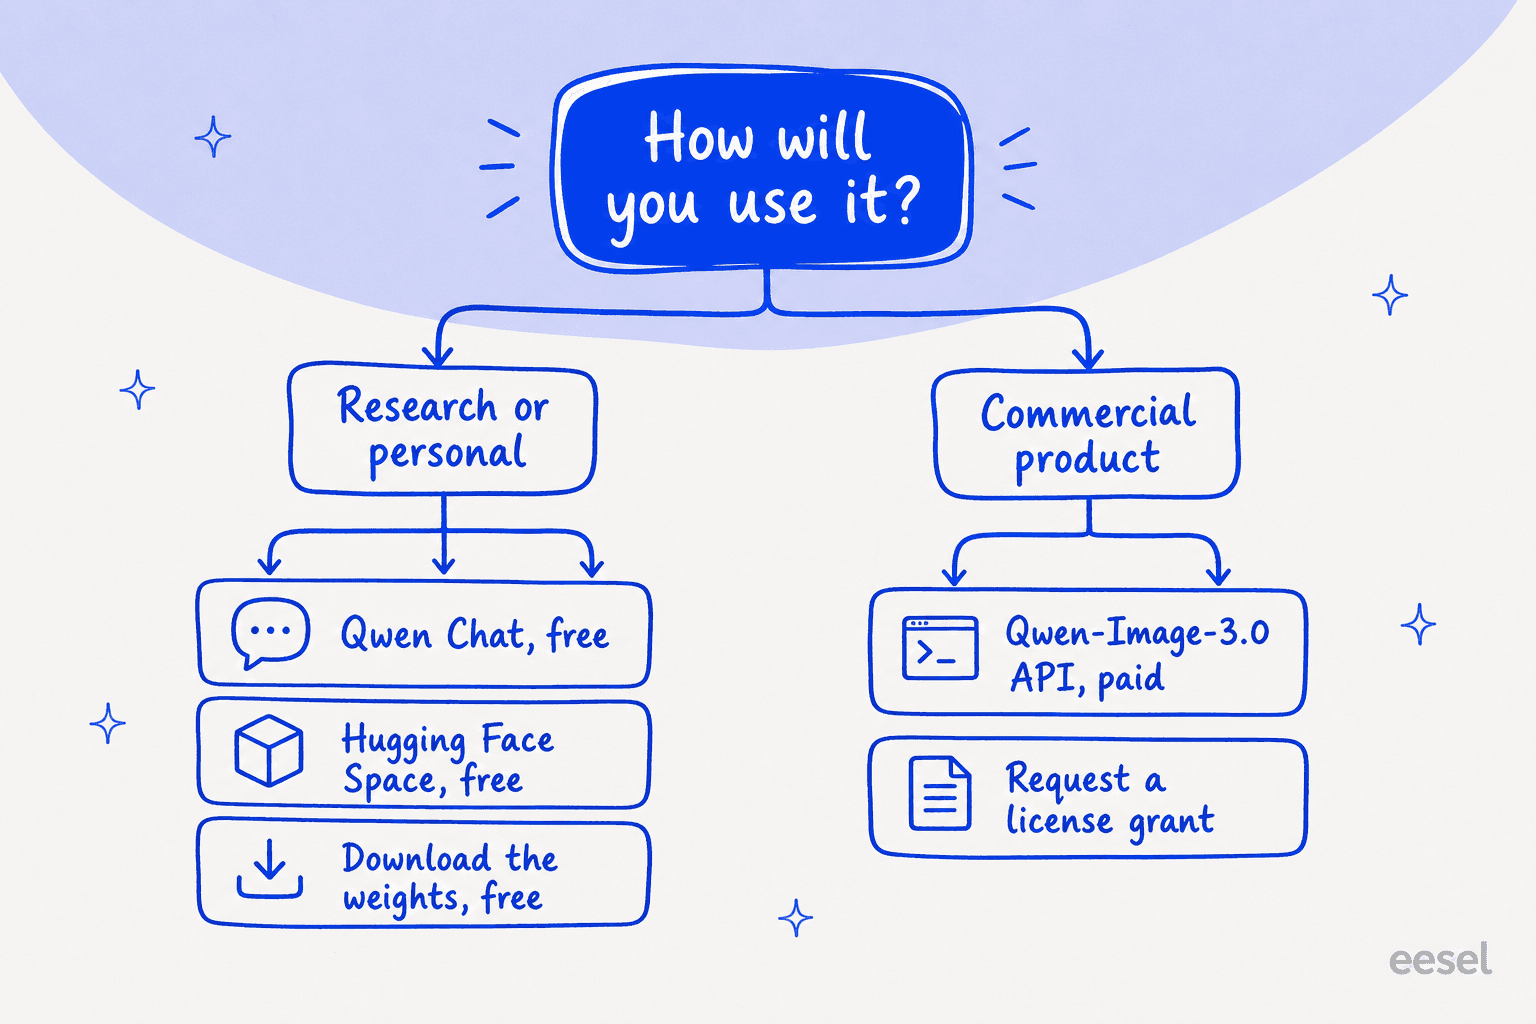
Si tu veux simplement l'essayer, les voies les plus rapides sont gratuites :
| Voie | Coût | Remarques |
|---|---|---|
| Hugging Face Space | Gratuit | Démo hébergée officielle du modèle 2.1 exact, sans installation, file d'attente limitée |
| Qwen Chat | Gratuit | Génération et édition d'images intégrées à l'assistant de Qwen |
| Poids Hugging Face | Téléchargement gratuit | Licence non commerciale, nécessite ta propre GPU |
| Poids ModelScope | Téléchargement gratuit | Mêmes poids, en miroir pour l'Asie |
API payante officielle (qwen-image-2.1) | Non proposée | Model Studio sert la génération d'images sous les identifiants 3.0 |
Pour une charge de travail commerciale, il te reste l'API payante, et elle tourne sur la gamme 3.0, pas la 2.1. Alibaba Cloud Model Studio la facture par image générée avec succès (tarifs Model Studio) :
| Modèle | Résolution | Prix de sortie |
|---|---|---|
qwen-image-3.0 | 1k et 2k | 0,03 $ / image |
qwen-image-3.0-pro | 1k | 0,04 $ / image |
qwen-image-3.0-pro | 2k | 0,075 $ / image |
Les images en entrée coûtent 0,003 $ chacune, les générations échouées ne sont pas facturées, et il y a un quota gratuit de 10 images valable 90 jours. Les hébergeurs tiers comme fal.ai et Replicate proposent Qwen Image 2.0, pas 2.1, très probablement parce que la licence non commerciale les empêche d'héberger la 2.1 pour un usage payant (Price Per Token).
Une dernière note pratique sur l'exécution en local : l'étiquette "7B" sous-estime le matériel. Il faut environ 16 GiB en Q8 et jusqu'à 17 GB pendant une exécution de 50 étapes, même si avec un déchargement sur le CPU un utilisateur l'a fait descendre à 3,05 GiB de VRAM. Les vitesses se situent autour de 5 à 25 secondes par image de 1 MP sur une carte récente, et environ 90 secondes pour un rendu 4K sur une 5080.
Ce que les gens disent vraiment
La réaction de la communauté est vraiment partagée, et les deux camps méritent d'être entendus. Les points positifs se concentrent sur le rapport taille-qualité et la vitesse. Depuis r/comfyui :
"I tested image editing with the default 25 steps at 2K resolution, and it takes about 2 minutes on a 5060 Ti. The output images are noticeably sharper than 2511, so I'd say this is a huge step forward. Considering the model is only 7B, I really can't ask for much more."

L'avis le plus équilibré que j'aie trouvé saluait un bon modèle local tout en nommant le défaut de qualité que les gens signalent sans cesse, une dominante jaunâtre synthétique (r/StableDiffusion) :
"In terms of being able to run it at a reasonable speed in a local environment, I'd say it's a good model. However, at commonly used resolutions ... the results did feel quite synthetic. In particular, the characteristic yellowish color tone and graininess made it feel like the model was trained on a lot of GPT Image data."
Et les louanges sur le rendu du texte sont contestées. Les mêmes images de comparaison qui ont impressionné un lecteur de Hacker News semblaient brouillées à un autre, qui a mieux noté Ideogram pour un texte propre. Un échec récurrent et très concret est apparu sur r/comfyui : un utilisateur "just can't get the model to generate infographics only in English ... it always adds some other parts I never prompted for in Chinese." Le respect du prompt sur des prompts de composition complexes est l'autre point faible signalé par les premiers testeurs.
Au final, un test indépendant GenAI Showdown l'a noté 7 sur 15 contre 4 sur 15 pour la version ouverte précédente, un vrai bond pour un tiers de la taille, avec des artefacts visibles de données synthétiques.
Faut-il utiliser Qwen Image 2.1 ?
Mon avis : c'est le modèle d'image à poids ouverts le plus intéressant du moment pour un profil précis, et un piège pour un autre. Si tu veux de la génération native de PNG transparents sur ton propre matériel, pour la recherche, le prototypage ou des projets personnels, télécharge-le aujourd'hui, parce qu'aucun autre modèle ouvert ne le fait aussi proprement, et du 7B sur une GPU grand public est un cadeau. Avec le bon sampler et le bon nombre d'étapes, plusieurs testeurs le classent comme la meilleure option locale.
Si tu produis du travail commercial, ralentis. La licence réservée à la recherche signifie que les poids gratuits ne sont pas un repas gratuit, et l'"API officielle" vers laquelle tu te tournerais est en réalité qwen-image-3.0, un autre modèle. Et si ton travail vit ou meurt de petits textes impeccables ou d'un rendu photographique propre et non synthétique, teste-le face à Ideogram ou à un plus grand modèle avant de t'engager ; la dominante jaunâtre et les problèmes de texte sur les longs prompts sont réels et rapportés par des gens qui voulaient l'aimer.
eesel pour transformer des modèles comme celui-ci en travail abouti
Un modèle, c'est de l'infrastructure. Qwen Image 2.1 te donne de la génération d'images brute, mais il te faut encore l'intégrer à un flux de travail, lui fournir du contexte et transformer sa sortie en quelque chose qui se publie. C'est le vide que eesel est conçu pour combler : au lieu d'un modèle brut, eesel te donne des coéquipiers IA prêts à travailler sur des missions définies, chacun arrivant avec les compétences, les intégrations et le contexte d'entreprise dont le rôle a besoin.
Le plus proche des modèles d'image est le rédacteur de blog IA d'eesel, un coéquipier qui recherche, rédige et illustre des contenus longs de bout en bout ; la génération d'images comme celle de Qwen est l'un des outils qu'il utilise en coulisses, pas quelque chose que tu dois piloter toi-même. Tu apportes le sujet et la marque ; il gère la chaîne, de la recherche à un brouillon prêt à publier avec ses visuels.
Si tu préfères embaucher la capacité toute faite plutôt que l'assembler à partir de poids et de scripts, tu peux essayer eesel gratuitement.
Questions fréquentes
Qwen Image 2.1 est-il gratuit ?
Il est gratuit à essayer et gratuit à exécuter. Tu peux l'utiliser sans frais dans Qwen Chat, dans le Space de démonstration Hugging Face officiel, ou en téléchargeant les poids ouverts et en les exécutant sur ta propre GPU. Le piège, c'est la licence : Qwen Image 2.1 n'est sous licence que pour un usage non commercial (recherche et évaluation), donc "gratuit à exécuter" ne veut pas dire "gratuit pour vendre avec".
Combien coûte l'API de Qwen Image 2.1 ?
Il n'existe pas de modèle d'API payant qwen-image-2.1. Model Studio d'Alibaba Cloud propose son API d'image commerciale sous les identifiants qwen-image-3.0, à 0,03 $ par image générée (1k et 2k) pour qwen-image-3.0 et jusqu'à 0,075 $ par image 2k pour qwen-image-3.0-pro. Si tu as besoin de Qwen Image 2.1 précisément pour un usage commercial, tu télécharges les poids et tu demandes une autorisation de licence distincte.
De quelle GPU ai-je besoin pour exécuter Qwen Image 2.1 ?
Malgré l'étiquette "7B", il est plus lourd qu'il n'y paraît. Les utilisateurs rapportent environ 16 GiB de VRAM en Q8 et jusqu'à 17 GB pendant une génération de 50 étapes, donc une carte de classe 3090, 4090 ou 5080 est confortable. Avec un déchargement sur le CPU, il tourne avec seulement ~3 GiB de VRAM, même sur un portable, même si une seule image 512x512 peut prendre environ trois minutes sur le CPU seul.
Qu'est-ce que la transparence native dans Qwen Image 2.1 ?
La transparence native signifie que le modèle peut produire directement, à partir d'un prompt, des images RGBA avec un vrai canal alpha, au lieu de te forcer à générer une image puis à détourer le fond. Il édite aussi les calques transparents et peut extraire un sujet d'une photo ordinaire sous forme de détourage transparent. C'est le changement phare de Qwen Image 2.1, qui intègre ce qui était auparavant un modèle distinct, Qwen-Image-Layered.
Qwen Image 2.1 est-il meilleur que les précédents modèles d'image Qwen ?
Sur la plupart des points, oui : il fait environ un tiers de la taille (7B contre 20B), ajoute la transparence native, édite avec jusqu'à 10 images de référence, et les testeurs de r/comfyui trouvent la sortie nettement plus nette que celle de la version 2511. Les contreparties sont la licence restrictive et un rendu synthétique, légèrement jaunâtre, que certains testeurs n'aiment pas.