Lo que la gente realmente quiere cuando dice "gestionar agentes de IA desde la terminal"
Yo desarrollo las integraciones y las APIs en eesel, así que esta frase de búsqueda me toca de cerca. Cuando alguien la escribe, casi nunca está pidiendo un prompt de chat en su shell. Es un ingeniero de plataforma, un líder de operaciones o un founding engineer que ya opera todo lo demás desde la línea de comandos, y al que le acaban de entregar un agente de soporte con IA que vive por completo detrás de un panel web. Se siente mal, de la misma forma en que se siente mal un servidor que solo puedes configurar haciendo clics.
El instinto es correcto, y bastantes ingenieros lo han dicho de forma más contundente de lo que yo lo haría:
"Devs spent decades building CI/CD, monitoring, rollbacks, and circuit breakers because deploying software and hoping it works was never acceptable. Then they built AI agents and somehow went back to hoping."

Ese es el picor detrás de la búsqueda. Todo lo demás en un stack moderno es código que puedes versionar, revisar, desplegar y revertir. Luego el agente de IA aparece como una página de ajustes donde alguien cambia el comportamiento en un navegador, sin registro de auditoría y sin forma de probar un cambio antes de que los clientes reales lo toquen. La terminal, aquí, es el atajo para toda una disciplina: si es un sistema en producción, debería poder operarse como tal.
Así que la pregunta real no es "¿hay una CLI?". Es "¿puedo tratar a este agente como trato al resto de mi infraestructura?". Eso replantea todo el asunto, y es el marco que vale la pena conservar para el resto de este artículo.
El cambio: un agente es un servicio que operas, no un bot que configuras
La mayoría del contenido sobre agentes de soporte con IA se detiene en la configuración inicial. Conecta tu centro de ayuda, elige un tono, actívalo. Pero la configuración es el día uno. El trabajo que realmente importa es el día dos y cada día después: la configuración se desvía, un artículo de la base de conocimiento queda obsoleto, se lanza un producto nuevo y el agente empieza a responder mal con total confianza. Gestionar un agente es un bucle, no un lanzamiento.
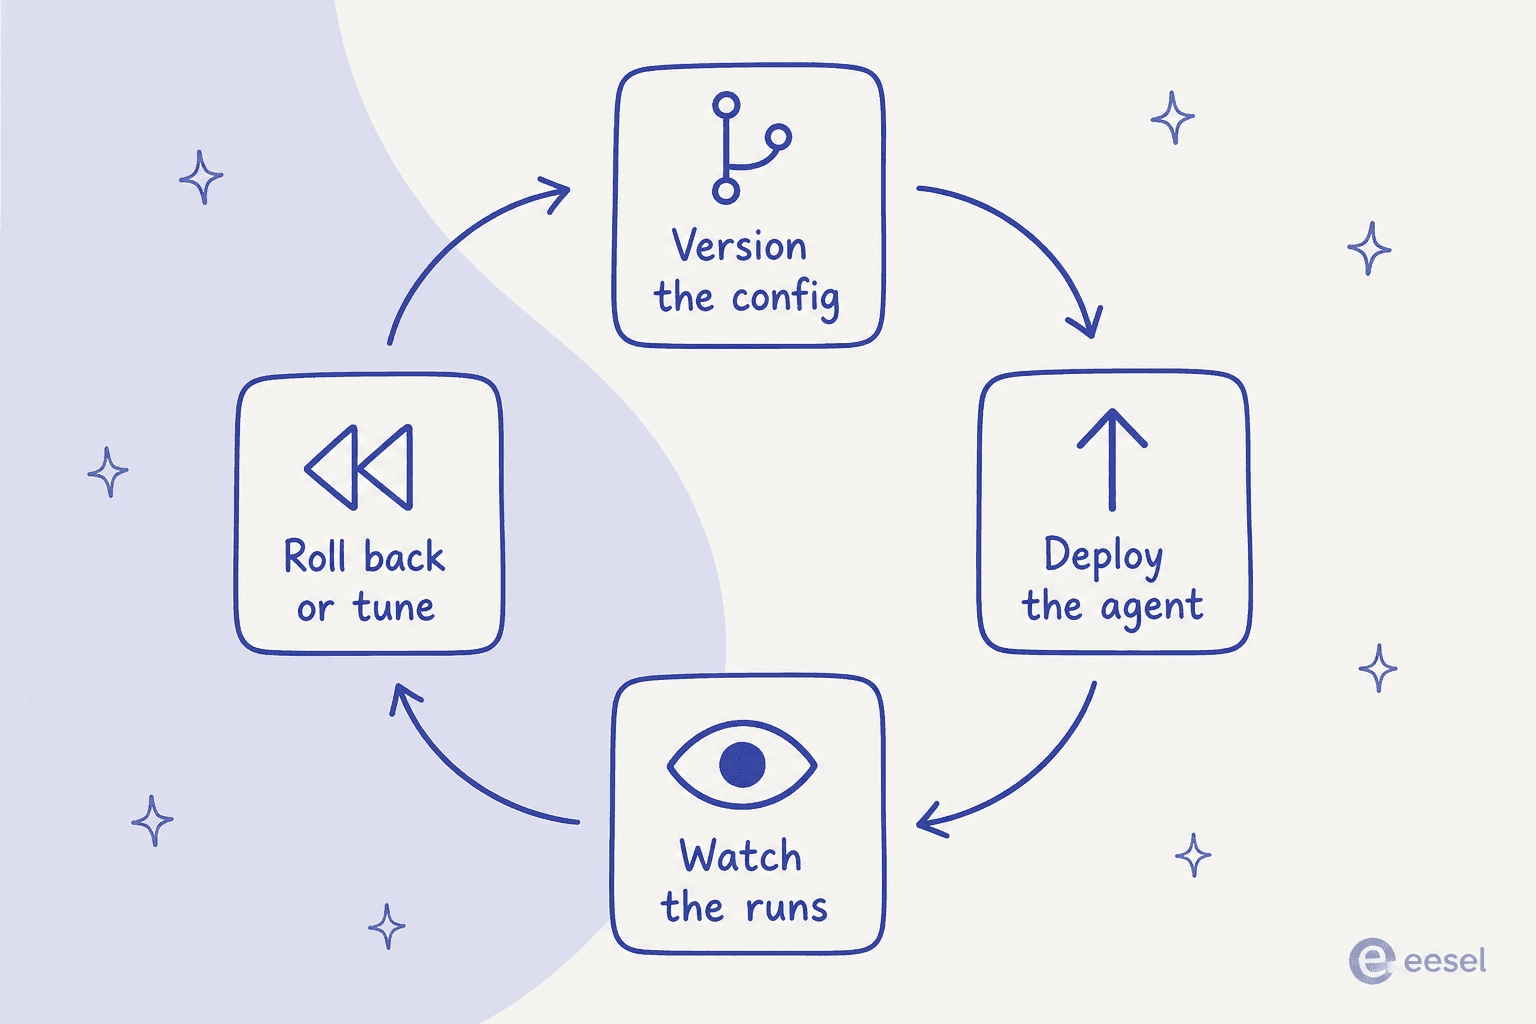
Ese bucle es exactamente para lo que "ops-as-code" te da un lugar. Versiona la configuración para que un cambio sea un diff que alguien pueda revisar. Despliega mediante un pipeline para que un rollout sea repetible. Vigila las ejecuciones para saber qué hizo realmente el agente. Revierte o ajusta cuando algo falla. Nada de eso es exótico; es como operarías cualquier servicio. La única razón por la que se siente novedoso para un agente de IA es que muchas herramientas se construyeron primero como paneles y nunca desarrollaron una superficie programable. Un equipo que construye un framework de agents-as-code lo dijo claramente:
"Orloj treats agents the way infrastructure-as-code treats cloud resources. You write a manifest that declares an agent's model, tools, permissions, and execution limits."

Una vez que adoptas ese marco, la terminal deja de ser el objetivo y se convierte en la interfaz hacia el objetivo. Quieres que el comportamiento del agente sea algo que puedas hacer diff, no algo que tengas que recordar que cambiaste el martes pasado.
Lo que realmente puedes scriptear hoy
Aquí está la parte práctica. Si tu herramienta expone una API o una CLI, una sorprendente cantidad de la gestión del agente ya funciona desde una shell. El patrón universal, sea cual sea el proveedor, es el mismo que usarías para cualquier servicio: el archivo de configuración es la fuente de verdad, la API es el destino del despliegue, y el control de versiones es el registro de auditoría. En su forma más cruda es solo curl y jq, por ejemplo para traer el último día de ejecuciones y contar las escaladas:
curl -s https://api.yourtool.com/v1/agent/runs \
  -H "Authorization: Bearer $AGENT_TOKEN" \
  --data-urlencode "since=$(date -u -v-1d +%FT%TZ)" \
| jq '[.runs[] | select(.outcome == "escalated")] | length'
Algunas herramientas se saltan el paso de REST puro y te dan una CLI de primera clase. eesel es una de ellas: su herramienta de línea de comandos es un binario npm real (@eesel/cli), y la documentación dice sin rodeos que la terminal es la interfaz prevista, no una puerta trasera: todo en el sitio "se puede hacer desde la terminal". Una sesión típica se ve así:
eesel login                 # browser once, or set EESEL_API_TOKEN for CI
eesel status                # what's connected, is knowledge current, plan
eesel activity              # every run, newest first (JSON by default)
eesel instructions          # read or edit the agent's standing rules
eesel approvals list        # actions held, waiting on a human
Cada comando imprime JSON, los errores vuelven como una línea estructurada en stderr, y configurar EESEL_API_TOKEN (más EESEL_AGENT_ID) permite que todo funcione sin interfaz en CI, sin inicio de sesión por navegador. Cuelga cualquiera de estas cosas de un cron job o una GitHub Action y tienes gestión de agente programada, revisable y versionada, sin necesidad de panel.
El truco está en el tamaño de ese "si". Muchas IA de soporte vienen sin una API que merezca ese nombre, así que el techo de lo que puedes scriptear lo fija enteramente el proveedor. Esto es lo más importante que hay que verificar antes de comprar: una herramienta sin superficie programable nunca podrá gestionarse desde la terminal, por mucho que lo desees. Vale la pena recorrer el espectro de gestionabilidad antes de comprometerte.
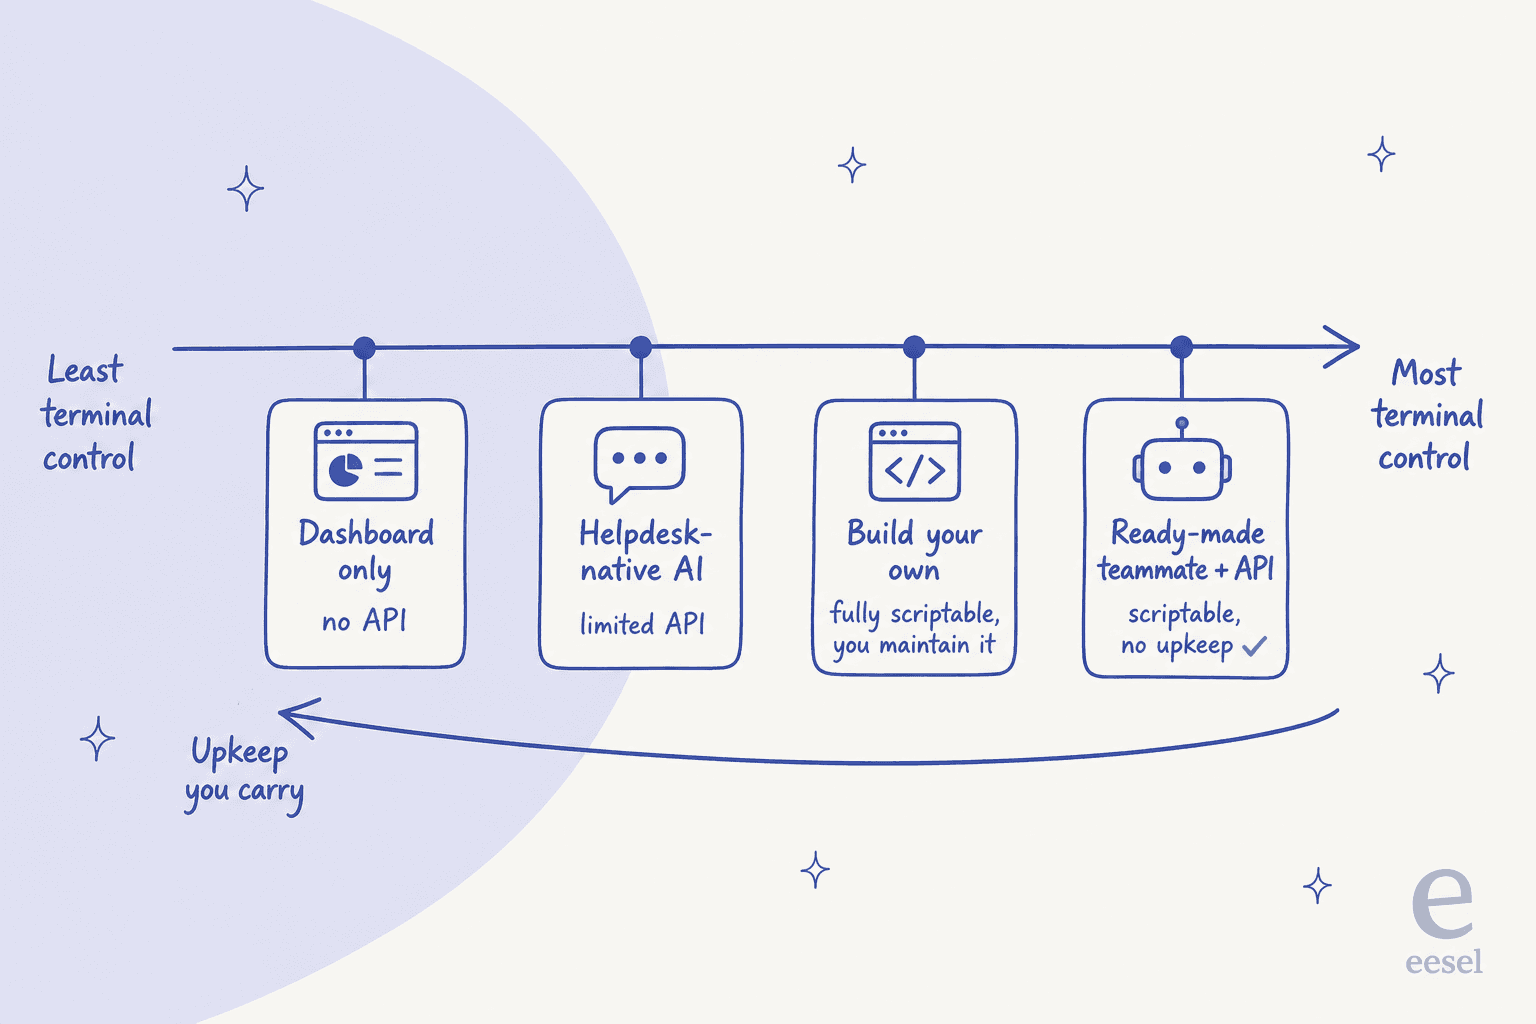
Hay un trade-off real a lo largo de esa línea. Construir tu propio agente sobre una API de modelo te da control total y mantenimiento total: eres dueño de la recuperación, de las guardrails, del arnés de evaluación y de cada aviso a las 2 de la madrugada cuando se despliega una regresión de prompt. Un agente listo para usar con una API adecuada te da la mayor parte de la programabilidad sin la cola de mantenimiento. Qué extremo prefieras depende de si gestionar el agente es tu trabajo o un impuesto sobre tu trabajo real. (Si estás sopesando el lado de construirlo tú mismo, profundizamos en ello en nuestros análisis de API de agente de soporte al cliente y API de helpdesk con IA.)
La mitad que la terminal no te puede dar: ver qué hizo el agente
Aquí está la trampa. Desplegar desde la línea de comandos es la mitad fácil, y te hace creer que tienes el control. Tu script se ejecuta, la API devuelve 200, tu terminal imprime exit 0, y sigues adelante. Pero un código de salida limpio te dice que el cambio se envió. No te dice nada sobre si el agente está haciendo lo correcto.
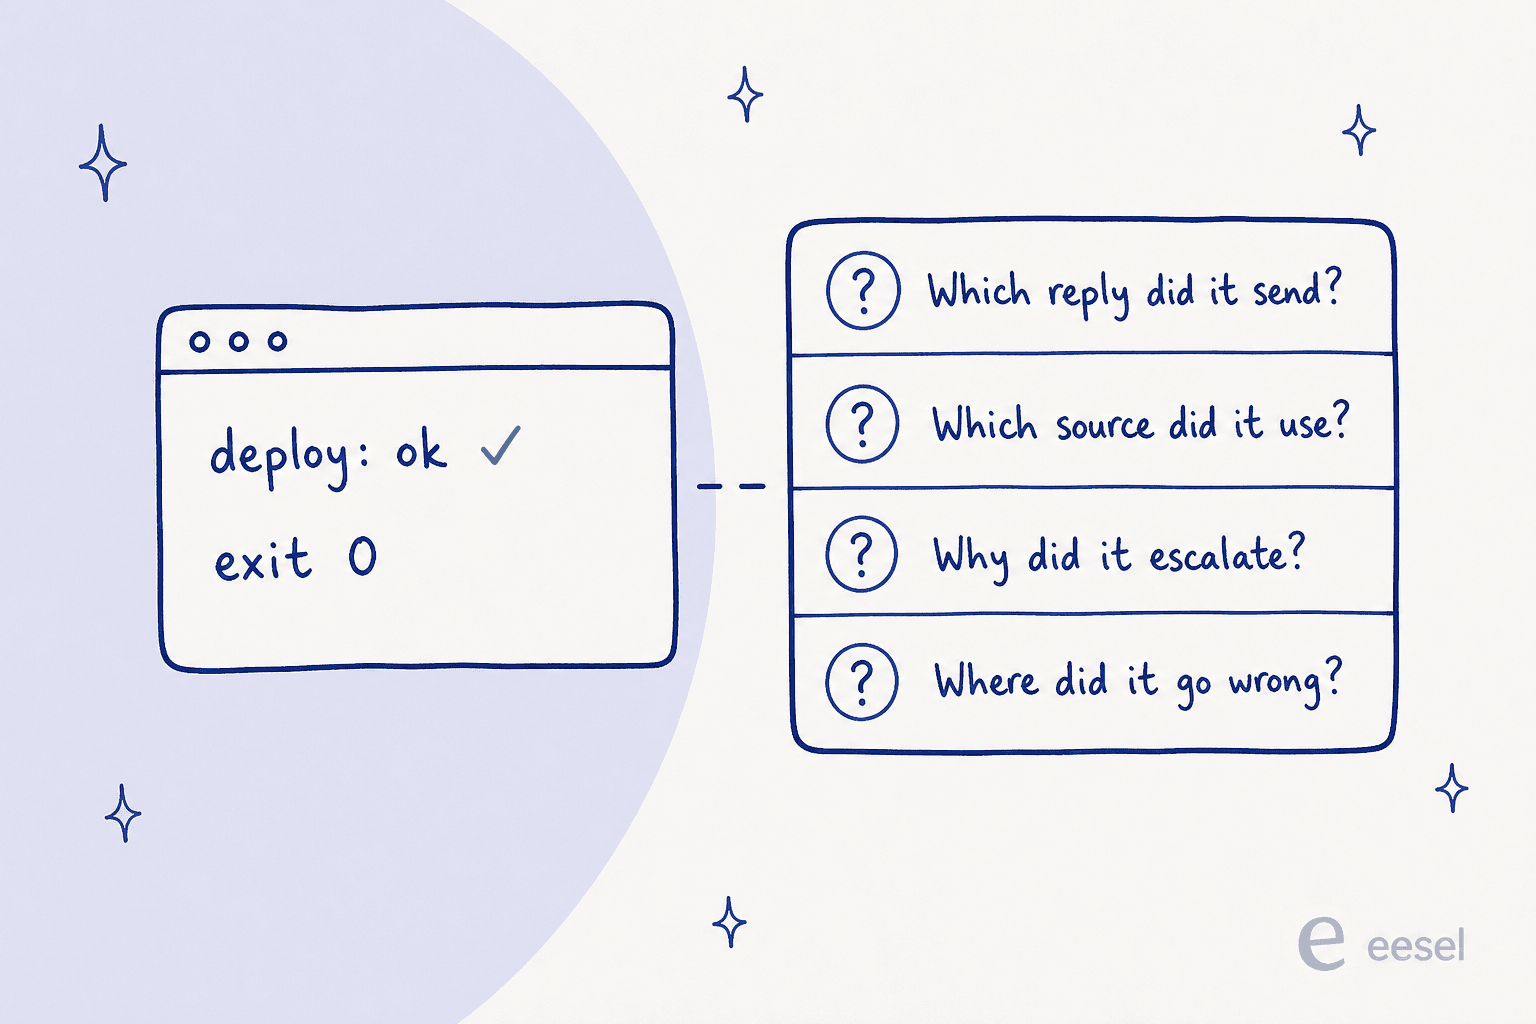
Aquí es donde muchos proyectos de agentes caseros se vienen abajo silenciosamente. Puedes automatizar el despliegue en una tarde; no puedes automatizar la necesidad de saber qué respuesta llegó a qué cliente, en qué fuente de conocimiento se apoyó el agente y por qué decidió escalar un ticket y responder otro. El relato de un ingeniero sobre seis meses de fallos en producción resumió perfectamente el patrón de falla:
"Agent works in testing. Works in the demo. Ships to production. Two weeks later - same input, different output. No error. No log that helps. Just a wrong answer delivered confidently."
Eso es observabilidad, y es la parte cara de construir y la parte fácil de omitir. Por eso el sentimiento en los foros de desarrolladores ha cambiado silenciosamente de "qué modelo" a "puedo ver qué hizo":
"honestly I'm starting to think observability is becoming more important than the model itself"
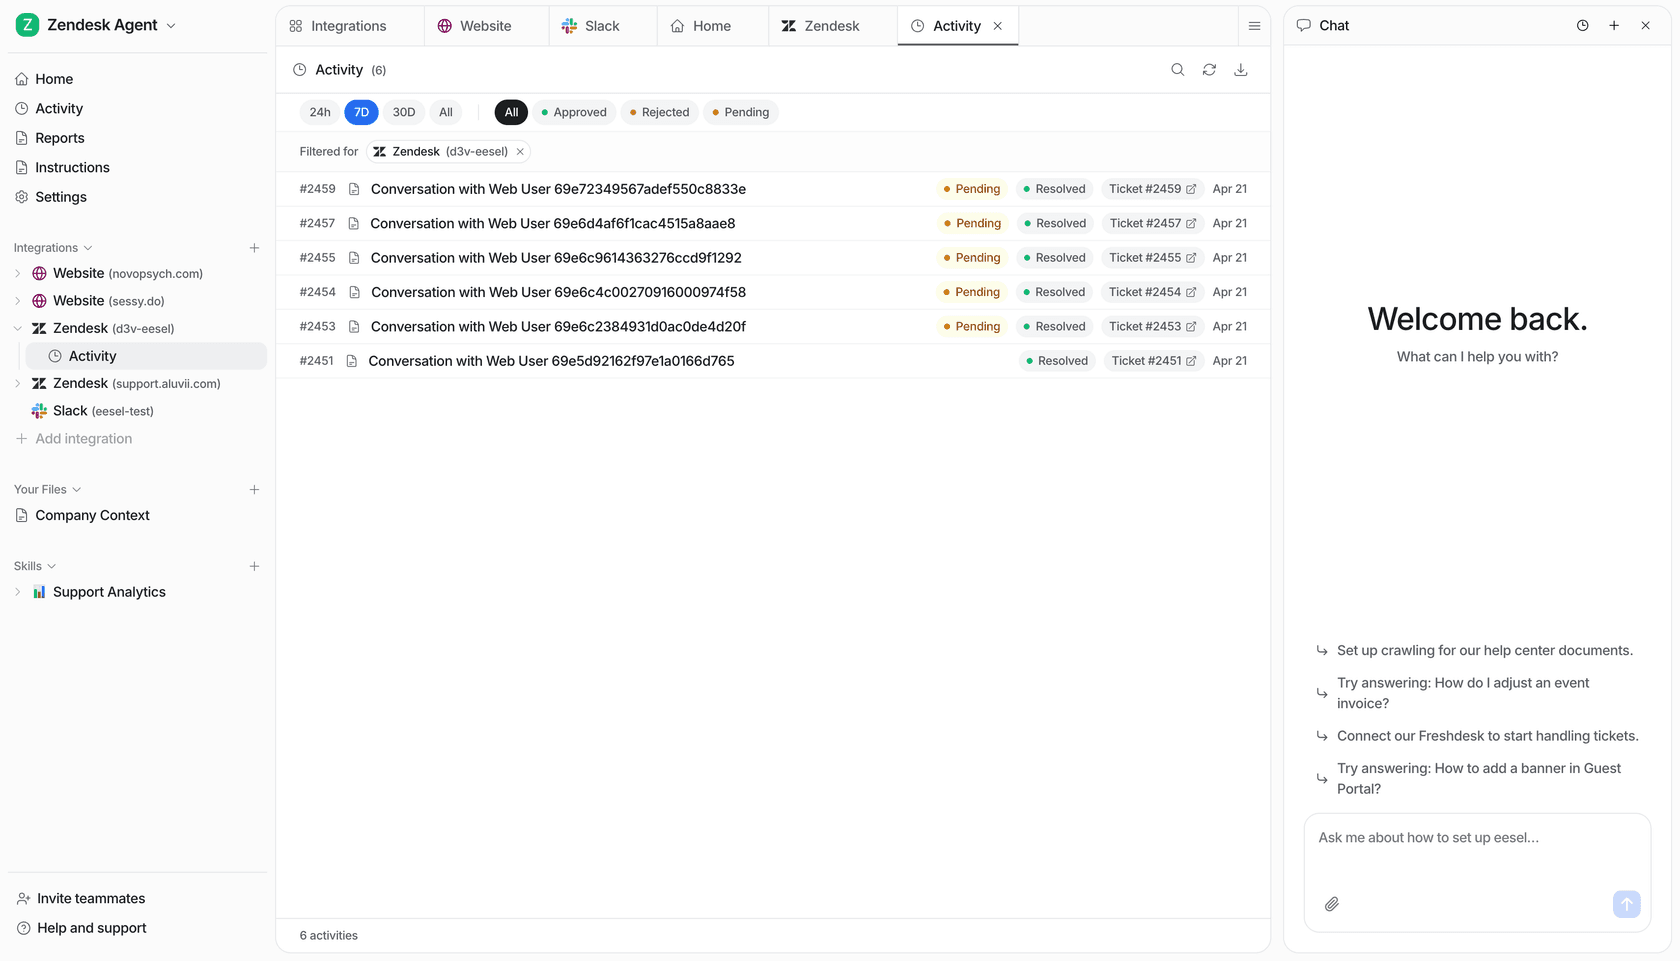
La lección que seguimos reaprendiendo: una terminal es tan útil como el historial de ejecuciones detrás de la herramienta que maneja. Si el agente puede desplegar pero no puede mostrarte su trabajo, has automatizado la parte que nunca fue el problema. Cuando evalúes una herramienta, exige tanto al lado de lectura como al de escritura. ¿Puedes obtener la transcripción completa de una ejecución? ¿Puedes ver la confianza y las fuentes detrás de una respuesta? ¿Puedes recibir una alerta cuando algo se desvía? Un panel que muestra esto de forma preciosa pero no expone nada a un script sigue siendo una caja negra para tu automatización.
Esta es la parte de la que estoy más orgulloso de nuestro lado: eesel activity lista cada ejecución empezando por la más reciente y te deja leer una en detalle completo, y como es el mismo JSON que muestra el panel, una respuesta nunca es algo que simplemente ocurrió en algún lugar que no puedes ver. Combínalo con eesel approvals, y una persona puede retener, aprobar o rechazar una acción en cola sin salir jamás de la shell.
Prueba antes de desplegar: el entorno de staging para agentes
Si tomas un solo hábito de operar servicios y lo aplicas a los agentes, que sea este: nunca envíes un cambio de configuración directamente a los clientes. En el software normal tienes un entorno de staging. Para un agente de IA, el equivalente es reproducir tus propios tickets pasados contra la nueva configuración y comprobar qué habría pasado, antes de que un solo cliente real lo vea. Un desarrollador que pasó por este ciclo describió la solución como pruebas de snapshot:
"What finally fixed the cycle for me was treating agent behavior like snapshot tests. Record the trajectory when it's working, save it as baseline, diff after every change. If the tool path shifted or output drifted - block the deploy before it hits prod."
La razón por la que esto importa no es teórica. En τ-bench, el benchmark de agentes con herramientas del equipo de investigación de Sierra, el mejor agente obtuvo menos del 50 % en tareas de soporte realistas, y un agente de GPT-4o que alcanzó su puntuación pass^1 cayó a aproximadamente 25 % en pass^8, un colapso de fiabilidad de ~60 % solo por volver a ejecutar la misma tarea ocho veces. La precisión titular no es el número que asusta. La inconsistencia entre ejecuciones sí lo es, y la única forma de detectarla antes de que lo hagan tus clientes es ejecutar primero la nueva configuración contra la realidad.
Aprendimos lo mismo por las malas, durante más de tres años poniendo IA en colas de soporte reales. Hemos visto a un bot que suena seguro de sí mismo repartir respuestas incorrectas en silencio, por eso ahora cada lanzamiento se simula primero contra tickets históricos. Esa simulación es tu suite de regresión. A nivel de comando, un flag --dry-run hace la versión pequeña de la misma idea: imprime la llamada exacta que haría una escritura sin enviarla, para que veas qué hace un cambio antes de que lo haga.
Este es también el límite honesto del scripteo. Puedes automatizar la reproducción. Puedes condicionar el despliegue al resultado. Lo que no puedes scriptear es la decisión de criterio sobre si una caída de 4 puntos en una categoría de tickets es aceptable por la ganancia de 10 puntos en otra. La terminal hace que la prueba sea barata y repetible; una persona sigue leyendo el resultado. Como lo he escuchado decir internamente: puedes scriptear el ticket, pero no puedes scriptear la respuesta.
Lo que cuesta operarlo, y dónde se esconde la factura
Operar un agente tiene un contador, y ese contador es donde "gestionar desde la terminal" se convierte silenciosamente en una pregunta de presupuesto. La unidad importa más que el número, porque las unidades no son iguales. Algunas herramientas cobran por resolución, algunas por conversación, algunas por token de API, y un script que dispara miles de llamadas a la API al día para consultar ejecuciones puede generar una factura sorprendente si te cobran por llamada.
La versión honesta de una tabla de costos para un agente de soporte se ve así:
| Enfoque | Qué scripteas | Quién lo mantiene | Modelo de costo aproximado |
|---|---|---|---|
| Herramienta solo con panel | Nada, sin API | El proveedor | Por resolución o por asiento |
| IA nativa de helpdesk | Configuración limitada vía la API del helpdesk | El proveedor | Por resolución (a menudo 1,50 a 2,00 $) |
| Construir la tuya propia sobre una API de modelo | Todo | Tú | Por token, en cada mensaje y reintento |
| Agente listo para usar con CLI (eesel) | Configuración, ejecuciones, acciones | El proveedor | 0,40 $ por ticket gestionado |
Los dos extremos son los interesantes. Construir el tuyo propio te da una factura por token que se cobra resuelva o no el ticket, más el costo salarial de la persona que mantiene la recuperación y las guardrails. Un modelo por ticket como el de eesel es plano por conversación gestionada sin importar cuántos mensajes lleve, sin cuota por asiento ni por plataforma, lo que hace que el gasto sea lo bastante predecible como para meterlo en un script y un presupuesto de verdad. A 1.000 tickets al mes eso son unos 400 $, y solo pagas por los tickets que enrutas al agente, no por los que tus personas siguen gestionando.
Prueba eesel para un agente de soporte que realmente puedes operar
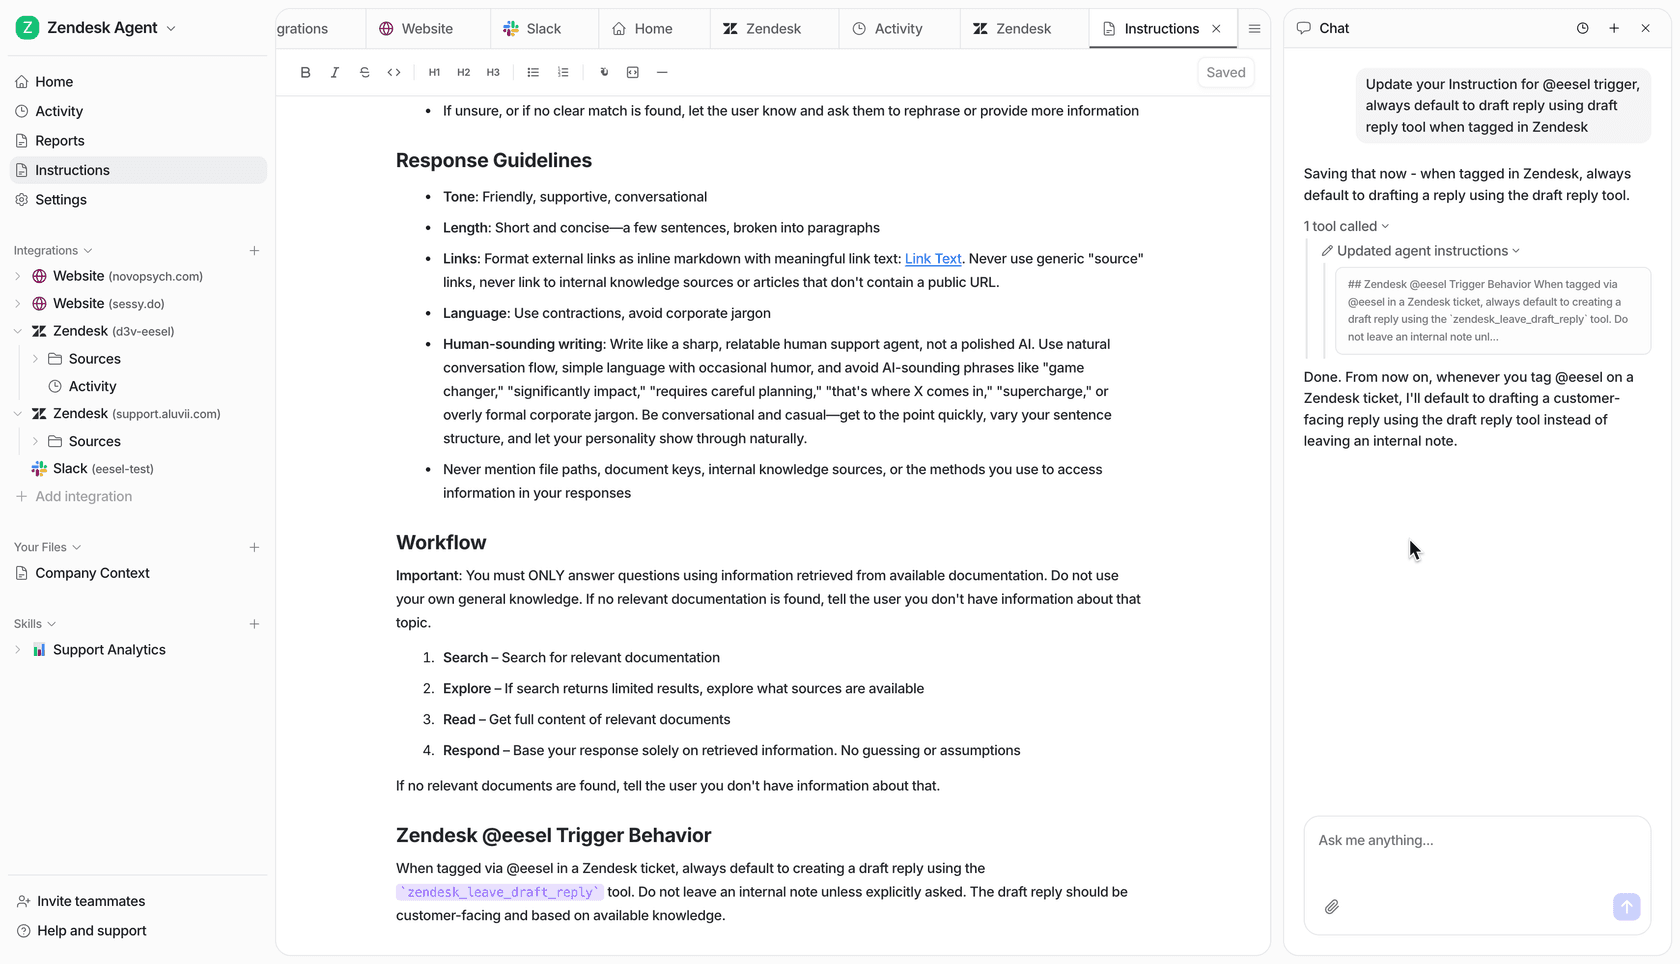
Si toda la razón por la que buscaste esto es que quieres operar un agente de soporte como un servicio en lugar de estar cuidando un panel, esa es la brecha para la que se construyó eesel. Es un compañero de equipo con IA que se une a tu helpdesk actual (Zendesk, Freshdesk, Front, Gorgias, Help Scout y otros), se entrena con tus tickets y documentos pasados, y te da una superficie programable genuina: una CLI, un servidor MCP por espacio de trabajo, webhooks y acceso de red saliente para que el agente pueda llamar a tus propios sistemas.
Puedes instalarlo y operarlo por completo desde una shell:
npx @eesel/cli init chat-bubble --site https://your-site.com
eesel chat "what's our refund policy?"   # test an answer before go-live
eesel activity                            # watch what it actually did
Los dos hábitos de este artículo que más importan ya vienen incorporados: simulas contra tus tickets históricos antes del go-live, y lo despliegas de forma gradual, manteniendo cada respuesta como borrador hasta que se gana el derecho de enviarse por sí sola. Y como cuesta 0,40 $ por ticket sin cuota por asiento, puedes empezar con unos pocos tipos de ticket y escalar desde un script en lugar de desde una llamada de ventas.
Puedes empezar gratis sin tarjeta de crédito, conectarlo a tu helpdesk en unos minutos y ver cómo gestiona tus tickets reales antes de comprometerte a nada. Ese es el punto: un agente que puedes probar, observar y operar, no uno en el que tienes que confiar a ciegas.
Preguntas frecuentes
¿Se puede gestionar realmente agentes de IA desde la terminal?
¿Qué significa 'ops-as-code' para un agente de soporte con IA?
¿Cómo despliego cambios en un agente de IA desde la línea de comandos?
¿Cuánto cuesta operar un agente de soporte con IA?
¿Qué pasa si un agente de IA da una respuesta incorrecta en producción?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.