KI-Kundenservice-API: der ehrliche Build-vs-Buy-Guide für 2026

Rama Adi

Katelin Teen
Zuletzt bearbeitet September 8, 2026
Was Menschen wirklich meinen, wenn sie von einer KI-Kundenservice-API sprechen
Wenn jemand nach "AI customer service API" sucht, steht er meist an einem von drei Punkten. Zu benennen, welcher das ist, erspart eine Menge unnötiges Lesen.
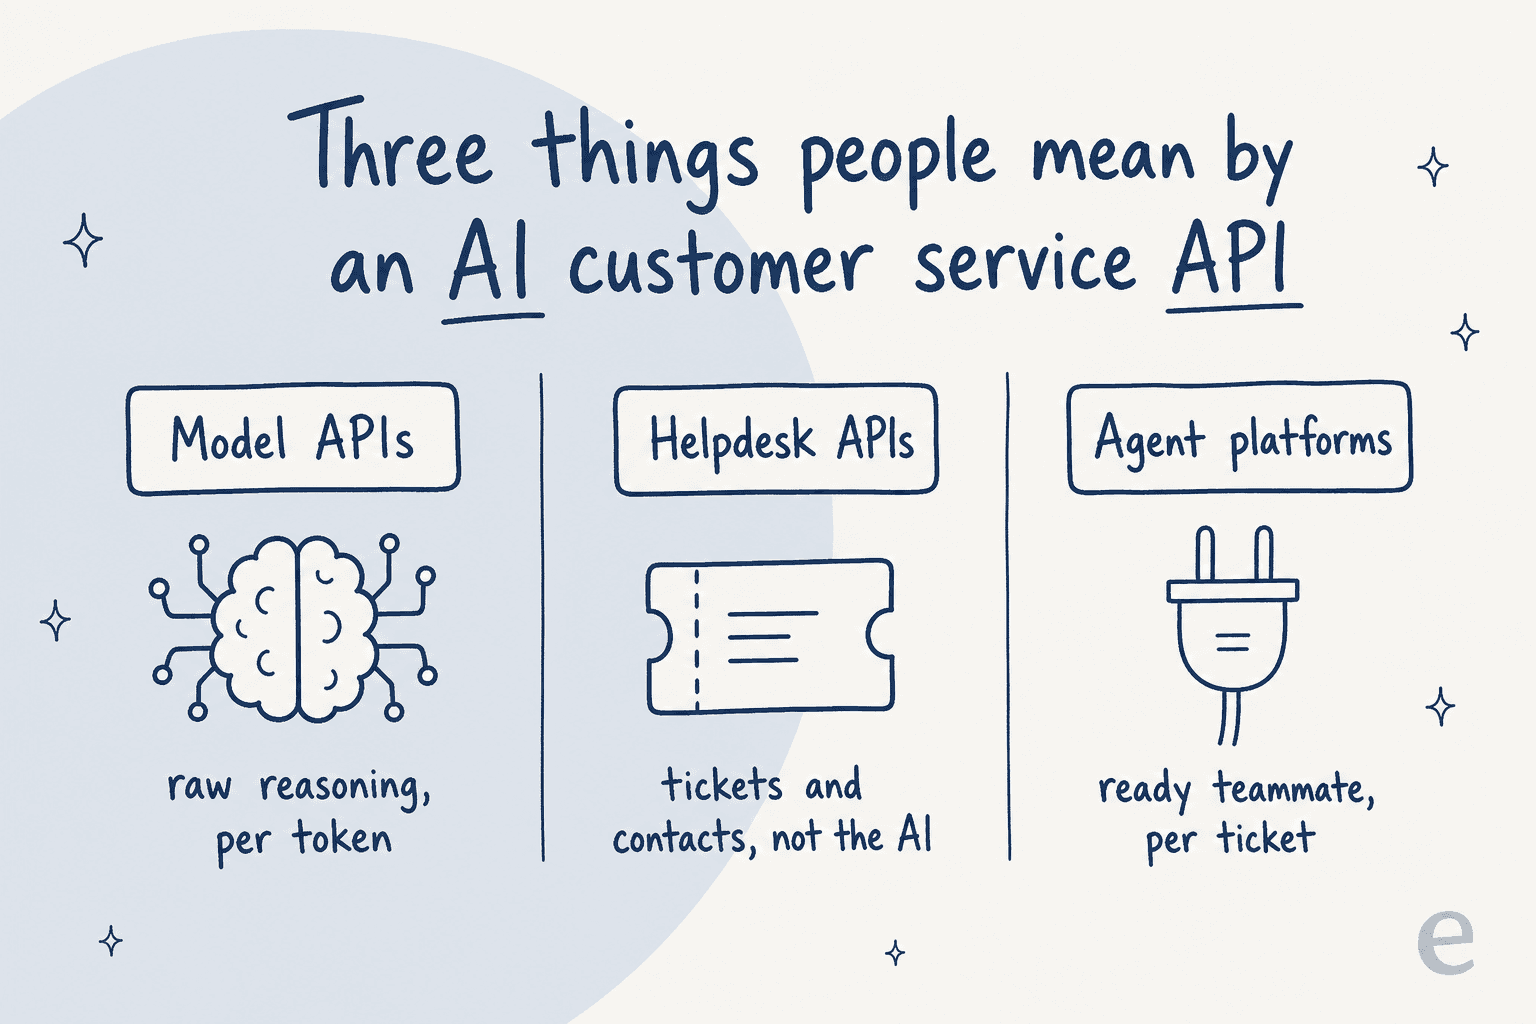
- Die Modell-API. Sie wollen den Agenten selbst auf OpenAI oder Claude aufbauen. Die API ist die reine Reasoning-Engine, abgerechnet pro Token. Alles, was ein Support-Produkt rund um das Modell leistet, liegt bei Ihnen.
- Die Helpdesk-API. Sie betreiben bereits Zendesk oder Freshdesk und wollen Ticket-Workflows programmatisch automatisieren. Damit bekommen Sie Tickets, Kontakte und Konversationen über REST, aber nicht die KI-Antwort selbst.
- Die Agenten-Plattform. Sie wollen einen funktionierenden KI-Agenten, ohne ihn selbst zu bauen, und suchen also nach etwas, das sich bereits mit Ihrem Stack verbindet. Genau hier ist ein KI-Helpdesk-Agent angesiedelt.
Das sind keine konkurrierenden Antworten auf dieselbe Frage. Es sind drei unterschiedlich große Mengen an Arbeit. Hier ist, was jede davon tatsächlich von Ihnen verlangt.
Weg 1: auf einer rohen Modell-API aufbauen
Das ist der Weg, auf den der Instinkt "wir bauen das einfach selbst" hindeutet, und er ist ein echter Fortschritt gegenüber einem regelbasierten Chatbot. Die Kehrseite: Eine Modell-API verkauft Ihnen die Reasoning-Engine, kein Support-Produkt.
Die aktuellen Token-Preise liegen bei den beiden großen Anbietern recht eng beieinander:
| Modell | Input / 1 Mio. Tokens | Output / 1 Mio. Tokens | Am besten für |
|---|---|---|---|
| GPT-6 Astra (OpenAI-Flaggschiff) | $10.00 | $50.00 | Anspruchsvolles Reasoning |
| GPT-5.6 Luna (OpenAI-Mini) | $0.20 | $1.20 | Hochvolumige Triage |
| Claude Opus 5 (Anthropic-Flaggschiff) | $5.00 | $25.00 | Komplexe Resolutions |
| Claude Haiku 4.5 (günstigstes Anthropic-Modell) | $1.00 | $5.00 | Schnelle, günstige Antworten |
Auf dem Papier sind die Mini-Modelle günstig genug, dass die Token-Kosten selten das sind, was ein Build-Projekt scheitern lässt. Was ein Build-Projekt scheitern lässt, ist alles, was der Token-Preis nicht abdeckt.
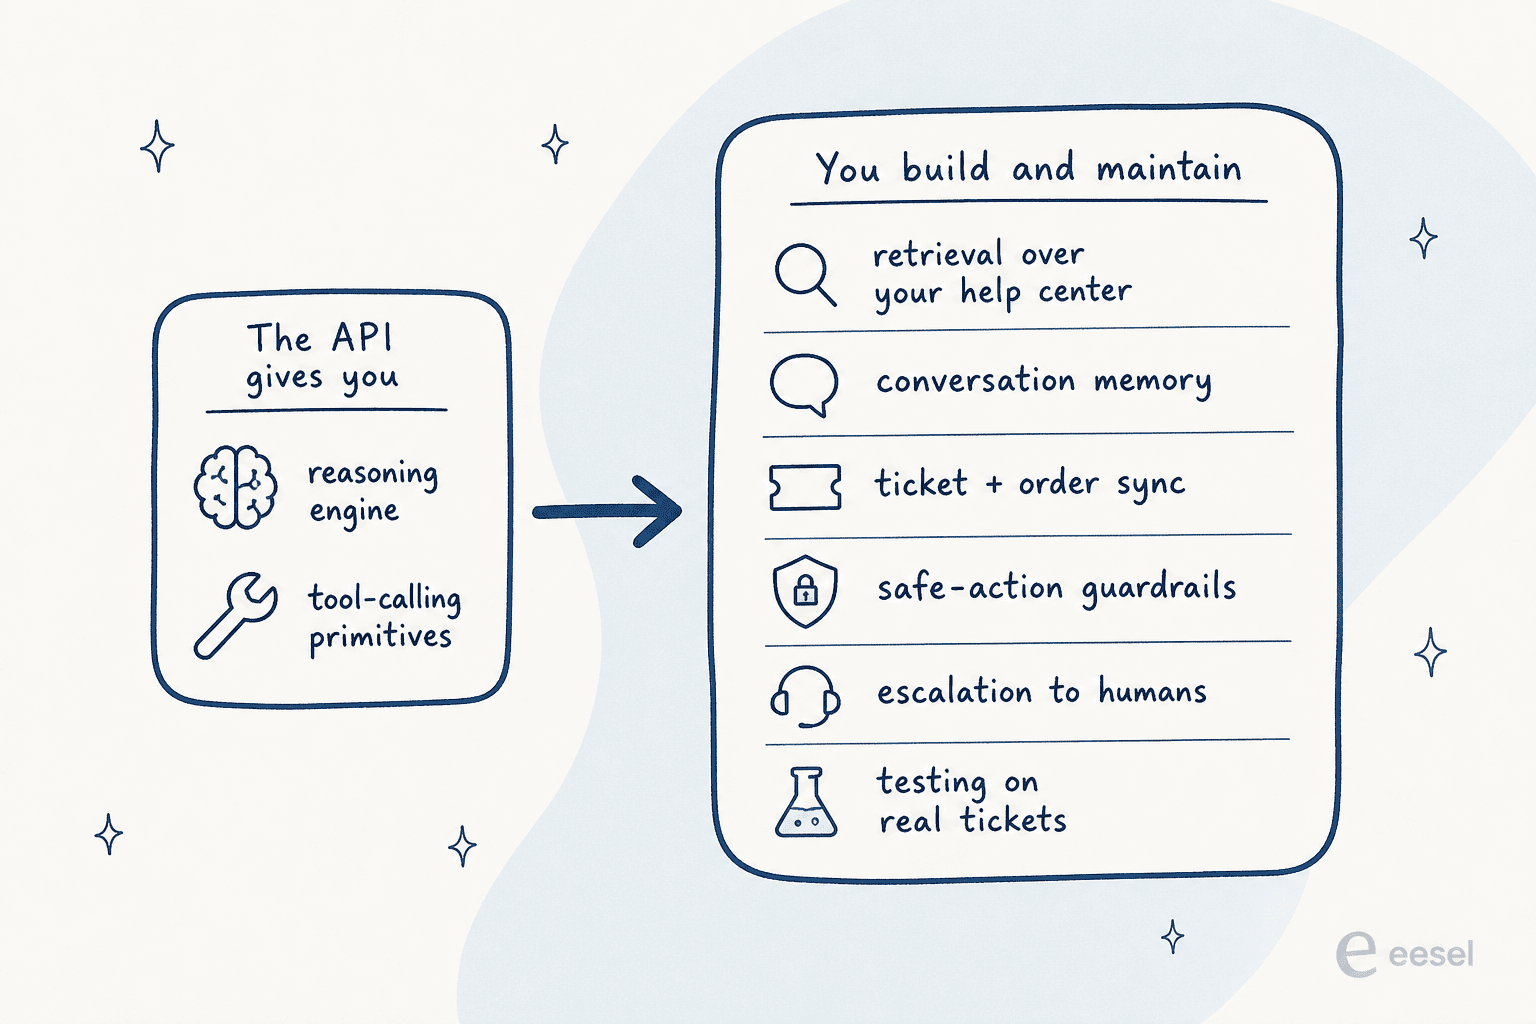
Gehen wir durch, was ein echter Support-Agent braucht, und wie viel davon die API tatsächlich liefert:
- Retrieval über Ihr Wissen. OpenAI gibt Ihnen ein gehostetes File-Search-Tool mit verwaltetem Vektorspeicher, sodass Sie die Retrieval-Infrastruktur nicht selbst betreiben. Aktuell halten und in Chunks zerlegen müssen Sie das Help Center trotzdem selbst. Bei Claude wird Retrieval über eigene Inhalte über Tools oder MCP verdrahtet, die Sie selbst bereitstellen – die RAG-Pipeline gehört also Ihnen.
- Tool-Calling und sichere Aktionen. Beide Plattformen lassen das Modell entscheiden, ob es
lookup_orderoderissue_refundaufruft. Anthropics Tool Use liefert einentool_use-Block zurück, Ihr Code führt die Operation aus und gibt eintool_resultzurück. Der Code, der tatsächlich Ihren Helpdesk anspricht, und die Autorisierung rund um eine Rückerstattung liegen bei beiden vollständig bei Ihnen. - Gesprächsgedächtnis. Die Claude Messages API ist pro Aufruf zustandslos; den Mehrfach-Turn-Kontext bauen Sie wieder auf, indem Sie den Verlauf erneut senden. Die Zustandspersistenz über Turns und Sessions hinweg ist Ihr Problem.
- Guardrails. OpenAI liefert ein echtes Guardrails-and-Human-Review-Framework mit Input-, Output- und Tool-Prüfungen sowie Human-in-the-Loop-Freigaben vor Seiteneffekten. Es ist aber ein Framework, das Sie konfigurieren, keine Support-Richtlinie. Es gibt keine fertige Regel "verspreche nie eine Rückerstattung über 200 $"; jede einzelne schreiben Sie selbst.
Nichts davon ist Kritik an den APIs. Sie sind exzellente Primitive. Der Punkt ist: "wir bauen es selbst" bedeutet, Retrieval, Gedächtnis, die Safe-Action-Schicht, die Eskalationslogik und den Test-Harness zu bauen und dann zu pflegen. Das ist ein Produkt, kein Wochenendprojekt.
MCP ist der neue Klebstoff, aber es bleibt Klebstoff
Das eine, was sich seit Ihrer letzten Kalkulation geändert hat, ist MCP, das Model Context Protocol. Beide Anbieter behandeln es inzwischen als Standardweg, über den ein Agent ein externes System erreicht. OpenAI stellt Connectors und Remote-MCP-Server über einen mcp-Tool-Typ bereit, und Anthropic bietet einen MCP-Connector direkt über die Messages API.
MCP bedeutet, dass Sie nicht mehr jede Integration von Hand neu schreiben müssen. Aber ein MCP-Server muss für jedes System, das Sie erreichen wollen, trotzdem existieren, und die Freigabe-Richtlinie rund um sensible Aktionen liegt weiterhin bei Ihnen. Das ist ein deutlich besserer Klebstoff als ein Haufen selbstgebauter Webhooks. Es bleibt aber Klebstoff, den Sie selbst zusammensetzen.
Weg 2: die eigene KI-API Ihres Helpdesks
Wenn Sie bereits einen Helpdesk betreiben, ist der zweite Instinkt, zu dessen API und der eingebauten KI zu greifen. Der überraschende Befund, nachdem ich alle drei Entwicklerdokumentationen hintereinander gelesen habe, ist durchgängig derselbe: Die öffentliche REST-API ist eine Datenebene für Tickets und Kontakte, und die KI-Beantwortung ist ein separates In-Produkt-Feature, das die API nicht als "Frag die KI"-Endpunkt offenlegt.
Zendesk hat mit Abstand die breiteste API: Support, Conversations, Help Center, Chat, Voice und Custom Objects, dazu eine eigene AI Agents API, mit der Sie KI-Konversationen und Eskalationen programmatisch verwalten können. Zwei Einschränkungen nennt die Dokumentation direkt: Sie "folgt nicht den allgemeinen Mechanismen und Konventionen der meisten Zendesk-APIs", und jeder KI-Aufruf wird weiterhin gegen den Automated-Resolution-Zähler gebucht. Die Rate-Limits liegen je nach Plan bei 200 bis 2,500 Anfragen pro Minute.
Freshdesk bietet eine saubere v2-REST-API für Tickets, Konversationen, Kontakte und Automatisierungsregeln, aber in der Ressourcenliste gibt es keinen Freddy- oder "Antwort generieren"-Endpunkt. Der KI-Agent für Freshdesk wird im produktinternen AI Agent Studio gebaut und ausgerollt. Die Rate-Limits gelten kontoweit und sind niedrig: 100 Aufrufe/Min. bei Growth, 400 bei Pro, 700 bei Enterprise.
Gorgias ist die gleiche Geschichte. Die REST-API deckt Tickets, Nachrichten, Kunden und Regeln ab, und der AI Agent berührt die API nur über systemverwaltete Felder AI Agent Outcome und AI Intent, die Sie lesen, aber nicht schreiben können. Das Rate-Limit liegt bei 40 Anfragen pro 20 Sekunden mit einem API-Key, 80 über OAuth.
Das Muster ist überall gleich: Sie können Daten über REST hinein- und herausbewegen, aber das eigentliche Antwortmodell wird in der produktinternen Oberfläche konfiguriert, und Sie zahlen dafür nach den Bedingungen des Anbieters. Wenn Sie sehen wollen, wie sich das in einem echten Setup abspielt, geht mein Zendesk-KI-Agenten-Guide den ganzen Ablauf durch.
Der Teil, den niemand auf die Preisseite schreibt: vier verschiedene Zähler
Sobald man akzeptiert, dass die KI nach den Bedingungen des Anbieters abgerechnet wird, kommt die nächste Überraschung: Keine zwei Anbieter messen dieselbe Einheit. Das ist der mit Abstand größte Grund, warum "was kostet eine KI-Kundenservice-API" keine saubere Antwort hat.
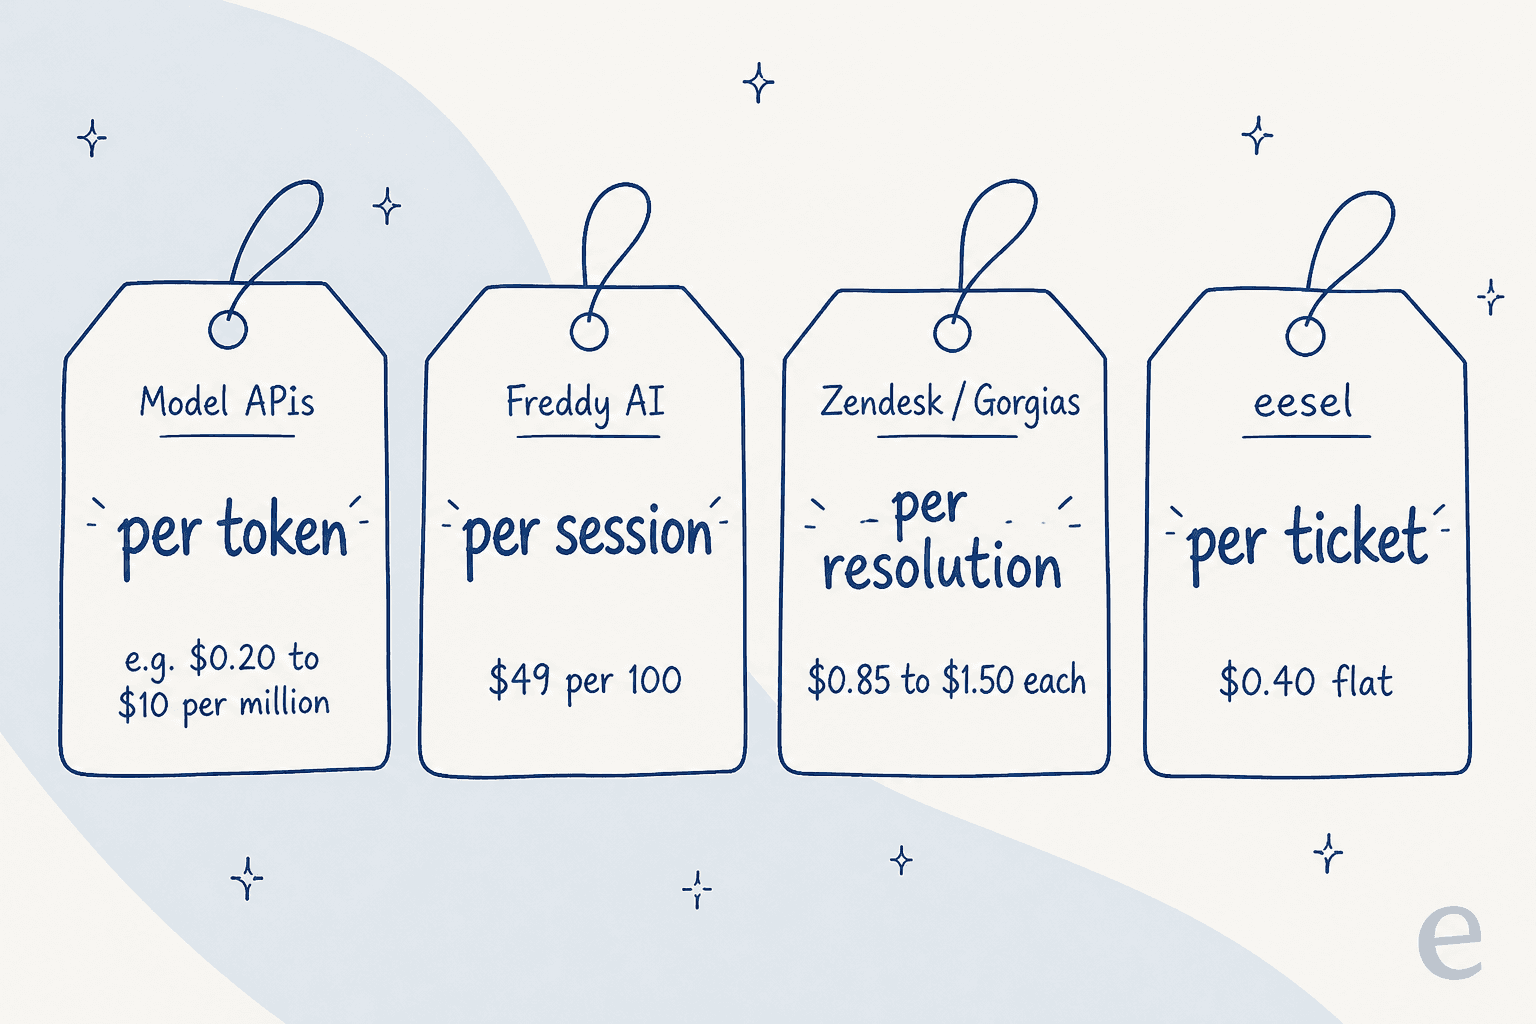
- Modell-APIs rechnen pro Token ab. Günstig pro Einheit, aber Ihre Rechnung ist eine Funktion aus Prompt-Größe und Traffic, den Sie selbst prognostizieren müssen.
- Freshdesk berechnet Freddy pro Session. 500 Sessions kostenlos, danach $49 pro 100 Sessions, zusätzlich zu Sitzplätzen pro Agent ($19 bis $89/Agent/Monat).
- Zendesk und Gorgias rechnen pro Resolution ab. Zendesk gewährt ein Plan-Kontingent (5 bis 15 Resolutions pro Agent und Monat) und berechnet danach eine Überschreitung auf Angebotsbasis. Gorgias nennt auf seinen Plan-Karten eine Gebühr von $1.50 nach Limit, in der Vergleichstabelle aber gestaffelte Sätze von $0.85 bis $1.00 – auf derselben Seite, was zeigt, wie "festgezurrt" diese Zahlen wirklich sind.
Ein Wort zu "Resolution", denn der Begriff leistet im Stillen eine Menge Arbeit. Zendesk zählt nur eine verifizierte Resolution (eine, die die LLM-Verifizierung bestanden hat) gegen Ihr Kontingent, und eine E-Mail-Konversation "endet" abrechnungstechnisch erst 72 Stunden nach der letzten Nachricht. Preise pro Resolution sind vertretbar, bedeuten aber, dass sich Ihre Rechnung danach richtet, wie der Anbieter ein erfolgreiches Ergebnis definiert – eine Zahl, die Sie nicht kontrollieren.
Hier eine schnelle Möglichkeit zu sehen, wie sich die Modelle pro Resolution und pro Ticket bei Ihrem eigenen Volumen unterscheiden:
Der Vergleich ist nicht perfekt eins zu eins (Anbieter mit Pro-Resolution-Abrechnung berechnen nur gelöste Konversationen, während ein Pro-Ticket-Zähler alles berechnet, was die KI berührt) – und genau das ist der Punkt: Sie können diese Tools preislich nicht vergleichen, ohne zuerst die Einheit zu normalisieren. Diese Normalisierungsarbeit ist es, die die Preisgestaltung von "KI-Kundenservice-APIs" so schwer greifbar macht.
Wann Selberbauen die richtige Wahl ist
Ich will dem Build-Weg gerecht werden, denn manchmal gewinnt er. Bauen Sie auf einer Modell-API auf, wenn Sie Engineers haben, die den Agenten etwas Unübliches tun lassen wollen, wenn Sie das Modell-Reasoning in Ihr eigenes Produkt statt in einen Helpdesk einbetten müssen, oder wenn Ihre Data-Governance-Regeln verlangen, dass die Retrieval-Schicht vollständig in Ihrer eigenen Infrastruktur liegt. In diesen Fällen ist die Kontrolle die Pflege wert, und MCP hat die Integrationsseite gegenüber vor einem Jahr deutlich weniger schmerzhaft gemacht.
Aber beachten Sie, wie eng das ist. Die meisten Teams, die nach "AI customer service API" suchen, wollen kein neuartiges Produkt bauen. Sie wollen, dass die KI ihr Help Center und vergangene Tickets liest, Routinefragen beantwortet, eine Bestellung nachschlägt und die schwierigen Fälle an einen Menschen übergibt. Das ist ein gelöstes Problem, und es intern nachzubauen kauft Ihnen meist vor allem einen Rückstand ein. Der abgewanderte Kunde, den ich oben zitiert habe, ist wegen einer kaputten Integration und langsamem Support gegangen und hat dann gesagt, man werde selbst bauen. Die Ironie: Eine kaputte Integration ist genau die Art von Wartung, auf die man sich einlässt, wenn man die gesamte Pipeline selbst baut.
eesel ausprobieren: der API-Klebstoff, schon fertig
Wenn Sie ins Lager "ich will einfach einen funktionierenden Agenten" gehören, ist das hier der Pitch, und ich halte ihn ehrlich. eesel ist ein KI-Support-Agent, der sich in den Helpdesk einklinkt, den Sie bereits betreiben, statt ihn zu ersetzen. Er liest Ihre Zendesk-, Freshdesk-, Gorgias- und Help-Scout-Daten über deren eigene APIs, trainiert mit Ihren vergangenen Tickets und Ihrem Help Center und reiht sich als Teammitglied in die Warteschlange ein – Sie schreiben also nicht die Retrieval-Schicht, den Ticket-Abgleich oder die Eskalationslogik.
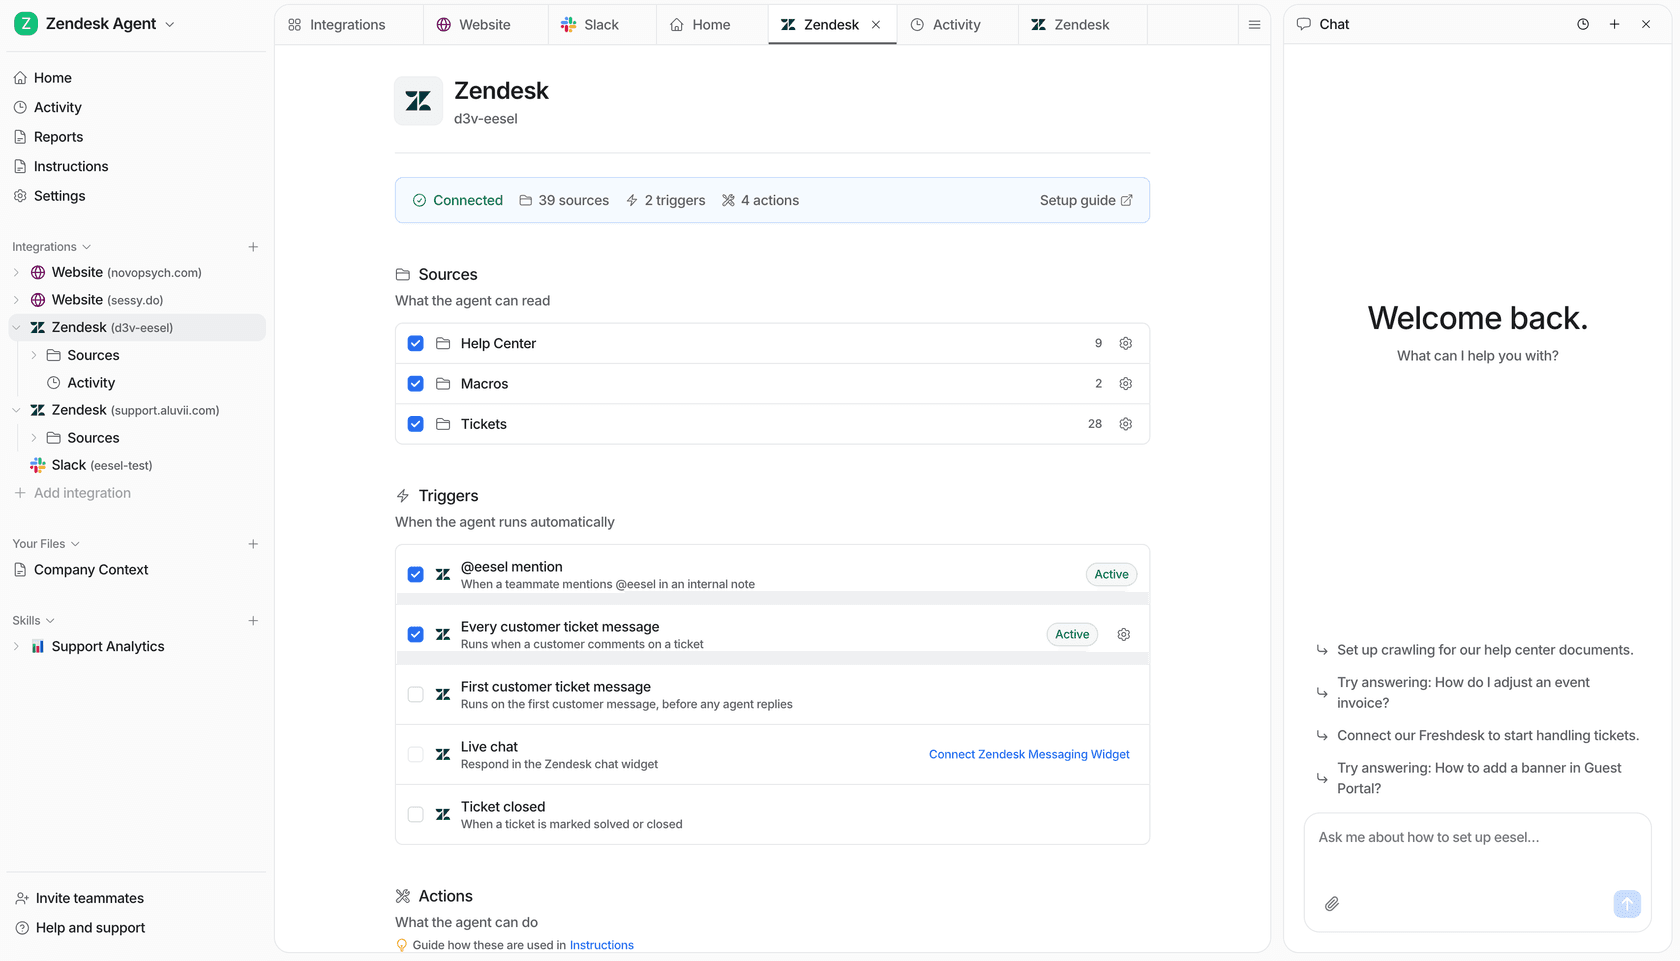
Zwei Dinge übernimmt eesel, die Sie beim rohen API-Weg von Grund auf selbst bauen müssten. Erstens: Simulation an Ihren historischen Tickets vor dem Go-live, sodass Sie die Resolution-Rate an Ihren eigenen Daten sehen, statt einen Schalter umzulegen und zu hoffen. Diese Gewohnheit habe ich mir auf die harte Tour angeeignet, nachdem ich selbstsichere Bots in Live-Warteschlangen falsche Antworten geben sah. Zweitens ein Abrechnungsmodell, das Sie nicht prognostizieren müssen: pauschal $0.40 pro Ticket, ohne Gebühr pro Sitzplatz oder Plattform, sodass die Kosten mit den bearbeiteten Tickets skalieren statt mit einer Token-Zahl oder der privaten Definition von "Resolution" eines Anbieters.
Es ist nicht das richtige Tool, wenn Sie das Modell wirklich mit eigener Governance in Ihr eigenes Produkt einbetten müssen; das ist der Build-Weg, und die Modell-APIs oben sind dort Ihr Ausgangspunkt. Aber wenn das Ziel ein KI-Agent ist, der diese Woche live auf Ihren echten Tickets läuft: Ein deutsches Kreditvergleichsportal, mit dem ich arbeite, betreibt sein Zendesk inzwischen vollständig automatisiert über Webhooks bei rund 27,000 Konversationen im Monat, und eine App für Fahreranalysen hat im ersten Monat 73% ihrer Tier-1-Tickets gelöst. Sie können kostenlos starten mit $50 Nutzungsguthaben, ohne Kreditkarte, und Ihre eigenen Zahlen sehen, bevor Sie sich festlegen.