

Gemini 3.5 Transcribe ist Googles erstes Speech-to-Text-Modell unter der Marke Gemini. Nachdem ich mich tief in die Doku, die Benchmarks und die Erfahrungen aus dem Produktiveinsatz eingearbeitet habe, lautet mein kurzes Fazit: Es ist ein starkes, günstiges verwaltetes Modell mit einem echten Haken.
Das Gute: etwa 0,005 $ pro Minute für das Dateimodell (grob ein Drittel von Googles eigener Cloud Speech-to-Text Standardstufe), eine Wortfehlerrate von 2,6 % bei sauberem englischem Audio, integrierte Sprechererkennung, Wort-Zeitstempel und automatische Spracherkennung für über 85 Sprachen.
Der Haken: Smart transcription, das Feature, das Google am stärksten bewirbt, schreibt Ihre Sprache um, um sie aufzuräumen, und hält manchmal etwas für Störgeräusch, das Sie nicht so sehen. Tester stellten fest, dass es präzise Formulierungen weglässt. Die Sprechererkennung wird außerdem ab drei Sprechern wackelig, was bei Meeting-Notizen zählt.
Für wen es passt: Diktate, Aufnahmen mit einer Stimme und kostenbewusste Transkription in großem Umfang. Wer woanders suchen sollte: wer wortgetreue Ausgabe braucht (Recht, Forschung) und Meetings mit mehreren Sprechern, bei denen Spezialisten wie Deepgram oder ElevenLabs Scribe weiter vorn liegen. Und denken Sie daran: Für ein Support-Team ist Transkription nur die Eingabeschicht, Sie brauchen weiterhin etwas, das das Ticket tatsächlich löst, und genau dafür ist ein AI-Helpdesk-Teammate da.
Was Gemini 3.5 Transcribe ist, kurz erklärt
Bisher bedeutete Audio-Transkription bei Google eines von zwei Dingen: die Speech-to-Text API von Google Cloud (die Chirp-Reihe) oder eine Audiodatei an ein allgemeines Gemini-Chatmodell zu übergeben und freundlich zu bitten. Gemini 3.5 Transcribe, angekündigt um den 26. August 2026, ist das erste Modell, das Google speziell für diese Aufgabe gebaut hat, und es ist als Nachfolger von Chirp 3 positioniert.
Googles Modellseite beschreibt es als „a speech-to-text model based on Gemini's audio understanding capabilities“ mit Spracherkennung, Sprechererkennung, Zeitstempeln auf Wortebene, Smart transcription und Anpassung an eigenes Vokabular. Es sind eigentlich zwei Endpunkte: gemini-3.5-transcribe für vorab aufgenommene Dateien und gemini-3.5-transcribe-live für Echtzeit-Streaming. Die vollständige Preis- und Spezifikationsübersicht habe ich separat aufbereitet; dieser Test dreht sich darum, ob es tatsächlich gut ist.
Hier ist die Modellseite selbst, bei der die meisten Entwickler anfangen werden:
Ein Hinweis, bevor Sie darauf aufbauen: Googles eigene Doku ist sich über den Status nicht einig. Die Modellübersicht markiert es als „New Stable“, während der Launch-Blog von „in public preview“ spricht. Es läuft bereits in Verbraucherprodukten (Rambler auf Gboard, die Gemini-App auf macOS), betrachten Sie es also als fast produktionsreif, aber nicht vollständig stabil.
Wie ich es bewertet habe
Ich hatte keine monatelangen Produktionslogs, daher sage ich offen, worauf dieser Test beruht: Ich habe die Model Card und die Preisdoku vollständig gelesen, Googles Benchmark-Angaben daraufhin geprüft, wie sie dargestellt werden, und mich stark auf Entwickler gestützt, die das Modell in den Tagen nach dem Start per A/B-Test gegen Whisper, Deepgram und ElevenLabs Scribe verglichen haben. Bei Transkription können die saubere Benchmark-Zahl des Anbieters und Ihr reales Ergebnis weit auseinanderliegen, deshalb zählt das Signal der Community genauso viel wie das Datenblatt.
Kurz gesagt: Die Zahlen sind echt und gut, der Preis ist sehr wettbewerbsfähig, und die lautesten Beschwerden drehen sich um zwei konkrete Dinge. Gehen wir sie der Reihe nach durch.
Genauigkeit: Die Laborwerte sind großartig, echtes Audio ist der Test
Auf dem Papier ist dieses Modell sehr gut. Google nennt die folgenden Wortfehlerraten, alle zugeschrieben Artificial Analysis:
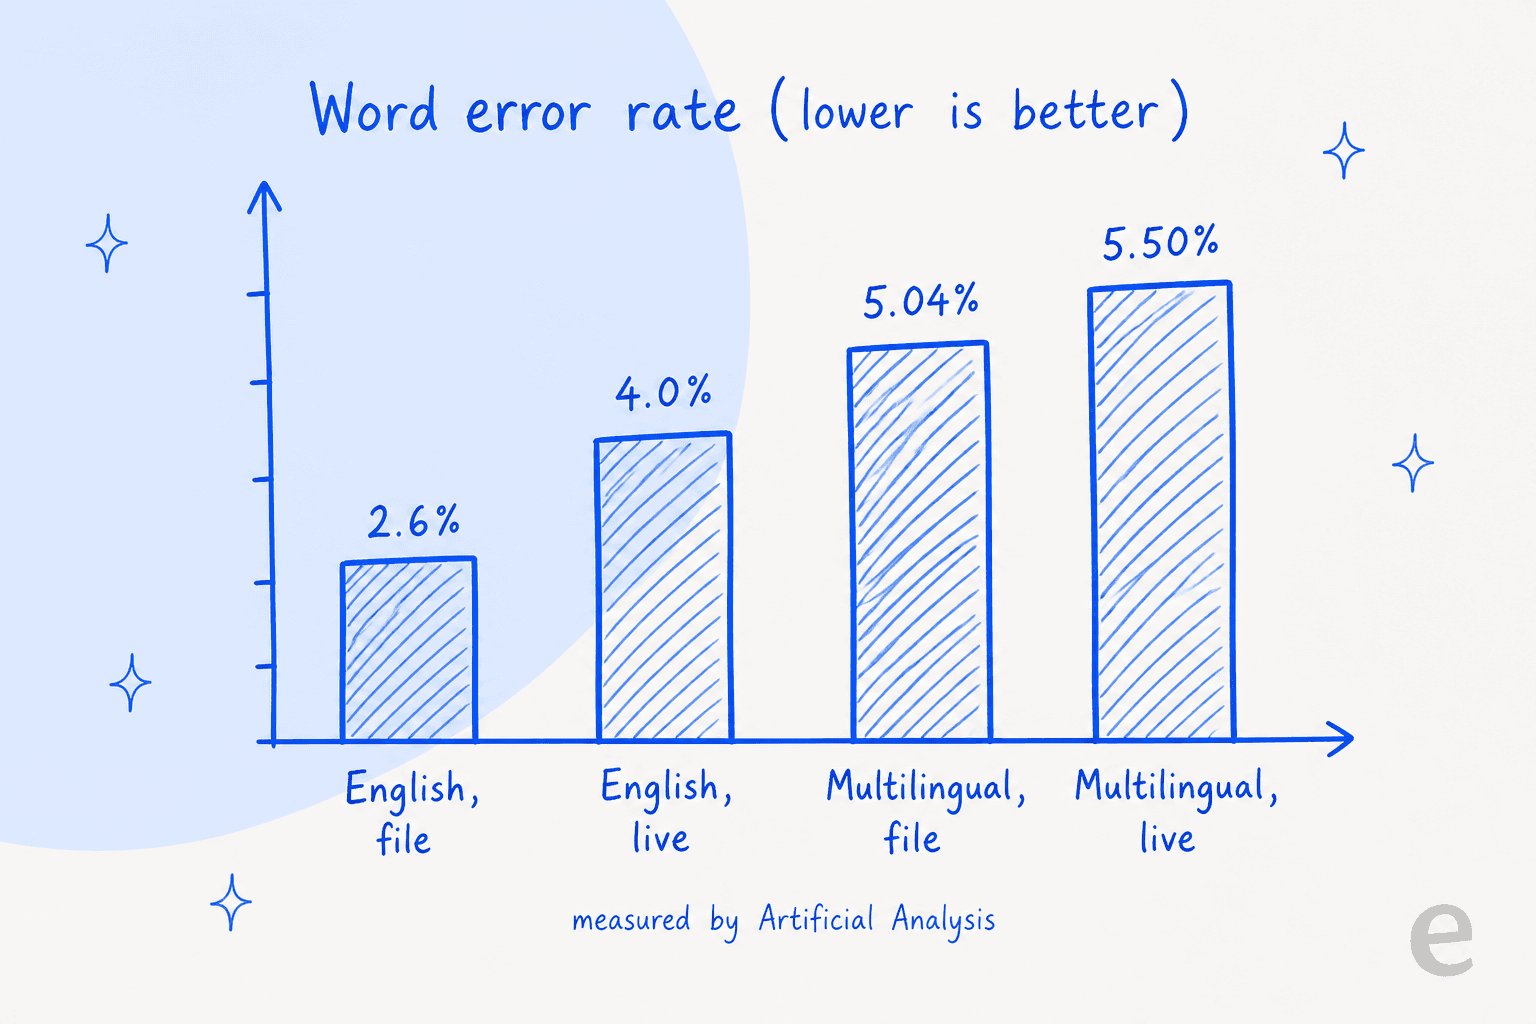
Eine Wortfehlerrate von 2,6 % bei nicht gestreamtem Englisch bedeutet etwa ein falsches Wort auf vierzig, was hervorragend ist. Google behauptet außerdem, die Zeit bis zum finalen Transkript verbessere sich um 70 % gegenüber Chirp 3, doch diese Darstellung stammt von Google selbst, ich würde sie also als Herstellerangabe und nicht als unabhängigen Benchmark einordnen.
Das aussagekräftigere Signal ist, was Leute beim Einsatz mit eigenem Audio festgestellt haben. Und hier gehen die Meinungen auseinander. Auf der stark positiven Seite war das so ziemlich das glühendste Feedback, das man bekommen kann:
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."

Aber im Launch-Thread vergleichen viele Leute und kommen zu kühleren Ergebnissen. Einer, der genau das beruflich macht, ist zu einem Hybrid-Aufbau zurückgekehrt:
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
Meine Einschätzung: Die Wortfehlerrate in einem sauberen Benchmark und die Wortfehlerrate bei Ihrem tatsächlichen Audio (verrauschte Anrufe, verschiedene Akzente, Durcheinanderreden) sind zwei verschiedene Tiere. Die Laborwerte sind ein starker Ausgangspunkt, kein Versprechen. Wenn Sie es für echte Arbeit prüfen, testen Sie es an Ihren eigenen Aufnahmen, bevor Sie eine Pipeline darauf festlegen.
Der Haken bei Smart transcription
Das ist der Teil des Tests, den ich unterstreichen würde. Smart transcription ist das Feature, auf das sich Google am stärksten stützt, und zugleich die häufigste Beschwerde. Ein Rohtranskript menschlicher Sprache ist unordentlich: Leute sagen „ähm“, brechen Sätze ab, nuscheln Zahlen. Smart transcription räumt das automatisch auf.
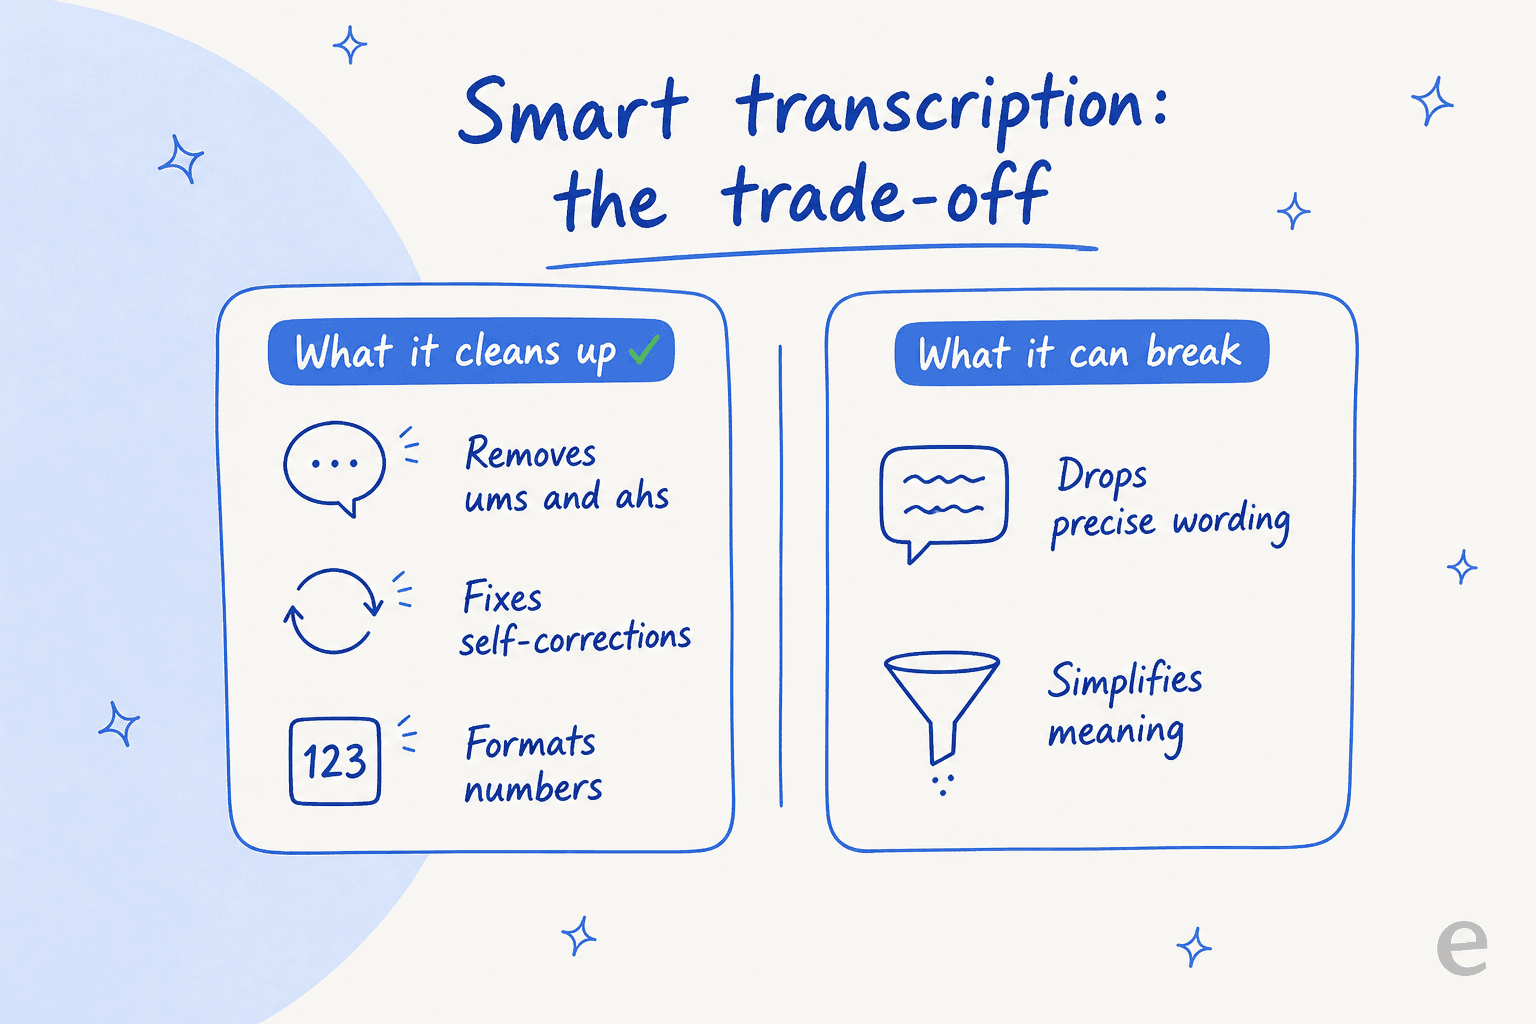
Laut Launch-Beitrag verarbeitet es Selbstkorrekturen („let's meet Tuesday, no, Wednesday“ wird zu „Wednesday“), entfernt Füllwörter und formatiert alphanumerische Zeichenfolgen intelligent. Für das Diktieren einer E-Mail oder das Aufräumen von Meeting-Notizen ist das genau das, wofür eigenständige Diktier-Tools extra berechnen, es im Basismodell zu bekommen ist also ein echtes Plus.
Das Problem: „Aufräumen“ ist eine Ermessensfrage, und das Modell teilt Ihr Urteil nicht immer. Ein Entwickler, der es auf einem Pixel 11 Pro testete, sagte es unverblümt:
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."
Das mentale Modell für die Kaufentscheidung lautet also: Smart transcription ist ein Feature, keine neutrale Transkription. Überall dort, wo der genaue Wortlaut zählt (Recht, Forschung, Compliance, Medizin), ist das ein echter Kompromiss, den man abwägen muss, keine Fußnote. Es ist das Eine an diesem Modell, das ich am gründlichsten mit meinem eigenen Audio testen würde, bevor ich ihm vertraue.
Sprechererkennung stockt ab drei Sprechern
Die zweite wiederkehrende Beschwerde betrifft die Verarbeitung mehrerer Sprecher, und wenn Sie Meetings transkribieren, sollten Sie hier genau hinsehen. Googles Doku nennt zwei verschiedene Obergrenzen: Die Modellseite sagt, das Dateimodell unterstütze „up to 8 speakers (Attribution for 3+ speakers is experimental)“, während der Launch-Blog „up to three“ sagt. Die verlässliche Grenze liegt heute bei drei, und ich würde mit dieser Zahl planen. Das Live-Streaming-Modell hat gar keine Sprechererkennung, da es auf niedrige Latenz setzt.
Diese Lücke zeigte sich in den Tests deutlich:
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
Wenn Ihr Einsatzfall ein Support-Anruf mit zwei Personen oder eine Sprachnotiz mit einer Stimme ist, betrifft Sie das nicht. Bei einem Stand-up mit sechs Personen ist es eine echte Einschränkung, und genau so etwas übersieht man im Datenblatt, bis man drei Wochen in den Aufbau investiert hat.
Preise: Hier gewinnt es
Google hat die Preise nicht in die Modellankündigung aufgenommen, was Entwickler genug ärgerte, dass einer sie selbst auf Hacker News postete. Hier das reale Bild von der Preisseite:
| Modell | Audio-Eingabe | Text-Ausgabe | Gemischter Satz |
|---|---|---|---|
gemini-3.5-transcribe (Datei) | 2,00 $ / 1 Mio. Tokens (~0,003 $/Min.) | 12,00 $ / 1 Mio. Tokens (~0,002 $/Min.) | ~0,005 $ / Min. |
gemini-3.5-transcribe-live (Streaming) | 3,50 $ / 1 Mio. Tokens (~0,005 $/Min.) | 21,00 $ / 1 Mio. Tokens (~0,004 $/Min.) | ~0,009 $ / Min. |
Zum Vergleich: Googles eigene Standard-Erkennung in Cloud Speech-to-Text v2 beginnt bei 0,016 $/Min., die dynamische Batch-Stufe kostet 0,003 $/Min. Das neue Dateimodell liegt also gut unter der Standard-Echtzeit-Erkennung und knapp über der günstigsten Batch-Option. Vergleichen Sie bei der Rechnung Gleiches mit Gleichem: Echtzeit mit Echtzeit, Batch mit Batch.
Rechnen Sie das konkret mit Ihrem eigenen Volumen:
Ein durchgerechnetes Beispiel: Ein kleines Team, das 200 Stunden Support-Anrufe pro Monat transkribiert, zahlt beim Dateimodell etwa 60 $, bei Cloud Speech-to-Text Standard rund 192 $. Echte Einsparung, in dieser Größenordnung aber nicht lebensverändernd, und ehrlich gesagt ist die größere Kostenfrage meist, was Sie anschließend mit den Transkripten machen, nicht die Transkription selbst. Dazu unten mehr.
Wie es sich gegen Whisper, Deepgram und Scribe schlägt
Ich will hier vorsichtig sein, denn ein fairer Direktvergleich braucht die eigenen Zahlen jedes Anbieters, und ehrlich gesagt werden die echten A/B-Tests von Nutzern durchgeführt, nicht von mir. Statt einer Spezifikationstabelle, die ich nicht vollständig belegen kann, hier also, was die Leute herausfanden, die diese Modelle tatsächlich vergleichen.
Bei den Kosten teilte sich die Reaktion fast genau in der Mitte. Ein Entwickler, der whispermemos.com betreibt, rechnete nach und war beeindruckt:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
Andere waren nicht überzeugt, dass die Genauigkeit nah genug herankommt:
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
Und Whisper hat weiterhin eine treue Anhängerschaft, teils weil es kostenlos selbst gehostet werden kann, teils weil Teams bereits Pipelines darum gebaut haben. Das häufigste Muster, das ich sah, war hybrid: Whisper für genaue Wort-Zeitstempel, dann ein Gemini-Modell für den eigentlichen Text. Kurz gesagt: Gemini 3.5 Transcribe ist eine starke, gut bepreiste verwaltete Option, kein automatischer Sieger gegenüber den spezialisierten ASR-Tools. Welches gewinnt, hängt von Ihrem Audio ab und davon, ob Sie zuverlässige Sprechererkennung brauchen.
Das Fazit: Für wen es sich eignet
Zusammengefasst lande ich nach der Recherche hier:
| Gemini 3.5 Transcribe | |
|---|---|
| Stärken | Niedriger Preis (~0,005 $/Min. Datei), 2,6 % Wortfehlerrate bei Englisch, integrierte Sprechererkennung + Zeitstempel, über 85 Sprachen, verwaltete API |
| Schwächen | Smart transcription kann präzise Formulierungen umschreiben, Sprechererkennung ab 3 Sprechern unzuverlässig, keine Batch-/Flex-Stufe, Doku widerspricht sich bei Status und Sprecherobergrenze |
| Am besten für | Diktate, Sprachnotizen mit einer Stimme, kostenbewusste Transkription in großem Umfang |
| Anderswo suchen, wenn | Sie wortgetreue Ausgabe, Meetings mit 4+ Sprechern oder die niedrigstmöglichen Batch-Kosten brauchen |
Die Entscheidung hängt letztlich von Ihrem Audio ab:
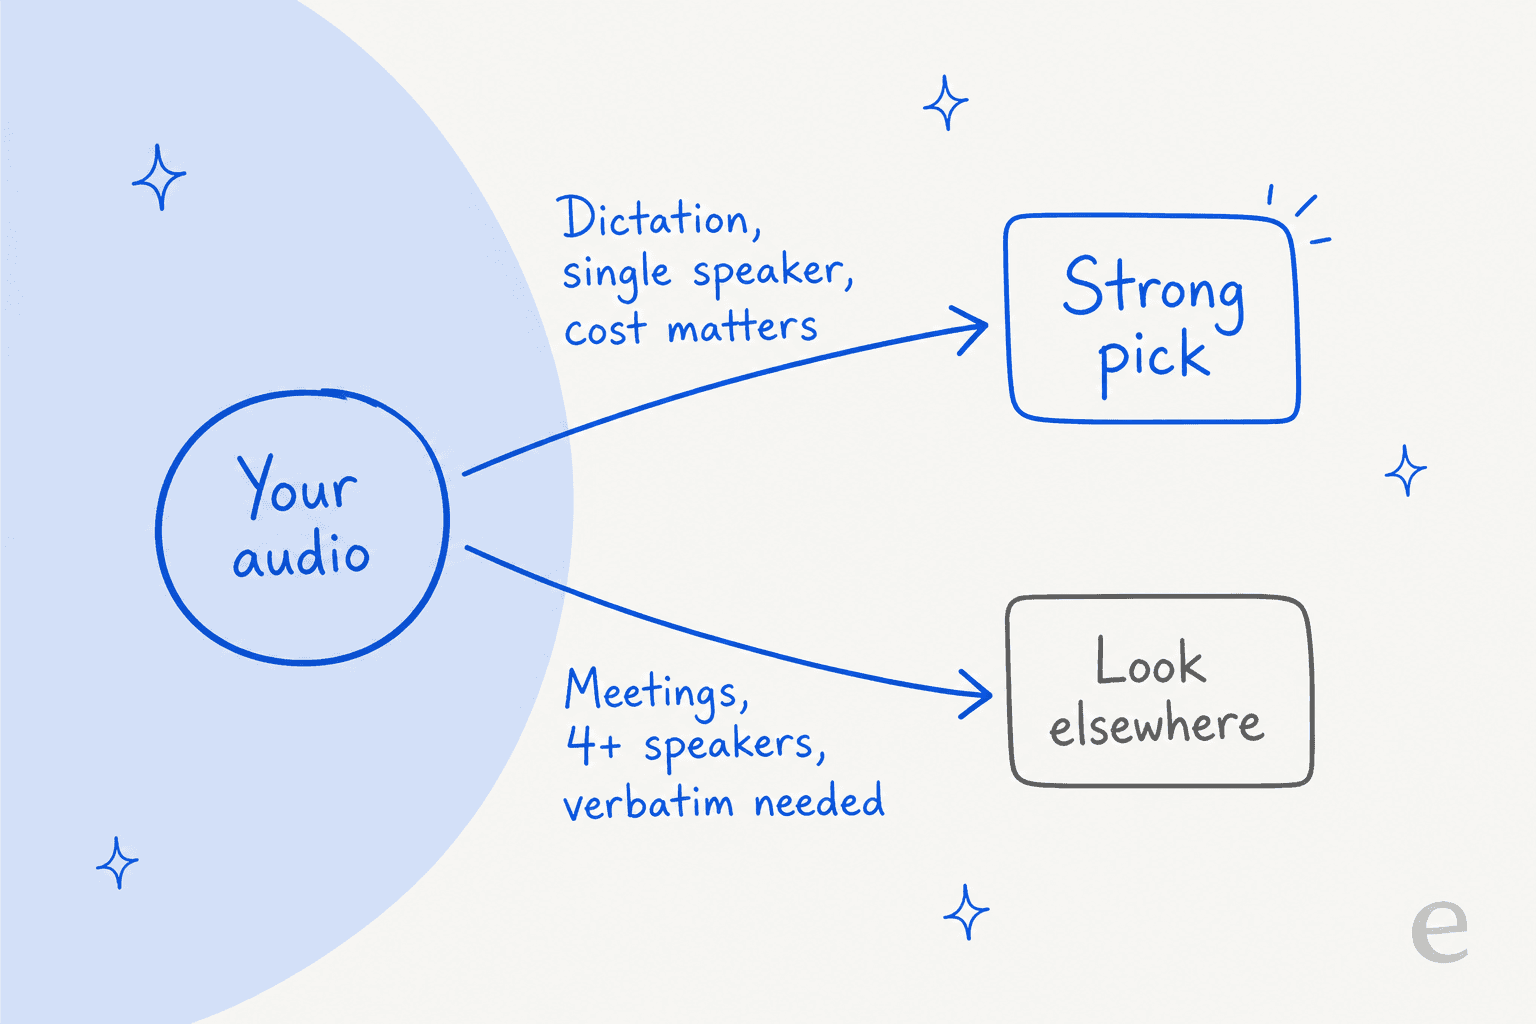
Würde ich eine Diktierfunktion bauen oder eine Warteschlange von Sprachnotizen mit einer Stimme transkribieren, würde ich gerne darauf zurückgreifen, Preis und englische Genauigkeit sind für ein verwaltetes Modell schwer zu schlagen. Würde ich Meeting-Notizen für Gespräche mit sechs Personen bauen oder etwas, wo der exakte Wortlaut rechtliches Gewicht hat, würde ich Deepgram oder ElevenLabs Scribe daneben testen, bevor ich entscheide, und nicht annehmen, dass die Benchmark-Zahlen auf mein Audio übertragbar sind.
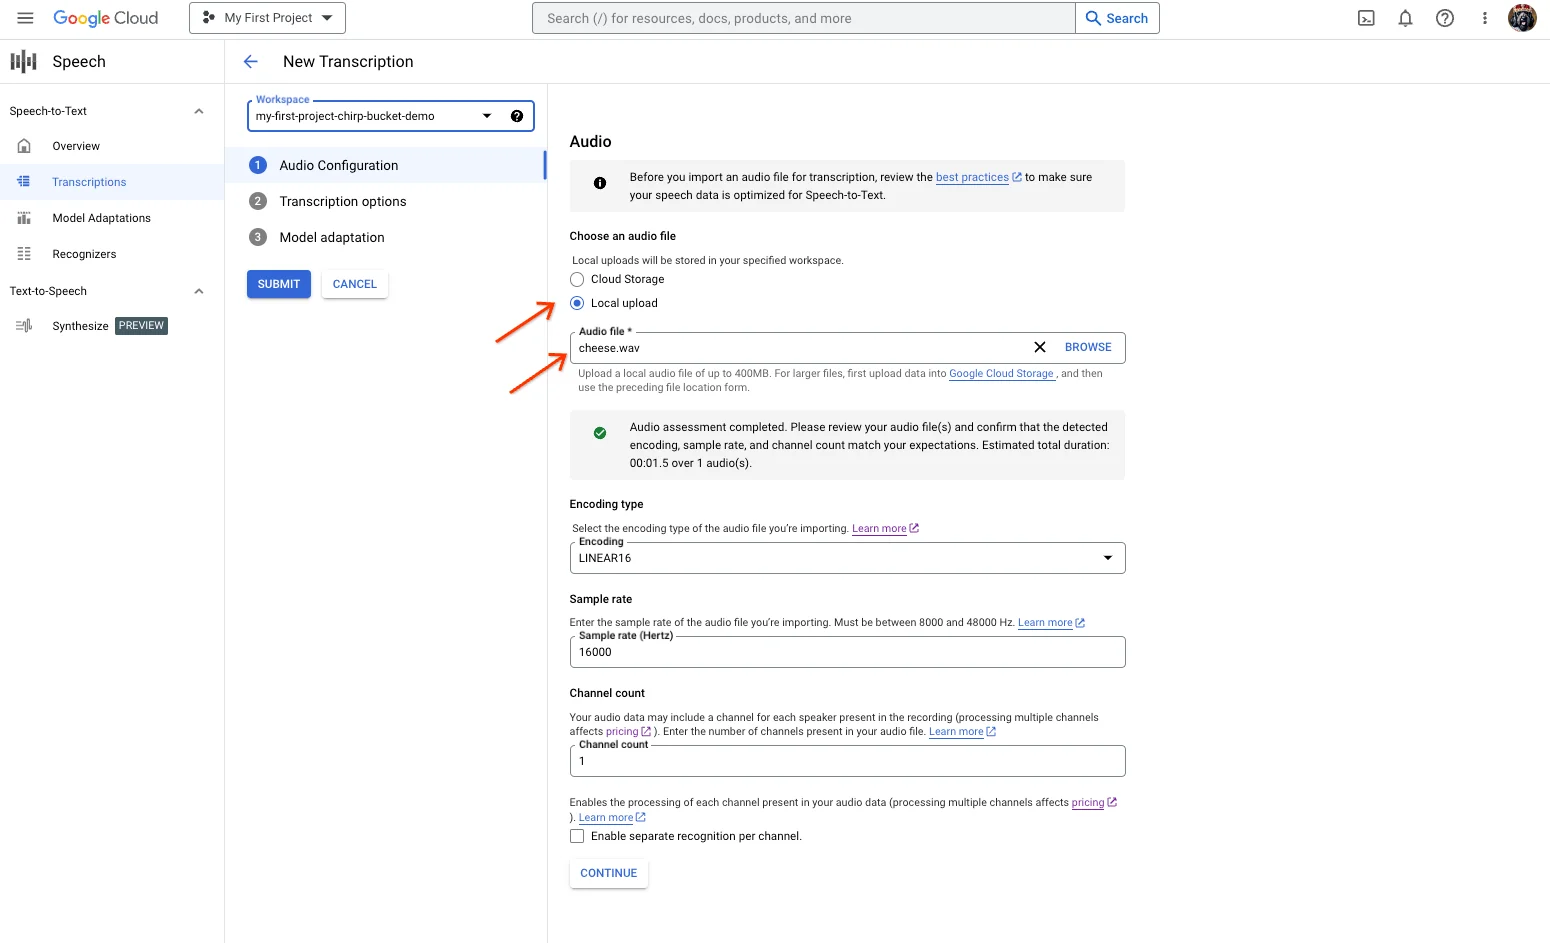
Zur Orientierung: Wenn Sie die Transkriptionskonsole von Google Cloud schon genutzt haben, wird Ihnen der Datei-Upload-Ablauf vertraut vorkommen, Sie verweisen auf Audio und wählen Ihre Optionen:
Wo Transkription für ein Support-Team ins Spiel kommt
Das ist etwas, das man klar sagen sollte, weil ein Test es leicht übersieht: Gemini 3.5 Transcribe ist Infrastruktur. Es wandelt Audio in Text um und erledigt diese schwere Aufgabe gut. Aber ein Transkript eines Kundenanrufs oder einer Sprachnotiz ist keine Antwort, es ist nur der Anfang. Etwas muss diesen Text noch lesen, verstehen, was der Kunde braucht, die richtigen Informationen holen und das Ticket tatsächlich lösen.
Genau diese Lösungsschicht ist das, woran ich arbeite. Ich habe die letzten Jahre mit KI verbracht, die auf echten Support-Warteschlangen arbeitet, und das Muster ändert sich nie: Die Wörter richtig zu erfassen ist Grundvoraussetzung; richtig darauf zu handeln ist der schwierige Teil. Ein Transkriptionsmodell liefert die Wörter. Es kennt weder Ihre Erstattungsrichtlinie noch Ihr Bestellsystem noch die letzten drei Tickets, die dieser Kunde eröffnet hat.
Das ist der Unterschied zwischen einem Modell und einem Teammate. Gemini 3.5 Transcribe ist ein Modell, brillant bei einer eng gefassten Aufgabe. eesel ist eine Teammate-Plattform: Sie stellen einsatzbereite KI-Teammates für bestimmte Aufgaben ein, und die aktuelle Besetzung umfasst einen AI-Helpdesk-Teammate und einen AI-Blog-Autor. Der Helpdesk-Teammate verbindet sich mit dem Helpdesk, den Sie bereits betreiben, Zendesk, Freshdesk, Gorgias, und tritt der bestehenden Warteschlange bei, trainiert auf Ihrem Help Center und früheren Tickets.
eesel für Sprach- und Chat-Tickets ausprobieren
Wenn Sie wegen eines Transkriptions-Tests hier gelandet sind, weil Ihr Team in Sprach- oder Chat-Tickets versinkt, denken Sie daran, dass das Transkript nur die halbe Arbeit ist. Der eesel AI-Helpdesk-Teammate setzt dort an, wo ein Modell wie Gemini 3.5 Transcribe aufhört: Er liest die Nachricht des Kunden, entwirft oder sendet die Antwort und schließt den Kreis, über 1.000+ Integrationen hinweg.
Den Teil, den ich zuerst nennen würde, ist der Simulationsmodus. Bevor eine KI einen echten Kunden berührt, lassen Sie sie über Tausende Ihrer eigenen früheren Tickets laufen und sehen genau, wie sie geantwortet hätte, Sie legen also nicht einfach einen Schalter um und hoffen, derselbe Rat „erst mit den eigenen Daten testen“, den ich für jedes Transkriptionsmodell geben würde, direkt ins Produkt eingebaut. Der Preis ist ein fester Monatspreis, ab 299 $/Monat für 500 Credits (1 Credit pro Ticket oder Chat) ohne Gebühren pro Nutzerplatz, und es gibt einen kostenlosen Plan mit 100 Credits, ohne Karte. Das ist der Unterschied zwischen einer klugen Transkription eines Problems und seiner tatsächlichen Lösung.