

Kurzfassung
Gemini 3.5 Transcribe ist Googles erstes Speech-to-Text-Modell unter der Marke Gemini. Es ist eine starke, gut bepreiste verwaltete Option mit etwa 0,005 $ pro Minute für das Dateimodell und einer Wortfehlerrate von 2,6 % bei sauberem Englisch. Es ist aber nicht automatisch die richtige Wahl, und zwei Dinge lassen Leute nach Alternativen suchen: Die Smart-Transkription formuliert Ihre genauen Worte um, um sie „aufzuräumen“, und die Sprechertrennung wird ab drei Sprechern unzuverlässig.
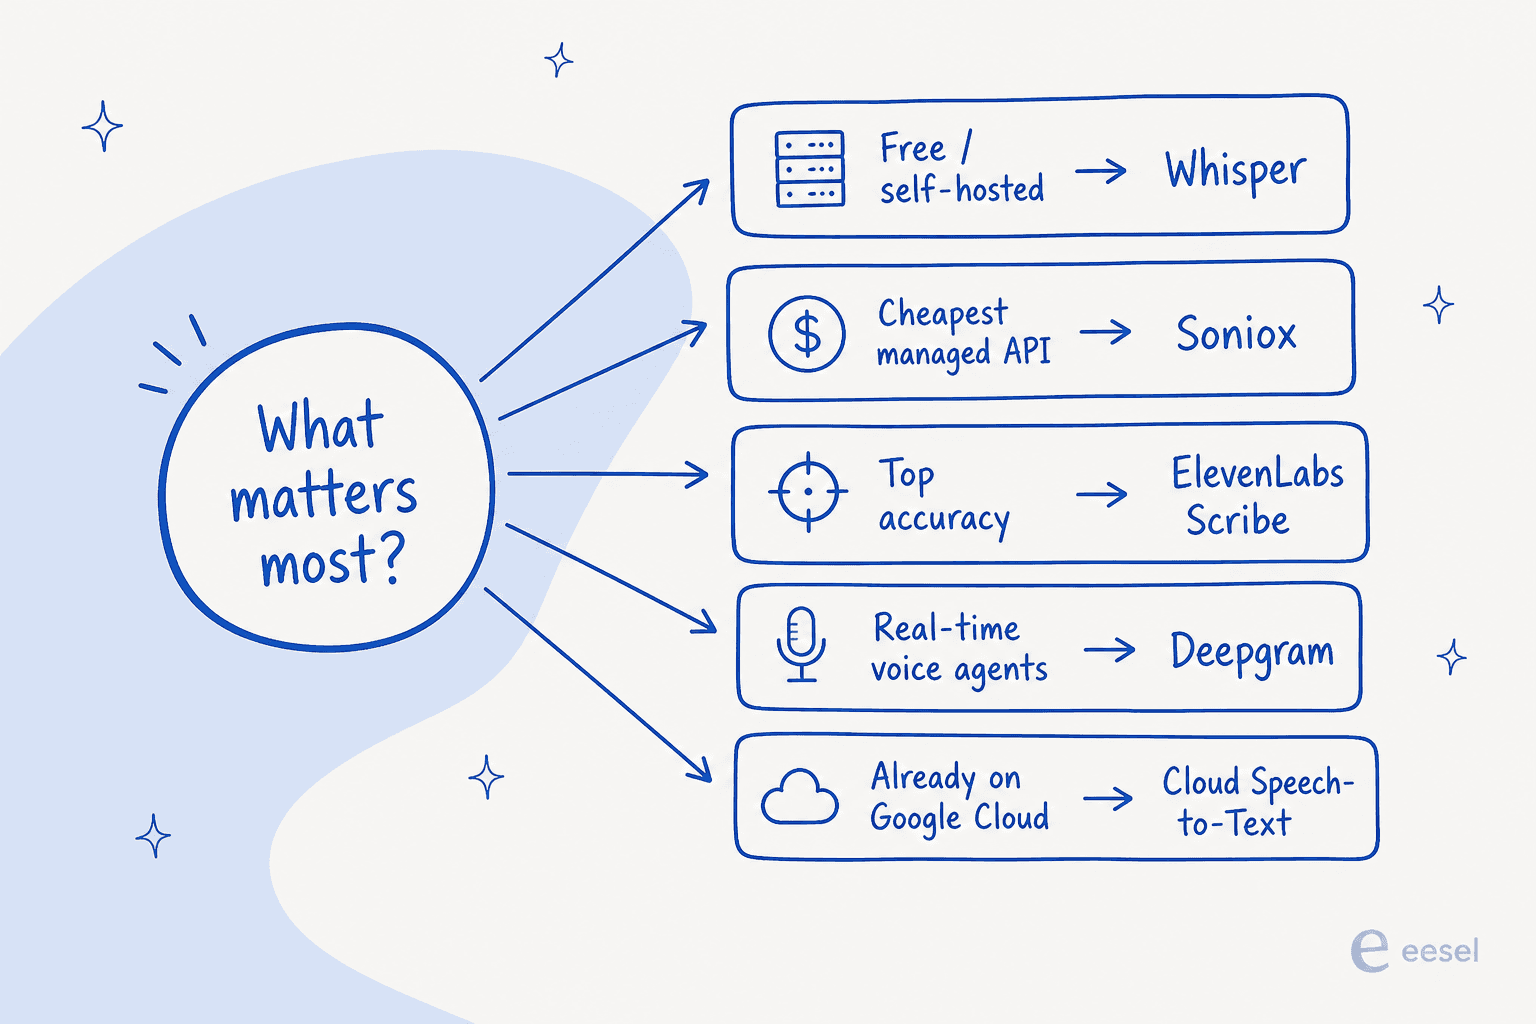
Wenn Sie eine Alternative zu Gemini 3.5 Transcribe suchen, hier meine Empfehlung nach Bedarf:
- Kostenlos und selbst gehostet: OpenAI Whisper (MIT-Lizenz, läuft auf Ihrer eigenen Hardware).
- Günstigste verwaltete API: Soniox, etwa 0,10 $ pro Stunde, inklusive Sprechertrennung und Spracherkennung.
- Höchste Genauigkeit: ElevenLabs Scribe, 98 %+ Genauigkeit und Sprechertrennung bis zu 32 Sprecher.
- Echtzeit-Sprachagenten: Deepgram, der Spezialist für Streaming mit niedriger Latenz.
- Bereits auf Google Cloud: Cloud Speech-to-Text (Chirp 3), mit dem günstigsten Batch-Tarif von 0,003 $ pro Minute.
Vorab noch ein wichtiger Punkt: Transkription ist nur die Eingabeschicht. Wenn Sie ein Support-Team sind, das Sprach- und Chat-Nachrichten in Tickets verwandelt, ist das Transkript die einfache Hälfte. Das Ticket tatsächlich zu lösen ist der schwierige Teil, die Aufgabe eines KI-Helpdesk-Teammitglieds, die ein Transkriptionsmodell nicht erfüllen kann.
Warum über Gemini 3.5 Transcribe hinausblicken
Zunächst fair gesagt: Gemini 3.5 Transcribe ist ein sehr gutes Modell. Es ist Googles Nachfolger von Chirp 3, meldet eine Wortfehlerrate von 2,6 % bei nicht gestreamtem Englisch, erkennt automatisch über 85 Sprachen, und mit etwa 0,005 $ pro Minute für das Dateimodell unterbietet es Googles eigenen Standardtarif von Cloud Speech-to-Text. Für Diktat mit nur einem Sprecher ist es schwer zu schlagen. All das habe ich in meinem Test von Gemini 3.5 Transcribe ausführlich behandelt.
Warum also wechseln? Drei konkrete Gründe tauchen immer wieder auf.
Die Smart-Transkription formuliert Ihre Worte um. Diese Funktion hebt Google am stärksten hervor, und sie ist zugleich die häufigste Beschwerde. Die Smart-Transkription entfernt Füllwörter und Selbstkorrekturen und formatiert unterwegs um. Das ist toll, wenn man eine E-Mail diktiert, und ein echtes Problem, wenn es auf den genauen Wortlaut ankommt. Ein Entwickler stellte beim Testen fest, dass das Modell einen Satz „vereinfachte“ und dabei den Sinn zerstörte: In wiederholten Tests fiel die erste Hälfte einer präzisen Formulierung weg. Für juristische, medizinische, wissenschaftliche oder Compliance-Arbeit ist das ein Ausschlusskriterium, keine Randnotiz.
Die Sprechertrennung stockt ab drei Sprechern. Googles Dokumentation ist in sich widersprüchlich: Die Modellseite nennt bis zu 8 Sprecher mit „3+ experimentell“, während der Launch-Blog bis zu drei nennt. Die verlässliche Zahl ist heute drei, und das Live-Streaming-Modell trennt Sprecher gar nicht. Wenn Sie Meetings mit sechs Personen transkribieren, ist das eine harte Grenze.
Es ist nicht wirklich das günstigste. Mit etwa 0,30 $ pro Stunde für das Dateimodell liegt Gemini am oberen Ende des Feldes. Mehrere Spezialisten unterbieten es, und einige bündeln dabei Sprechertrennung und Spracherkennung, die bei Gemini zwar nichts extra kosten, bei anderen aber gesondert ausgewiesen werden. So sieht das Bild aus:
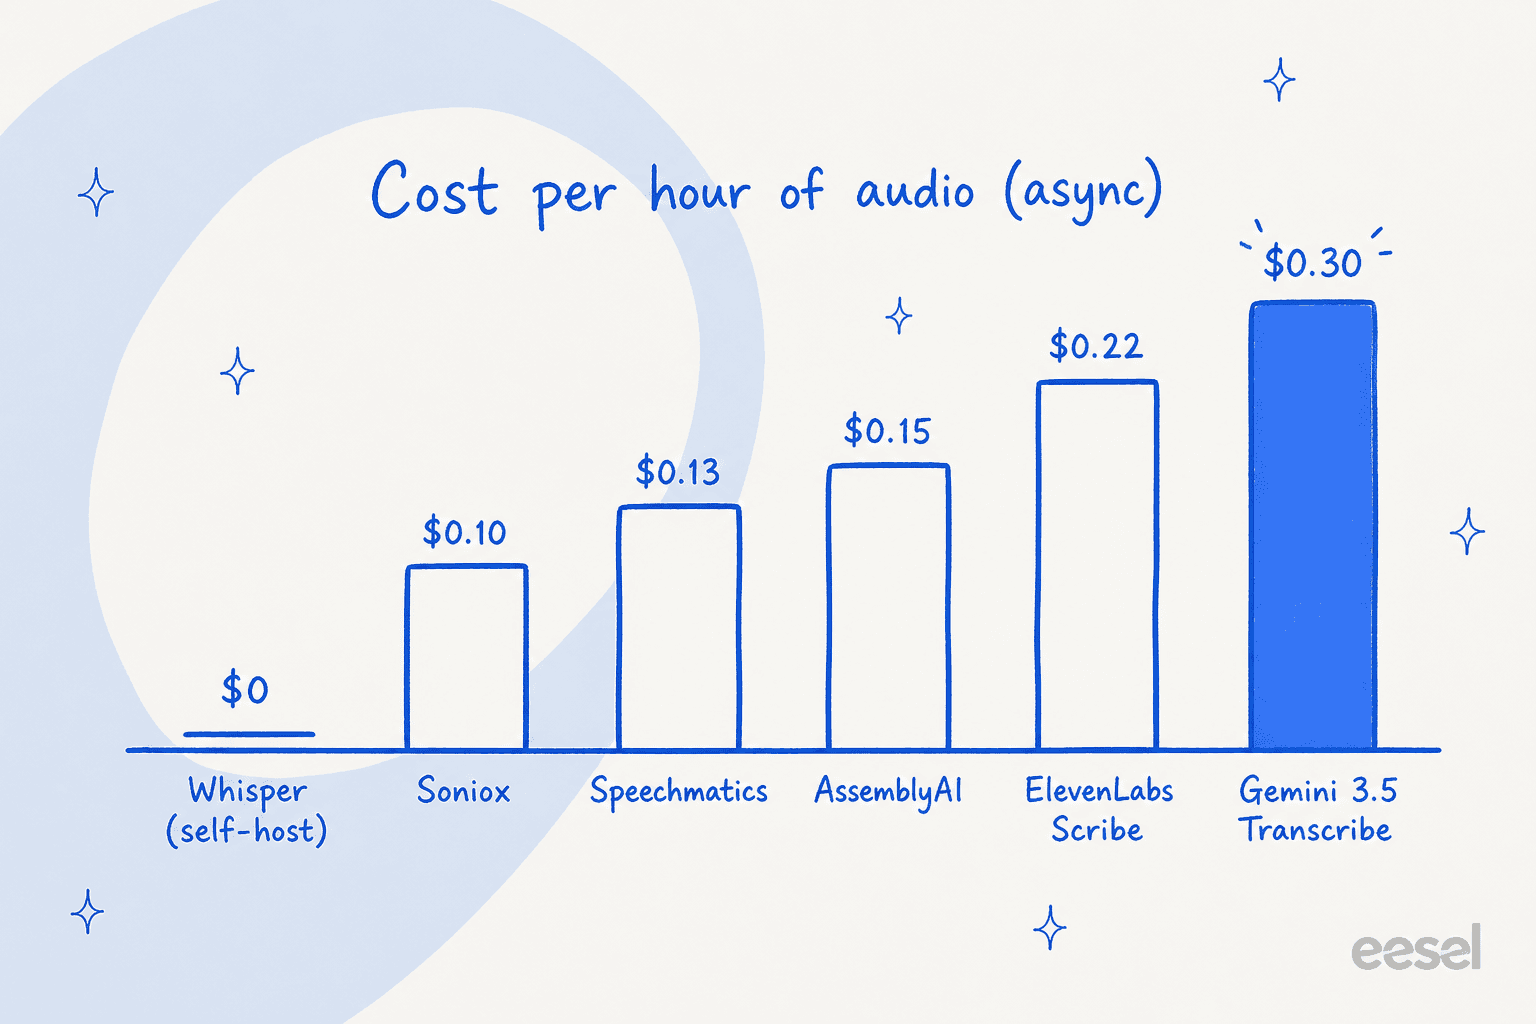
Das macht Gemini nicht zu einem schlechten Modell. Es heißt nur, dass die richtige Wahl von Ihrem Audiomaterial abhängt, und für viele reale Anwendungsfälle passt eine der folgenden Alternativen besser.
Wie ich sie verglichen habe
Ich habe jede Alternative nach den Kriterien beurteilt, die eine Entscheidung wirklich beeinflussen: reale Kosten pro Stunde (nicht der Listenpreis), ob Sprechertrennung und Spracherkennung inklusive oder als Zusatz berechnet werden, Sprachabdeckung, ob es einen Echtzeit-Streaming-Modus gibt und welches kostenlose Kontingent zum Testen zur Verfügung steht. Ich habe die Preise und Dokumentation jedes Anbieters gelesen und mich auf Entwickler gestützt, die diese Modelle direkt nebeneinander einsetzen, denn ein sauberer Benchmark-Wert und Ihr Ergebnis in der Praxis können Welten auseinanderliegen.
Hier die Übersichtstabelle vor den Detailvorstellungen. Alle Preise sind die öffentlichen Pay-as-you-go-Tarife des jeweiligen Anbieters für asynchrone (Datei-)Transkription, sofern nicht anders angegeben.
| Tool | Async-Preis | Streaming | Sprachen | Sprechertrennung | Kostenloses Kontingent | Am besten für |
|---|---|---|---|---|---|---|
| Whisper | 0 $ (selbst gehostet) | Selbst gebaut | 99 | Zusatzbibliotheken | Offene Gewichte | Kontrolle, keine Gebühr pro Minute |
| Deepgram | ~0,29 $/Std. (Nova-3) | Ja | 30+ | +0,0020 $/Min. | 200 $ Guthaben | Echtzeit-Sprachagenten |
| AssemblyAI | 0,15 $/Std. (Universal-2) | Ja | 99 | +0,02 $/Std. | Kostenloses PAYG | Audio-Intelligenz |
| ElevenLabs Scribe | 0,22 $/Std. | 0,39 $/Std. | 90+ | Bis zu 32 Sprecher | Kostenloses Kontingent | Höchste Genauigkeit, viele Sprecher |
| Speechmatics | ab 0,129 $/Std. | ab 0,24 $/Std. | 55+ | Inklusive | 100 $ Guthaben | Akzente und Dialekte |
| Soniox | ~0,10 $/Std. | ~0,12 $/Std. | 60+ | Inklusive | Kostenloses Guthaben | Günstigste verwaltete API |
| Cloud Speech-to-Text | 0,003 $/Min. (Batch) | 0,016 $/Min. | 125+ | Inklusive | 300 $ GCP-Guthaben | Teams, die bereits GCP nutzen |
| Rev AI | 0,20 $/Std. | Ja | 57+ | Inklusive | Kostenlose Testversion | Genauigkeit bei Akzenten, HIPAA |
| Gemini 3.5 Transcribe | ~0,30 $/Std. | ~0,54 $/Std. | 85+ | Bis zu 3 Sprecher | Kostenloses Kontingent | Diktat mit einem Sprecher |
1. OpenAI Whisper
Am besten für: Teams, die volle Kontrolle, keine Bindung an Preise pro Minute oder einen kostenlosen Einstieg wollen.
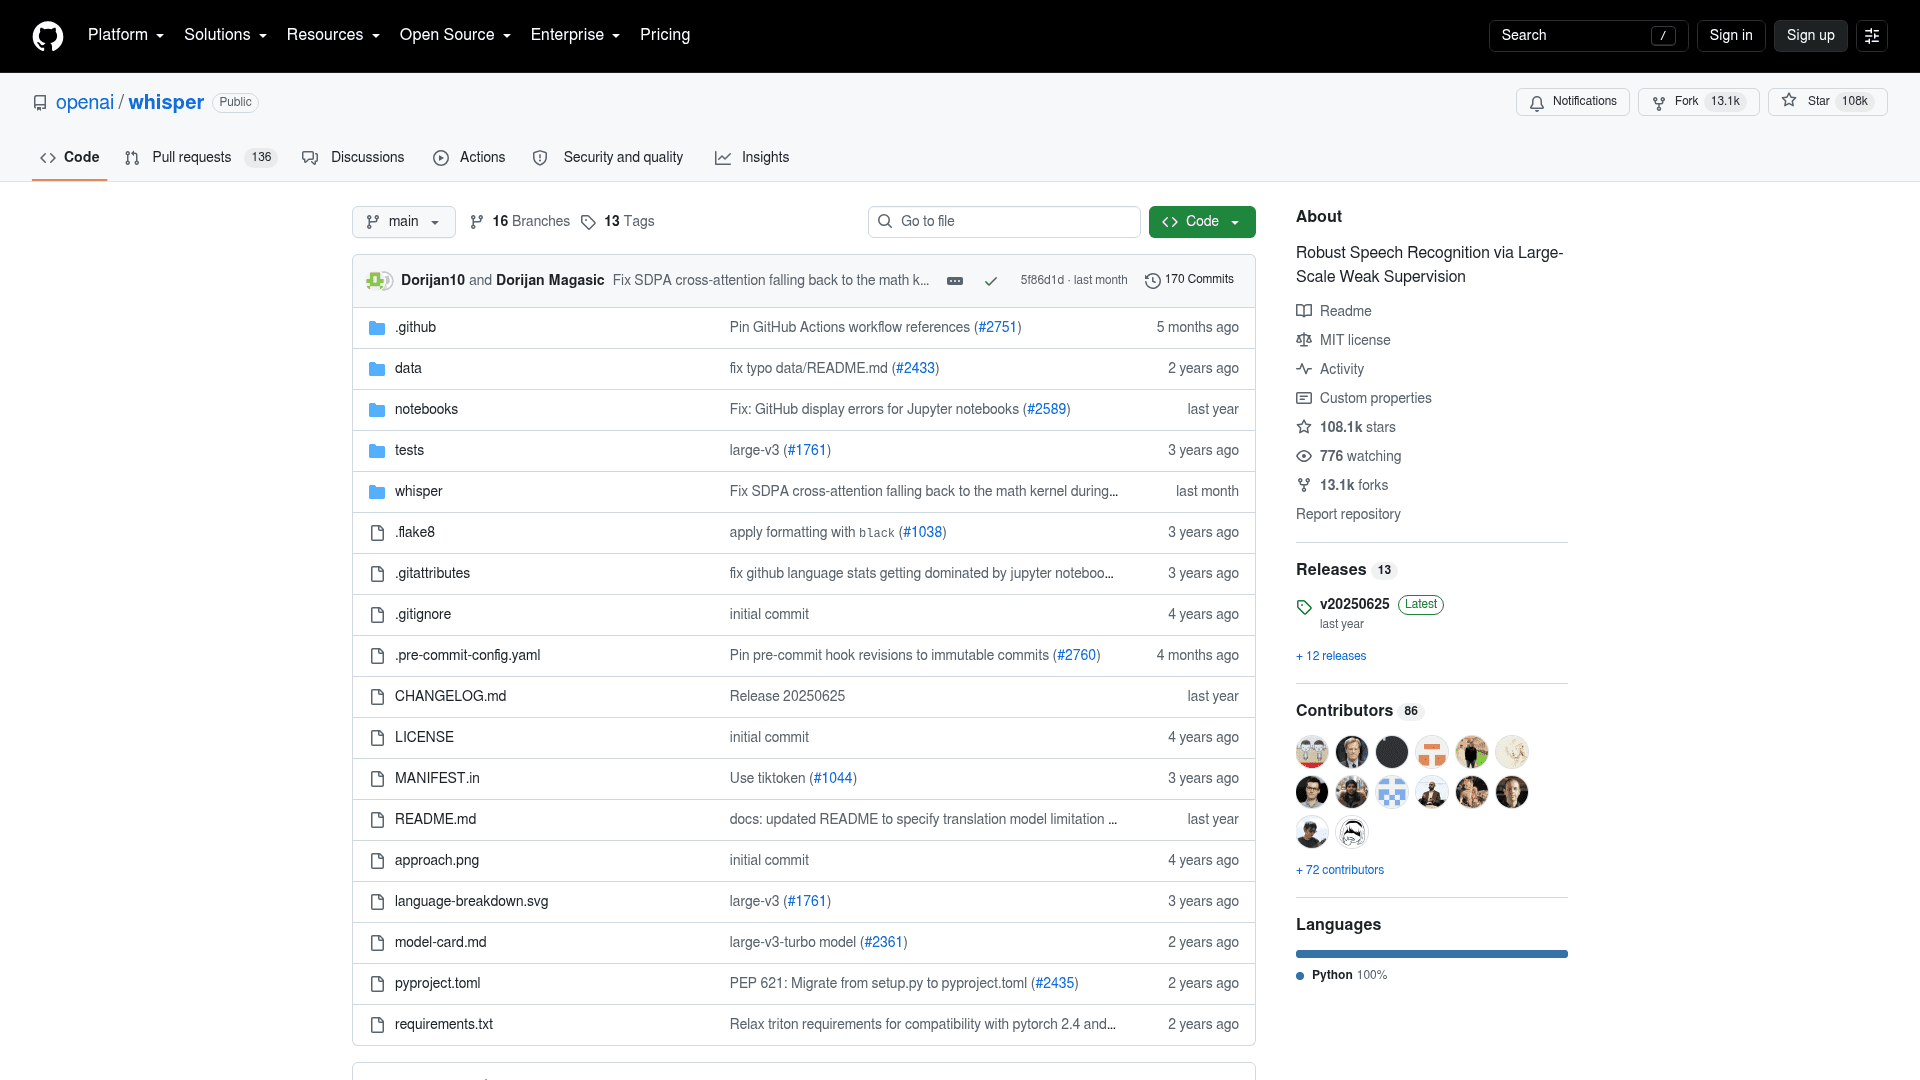
Whisper ist das Modell, das die Erwartungen an offene Spracherkennung neu gesetzt hat. Es steht unter der MIT-Lizenz, hat über 108.000 GitHub-Sterne und beschreibt sich selbst als „Robust Speech Recognition via Large-Scale Weak Supervision“. Da die Gewichte offen sind, können Sie es auf Ihrer eigenen Hardware für die reine Rechenzeit betreiben, ohne API-Rechnung pro Minute und ohne dass Daten Ihre Infrastruktur verlassen. Dieser letzte Punkt ist der Grund, warum so viele datenschutzbewusste Teams hier beginnen.
Aus gutem Grund bleibt es ein Liebling der Community:
"Whisper Large-v3 is still the most stable open model across diverse domains. Great accuracy, predictable output, and decent handling of accents."

Vorteile: Kostenlos selbst hostbar, offene Gewichte, starke mehrsprachige Genauigkeit, riesiges Ökosystem aus Tools und Feinabstimmungen, läuft komplett offline.
Nachteile: Selbst hosten ist echte Entwicklungsarbeit (GPUs, Batching, Skalierung). Sprechertrennung und Zeitstempel pro Wort sind nicht eingebaut, Sie müssen also zusätzliche Bibliotheken anbinden. Whisper ist außerdem dafür bekannt, bei stillen oder verrauschten Abschnitten Text zu erfinden. Wenn Sie keine Infrastruktur betreiben möchten: OpenAIs eigene verwaltete GPT-Transcribe-API kostet etwa 0,0045 $ pro Minute (rund 0,27 $ pro Stunde) für Async und 0,017 $ pro Minute für Live-Streaming.
Fazit: Whisper ist der Standard für alle, denen Kontrolle und Kosten wichtiger sind als Komfort. Wenn Sie das Know-how zum Hosten haben, ist es praktisch kostenlos und privat. Wenn nicht, bringen Sie die verwalteten OpenAI-Endpunkte ohne Betriebsaufwand in dieselbe Modellfamilie. Viele Teams fahren einen Hybrid: Whisper für Zeitstempel pro Wort und ein Chat-Modell zur Korrektur des Texts.
2. Deepgram
Am besten für: Echtzeit-Sprachagenten und Streaming mit niedriger Latenz in großem Maßstab.
Deepgram ist der auf Geschwindigkeit ausgelegte ASR-Spezialist. Er liefert die Sprachinfrastruktur für Unternehmen wie Twilio, Cloudflare und Vapi, und seine gesamte Architektur ist auf Streaming mit niedriger Latenz getrimmt, genau das, was ein Live-Sprachagent braucht. Das aktuelle Nova-3-Modell kostet 0,0048 $ pro Minute für einsprachiges Streaming (etwa 0,29 $ pro Stunde), mit 200 $ Startguthaben.
Entwickler, die das Feld vergleichen, sehen Deepgram eher als den schnellen denn als den genauesten Anbieter:
"AssemblyAI and Speechmatics too, who both have much greater accuracy - especially in real-time for Speechmatics. Deepgram are only fastest at..."
Vorteile: Hervorragende Streaming-Latenz, enorme Parallelität, Self-Hosting für regulierte Branchen und eine klare Preisliste pro Minute.
Nachteile: Zusatzfunktionen summieren sich: Die Sprechertrennung kostet 0,0020 $ pro Minute extra, Schwärzung und Keyterm-Prompting kosten zusätzlich. Die reine Genauigkeit bei schwierigem Audio liegt in einigen Nutzertests hinter den Genauigkeitsführern.
Fazit: Wenn Sie Echtzeit-Sprache bauen, ist Deepgram der erste Name auf der Liste. Es kommt dem Einsatzzweck von Gemini 3.5 Transcribe Live am nächsten und behandelt Streaming als Kernfunktion statt als Kompromiss bei der Latenz. Für Batch-Dateien, bei denen Genauigkeit wichtiger ist als Geschwindigkeit, würde ich es vor einer Festlegung gegen AssemblyAI oder Scribe testen.
3. AssemblyAI
Am besten für: Teams, die Transkription plus Audio-Intelligenz in einer API wollen.
AssemblyAI verbindet starke Transkription mit vielen „Audio-Intelligenz“-Funktionen: Stimmungsanalyse, Themenerkennung, Zusammenfassung und Sicherheitsleitplanken, alles über dieselbe API. Das Modell Universal-2 kostet 0,15 $ pro Stunde über 99 Sprachen, und das neuere Universal-3.5 Pro für 0,21 $ pro Stunde bringt natives Code-Switching und die bisher genaueste Sprechertrennung in 18 Sprachen. AssemblyAI gibt eine höhere Wortgenauigkeit als Whisper an, nämlich 94,1 % gegenüber 92,4 %.
Vorteile: Hohe Genauigkeit bei Dateien, Abdeckung von 99 Sprachen mit Universal-2, eine nützliche Intelligenzschicht für die Arbeit mit Support-Tickets sowie Self-Service-Preise pro Stunde mit kostenlosem Kontingent.
Nachteile: Zusatzfunktionen werden abgerechnet: Die Sprechertrennung kostet 0,02 $ pro Stunde extra, Keyterm-Prompting beim Pro-Modell 0,05 $ pro Stunde. Das Top-Modell Universal-3.5 Pro beschränkt sich auf 18 Sprachen, für breite Mehrsprachigkeit bleibt also Universal-2.
Fazit: AssemblyAI ist die Wahl, wenn Sie mehr als ein reines Transkript wollen. Wenn Ihr Produkt Anrufe zusammenfassen, Stimmung markieren oder Themen extrahieren soll, ist ein einziger Aufruf besser, als ein Transkriptionsmodell mit einem separaten LLM-Schritt zu verbinden. Bei der reinen Genauigkeit gehört es zur Spitzengruppe, und das kostenlose Pay-as-you-go-Kontingent macht den Vergleich mit Ihrem eigenen Audio einfach.
4. ElevenLabs Scribe
Am besten für: höchste Genauigkeit und Audio mit vielen Sprechern.
ElevenLabs hat sich mit Sprachgenerierung einen Namen gemacht, aber Scribe ist ein ernstzunehmendes Speech-to-Text-Modell für sich. Es wirbt mit 98 %+ Genauigkeit, 90+ Sprachen und der herausragenden Zahl, Sprechertrennung bis zu 32 Sprecher, eine Größenordnung über Geminis drei. Scribe v1 und v2 kosten 0,22 $ pro Stunde, mit einem Echtzeitmodell, Scribe v2 Realtime, für 0,39 $ pro Stunde und etwa 150 ms Latenz.
Das Verhältnis von Preis zu Genauigkeit überzeugt viele. Ein Entwickler, der beruflich transkribiert, hat gegenüber Gemini nachgerechnet:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."

Vorteile: Genauigkeitsführer bei sauberem Audio, Sprechertrennung, die tatsächlich auf große Meetings skaliert, breite Sprachabdeckung und eine Echtzeit-Option.
Nachteile: Pro Stunde teurer als Soniox, Speechmatics oder der Basistarif von AssemblyAI. Speech-to-Text ist ein Produkt innerhalb eines Unternehmens für Sprachgenerierung, daher sind Dokumentation und Community eher auf TTS ausgerichtet.
Fazit: Wenn Ihr Anspruch lautet „die Worte exakt richtig, auch wenn ein ganzer Raum durcheinanderredet“, würde ich bei Scribe anfangen. Allein die Sprechertrennung für 32 Sprecher macht es zur naheliegenden Antwort für Meeting- und Podiumstranskription, genau dort, wo Gemini 3.5 Transcribe am meisten Schwierigkeiten hat.
5. Speechmatics
Am besten für: breite Abdeckung von Akzenten und Dialekten sowie Unternehmenseinsätze.
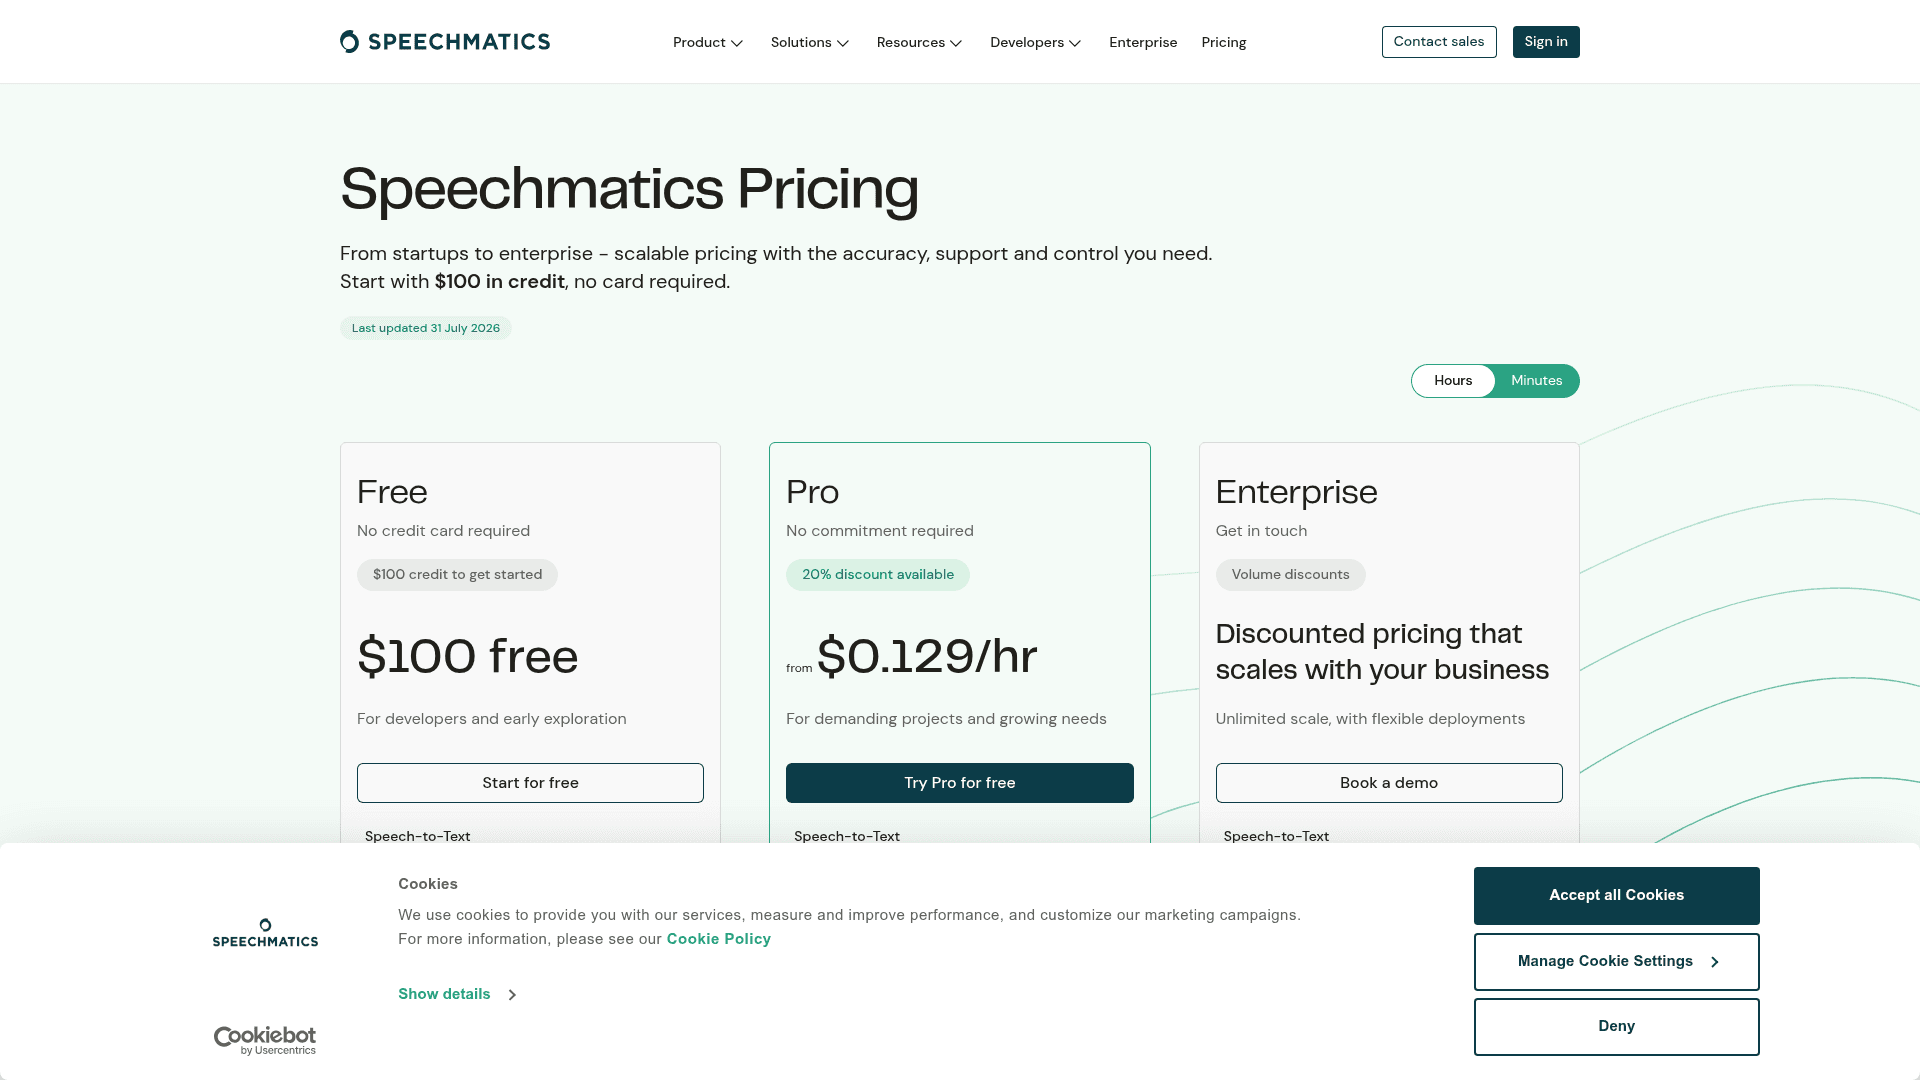
Speechmatics ist der Spezialist für Genauigkeit und Akzente. Es deckt über 55 Sprachen und Dialekte ab und wirbt damit, „over 4 billion people“ genau zu transkribieren, eine Akzentabdeckung, die wichtig ist, wenn Ihre Anrufer nicht alle denselben Standardakzent sprechen. Der Batch-Tarif Melia 1 beginnt bei 0,129 $ pro Stunde, der Echtzeit-Standardtarif bei 0,24 $ pro Stunde, dazu 100 $ Startguthaben und 20 % Rabatt ab 500 Stunden im Monat.
Nutzer in der Genauigkeitsdebatte nennen es durchweg weit oben, besonders in Echtzeit, dem schwierigeren Problem.
Vorteile: Starker Umgang mit Akzenten und Dialekten, wettbewerbsfähige Batch-Preise, Sprechertrennung inklusive statt separat berechnet und On-Premise-Betrieb für Unternehmen.
Nachteile: Die Tarifstruktur (Melia 1, Standard, Enhanced, jeweils für Batch und Echtzeit) braucht einen Moment, bis man sie versteht. Der günstige Tarif Melia 1 ist der, bei dem die 0,129 $ gelten, lesen Sie den Tarif also, bevor Sie budgetieren.
Fazit: Speechmatics wähle ich, wenn das Audio sprachlich unordentlich ist: gemischte Akzente, Dialekte, reale Call-Center-Aufnahmen. Wenn Geminis Smart-Transkription die Formulierung eines Sprechers stillschweigend „korrigiert“, die Sie unverändert brauchten, ist ein Modell mit Fokus auf originalgetreue Akzentverarbeitung die sicherere Wahl.
6. Soniox
Am besten für: die günstigste verwaltete API mit gebündelten Funktionen.
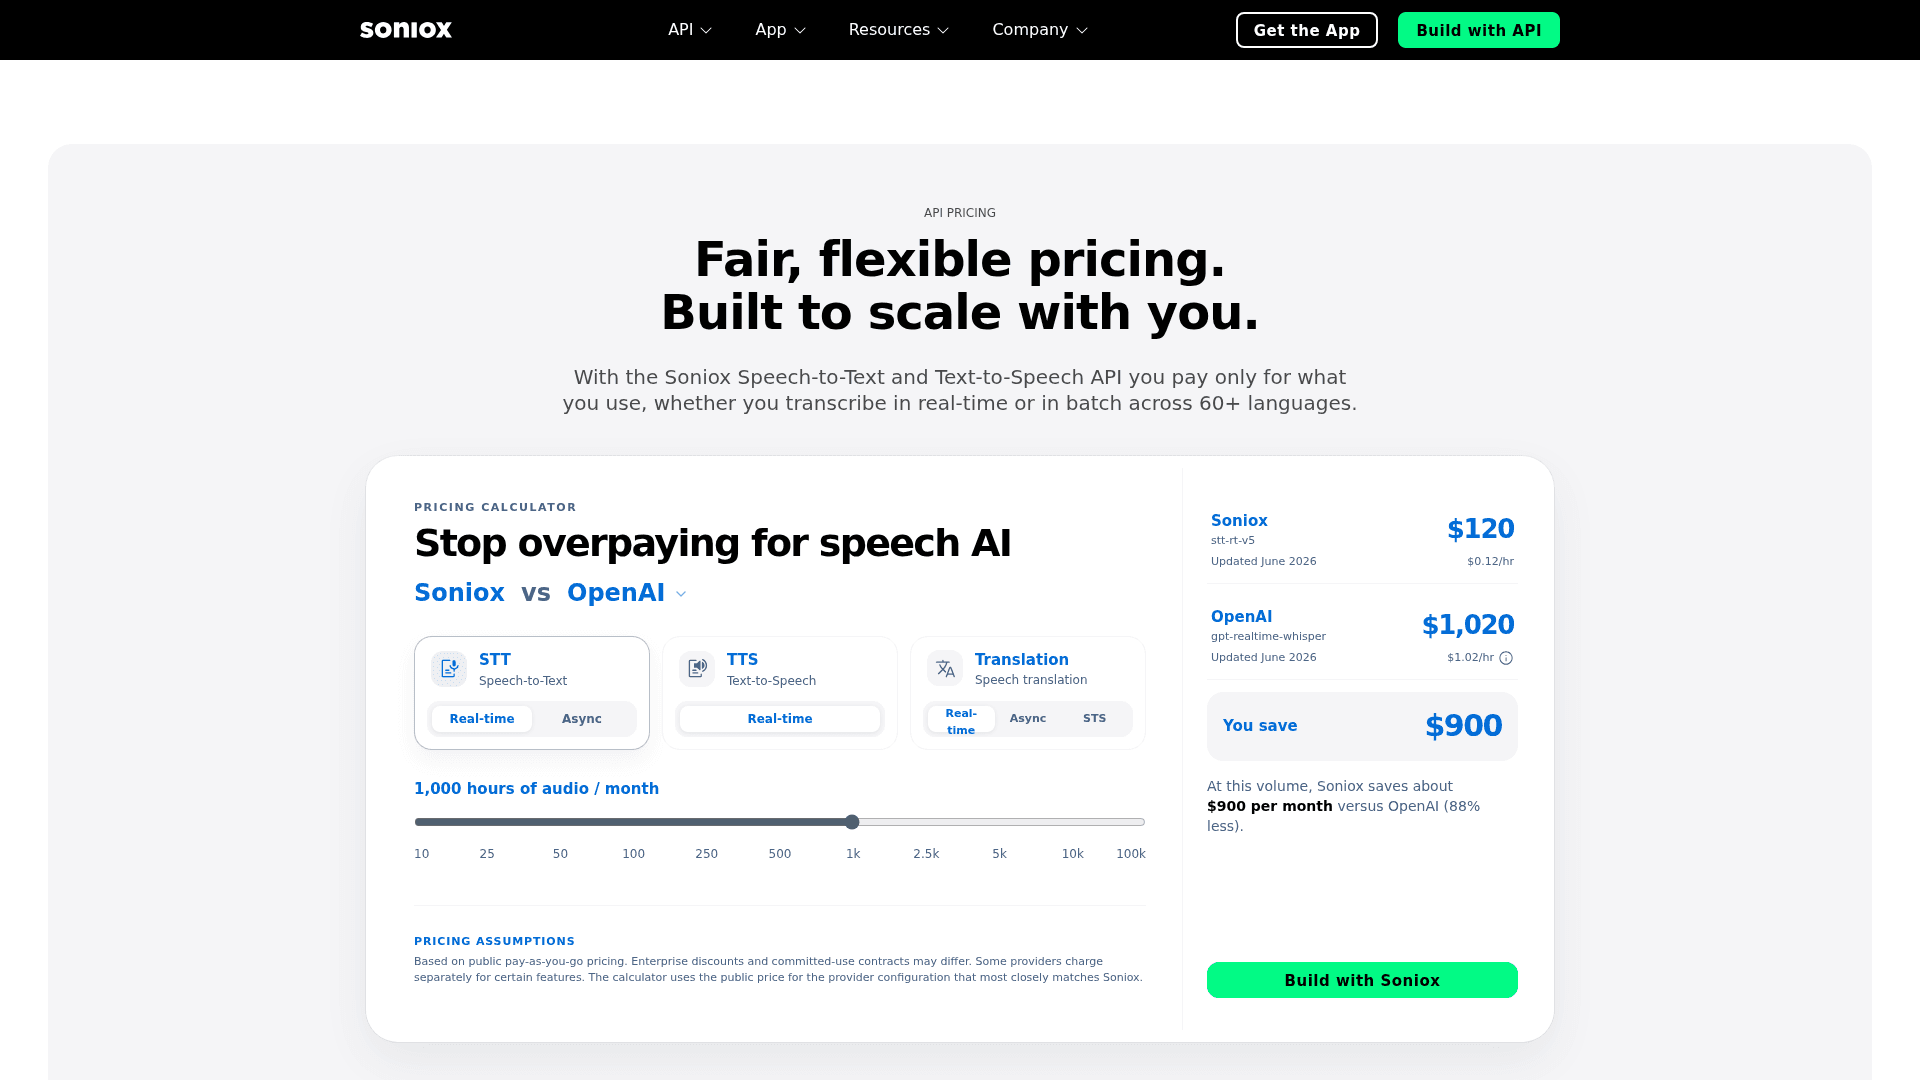
Soniox ist das Preis-Leistungs-Angebot und macht daraus keinen Hehl. Speech-to-Text kostet etwa 0,10 $ pro Stunde für Async und 0,12 $ pro Stunde in Echtzeit, über 60+ Sprachen. Der Unterschied liegt nicht nur in der Zahl: Sprechertrennung, Spracherkennung, intelligente Formatierung und sogar Übersetzung sind im Stundenpreis enthalten statt als Zusatz berechnet. Soniox wirbt damit, bei Echtzeit rund 4,5-mal günstiger als Google und 8-mal günstiger als Azure zu sein.
Vorteile: Der niedrigste verwaltete Preis hier, alles gebündelt (kein Aufschlag für Sprechertrennung oder Spracherkennung), Echtzeit und Batch mit demselben Modell und Übersetzung in 60+ Sprachen im selben Aufruf.
Nachteile: Es ist ein kleinerer, neuerer Name als Deepgram oder Google, daher gibt es weniger Benchmarks von Dritten und weniger Markenbekanntheit. Sie sollten es mit Ihrem eigenen Audio testen, statt der Marketing-Rechnung zu vertrauen.
Fazit: Für kostensensible Transkription in großen Mengen ist Soniox das schärfste Angebot in diesem Überblick. Sprechertrennung und Übersetzung in einen pauschalen Preis von 0,10 $ pro Stunde zu bündeln ist ein echter Vorteil gegenüber Gemini und Deepgram, die beides separat berechnen. Wenn die Genauigkeit bei Ihren Aufnahmen stimmt, summieren sich die Einsparungen im großen Maßstab schnell.
7. Google Cloud Speech-to-Text (Chirp 3)
Am besten für: Teams, die bereits auf Google Cloud sind, und den günstigsten Batch-Tarif.
Hier kommt der interessante Fall: Googles Cloud Speech-to-Text ist das Modell, das Gemini 3.5 Transcribe beerben soll, und es ist weiterhin sehr lebendig. Sein Foundation-Modell Chirp 3 unterstützt über 125 Sprachen, und die Preise reichen von 0,016 $ pro Minute für Standarderkennung bis hinunter zu 0,003 $ pro Minute für Dynamic Batch, dem günstigsten Batch-Tarif in diesem gesamten Vergleich. Neukunden erhalten außerdem 300 $ Google-Cloud-Guthaben.
Vorteile: Der günstigste Tarif für große Batches mit 0,003 $ pro Minute, die breiteste Sprachabdeckung, tiefe Integration in den Rest von Google Cloud und Tools für Unternehmen.
Nachteile: Die Standard-Echtzeiterkennung mit 0,016 $ pro Minute ist teurer als Geminis eigenes Dateimodell. Der Konfigurationsaufwand ist größer als bei einem einzelnen sauberen Endpunkt, und Google lenkt neue Arbeit erkennbar zu Gemini 3.5 Transcribe.
Fazit: Wenn Ihr Stack bereits in Google Cloud liegt oder Sie riesige Batch-Aufträge fahren, bei denen 0,003 $ pro Minute gewinnen, ist Chirp 3 eine völlig vernünftige Wahl, manchmal sogar eine günstigere als das neue Gemini-Modell. Vergleichen Sie nur Gleiches mit Gleichem: Batch mit Batch, Echtzeit mit Echtzeit.
8. Rev AI
Am besten für: Genauigkeit bei Akzenten, HIPAA-Konformität und eine menschliche Rückfalloption.
Rev AI stammt von Rev, dem Anbieter menschlicher Transkription, und stützt sich auf diese Herkunft: Die Modelle sind auf über 7 Mio. Stunden menschlich verifizierter Sprache trainiert, und das Unternehmen wirbt mit Fairness über „ethnic background, nationality, gender, and accent“ hinweg. Es deckt 57+ Sprachen ab, erfüllt SOC 2, HIPAA, DSGVO und PCI mit 99,99 % Verfügbarkeit und berechnet maschinelle Transkription mit 0,20 $ pro Stunde, ein Turbo-Modell mit 0,10 $ pro Stunde und menschliche Transkription mit 1,99 $ pro Minute, wenn ein Mensch beteiligt sein soll.
Vorteile: Gleichbleibende Genauigkeit bei Akzenten und schwierigem Audio, starke Compliance für regulierte Branchen und die Möglichkeit, schwierige Dateien an menschliche Transkription zu eskalieren.
Nachteile: Die Marke ist weiterhin vor allem für menschliche Transkription bekannt, daher erhält die Entwickler-API weniger Aufmerksamkeit der Community als Deepgram oder AssemblyAI. Streaming und Premium-Modelle liegen über den Basispreisen von 0,10 bis 0,20 $.
Fazit: Rev AI ist die Wahl, wenn Compliance und Fairness über alle Stimmen hinweg unverzichtbar sind oder wenn Sie gelegentlich ein Transkript in menschlicher Qualität für eine wichtige Datei brauchen. HIPAA-Abdeckung und der Eskalationsweg zu Menschen sind Dinge, die die meisten reinen Modellanbieter nicht bieten, was es zu einer natürlichen Wahl für Gesundheits- und Rechts-Workflows macht.
So treffen Sie die richtige Wahl
Ehrlich gesagt gibt es keinen einzelnen Sieger, nur die passende Lösung für Ihr Audio. Nach allen acht Kandidaten hier der kürzeste Weg zur Entscheidung:
Zwei Faustregeln aus der Beobachtung von Leuten, die darauf aufbauen. Erstens: Testen Sie immer zwei oder drei Dienste mit Ihren eigenen Aufnahmen, bevor Sie eine Pipeline festlegen. Die Benchmark-WER und die WER bei Ihrem verrauschten, akzentuierten Audio mit Überlappungen sind zwei verschiedene Dinge, worauf ich auch im Test von Gemini 3.5 Transcribe herumreite. Zweitens: Zählen Sie die Zusatzfunktionen mit. Ein Listenpreis, der Sprechertrennung und Spracherkennung ausschließt, ist nicht mit einem vergleichbar, der sie bündelt. Deshalb kann Soniox mit pauschal 0,10 $ pro Stunde ein „günstigeres“ Modell schlagen, sobald man die Extras einschaltet.
Wo Transkription endet und Lösung beginnt
Hier der Teil, den ein reiner Modellüberblick übersieht und der mir am wichtigsten ist. Jedes Tool auf dieser Liste macht dieselbe Arbeit: Es verwandelt Audio in Text. Selbst das beste liefert, wenn es das fehlerfrei tut, ein Transkript. Und ein Transkript eines Kundenanrufs oder einer Sprachnachricht ist keine Antwort, sondern der Anfang einer.
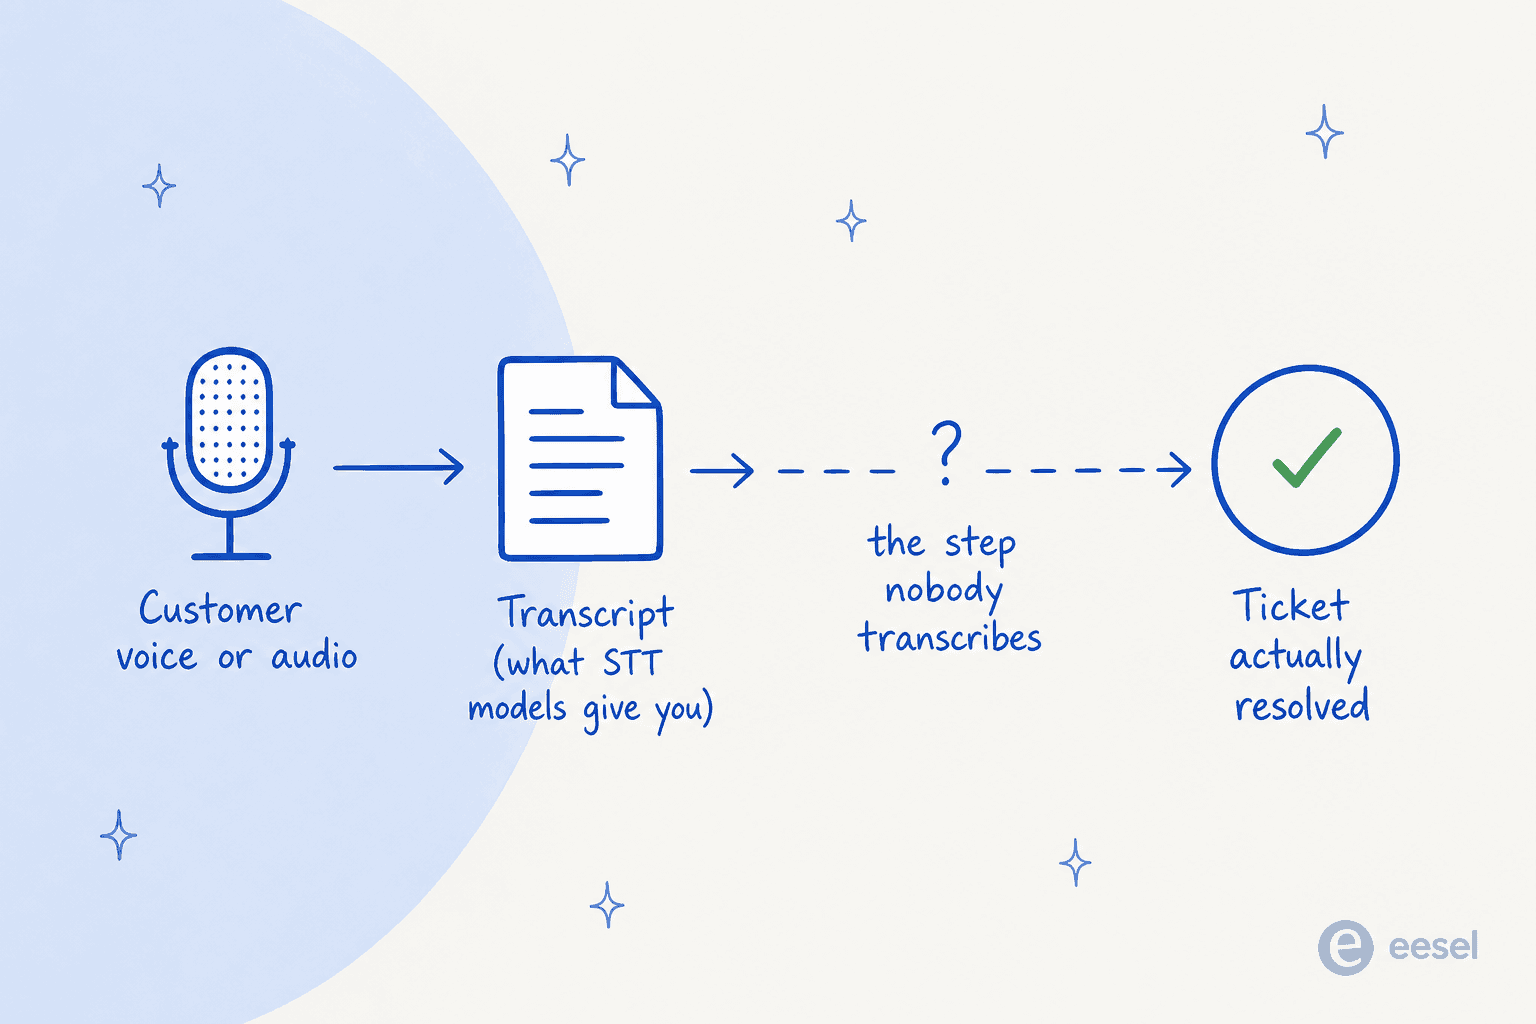
Etwas muss diesen Text noch lesen, verstehen, was der Kunde wirklich braucht, die richtigen Informationen abrufen und das Ticket lösen. An dieser Lösungsschicht arbeite ich. Ich habe die letzten Jahre mit KI an Live-Support-Warteschlangen verbracht, und das Muster bleibt gleich: Die Worte richtig zu erfassen ist Grundvoraussetzung, korrekt darauf zu handeln ist der schwierige Teil. Ein Transkriptionsmodell liefert die Worte. Es kennt weder Ihre Erstattungsrichtlinie noch Ihr Bestellsystem noch die letzten drei Tickets dieses Kunden.
Das ist der Unterschied zwischen einem Modell und einem Teammitglied. Gemini 3.5 Transcribe, Whisper, Deepgram und die übrigen sind Modelle, brillant bei einer eng umrissenen Aufgabe. eesel ist eine Plattform für Teammitglieder: Sie stellen einsatzbereite KI-Teammitglieder für bestimmte Aufgaben ein, und zur aktuellen Besetzung gehören ein KI-Helpdesk-Teammitglied und ein KI-Blog-Autor. Das Helpdesk-Teammitglied wird in das Helpdesk eingebunden, das Sie bereits nutzen, Zendesk, Freshdesk, Gorgias, und stößt zur bestehenden Warteschlange, trainiert mit Ihrem Help Center und Ihren früheren Tickets.
eesel für Sprach- und Chat-Tickets ausprobieren
Wenn Sie Transkriptionsmodelle vergleichen, weil Ihr Team in Sprach- oder Chat-Tickets versinkt, denken Sie daran, dass das Transkript nur die halbe Arbeit ist. Das eesel KI-Helpdesk-Teammitglied setzt dort an, wo ein Modell wie Gemini 3.5 Transcribe aufhört: Es liest die Nachricht des Kunden, entwirft oder sendet die Antwort und schließt den Vorgang ab, über 1.000+ Integrationen hinweg.
Als Erstes würde ich den Simulationsmodus nennen. Bevor eine KI mit echten Kunden in Kontakt kommt, lassen Sie sie über Tausende Ihrer historischen Tickets laufen und sehen genau, wie sie geantwortet hätte, derselbe Rat „erst mit den eigenen Daten testen“, den ich für jedes Transkriptionsmodell geben würde, direkt ins Produkt eingebaut. Der Preis ist ein fester Monatspreis, ab 299 $/Monat für 500 Credits (1 Credit pro Ticket oder Chat) ohne Gebühren pro Nutzer, dazu gibt es einen kostenlosen Plan mit 100 Credits, ohne Karte. Das ist der Unterschied zwischen einer klugen Transkription eines Problems und seiner tatsächlichen Lösung.