As 10 melhores alternativas ao Pluno AI em 2026
Riellvriany Indriawan

Katelin Teen
Última edição August 18, 2026
O que o Pluno realmente acerta
Quero começar por aqui, porque a versão justa deste post não é "o Pluno é ruim". A maioria dos agentes de suporte com IA se baseia apenas na sua central de ajuda e para por aí. Isso funciona para redefinições de senha e perguntas sobre envio. Mas falha no momento em que um cliente escreve "nosso webhook começou a retornar 429 depois do seu deploy de terça-feira", porque a resposta para isso nunca esteve em um artigo. Ela estava em um ticket que seu agente sênior fechou seis semanas atrás.
A proposta inteira do Pluno é essa segunda camada. Seu Deflection AI é treinado com tickets resolvidos no passado, junto com sua base de conhecimento, documentação, threads do Slack e APIs conectadas, e roda um loop de pesquisa iterativo antes de responder. Seu Troubleshooting Agent vai uma camada além, se baseando em sistemas de engenharia ao vivo: o código-fonte e deploys recentes, o estado da conta no banco de dados, Sentry e Datadog, rastros de requisições, replays de sessão. Ele decide não escalar com base em evidências negativas, então um Sentry limpo, mais um log 200-OK, mais um replay, viram "isto não é um bug de produto", escrito como uma nota interna.
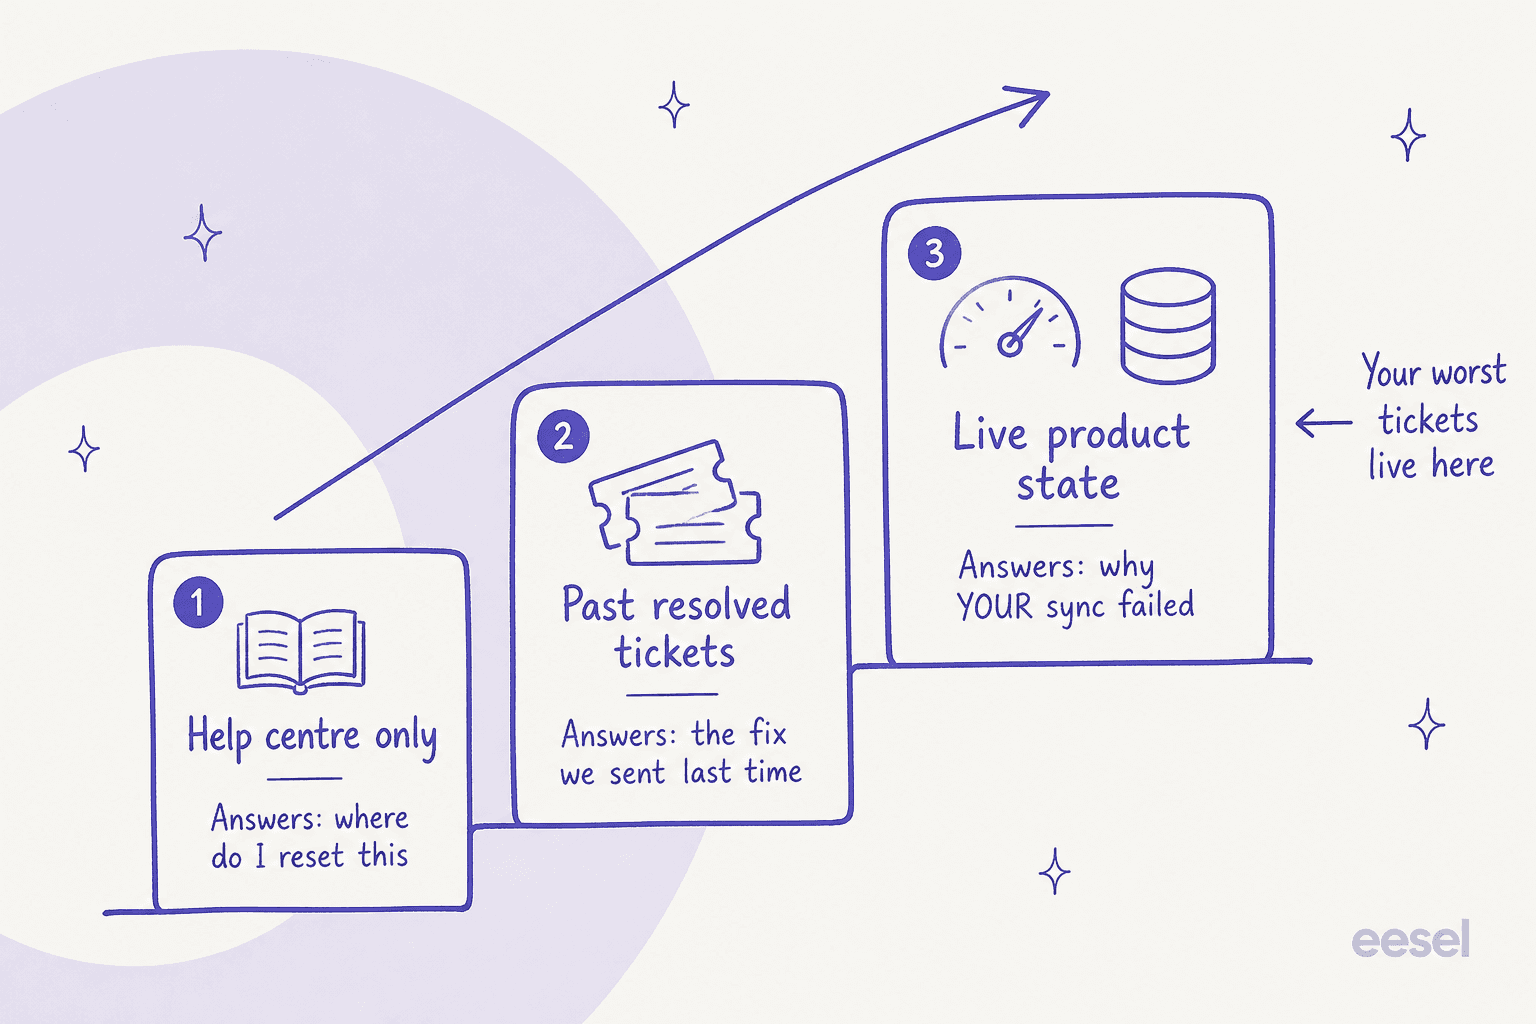
Essa escada é o mapa honesto de toda essa categoria, e é por isso que comparar ferramentas por um único número de taxa de resolução é quase inútil. Um número de 70% conquistado na camada um e um número de 70% conquistado na camada três não são o mesmo produto.
O Pluno também é incomumente honesto em um ponto onde a maioria dos fornecedores não é. Sua própria calculadora de ROI publica uma curva de deflexão por complexidade de ticket: cerca de 90% em "muito simples", 60% em "moderado", e 20% em "extremamente complexo". Um fornecedor que se posiciona contra bots de FAQ publicar um número tão baixo na ponta difícil da curva é um bom sinal sobre esse fornecedor. Esse também é o número em torno do qual um comprador técnico B2B deveria planejar, não os 65% da página inicial nem os 70% da página de deflexão.
Os resultados de clientes publicados também ficam numa faixa ampla, e essa faixa é mais útil do que qualquer média isolada. A Innovorder foi de 0% a 67% de deflexão em seis meses com 3.000 tickets por mês, embora esse número seja limitado a chat e WhatsApp. A Kojo relata de 30% a 50% com 1.000 tickets por mês e cinco agentes. A Waste Vision relata de 10% a 20%, ou de 100 a 200 tickets por mês, além de dois a cinco minutos economizados por ticket. A frase de fechamento nas quatro páginas de estudo de caso afirma que o Pluno "resolve 70% dos tickets", número acima de cada resultado individual de cliente publicado nessas mesmas páginas.
Por onde a comparação começa: os medidores
A tabela de preços do Pluno é o documento mais interessante que ele publica, em parte porque a página de preços a exibe como um controle deslizante, então você só vê um nível por vez. Aqui está a grade completa.
| Volume mensal de tickets | Taxa base, mensal | Taxa base, anual (−15%) |
|---|---|---|
| Menos de 500 | 249€ | 210€ |
| Menos de 1.000 | 499€ | 425€ |
| Menos de 3.000 | 999€ | 850€ |
| Menos de 5.000 | 1.499€ | 1.275€ |
| Menos de 10.000 | 2.499€ | 2.125€ |
| Menos de 20.000 | 3.799€ | 3.230€ |
| Menos de 30.000 | 4.649€ | 3.950€ |
| 30.000+ | Sob consulta | Sob consulta |
Além disso:
| Medidor | Taxa | Unidade | O que aciona |
|---|---|---|---|
| AI Copilot | 49€ | por assento / mês | Cada agente humano que recebe rascunhos e resumos |
| Deflection AI | 0.90€ | por resolução | Um ticket fechado sem envolvimento humano |
| Quality Assurance | 35€ | por agente / mês | Avaliando cada ticket resolvido |
| Troubleshooting Agent | a partir de 99€ | por pacote de créditos | 4.000 créditos, cerca de 50 investigações a aproximadamente 80 créditos cada |
| Enterprise | Sob consulta | - | Restringe SSO, SAML, DPA e transferência bancária |
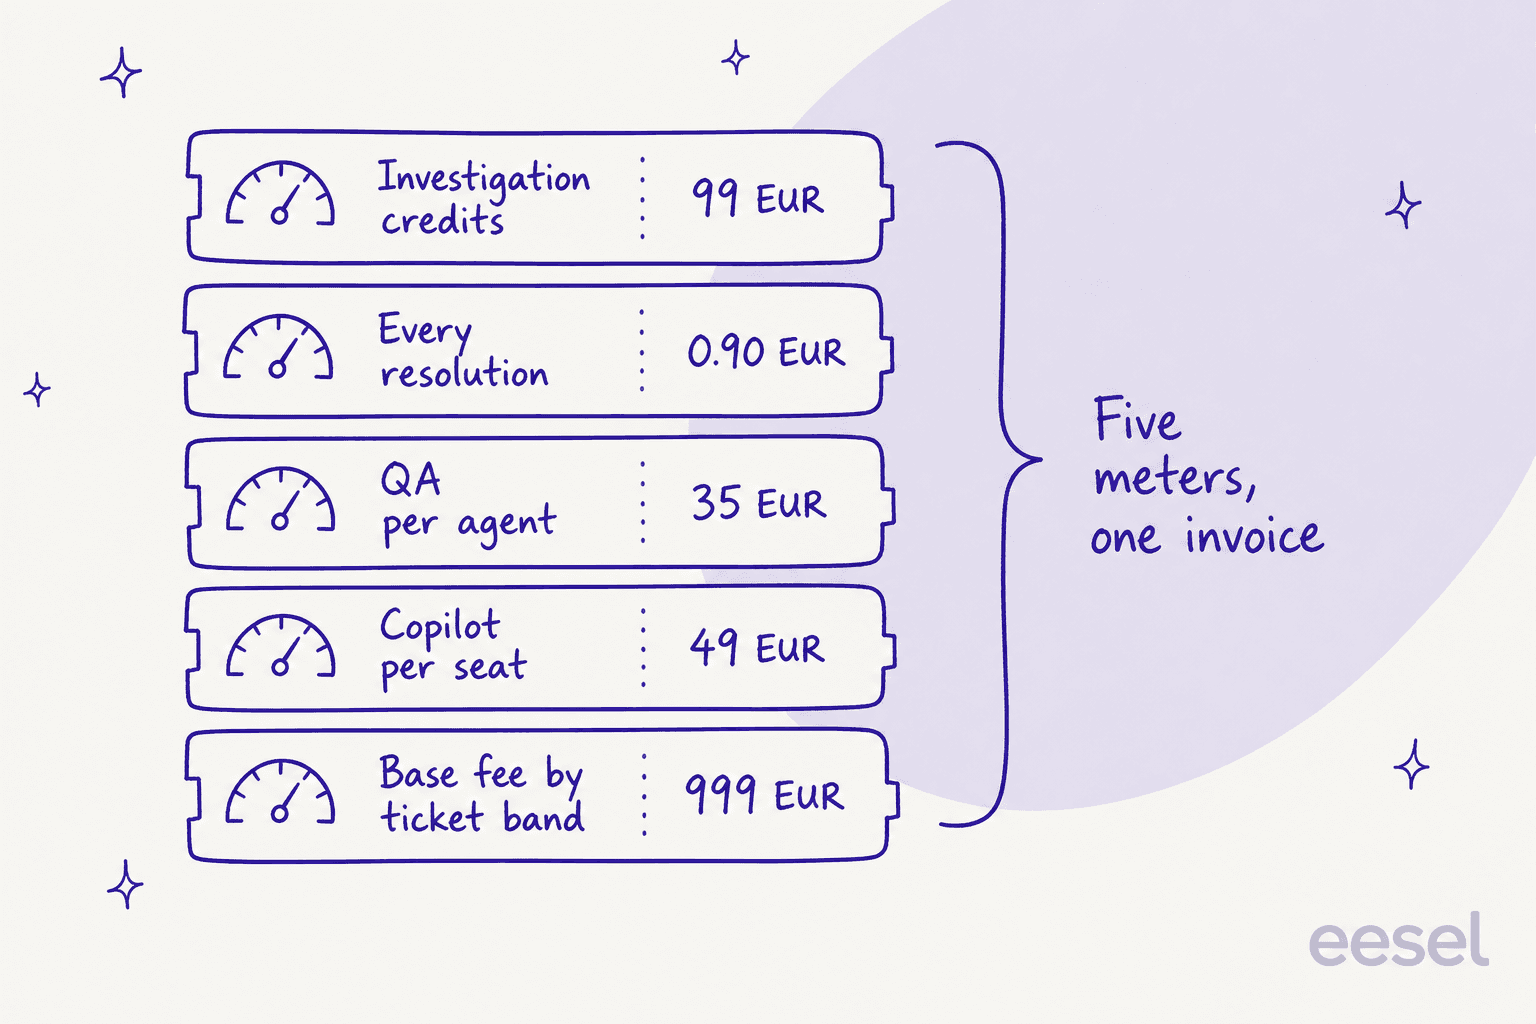
Três coisas nessa estrutura merecem uma pausa de verdade.
A taxa base cobra até por tickets que você nunca encaminha para a IA. Ela é definida pelo "volume mensal total de tickets de suporte em todos os canais", então uma fila em que humanos tratam 80% ainda paga a faixa completa. Isso é o oposto de como funciona a maior parte da precificação por uso, e é a maior armadilha de modelagem da página.
Silêncio é uma resolução faturável. O próprio FAQ do Pluno define isso: "Um ticket é marcado como resolvido 72 horas após a última resposta do Pluno, caso não haja mais resposta do cliente." Escalonamentos nunca são cobrados, o que é justo, e todo ticket resolvido por IA é marcado no helpdesk para que você possa auditar. Mas uma resposta errada que o cliente simplesmente desiste de responder parece idêntica a uma resposta certa com a qual ele ficou satisfeito. Aliás, isso não é exclusividade do Pluno: o Zendesk verifica suas próprias resoluções automatizadas após a mesma janela de 72 horas. Só vale saber que tanto sua métrica de deflexão quanto sua fatura estão, em parte, medindo pessoas que não respondem.
Desempenho custa dinheiro. Com 10.000 tickets por mês, passar de 30% para 60% de deflexão adiciona 2.700€ à fatura mensal, sem nenhuma mudança na taxa base. Numa equipe de 25 agentes nesse volume, só o medidor de resolução já representa cerca de 57% da fatura. O desconto anual de 15% não afeta isso, porque ele se aplica apenas à taxa base.
O que isso significa em três tamanhos reais de equipe
Abaixo está o que cada ferramenta da lista custa em três formatos de equipe técnica B2B, usando as taxas publicadas por cada fornecedor. A tabela do Pluno está em euros, e a de todos os outros em dólares, então deixei ambos na moeda original em vez de inventar uma conversão. Fornecedores que só trabalham sob consulta são marcados assim, porque essa é a resposta honesta.
O padrão nessa tabela é a real descoberta. Ferramentas cobradas por assento ficam mais baratas conforme a IA melhora; ferramentas cobradas por resolução ficam mais caras. Nenhuma das duas está errada, mas elas recompensam comportamentos opostos, e você deveria saber qual delas está assinando.
Como avaliei essas dez
Eu trabalho na fila de suporte do eesel, então minha inclinação é para a pergunta chata: o que acontece no ticket que a demonstração não cobriu. Cinco critérios, na ordem em que realmente os pondero.
- Em que ele se baseia. Central de ajuda, tickets resolvidos, ou estado ao vivo do produto. Veja a escada acima.
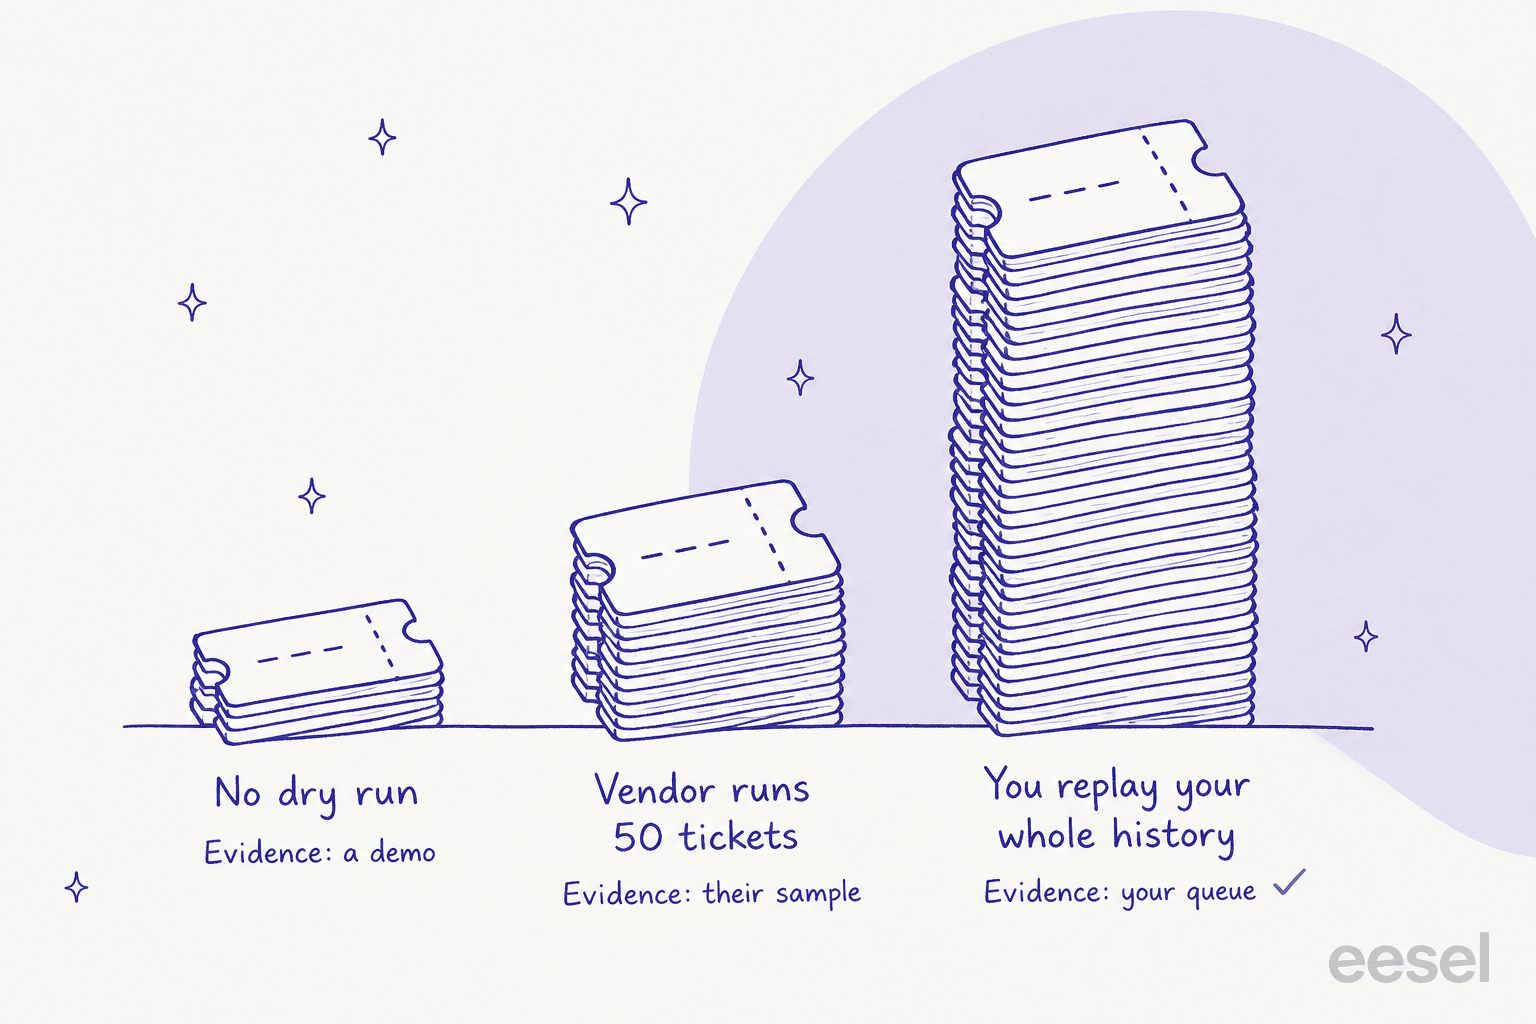
- Se você pode testar com seus próprios tickets antes de comprar. Não uma demonstração roteirizada, não um sandbox, não cenários escritos à mão. Seus tickets reais e fechados.
- A unidade faturável, e se ela é definida. "Por resolução" significa pelo menos quatro coisas diferentes ao longo desta lista.
- Qualidade do escalonamento. O que o humano recebe quando a IA para, e se a IA sabe quando parar.
- Em qual helpdesk ele realmente vive. A maioria delas tem uma stack de origem e fica mais fraca fora dela.
O critério dois é onde quase todas as ferramentas desta lista falham, e vale a pena ser específico sobre por que isso importa.
Rodamos um teste completo com tráfego real do Zendesk para um varejista alemão de joias que fazia cerca de 1.000 tickets por mês no Zendesk e na Shopify, e validamos cruzadamente os resultados em 100 tickets mais 284 chats. A precisão de triagem ficou em 93%. A detecção de spam atingiu 100%, com zero falsos positivos numa caixa de entrada que era 22% spam. Os rascunhos tiveram 88% de precisão direcional. E os agentes enviaram 12% desses rascunhos como estavam.
Essa diferença é o motivo inteiro pelo qual eu me importo com o critério dois. Nada estava quebrado. O padrão dominante era "olhar e reescrever", com agentes transformando rascunhos de 8 a 15 frases em respostas de 1 a 3 frases, e cerca de 65% dessas reescritas eram sobre extensão e tom, corrigíveis treinando com as próprias mensagens enviadas pela equipe. Só cerca de 5% eram a IA estando factualmente errada. Mas você não consegue ver nada disso a partir de um número de precisão num slide. Você vê isso rodando a ferramenta na sua própria fila por algumas semanas. Como meu colega Amogh colocou depois de uma call: "Also - past ticket training strikes again. Classic. People really, really, really want to train on past tickets."
A falha contra a qual isso protege não é a IA dizer "eu não sei". É a IA estar confiantemente errada de um jeito que é tecnicamente respaldado pela sua documentação. Um comprador, uma equipe dinamarquesa de telemetria veicular B2B no Zendesk fazendo cerca de 200 tickets por mês, percebeu isso durante o teste: o bot confirmou alegremente suporte para modelos de carro que não estavam no banco de dados deles, porque a base de conhecimento diz "damos suporte a todos os modelos". O artigo estava correto. A resposta estava errada. Um chatbot baseado em regras nunca teria cometido esse erro, porque nunca teria tentado.
Aqui está outra em que penso bastante, de um líder de CX de uma marca DTC de suplementos no Gorgias e na Shopify, fazendo cerca de 7.000 tickets por mês:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Provavelmente perdemos aquele negócio exatamente por essa lacuna. É a exigência certa, e é por isso que eu pondero os limites de confiança com tanto peso quanto a taxa de resolução.
A lista resumida em um relance
| Ferramenta | Melhor para | Preço inicial | Unidade faturável | Treina com tickets resolvidos | Teste real com seus tickets | Helpdesk de origem | SOC 2 | G2 |
|---|---|---|---|---|---|---|---|---|
| eesel AI | Provar valor no seu histórico primeiro | $0.40/ticket | Por ticket atendido | Sim | Sim, histórico completo | Zendesk, Freshdesk, Front, Gorgias, HubSpot, JSM, Salesforce | Type II em andamento | Avaliações insuficientes |
| Pluno | Equipes no Zendesk que querem respostas baseadas em engenharia | 249€/mês base | Base + assento + resolução + QA + créditos | Sim | Rodado pelo fornecedor, últimos 50 tickets | Zendesk | Type 2 | 4.8/5 (3 avaliações) |
| Zendesk AI | Recusar adicionar mais um fornecedor | $19/agente/mês | Assento + $1.50 por resolução | Não | Não | Zendesk | Type 2 | 4.3/5 (6,964) |
| Decagon | CX de consumidor em alto volume | Somente sob consulta | Por conversa ou resolução | Não divulgado | Não | Não nomeado publicamente | Não enumerado | 4.9/5 (~18) |
| Sierra | Preço por resultado e voz | Somente sob consulta | Por resultado, por contrato | Não divulgado | Escopo não informado | Não nomeado publicamente | Tipo não divulgado | 4.1-4.3/5 (17) |
| Twig AI | Deflexão baseada em documentação com orçamento pequeno | $0 grátis, $99/mês | Chats de IA e minutos de voz | Alegado em uma única página | Não | Zendesk, Freshdesk | Type II | 4.9/5 (10) |
| IrisAgent | Marcação e triagem incluídas | Grátis, depois $500/mês | Não divulgada | Sim | Não | Zendesk, Salesforce, Freshworks, HubSpot, Zoho, Gorgias | Type II | 4.8/5 (2 avaliações) |
| Thena | Contas B2B que vivem no Slack | $29/usuário/mês | Por assento, sem medidor de IA | Não | Não documentado | Slack, email, Teams | Type II | 4.9/5 (65) |
| Unthread | Prioriza o Slack, com uma espinha dorsal de tickets de verdade | $50/agente/mês, 5 min | Por assento, sem medidor de IA | Parcialmente, via documentos gerados | Não documentado | Slack, Teams, email | Type II | 4.9/5 (13) |
| Ada | Autoatendimento multilíngue em escala corporativa | Somente sob consulta | Não divulgada | Não | Cenários escritos manualmente | Zendesk, Salesforce, ServiceNow, Genesys | Type II | 4.6/5 (173) |
| Crescendo | Comprar pessoas e software juntos | $2,900/mês + $1.25/solve | Por solve, mais taxa de plataforma | Não | Não | Zendesk, Freshdesk, Gorgias, Front | Type II | 0 avaliações |
Uma observação sobre essas colunas de G2, porque esses são os números mais mal interpretados nessa categoria. O site do Pluno diz "4.8/5 no G2," e isso está exatamente certo: são 4.8 em três avaliações, com mais três no Capterra, e dois avaliadores aparecem nas duas plataformas, então a contagem defensável é de quatro pessoas distintas. O próprio G2 estampa o motivo na página: não há avaliações suficientes para fornecer um indicativo de compra. Também existem 87 avaliações espalhadas pelas sete listagens do Pluno no Zendesk Marketplace, e um dos avaliadores recorrentes ali é citado na própria página da equipe do Pluno. Nada disso significa que o produto seja ruim, e os números de clientes dentro dessas avaliações são reais. Significa que um 4.8 com n=3 diz menos do que um 4.3 com n=6,964, e ambos deveriam ser lidos com o denominador junto.
1. eesel AI
Ideal para: equipes que querem a taxa de resolução medida com base em seus próprios tickets antes de qualquer coisa entrar no ar.
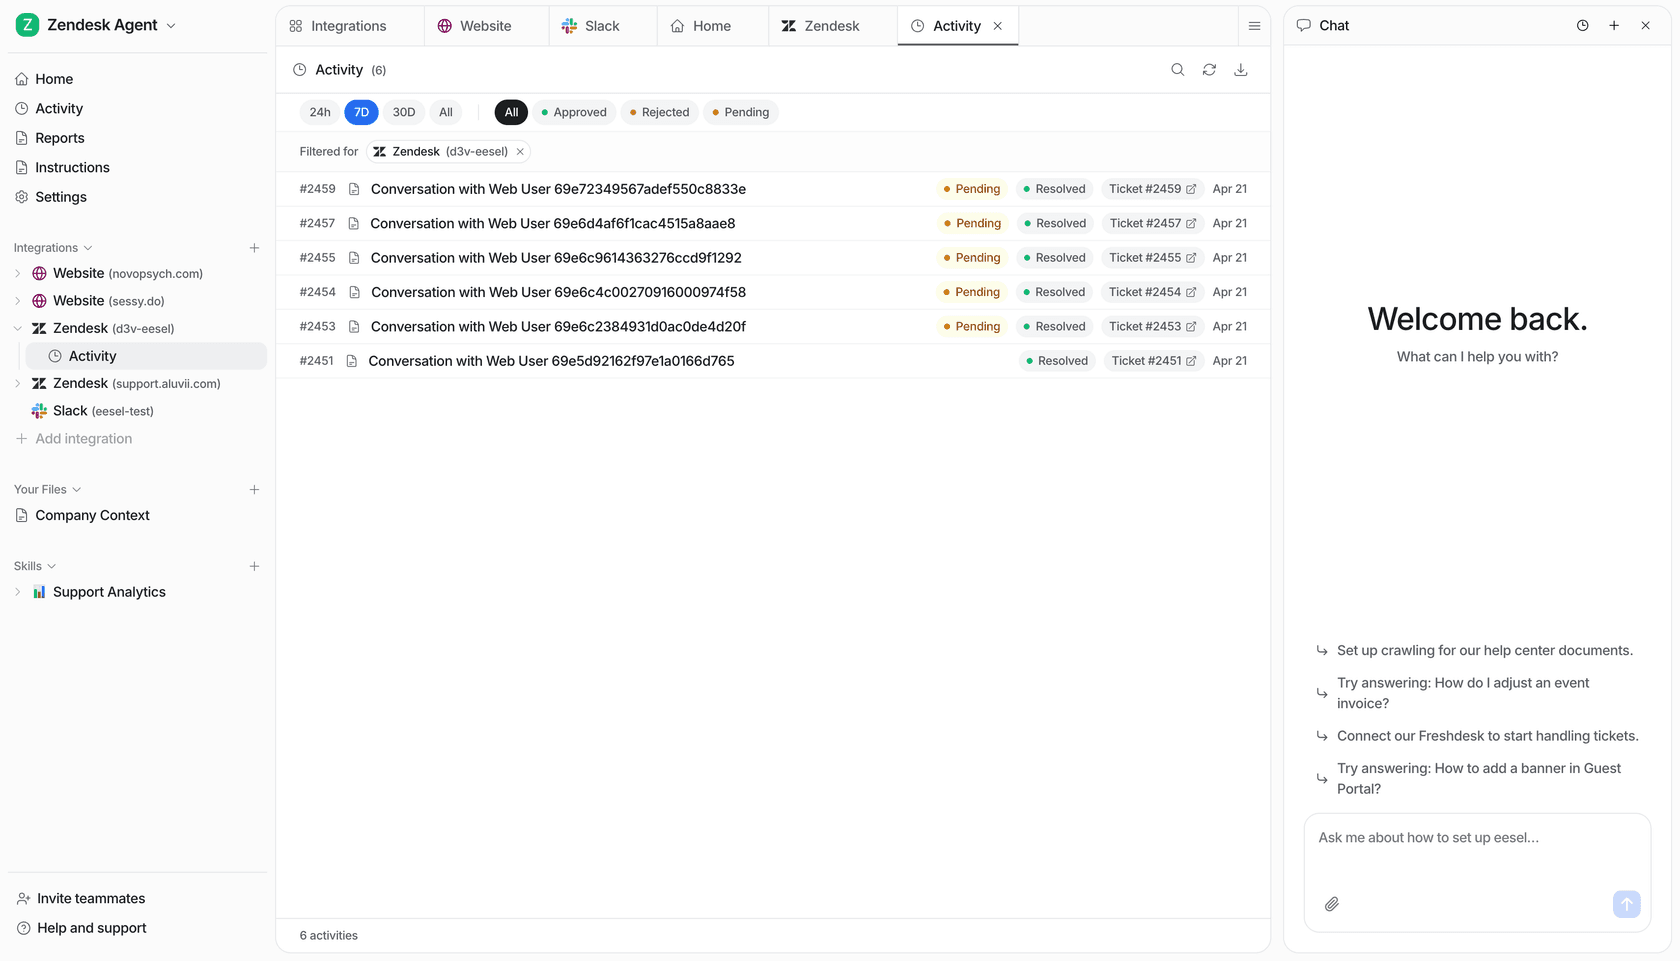
Eu trabalho aqui, então leve o entusiasmo com essa ressalva, mas o motivo de o eesel liderar esta lista é o único critério que nenhuma outra ferramenta satisfaz. O modo de simulação reproduz o histórico dos seus tickets resolvidos, mostra a cobertura detalhada por tema, diz quais temas ele teria tratado e quais teria escalado, e permite preencher as lacunas e rodar novamente antes de ativar qualquer coisa. Você obtém uma previsão de resolução construída a partir da sua fila, não da amostra de um fornecedor.
A base de conhecimento fica na camada dois e alcança a camada três: tickets passados, documentos de ajuda, macros, e ferramentas conectadas em mais de 100 integrações. A implantação é deliberadamente gradual, rascunhos primeiro, depois autonomia nos temas que a simulação já comprovou, com roteamento baseado em confiança enviando qualquer coisa duvidosa para um rascunho em vez de uma resposta ao vivo. Ele também encontra tópicos que sua base de conhecimento não cobre e rascunha os artigos que faltam, que é a outra metade do truque dos tickets passados.
Preços
| Item | Preço | Unidade |
|---|---|---|
| Início gratuito | $50 em uso + 2 gerações de blog | Único, sem cartão |
| Tarefa leve | Gratuito | Perguntas de painel, consultas |
| Tarefa regular | $0.40 | Um ticket ou sessão de chat, não importa quantas respostas |
| Tarefa pesada | $4.00 | Um rascunho de post de blog |
| Compromisso anual | 25% de desconto | Comprometa-se com um ano antecipado |
| Enterprise | $1,000/mês | Taxa fixa de plataforma além do uso |
Sem taxa de plataforma, sem cobrança por assento, sem mínimo no plano padrão. Você é cobrado por ticket atendido, não por resposta, e nunca por tickets que seus humanos assumem: encaminhe 200 dos seus 1.000 e você paga por 200.
Prós
- A única ferramenta aqui com um teste real autoatendido sobre todo o seu histórico de tickets.
- A cobrança por ticket significa que o custo é fixo, seja a IA resolvendo ou escalando, então você não paga mais por ela funcionar melhor.
- Funciona dentro do helpdesk que você já usa: Zendesk, Freshdesk, Front, Gorgias, HubSpot, Jira Service Management, Salesforce, Slack.
- Mais de 80 idiomas, treinado com histórico de tickets multilíngue em vez de traduzido no momento da resposta.
Contras
- O SOC 2 Type II está em andamento, não certificado. Se sua análise de segurança precisa de um relatório concluído hoje, isso é um bloqueio real.
- HIPAA e um BAA ficam no nível Enterprise de $1,000/mês.
- Sem canal de voz próprio, então uma fila com muito volume por telefone precisa de outra coisa junto.
- A cobrança por ticket também cobra por tickets escalados, o que é pior custo-benefício do que um modelo por resolução numa fila com um teto de deflexão baixo.
Veredito: escolha o eesel se você quer a resposta para "isso vai funcionar com nossos tickets" antes de assinar, e se a precificação por ticket combina com uma fila em que uma boa parcela ainda precisa de um humano. A Global Pay relata até 80% de economia de tempo na busca por respostas; a InDebted levou seu helpdesk de TI de 15% de deflexão em direção a uma meta de 55% no Jira Service Management; a Gridwise viu 73% das solicitações de nível 1 resolvidas no primeiro mês, com resultados chegando dentro de um teste de sete dias. Pule se você precisa de um relatório SOC 2 concluído ou de voz hoje.
2. Agentes de IA do Zendesk
Ideal para: equipes que preferem ativar um item de linha a integrar um novo fornecedor.
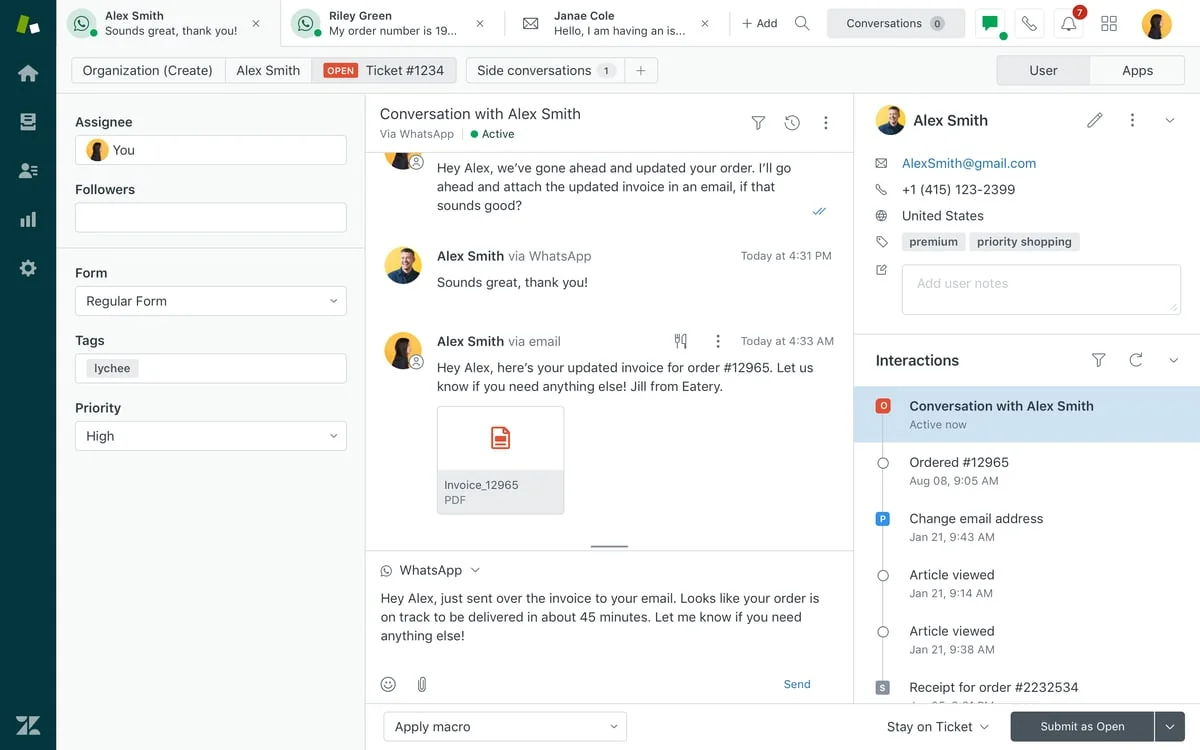
Se o apelo do Pluno é que ele vive dentro do Zendesk, a primeira pergunta óbvia é por que não usar a própria camada do Zendesk. A Resolution Platform do Zendesk está bem melhor do que era: procedimentos generativos transformam uma política em linguagem simples em algo que o agente executa, o raciocínio adaptativo lida com múltiplos problemas numa única mensagem, e os controles de raciocínio expõem por que cada ação disparou no log da conversa.
A pegadinha estrutural é a base de conhecimento. Um agente de IA pode conectar exatamente dois tipos de fonte: centrais de ajuda do Zendesk, e conteúdo externo trazido por crawler ou conector. Seu arquivo de tickets resolvidos não é uma fonte de conhecimento conectável. Em vez disso, o Zendesk transforma tickets em conteúdo, com o Knowledge builder gerando artigos a partir do histórico de tickets e macros sugeridas extraídas de dados históricos, e então o agente lê os artigos. Para uma fila técnica B2B, isso é um degrau significativo abaixo na escada. Também vale saber: centrais de ajuda conectadas são pesquisadas ao vivo, mas fontes externas são pesquisadas contra a última sincronização, que costuma rodar a cada 24 horas.
Preços
| Item | Anual | Mensal |
|---|---|---|
| Support Team | $19/agente | $25/agente |
| Suite Team | $55/agente | $69/agente |
| Suite Professional | $115/agente | $149/agente |
| Suite Enterprise + Copilot | Fale com vendas | Fale com vendas |
| Resoluções automatizadas comprometidas | $1.50 cada | $1.50 cada |
| Resoluções pagas por uso | $2.00 cada | $2.00 cada |
| Complemento Copilot | $50/agente (Professional ou superior) | - |
A franquia é de 5 resoluções automatizadas por agente por mês no Support Team e no Suite Team, e 10 no Suite Professional. Desde maio de 2026, apenas uma resolução verificada consome essa franquia: um LLM verifica, após uma janela de silêncio de 72 horas, se a solicitação foi realmente atendida, e resoluções contidas que falham nessa verificação, além de escalonamentos assistidos, não são cobradas. Essa é uma melhoria real em relação à contagem antiga, e os números ainda somam rápido. Nosso guia de preços do Zendesk AI se aprofunda nesse empilhamento.
Prós
- Zero trabalho de integração, uma única fatura, e a IA consegue ver tudo o que o helpdesk vê.
- A cobrança por resolução verificada é mais rigorosa do que a maioria dos medidores por resolução, e escalonamentos assistidos são gratuitos.
- 80 idiomas com troca automática, e logs de raciocínio bons o suficiente para auditoria.
Contras
- O histórico de tickets não é uma fonte de conhecimento do agente, o que é o contraste mais nítido com uma ferramenta treinada em tickets passados.
- Nenhum teste real sobre seus próprios tickets. Os três caminhos de teste documentados são um ambiente de teste, um gatilho de e-mail de teste, e um botão "Test AI agent", todos voltados para o futuro.
- O e-mail escala por padrão em casos mistos comuns, incluindo uma pergunta de conhecimento e uma solicitação de procedimento na mesma mensagem.
- Os custos se empilham em três camadas: assentos, depois resoluções, depois o Copilot de $50/agente que só se aplica a partir do Suite Professional.
- Agentes de IA - Essential está descontinuado desde maio de 2026 e será removido em 10 de dezembro de 2026, então planeje as migrações agora.
Veredito: a opção padrão que vale a pena tentar superar, e é possível superá-la. O sentimento aqui é dividido, principalmente sobre o medidor, não sobre as respostas:
"Complete trash lol, stuff I used to get free now counts as an AR. Most of the ARs are abandoned chats. There's no dispute resolution process. Complete scam. I used to like Zendesk but since trying the new bot and now this I have little good will left"

Escolha essa opção se a fila tem formato de FAQ e o processo de compras importa mais do que o teto de desempenho. Veja as alternativas ao Zendesk AI se seus tickets mais difíceis precisam de histórico de tickets.
3. Decagon
Ideal para: CX voltado ao consumidor em volume sério, com tempo de engenharia disponível para investir.
A Decagon é o nome mais forte em IA conversacional corporativa no momento, e seus Agent Operating Procedures são uma ideia inteligente: fluxos de trabalho escritos em linguagem natural que compilam em código executável, posicionados explicitamente contra linguagens de configuração que "inflam custos e consomem tempo de engenharia." Um único runtime cobre chat, voz, e-mail e SMS com memória cruzada entre canais, voz construída sobre a ElevenLabs, mais de 70 idiomas com detecção automática.
A pergunta de adequação para um leitor técnico B2B é honesta, e é sobre ICP. O próprio formulário de demonstração da Decagon torna o volume mensal de tickets um campo obrigatório, com faixas começando em "menos de 9,999" e indo até "250,000+." Isso diz para quem esse preço foi pensado. Seu material publicado também nunca nomeia uma integração específica de helpdesk, apenas categorias, então se você usa Front ou Help Scout, não é possível confirmar o suporte pelo site.
Preços. Somente sob consulta. decagon.ai/pricing retorna um erro 404 e não há link de preços na navegação. A Decagon descreve os dois modelos que ela vende: por conversa (cobrado em cada interação que a IA toca, resolvida ou não, e ela diz que a maioria dos clientes escolhe essa opção) ou por resolução (taxa unitária mais alta, nada cobrado quando escala). Nenhum valor em dólares está atrelado a nenhum dos dois. Não há plano gratuito, nem teste, nem caminho de autoatendimento. Nosso detalhamento de preços da Decagon tem o que é possível saber.
Prós
- Fluxos de trabalho em linguagem natural que compilam, em vez de um construtor de regras que você mantém para sempre.
- Observabilidade completa: cada chamada de modelo, etapa de fluxo de trabalho e consulta de conhecimento é rastreada, além de testes A/B ao vivo entre versões do agente.
- Referências fortes em escala real, e 4.9/5 em aproximadamente 18 avaliações no G2.
Contras
- Nenhum preço, piso ou teste autoatendido publicados. A avaliação começa com uma ligação de vendas condicionada ao seu volume de tickets.
- O teste consiste em conversas simuladas mais testes A/B pós-lançamento, não uma reprodução do seu arquivo.
- Se tickets resolvidos no passado são uma fonte de ingestão não é declarado em suas páginas públicas.
- A reclamação recorrente dos avaliadores é o esforço de configuração, "recursos significativos de engenharia antecipados" e uma curva inicial íngreme, mais do que a qualidade das respostas.
Veredito: se você é uma marca de consumo fazendo mais de 50.000 conversas por mês com engenheiros disponíveis para alocar, a Decagon merece a reunião. Para uma fila técnica B2B de 3.000 tickets, é a categoria de peso errada, e Decagon para SaaS é a página para ler antes de presumir o contrário.
4. Sierra
Ideal para: compradores que querem pagar apenas por resultados, e têm jurídico para negociar o que é um resultado.
A Sierra vende preços baseados em resultado com mais clareza do que qualquer outra: "a precificação baseada em resultado está atrelada a impactos tangíveis para o negócio, como uma conversa de suporte resolvida, um cancelamento evitado, um upsell." Se a conversa não é resolvida, na maioria dos casos não há cobrança. Sua ferramenta Ghostwriter constrói o agente a partir do seu material bruto, e as entradas aceitas são incomumente amplas: SOPs, transcrições de ligações e chats, fotos de quadro branco, gravações de áudio, ou uma descrição do objetivo em linguagem simples.
Duas ressalvas acompanham essa história de preços. Os critérios para um resultado pago são acordados por contrato, não definidos universalmente, então "por resolução" significa o que quer que o seu MSA diga que significa. E a Sierra admite que a fatura real é combinada: tráfego de roteamento e de estilo recepcionista "pode se alinhar melhor com preços baseados em consumo, em que o pagamento se baseia na contagem de conversas, independentemente do resultado." Então uma fatura da Sierra pode carregar uma linha por conversa ao lado da linha por resultado.
Preços. Somente sob consulta, e não há nenhum valor em dólares em lugar nenhum do sierra.ai. A página de preços retorna erro 404 e sempre retornou. Nenhuma taxa de plataforma é mencionada, mas a Sierra também nunca diz que não existe uma, então não presuma. Veja preços da Sierra para o quadro completo.
Prós
- A superfície de conformidade mais ampla desta lista: selos de SOC 2, ISO 27001, ISO 42001, HIPAA, GDPR, EU AI Act, CSA STAR Level One, FedRAMP e PCI DSS.
- Ações reais, não apenas respostas. O Agent SDK cobre atualizar uma assinatura ou enviar uma reclamação de garantia, com depuração de chamadas de API e rastreamento de lógica.
- 59 idiomas na plataforma, mais de 55 em voz, e simulações de voz em casos extremos.
Contras
- Sem teste, sem sandbox, sem cadastro autoatendido, então a aprovação de orçamento precede qualquer avaliação prática.
- Esses selos não têm um centro de confiança por trás: tanto
/securityquanto/trustretornam 404, então nenhuma data de auditoria, escopo de relatório, ou distinção entre SOC 2 Type I e Type II é publicada. - Simulações existem, mas a Sierra nunca declara se elas reproduzem seu histórico ou rodam cenários escritos manualmente.
- Nenhuma integração de helpdesk nomeada é publicada, e a exceção de escalonamento é qualificada como "na maioria dos casos."
Veredito: o modelo de preços mais bem argumentado da categoria, numa plataforma que claramente consegue fazer o trabalho, mas você está negociando a definição de um resultado pago antes de conseguir modelar uma fatura. Ótimo para uma grande marca com músculo de compras; pesado demais para uma equipe de suporte de 25 pessoas. Alternativas à Sierra cobre as opções mais leves.
5. Twig AI
Ideal para: pequenas equipes técnicas que querem deflexão baseada em documentação sem um ciclo de vendas.
O Twig é a coisa mais próxima aqui do posicionamento do Pluno, com um preço de autoatendimento, e é o único item desta lista em que preciso sinalizar confusão no próprio material do fornecedor, em vez de apenas relatar fatos. O Twig roda dois produtos num único domínio: uma plataforma autônoma de suporte com IA para SaaS B2B, fintech e e-commerce, e o "Sera," uma recepção de voz e chat para consultórios odontológicos, clínicas de estética e concessionárias de carros. Os dois quase não compartilham stack.
Essa divisão aparece na pergunta de fonte de dados que mais importa. A página twig.so/industries/saas diz duas vezes que o Twig ingere "artigos da central de ajuda, documentação do produto, tickets passados e wikis internas." A página complementar de caso de uso de Nível 1 lista as fontes como "sua base de conhecimento, central de ajuda, e documentação do produto," com tickets passados ausentes. A página inicial lista apenas site, documentação e FAQs. Eu confirmaria isso por escrito antes de deixar que se torne um motivo de compra.
Preços. Duas tabelas de taxas, duas unidades, e nenhuma das páginas reconhece a outra.
| Plano Sera | Preço | Chats de IA/mês | Minutos de voz | Excedente de chat | Excedente de voz |
|---|---|---|---|---|---|
| Free | $0, para sempre | 100 | - | - | - |
| Starter | $99/mês | 500 | - | $100/1K chats | - |
| Growth | $499/mês | 2,000 | 300 | $100/1K chats | $1/min |
| Scale | $1,499/mês | 10,000 | 2,000 | $100/1K chats | $1/min |
Separadamente, o hub de comparação afirma que "o Twig é uma plataforma autônoma de suporte com IA que começa em $5/ticket." Um ticket nunca é definido ali: nada sobre se ele cobra na criação, no toque da IA, ou na resolução, e nada sobre se um ticket escalado ainda custa $5.
Prós
- Um plano gratuito de verdade para sempre com 100 chats de IA por mês, e um teste de 15 dias em todo plano pago.
- SOC 2 Type II com selo da Vanta, AES-256 em repouso, TLS 1.3, residência de dados nos EUA e na UE, e redação de PII antes de o conteúdo chegar ao modelo.
- 4.9/5 no G2, e as avaliações descrevem a recuperação de conhecimento interno funcionando bem.
Contras
- Nenhuma simulação, backtest, teste real ou modo shadow em lugar nenhum. O único controle de qualidade é a autoavaliação por resposta em tráfego ao vivo.
- Duas tabelas de taxas em unidades diferentes, e o número de $5/ticket não tem página de plano ou tabela de níveis por trás.
- O servidor MCP é somente leitura: três ferramentas, nenhuma ação de escrita, então ele não consegue agir sobre um ticket.
- A amostra do G2 é de 10, quatro delas concentradas numa janela de duas semanas, e nenhuma menciona o produto Sera.
- Dois números do próprio fornecedor entram em conflito sobre o mesmo cliente: a página inicial afirma 90% mais rápido na primeira resposta, o estudo de caso vinculado diz 60% em seu próprio título.
Veredito: vale 20 minutos no plano gratuito se sua documentação de produto for forte e seu orçamento for pequeno. O avaliador mais recente do G2 é justo sobre o atrito:
"I think the onboarding process could be sped up. It initially took a while to get things set up, but I believe things have improved since then. The Twig AI implementation team made it easy, though it took a little bit longer than we anticipated."

6. IrisAgent
Ideal para: equipes cuja dor real é marcação e triagem, não deflexão.
A IrisAgent é a única ferramenta que trata o histórico de tickets, sem ambiguidade, como uma fonte de conhecimento de primeira classe, e sua fundadora Palak Dalal Bhatia diz isso diretamente: IA para suporte "só funciona se as respostas forem baseadas na própria base de conhecimento e no histórico de tickets da empresa, não nos dados de treinamento do LLM." Existe um Hallucination Removal Engine nomeado que valida respostas contra o seu conteúdo, e Smart Operating Procedures compilam procedimentos em linguagem simples em fluxos de trabalho, com os procedimentos tendo precedência sobre respostas da base de conhecimento.
O ponto mais forte, porém, é a camada ao redor do agente. Os Case Triggers podem responder automaticamente, rotear, atribuir, marcar, preencher campos personalizados e postar notas privadas. Uma barra lateral do Copilot com 11 painéis fica dentro do helpdesk com Suggested Resolution, uma pontuação de prioridade de caso de 0 a 100, sentimento, casos semelhantes e vínculo com o Jira. Isso é o tipo de coisa prática com que uma equipe técnica B2B luta diariamente.
Preços. Gratuito, depois "A partir de $500/mês" no Standard, depois Enterprise sob consulta. A unidade faturável não é divulgada para nenhum nível: nenhum número de assento, nenhum teto de conversas, nenhuma contagem de resolução, nenhum limite de documentos. A tabela de níveis é uma lista de recursos em que nenhuma linha traz um número. Existem dois medidores de resultado separados em outro lugar: o Managed Resolution é pago por resolução sem taxa publicada, e o Voice AI custa $2 por ligação totalmente resolvida. Nosso post sobre preços da IrisAgent se aprofunda no que isso significa na prática.
Prós
- O histórico de tickets é uma fonte de conhecimento real, não uma frase de marketing.
- A camada de marcação e preenchimento de campos é a mais completa aqui, e é o que os usuários realmente elogiam.
- Certificação SOC 2 Type II, GDPR, HIPAA "Ready," SLA de 99.9% de disponibilidade, além de uma opção auto-hospedada com zero saída de dados.
- Integrações nomeadas com Zendesk, Salesforce Service Cloud, Freshworks, HubSpot Service Hub, Zoho Desk e Gorgias.
Contras
- $500/mês sem nenhuma unidade atrelada significa que você não consegue modelar o custo a partir da página.
- Nenhum teste real. A validação pré-lançamento é o IrisGPT Playground, uma pergunta de cada vez, além de uma implantação de notas privadas em tickets ao vivo.
- A página inicial publica tanto 60%+ quanto 50%+ como seu número de resolução, sem metodologia ou data em nenhum dos dois.
- A página de preços marca cinco capacidades como incluídas em um nível, mas também as vende como complementos pagos.
- Garantias de SLA e SSO/SAML são exclusivas do Enterprise, e o G2 tem apenas duas avaliações.
Veredito: a escolha subestimada se a higiene dos seus tickets é o gargalo. A única voz de usuário não afiliado que consegui encontrar diz exatamente isso, e é sobre marcação, não deflexão:
"OP, you should checkout IrisAgent. We're using them at my company (Fintech) - I haven't had to manually update a field or tag a ticket in 9 months because of it. Soooo nice lol"
7. Thena
Ideal para: equipes B2B cujos clientes já falam com elas em canais compartilhados do Slack.
Se seus clientes corporativos levantam problemas no Slack Connect em vez de um formulário na web, o mundo moldado pelo Zendesk do Pluno é o formato errado por completo, e a Thena é a resposta para uma pergunta diferente. Ela transforma conversas do Slack, e-mail, chat na web, Teams e Discord em tickets rastreáveis, com detecção de tickets por IA no nível de entrada e reações de emoji disparando ações de ticket em todos eles. A IA cria tickets, preenche campos, lembra, transfere, resume, extrai insights e coleta feedback.
Preços
| Plano | Preço | Unidade | Limites |
|---|---|---|---|
| Starter | $29 | por usuário/mês, cobrado anualmente | Até 5 assentos, 1,000 tickets/mês, apenas Slack e e-mail |
| Standard | $79 | por usuário/mês, cobrado anualmente | Nenhum limite publicado |
| Enterprise | $119 | cobrado anualmente | Adiciona Microsoft Teams |
Nada aqui é condicionado a uma consulta comercial, o que é revigorante, e não há medidor de IA algum: a automação vem embutida no preço do assento, sob a ideia de que "a IA é o padrão."
Prós
- Preço por assento sem cobrança por resolução, então a fatura não cresce conforme a deflexão melhora.
- Genuinamente multi-persona: políticas de SLA com horário de trabalho, roteamento para grupos, RBAC, e um servidor MCP expondo tickets para Claude, Cursor e Raycast.
- SOC 2 Type II com auditorias anuais de terceiros e testes de penetração semestrais, monitorados via Vanta.
- 4.9/5 em 65 avaliações no G2, a amostra mais saudável entre as ferramentas nativas do Slack aqui.
Contras
- O conhecimento vem de centrais de ajuda e artigos escritos na Thena. O treinamento sobre o histórico acumulado de tickets não é documentado.
- Nenhum teste real documentado. Os logs de IA são, em vez disso, uma trilha de auditoria posterior.
- O Microsoft Teams é exclusivo do Enterprise, a $119/usuário/mês, então uma empresa focada em Teams não consegue comprar abaixo do nível mais alto.
- O compromisso anual é a única forma de entrada publicada, e nenhuma taxa de excedente é informada para o limite de 1,000 tickets do Starter.
- O limite de assentos diverge entre páginas: a página de preços diz 5 assentos no Starter, a página inicial diz 10.
Veredito: a ferramenta certa se o canal é o problema. Um avaliador do G2 é admiravelmente claro sobre o limite:
"Limited Platform Support – While Thena integrates well with Slack, Microsoft Teams, and email, companies that rely on other platforms (e.g., Discord, WhatsApp, or in-app chat systems) might find it lacking."
8. Unthread
Ideal para: suporte com foco em Slack que ainda precisa de um sistema de tickets de verdade por baixo.
A Unthread fica próxima da Thena, mas se inclina mais fortemente para ser um helpdesk do que uma camada do Slack. E-mail para ticket é de primeira classe, com threading e anexos, e seu próprio exemplo prático é pontualmente técnico: uma mensagem no Slack sobre uma integração SSO da Okta quebrada, um e-mail do financeiro, e um chat na web sobre uma API retornando 429, tudo chegando em uma única fila. Ela também vende o mesmo produto para TI interna e suporte externo ao cliente, o que serve empresas em que essas duas filas compartilham pessoas.
Sua abordagem sobre tickets passados é um caminho intermediário que vale a pena entender. A IA rascunha artigos de base de conhecimento a partir de tickets resolvidos no plano Pro, e o agente então recupera dessa base de conhecimento. Então o histórico de tickets chega até a resposta, mas por meio de um artigo, a mesma rota indireta que o Zendesk segue.
Preços
| Plano | Preço | Unidade | Mínimo | Piso | Limite |
|---|---|---|---|---|---|
| Basic | $50 | por agente/mês | 5 assentos | $250/mês | 100 conversas/mês, sem IA |
| Pro | $75 | por agente/mês | 5 assentos | $375/mês | Não informado |
| Enterprise | Não divulgado | - | - | - | - |
Duas coisas a observar. O Basic tem zero IA, então o ponto de entrada real para automação é o Pro, a $375/mês. E o limite de 100 conversas no Basic é por plano, não por agente, então cinco agentes o dividem entre si.
Prós
- Nenhum medidor de IA em qualquer nível, então a automação não adiciona uma linha variável.
- SOC 2 Type II, conformidade com HIPAA com BAA disponível, TLS 1.3, AES-256, testes de penetração de terceiros, e instâncias de banco de dados isoladas opcionais em países específicos.
- Mais de 100 integrações, com mais de 50 bidirecionais, incluindo Zendesk, Jira, Linear, HubSpot, Salesforce, PagerDuty e Okta.
- O Head de TI da Lemonade relata que ela "resolve automaticamente cerca de 40% de todos os tickets que chegam entre diferentes equipes."
Contras
- Nenhum teste real sobre seus próprios tickets documentado em lugar nenhum.
- SSO, Slack Enterprise Grid e HIPAA/BAA são todos exclusivos do Enterprise, então uma organização grande no Slack Grid não consegue comprar pelo preço de tabela.
- O teste não é autoatendido: os dois botões "Try for free" levam a um formulário de demonstração.
- O G2 é 4.9/5 em 13 avaliações, então leia a nota junto com o tamanho da amostra.
- As próprias contagens de integração da página inicial divergem, mais de 100 em uma seção e mais de 50 em outra.
Veredito: a escolha quando o solicitante vive no Slack, mas você ainda precisa de SLAs, relatórios e uma fila que sobreviva a uma auditoria. Um avaliador nomeia a lacuna que importa para um líder de suporte:
"It does not have a proper customer centric dashboard to track and create reports. Need to click on few tabs to make it user friendly."
9. Ada
Ideal para: autoatendimento multilíngue em escala corporativa, funcionando sobre um helpdesk que você mantém.
A Ada é, de longe, o produto mais maduro desta lista: uma camada de agente de IA sediada em Toronto, construída como um Reasoning Engine, Conversation Hub, Performance Center e Developer Toolkit, com 25 integrações listadas entre Zendesk, Salesforce, ServiceNow, Freshworks, Genesys, Gorgias, Help Scout, Kustomer e mais, e canais que vão de voz, e-mail, chat, WhatsApp, SMS e in-app.
Ela também tem um recurso de Simulations, e é por isso que vale a pena ser preciso sobre o que essa palavra significa. As simulações da Ada reproduzem casos de teste que você escreve manualmente: você redige o nome, a solicitação do cliente e o cenário. Os limites documentados são apenas chat na web, e-mail e voz, até 40 turnos, avaliações de aprovação/reprovação, apenas configuração de produção, e o próprio aviso da Ada de que ela "executa chamadas de API contra endpoints de produção configurados. As ações não são simuladas." Isso é um bom teste de regressão para uma mudança de configuração. Não é uma previsão do que o seu backlog teria feito.
Preços. Somente sob consulta, sem nenhum valor em dólares, símbolo de moeda, taxa ou nome de nível em lugar nenhum. A página de preços é um formulário de captura de leads cujo botão de envio diz "Speak to an expert," e seu campo central é o volume anual de contatos. Nosso post sobre preços da Ada CX tem o que pode ser estabelecido.
Prós
- A superfície de integração mais ampla aqui, e a única com uma história multilíngue profunda em escala real.
- SOC 2 Type II além de HIPAA, GDPR, PCI DSS, AIUC-1 e zero retenção de dados entre provedores de LLM.
- 4.6/5 em 173 avaliações no G2, a segunda maior amostra verificada desta lista.
Contras
- Nenhum preço publicado de qualquer tipo, e nenhum teste autoatendido.
- Conversas passadas alimentam o Coaching, que são instruções escritas por humanos, em vez de recuperação no momento da resposta, então o histórico de tickets não fundamenta as respostas.
- As simulações rodam cenários escritos manualmente contra endpoints de produção com ações não simuladas.
- Sua nota no Trustpilot é 1.8/5 em 20 avaliações. Essa divergência vale a pena ler com justiça: a amostra do G2 é de compradores e administradores que implantaram a Ada, enquanto quase todas as avaliações do Trustpilot são de consumidores que esbarraram em um bot com tecnologia da Ada no site de outra empresa.
Veredito: uma escolha corporativa segura se seu volume é em escala de consumidor e multilíngue, e se a base na central de ajuda é suficiente. Para uma fila técnica B2B, ela fica um degrau abaixo do necessário na escada de fundamentação. Alternativas à Ada cobre o campo.
10. Crescendo
Ideal para: equipes que querem comprar as pessoas e o software do mesmo fornecedor.
A Crescendo é a exceção aqui, e propositalmente. É uma plataforma totalmente gerenciada que combina agentes de IA com seus próprios agentes humanos empregados, em grande parte vindos de sua aquisição da PartnerHero, posicionada como uma substituta para toda a stack de CX: agentes, roteamento, tickets, QA, conhecimento e gestão de força de trabalho. Se o seu problema real é não ter pessoas suficientes, esse é o único item da lista que resolve isso.
Preços. Dois números publicados, e eles se somam.
| Item | Preço | Unidade |
|---|---|---|
| Managed AI | $1.25 | por solve, com descontos por volume disponíveis |
| Taxa de serviço mensal inicial | $2,900 | por mês |
| Nível de agente humano | Sob consulta | - |
Então o piso honesto é $2,900/mês mais $1.25 por solve, o que dá $34,800 por ano antes de um único ticket ser resolvido. Com 2,000 solves por mês, a taxa efetiva é de $2.70 por solve; com 10,000, ela cai para $1.54. E "solve" não é definido em lugar nenhum da página: a palavra aparece uma única vez, no rótulo da unidade. Nosso post sobre preços da Crescendo percorre a matemática do ponto de cruzamento.
Prós
- Compra capacidade, não apenas software, o que nenhuma outra ferramenta aqui faz.
- SOC 2 Type II, HIPAA, ISO 27001, GDPR e um Safe Action Framework.
- Mais de 20 conexões nativas alegadas, incluindo Zendesk, Freshdesk, Freshservice, Kustomer, Gorgias, Salesforce, HubSpot, Slack e Front.
Contras
- Um piso de $2,900/mês equivale a $29 por ticket na faixa mais baixa do próprio formulário de demonstração, que é de 0 a 100 tickets por mês.
- "Solve" não é definido, então o $1.25 não pode ser comparado à taxa por resolução de mais ninguém.
- Nenhum teste real. O teste é modo de rascunho, comparação de versões e consultas de amostra que você mesmo escreve.
- O backlog de tickets não é uma entrada de conhecimento documentada.
- O G2 mostra 0 avaliações. A única superfície de avaliação verificada é o Gartner Peer Insights, com 4.5 em duas avaliações.
Veredito: vale uma conversa se você já está terceirizando de qualquer forma e quer a IA e os agentes num único contrato. Todos os outros deveriam tratar o piso de $2,900 como o número decisivo. Decagon versus Crescendo é o comparativo direto mais útil.
O que eu realmente faria
Se você está no Zendesk e seus tickets mais difíceis precisam de contexto de engenharia, o Pluno é um produto real e você deveria deixá-lo rodar sua simulação. Só deixe três coisas explícitas antes de assinar: quanto a taxa base custa no seu volume, mesmo para tickets que você nunca encaminha para a IA, que uma resolução é contabilizada por 72 horas de silêncio, e o que acontece com a fatura quando a deflexão vai de 30% para 60%.
Depois rode a mesma avaliação que você rodaria em qualquer outra coisa, e avalie mais do que precisão. Um comprador rodou 67 testes separados conosco, achou as respostas "sólidas," e mesmo assim desistiu porque o widget de chat era lento e travava. Outro pagou por quatro meses e cancelou porque o teste nunca havia respondido nada útil desde o início. Ambas as situações são coisas que um número de taxa de resolução esconde completamente.
A única coisa que eu me recusaria a pular é um teste real com seus próprios tickets. Não porque os fornecedores estão escondendo algo, mas porque 93% de precisão de triagem e 12% de rascunhos enviados como estavam foram verdade para o mesmo sistema na mesma semana, e apenas um desses números sobrevive ao contato com uma fila real. Se um fornecedor só mostrar isso depois de uma ligação, isso também é uma informação. Como um cliente colocou sobre construir isso por conta própria em vez disso:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, via eesel
Esse é o instinto certo, e construir versus comprar é uma bifurcação real que vale a pena pensar antes mesmo de montar sua pré-seleção.
Experimente o eesel para sua fila técnica
Se você está avaliando o Pluno porque ele treina com tickets resolvidos e quer ver isso funcionar com os seus tickets resolvidos, é exatamente para isso que serve a simulação do eesel. Conecte Zendesk, Freshdesk, Front, Gorgias, HubSpot ou Jira Service Management, reproduza seu histórico de tickets, e leia a taxa de resolução detalhada por tema antes de qualquer cliente ver uma resposta. Depois entre no ar em modo de rascunho nos temas que ele já domina e conceda autonomia a partir daí.
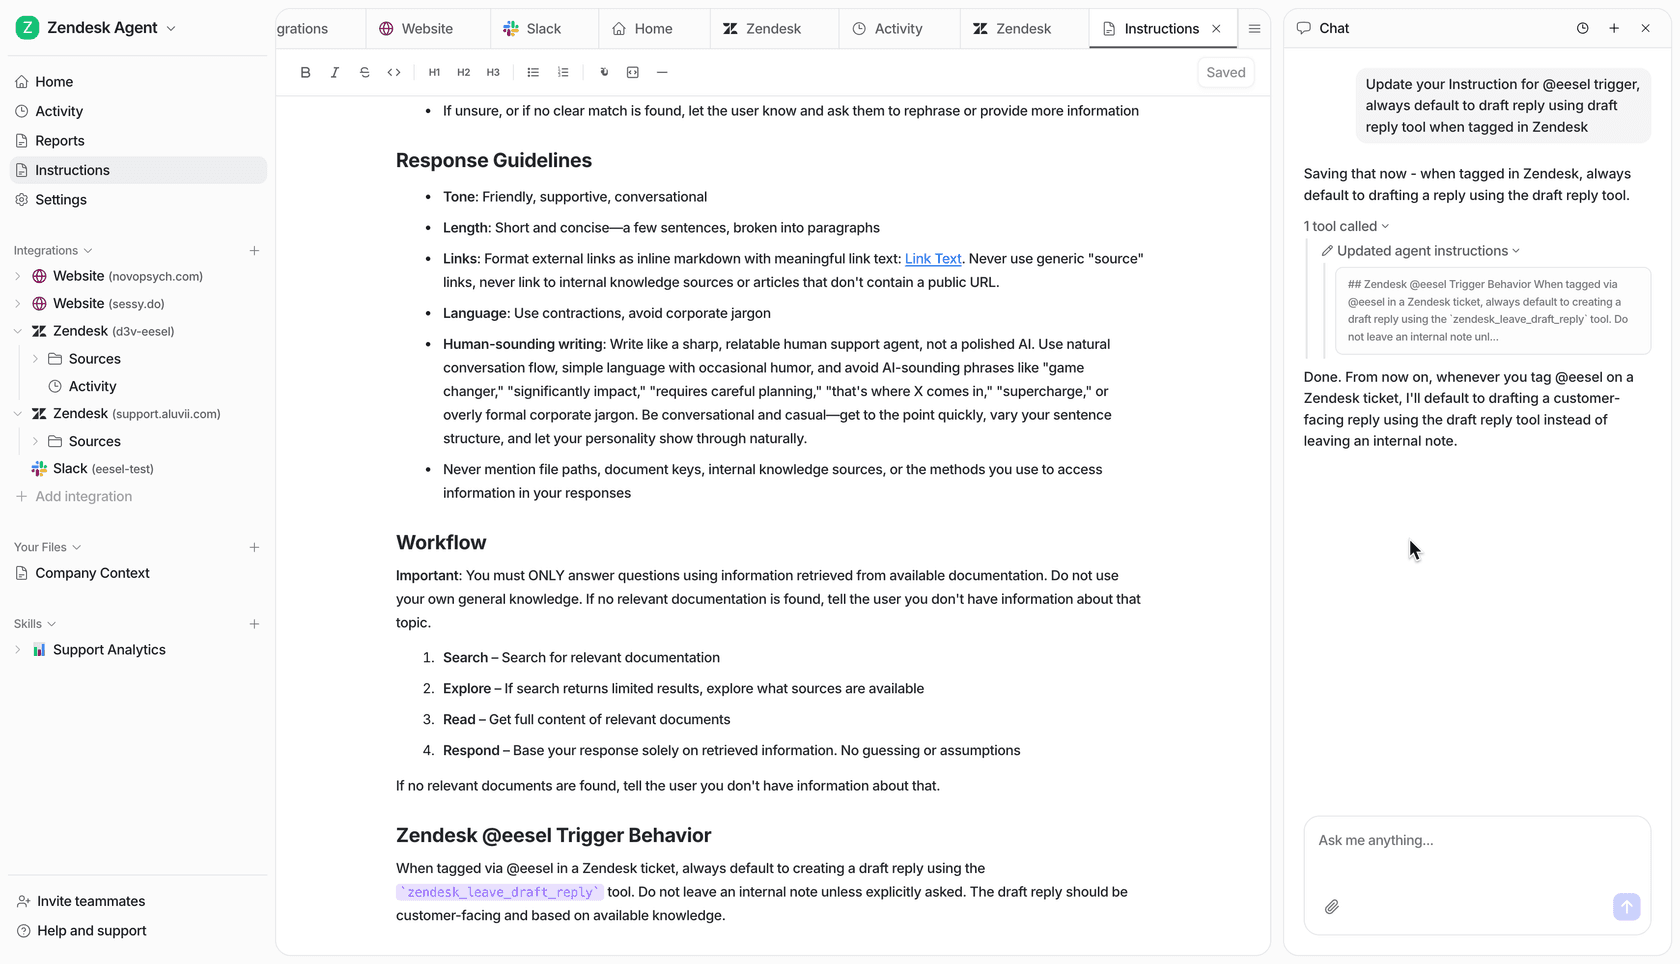
São $0.40 por ticket atendido, sem taxa de plataforma, sem cobrança por assento, e você nunca é cobrado por tickets que seus humanos assumem. Há $50 de uso esperando sem precisar de cartão, o que numa fila técnica é suficiente para descobrir se algo disso funciona para você. Experimente o eesel.
Perguntas Frequentes
Quanto custa o Pluno AI?
Qual é a melhor alternativa ao Pluno AI para uma equipe técnica de SaaS B2B?
O Pluno AI funciona com helpdesks além do Zendesk?
Existe uma alternativa gratuita ao Pluno AI?
O que acontece se a IA responder errado a um ticket técnico?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.