

O Gemini 3.5 Transcribe é o novo modelo dedicado de fala para texto do Google, anunciado por volta de 26 de agosto de 2026 e construído sobre a compreensão de áudio do Gemini. Ele vem em dois sabores: gemini-3.5-transcribe para arquivos gravados (até uma hora, com diarização e carimbos de tempo por palavra) e gemini-3.5-transcribe-live para streaming em tempo real via WebSockets (sessões de 10 minutos, sem diarização).
O preço é o destaque: cerca de US$ 0,005 por minuto para o modelo de arquivo e US$ 0,009 por minuto para o ao vivo, abaixo do nível padrão do próprio Cloud Speech-to-Text v2 do Google (US$ 0,016/min). O Google informa uma taxa de erro de palavras de 2,6% em inglês sem streaming (medida pela Artificial Analysis), e o modelo é posicionado como sucessor do Chirp 3.
O veredito honesto: os números de laboratório são excelentes, mas as primeiras reações práticas estão divididas. Os fãs o chamam de o melhor modelo de ditado que já usaram; os críticos dizem que a transcrição inteligente pode "simplificar" redações precisas, e que a diarização trava depois de três falantes. Um detalhe de status que vale conhecer: a lista de modelos do Google o marca como "Stable", enquanto o blog de lançamento fala em "public preview". Se você é de uma equipe de suporte avaliando isso para tickets de voz, lembre-se de que a transcrição é só a camada de entrada: você ainda precisa de algo que realmente resolva o ticket, e é aí que entra um colega de IA para helpdesk.
O que é o Gemini 3.5 Transcribe?
Por alguns anos, se você queria transformar áudio em texto com os modelos do Google, tinha duas opções: a Speech-to-Text API do Google Cloud (a linha Chirp) ou simplesmente entregar um arquivo de áudio a um modelo de chat Gemini genérico e pedir que o transcrevesse. O Gemini 3.5 Transcribe é a primeira vez que o Google lança um modelo da marca Gemini feito especificamente para essa tarefa, ao lado do restante da linha Gemini 3.
O Google o descreve como "a speech-to-text model based on Gemini's audio understanding capabilities" que oferece transcrição de baixa latência com detecção de idioma por enunciado, diarização de falantes, carimbos de tempo por palavra, transcrição inteligente e viés de vocabulário personalizado. Em palavras simples: ele ouve áudio e devolve texto limpo, formatado e com rótulos de falante, em mais de 85 idiomas, sem que você precise montar um pipeline.
Se você já usou o console de transcrição do Google Cloud, o fluxo será familiar: você aponta para um arquivo de áudio e escolhe suas opções:
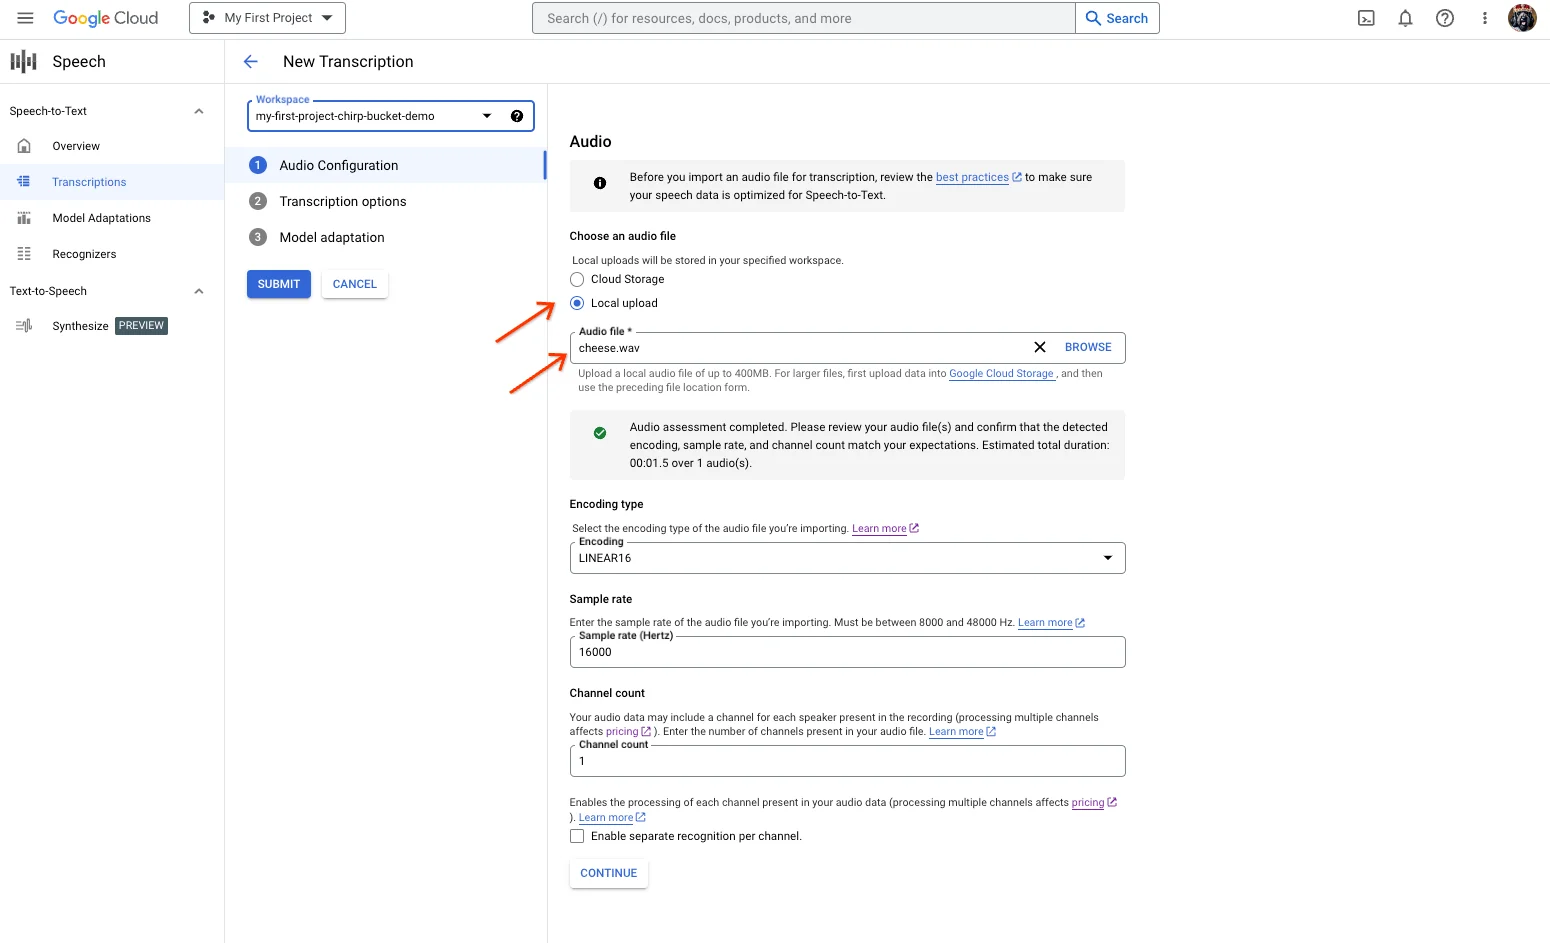
Um aviso logo de cara, porque os próprios documentos do Google não concordam entre si: a página de visão geral dos modelos marca o Gemini 3.5 Transcribe como "New Stable", enquanto a postagem do blog de lançamento diz que ele está "in public preview" para desenvolvedores e empresas. Ele já está em produtos de consumo, Rambler no Gboard para Android, o app Gemini no macOS e "em breve no Chrome", segundo a mesma postagem. Trate-o como quase pronto para produção, mas ainda não totalmente consolidado.
Os dois modelos: arquivo vs. ao vivo
O mais importante a entender antes de escrever uma linha de código é que "Gemini 3.5 Transcribe" são, na verdade, dois endpoints, e eles se comportam de forma muito diferente.
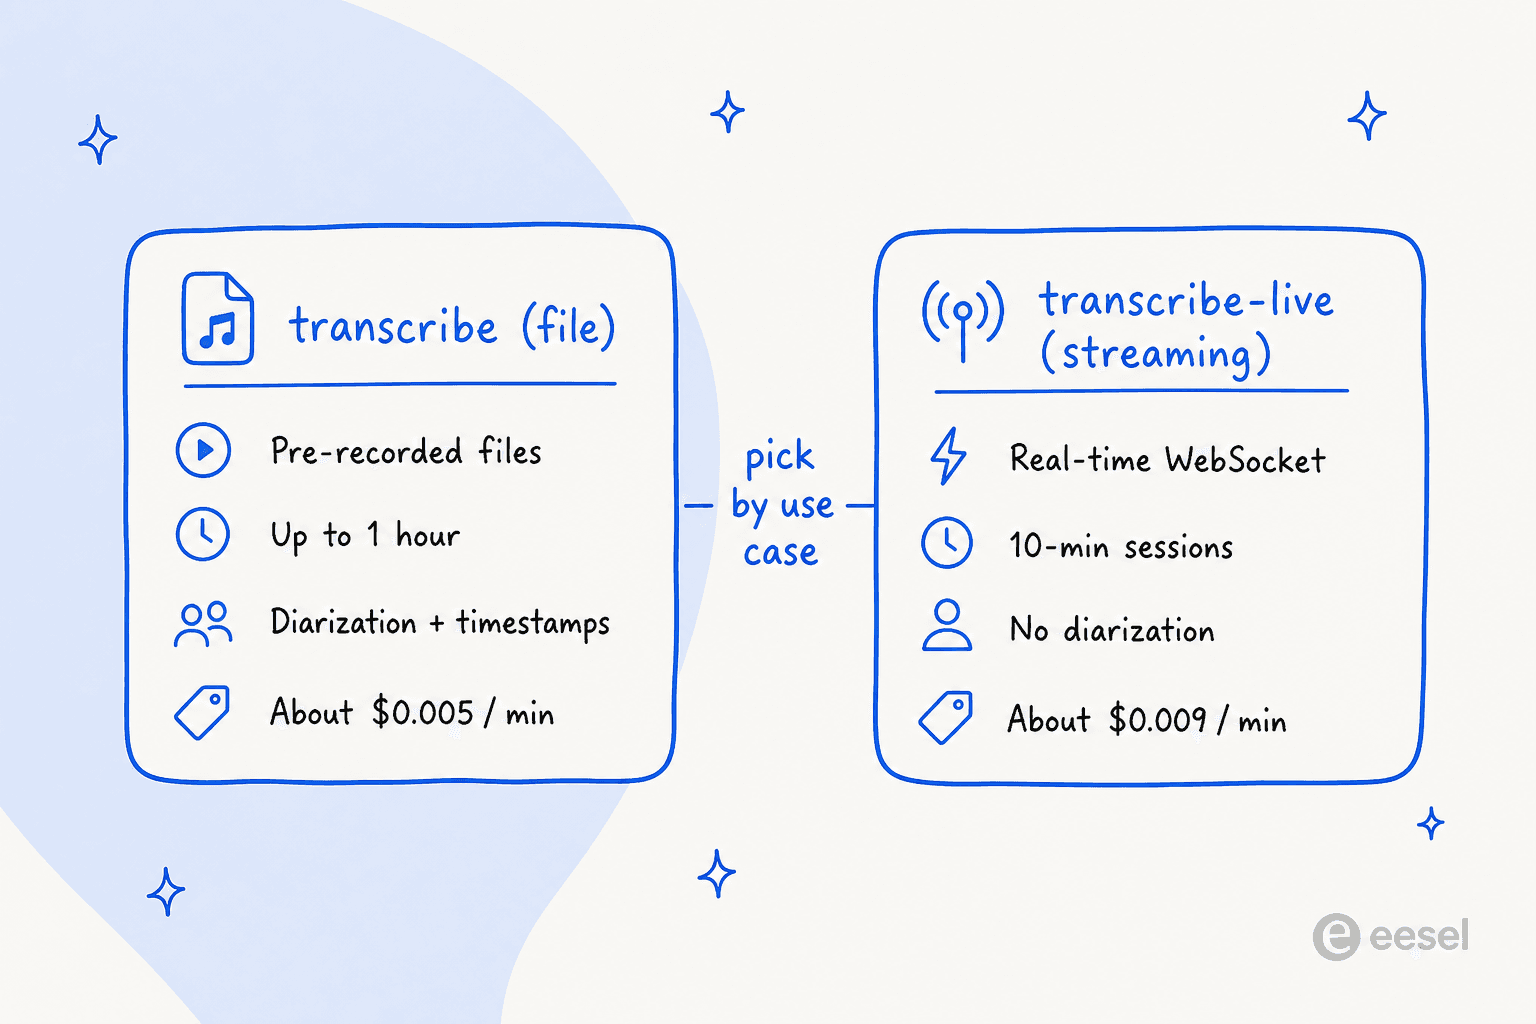
O modelo de arquivo gemini-3.5-transcribe é o que você usa quando já tem uma gravação, uma chamada de suporte, um podcast, uma reunião, e quer a transcrição completa com rótulos de falante. O modelo gemini-3.5-transcribe-live serve para transmitir áudio enquanto acontece, como legendas ao vivo, onde cada segundo extra de latência é sentido. Veja como fica o suporte a recursos:
| Recurso | gemini-3.5-transcribe (arquivo) | gemini-3.5-transcribe-live (streaming) |
|---|---|---|
| Ideal para | Áudio gravado | Legendas em tempo real |
| Detecção automática de idioma | Mais de 85 idiomas, incl. mistura de idiomas no meio da sessão | Mais de 85 idiomas |
| Carimbos de tempo por palavra | Suportado (reduz a precisão) | Não suportado |
| Diarização de falantes | Suportado (veja o alerta abaixo) | Não suportado |
| Viés de vocabulário personalizado | Até 1.000 termos (melhor ≤100) | Até 1.000 termos |
| Ditado inteligente e formatação | Suportado | Suportado |
| Duração máxima de áudio | Até 1 hora (30 min com diarização ou carimbos de tempo) | 10 minutos por sessão |
| Preço combinado | ~US$ 0,005 / min | ~US$ 0,009 / min |
O alerta sobre diarização é o que merece atenção. A tabela de recursos na página do modelo do Google diz que o modelo de arquivo suporta "up to 8 speakers (Attribution for 3+ speakers is experimental)", mas o blog do anúncio diz "up to three speakers". De qualquer forma, o teto confiável hoje é três, e eu planejaria em torno desse número, não de oito.
O que a transcrição inteligente realmente faz
O recurso em que o Google mais se apoia é a transcrição inteligente, e vale entendê-lo porque ele também é a fonte das reclamações mais barulhentas. Uma transcrição bruta da fala humana é bagunçada: as pessoas dizem "hum", começam uma frase, param e recomeçam, murmuram números. A transcrição inteligente limpa tudo isso automaticamente.
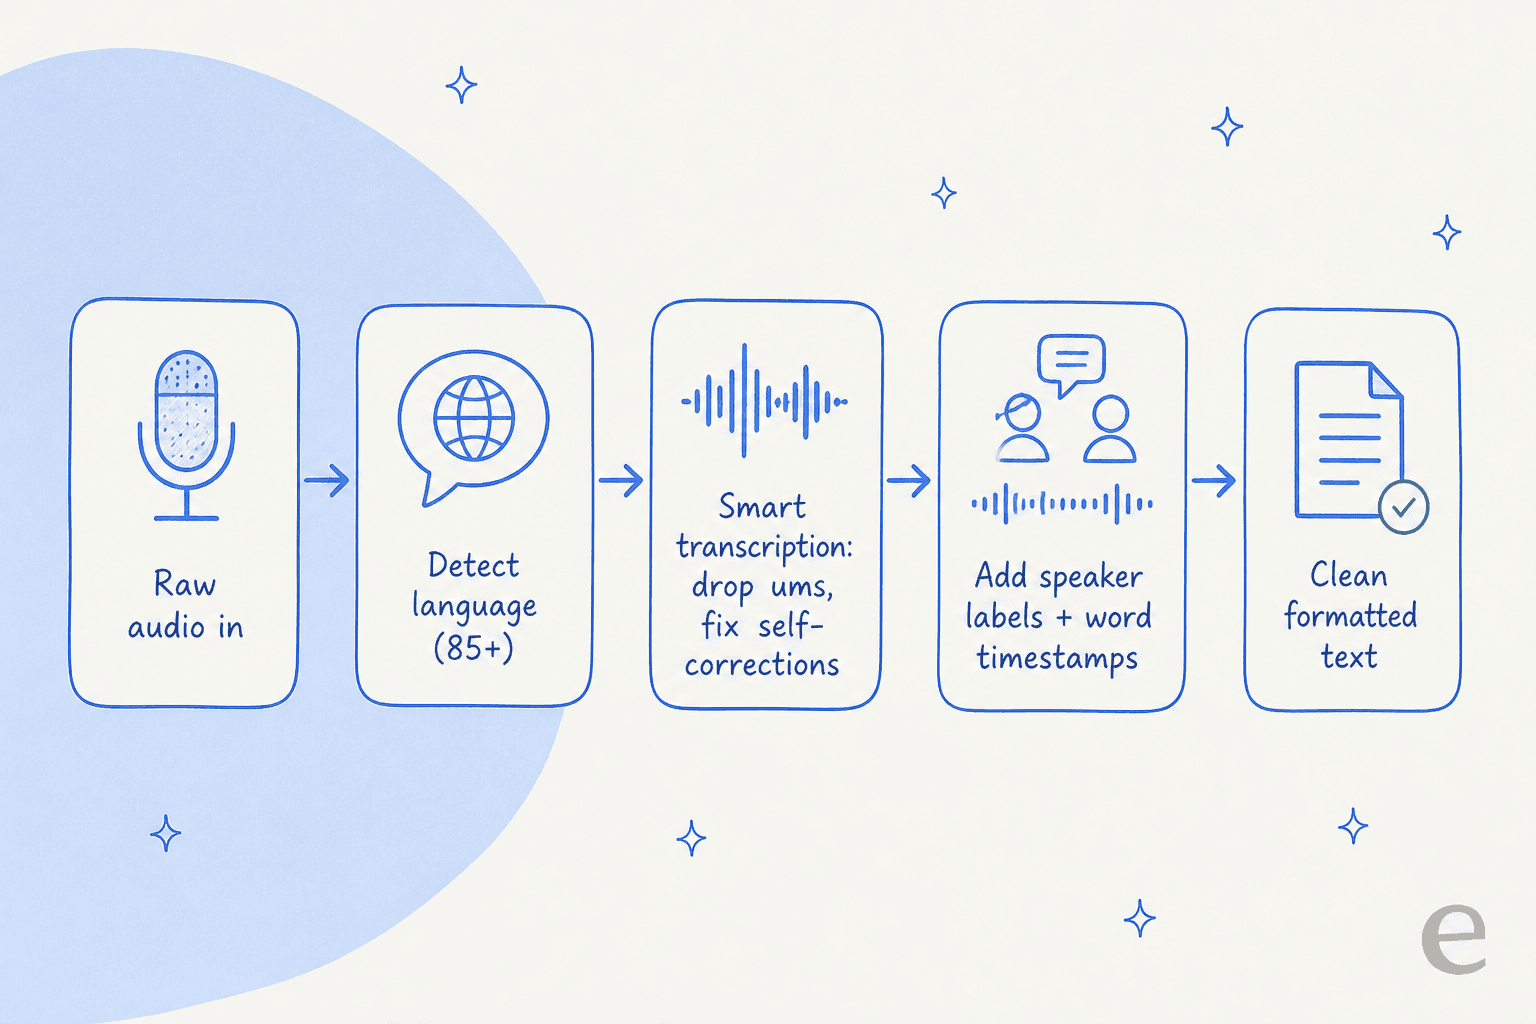
Segundo a postagem de lançamento, ele trata autocorreções (alguém diz "vamos marcar na terça, não, na quarta" e você recebe "quarta"), remove vícios de linguagem e aplica formatação consciente da intenção em coisas como sequências alfanuméricas. Para ditar um e-mail ou organizar anotações de reunião, isso é o tipo de coisa pela qual ferramentas de ditado dedicadas cobram, então tê-lo no modelo base é útil.
O outro lado é que "limpar" é uma questão de julgamento, e o modelo nem sempre concorda com você sobre o que é ruído. Um desenvolvedor que o testou em um Pixel 11 Pro foi direto:
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."

Então o modelo mental é: a transcrição inteligente é um recurso, não uma transcrição neutra. Para necessidades literais (jurídico, pesquisa, qualquer caso em que as palavras exatas importam), é uma troca real a ponderar.
Quão preciso ele é, de verdade?
No papel, os números são excelentes. O Google informa as seguintes taxas de erro de palavras, todas atribuídas à Artificial Analysis:
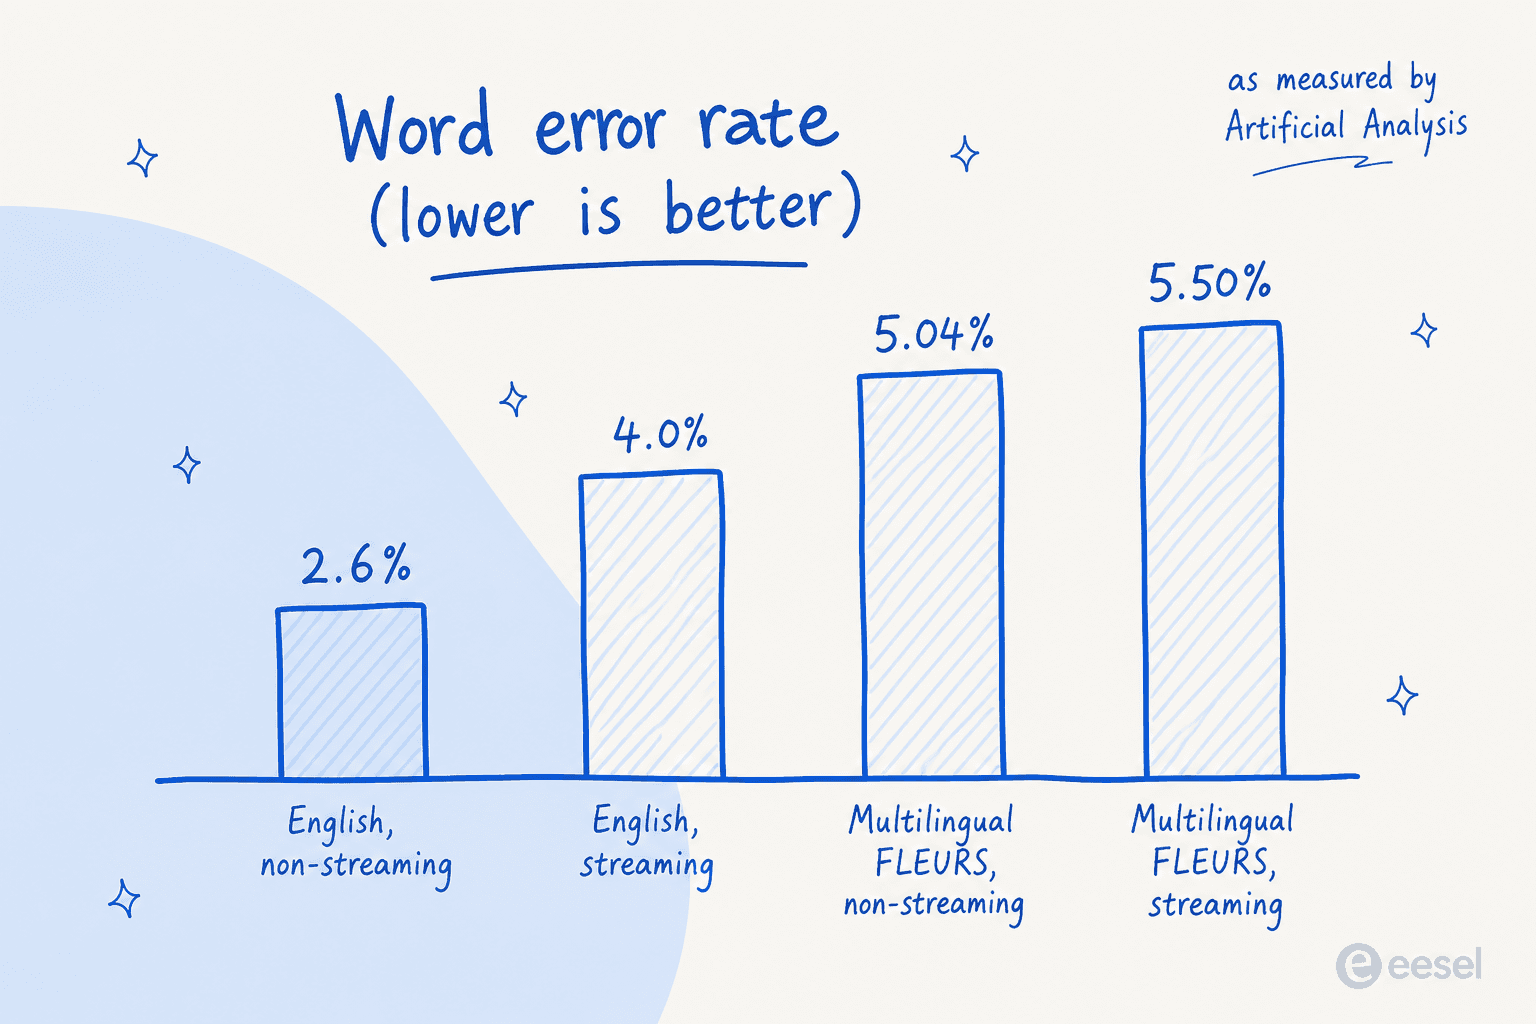
Uma taxa de erro de palavras de 2,6% em inglês sem streaming é muito boa, aproximadamente uma palavra errada em quarenta. O Google também afirma que o tempo até a transcrição final melhora 70% em relação ao Chirp 3, embora esse enquadramento seja do próprio Google, então eu o trataria como um número do fabricante, não como um benchmark independente.
O sinal mais interessante é o que os profissionais dizem depois de usá-lo. E aqui o quadro é dividido. Do lado positivo:
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."
Mas o tópico de lançamento no Hacker News está cheio de gente fazendo suas próprias comparações e chegando a conclusões diferentes. Alguns ainda preferem o Whisper, e outros encontraram lacunas reais:
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
A conclusão que tiro: a WER em um benchmark limpo e a WER no seu áudio real (chamadas com ruído, vários sotaques, falas sobrepostas) são coisas diferentes. Os números de laboratório são um bom começo, não uma garantia. Se você avalia qualquer modelo de transcrição para trabalho real, teste-o nas suas próprias gravações antes de se comprometer.
Preços do Gemini 3.5 Transcribe
O Google não colocou os preços no anúncio do modelo, o que irritou os desenvolvedores a ponto de um deles postar os números no Hacker News por conta própria. Aqui está o quadro completo da página de preços, para a Gemini Developer API:
| Modelo | Entrada de áudio | Saída de texto | Tarifa combinada |
|---|---|---|---|
gemini-3.5-transcribe (arquivo) | US$ 2,00 / 1 mi de tokens (~US$ 0,003/min) | US$ 12,00 / 1 mi de tokens (~US$ 0,002/min) | ~US$ 0,005 / min |
gemini-3.5-transcribe-live (streaming) | US$ 3,50 / 1 mi de tokens (~US$ 0,005/min) | US$ 21,00 / 1 mi de tokens (~US$ 0,004/min) | ~US$ 0,009 / min |
Para comparação, o reconhecimento padrão do Cloud Speech-to-Text v2 do próprio Google começa em US$ 0,016/min e cai com o volume, enquanto o nível de lote dinâmico custa US$ 0,003/min. Assim, o novo modelo de arquivo do Gemini fica logo abaixo do reconhecimento padrão em tempo real, mas acima da opção de lote mais barata. Compare coisas equivalentes (tempo real com tempo real, lote com lote) ao fazer as contas.
Falando em contas, aqui vai uma calculadora rápida. Informe quantas horas de áudio você processa por mês e veja aproximadamente quanto cada opção custa:
Um exemplo prático: uma equipe pequena que transcreve 200 horas de chamadas de suporte por mês pagaria cerca de US$ 60/mês no modelo de arquivo, contra cerca de US$ 192 no Cloud Speech-to-Text padrão. Nessa escala a diferença é real, mas não enorme. A pergunta de custo maior costuma ser o que você faz com as transcrições depois, não a transcrição em si.
Como se compara ao Whisper, Deepgram e Scribe
Quero ser cuidadoso aqui, porque uma comparação justa precisa dos números de cada fornecedor, e a posição honesta é que os confrontos diretos reais estão sendo feitos pelos usuários, não por mim. Então, em vez de uma tabela de especificações que não consigo embasar totalmente, aqui está o que as pessoas que realmente fazem testes A/B desses modelos estão encontrando.
Quanto ao custo, a reação se divide quase ao meio. Um desenvolvedor que toca o whispermemos.com fez as contas e gostou do que viu:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
Outros não se convenceram de que a precisão seja próxima o bastante:
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
A reclamação mais consistente, e a que eu mais pesaria se você faz transcrição de reuniões, é o tratamento de vários falantes:
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
E o Whisper ainda tem seguidores fiéis, em parte porque pode ser hospedado por conta própria de graça e em parte porque muitas equipes já construíram pipelines em torno dele. Um padrão comum é o híbrido: usar o Whisper para carimbos de tempo precisos por palavra e depois um modelo Gemini para o texto. Em resumo, o Gemini 3.5 Transcribe é uma opção gerenciada forte e bem precificada, não um vencedor automático sobre as ferramentas de ASR especializadas. Qual vence depende muito do seu áudio e de você precisar de diarização confiável.
Onde a transcrição se encaixa para uma equipe de suporte
Aqui vai algo que vale dizer com clareza, porque é fácil passar batido: o Gemini 3.5 Transcribe é infraestrutura. Ele transforma áudio em texto, e esse é um problema difícil que ele resolve bem. Mas a transcrição de uma chamada ou nota de voz de um cliente não é uma resposta, é só o começo. Algo ainda precisa ler esse texto, entender o que o cliente precisa, buscar as informações certas e resolver o ticket.
Essa camada de resolução é aquilo em que eu trabalho. Passei os últimos anos ajudando a construir IA que atua em filas de suporte ao vivo, e o padrão é sempre o mesmo: acertar as palavras é o básico; agir corretamente sobre elas é o difícil. Um modelo de transcrição entrega as palavras. Ele não conhece sua política de reembolso, seu sistema de pedidos nem os últimos três tickets que aquele cliente abriu.
Essa é a diferença entre um modelo e um colega de equipe. O Gemini 3.5 Transcribe é um modelo, brilhante em uma tarefa estreita. A eesel é uma plataforma de colegas de IA: você contrata colegas de IA prontos para trabalhar em funções específicas, e o elenco atual inclui um colega de IA para helpdesk e um redator de blog com IA. O colega de helpdesk se conecta ao helpdesk que você já usa, Zendesk, Freshdesk, Gorgias, e entra na fila existente, treinado na sua central de ajuda e em tickets anteriores.
Experimente a eesel para tickets de voz e chat
Se você está olhando para transcrição porque sua equipe está afogada em tickets de voz ou chat, a transcrição é só metade do trabalho. O colega de IA para helpdesk da eesel continua de onde um modelo como o Gemini 3.5 Transcribe para: lê a mensagem do cliente, redige ou envia a resposta e realmente fecha o ciclo, por meio de mais de 1.000 integrações.
A parte que eu apontaria primeiro é o modo de simulação. Antes que qualquer IA toque em um cliente real, você a executa contra milhares dos seus próprios tickets históricos e vê exatamente como ela teria respondido, sem apertar um botão e torcer. O preço é uma mensalidade fixa, a partir de US$ 299/mês por 500 créditos (1 crédito por ticket ou chat) sem taxas por usuário, e há um plano gratuito com 100 créditos, sem cartão. É a diferença entre uma transcrição inteligente de um problema e a resolução real dele.