

O Gemini 3.5 Transcribe é o primeiro modelo de fala para texto do Google com a marca Gemini, e depois de me aprofundar na documentação, nos benchmarks e no que as pessoas que o usam em produção estão dizendo, meu veredito curto é: é um modelo gerenciado forte e bem precificado, com um problema real.
O lado bom: cerca de US$ 0,005 por minuto para o modelo de arquivos (aproximadamente um terço do nível padrão do Cloud Speech-to-Text do próprio Google), taxa de erro de palavras de 2,6% em áudio limpo em inglês, diarização integrada, carimbos de tempo por palavra e detecção automática de idioma em mais de 85 idiomas.
O problema: o Smart transcription, o recurso que o Google mais vende, reescreve sua fala para limpá-la, e nem sempre concorda com você sobre o que é ruído. Testadores o viram descartar trechos precisos. A diarização também fica instável com mais de três falantes, o que importa para atas de reunião.
Para quem é: ditado, gravações de um único falante e transcrição sensível a custo em escala. Quem deve olhar outras opções: quem precisa de saída literal (jurídico, pesquisa) e reuniões com vários falantes, onde um especialista como Deepgram ou ElevenLabs Scribe ainda lidera. E lembre-se: se você é uma equipe de suporte, a transcrição é apenas a camada de entrada, você ainda precisa de algo para realmente resolver o ticket, e é aí que entra um colega de IA para helpdesk.
O que é o Gemini 3.5 Transcribe, rapidamente
Até agora, transcrever áudio com o Google significava uma de duas coisas: a Speech-to-Text API do Google Cloud (a linha Chirp), ou entregar um arquivo de áudio a um modelo de chat Gemini genérico e pedir com educação. O Gemini 3.5 Transcribe, anunciado por volta de 26 de agosto de 2026, é o primeiro modelo que o Google construiu especificamente para essa tarefa, e é posicionado como sucessor do Chirp 3.
A página do modelo do Google o descreve como "a speech-to-text model based on Gemini's audio understanding capabilities" com detecção de idioma, diarização de falantes, carimbos de tempo em nível de palavra, Smart transcription e viés de vocabulário personalizado. São na verdade dois endpoints: gemini-3.5-transcribe para arquivos pré-gravados e gemini-3.5-transcribe-live para streaming em tempo real. Analisei o detalhamento completo de preços e especificações separadamente; esta análise é sobre se ele realmente é bom.
Aqui está a própria página do modelo, por onde a maioria dos desenvolvedores vai começar:
Um aviso antes de construir sobre ele: a própria documentação do Google não concorda sobre seu status. A página de visão geral dos modelos o marca como "New Stable", enquanto o blog de lançamento o chama de "in public preview". Ele já está ativo em produtos de consumo (Rambler no Gboard, o app Gemini no macOS), então trate-o como quase pronto para produção, mas não totalmente definido.
Como o avaliei
Não tinha meses de logs de produção para consultar, então serei direto sobre a base desta análise: li a model card e a documentação de preços por inteiro, conferi as afirmações de benchmark do Google quanto à forma como são apresentadas e me apoiei bastante nos desenvolvedores que estavam fazendo testes A/B contra Whisper, Deepgram e ElevenLabs Scribe nos dias após o lançamento. Transcrição é uma área em que o número limpo de benchmark do fornecedor e o seu resultado real podem estar a mundos de distância, então o sinal da comunidade importa tanto quanto a folha de especificações.
A versão curta do que apareceu: os números são reais e bons, o preço é muito competitivo, e as reclamações mais altas se concentram em duas coisas específicas. Vamos por ordem.
Precisão: os números de laboratório são ótimos, o áudio real é o teste
No papel, este modelo é muito bom. O Google informa as taxas de erro de palavras abaixo, todas atribuídas à Artificial Analysis:
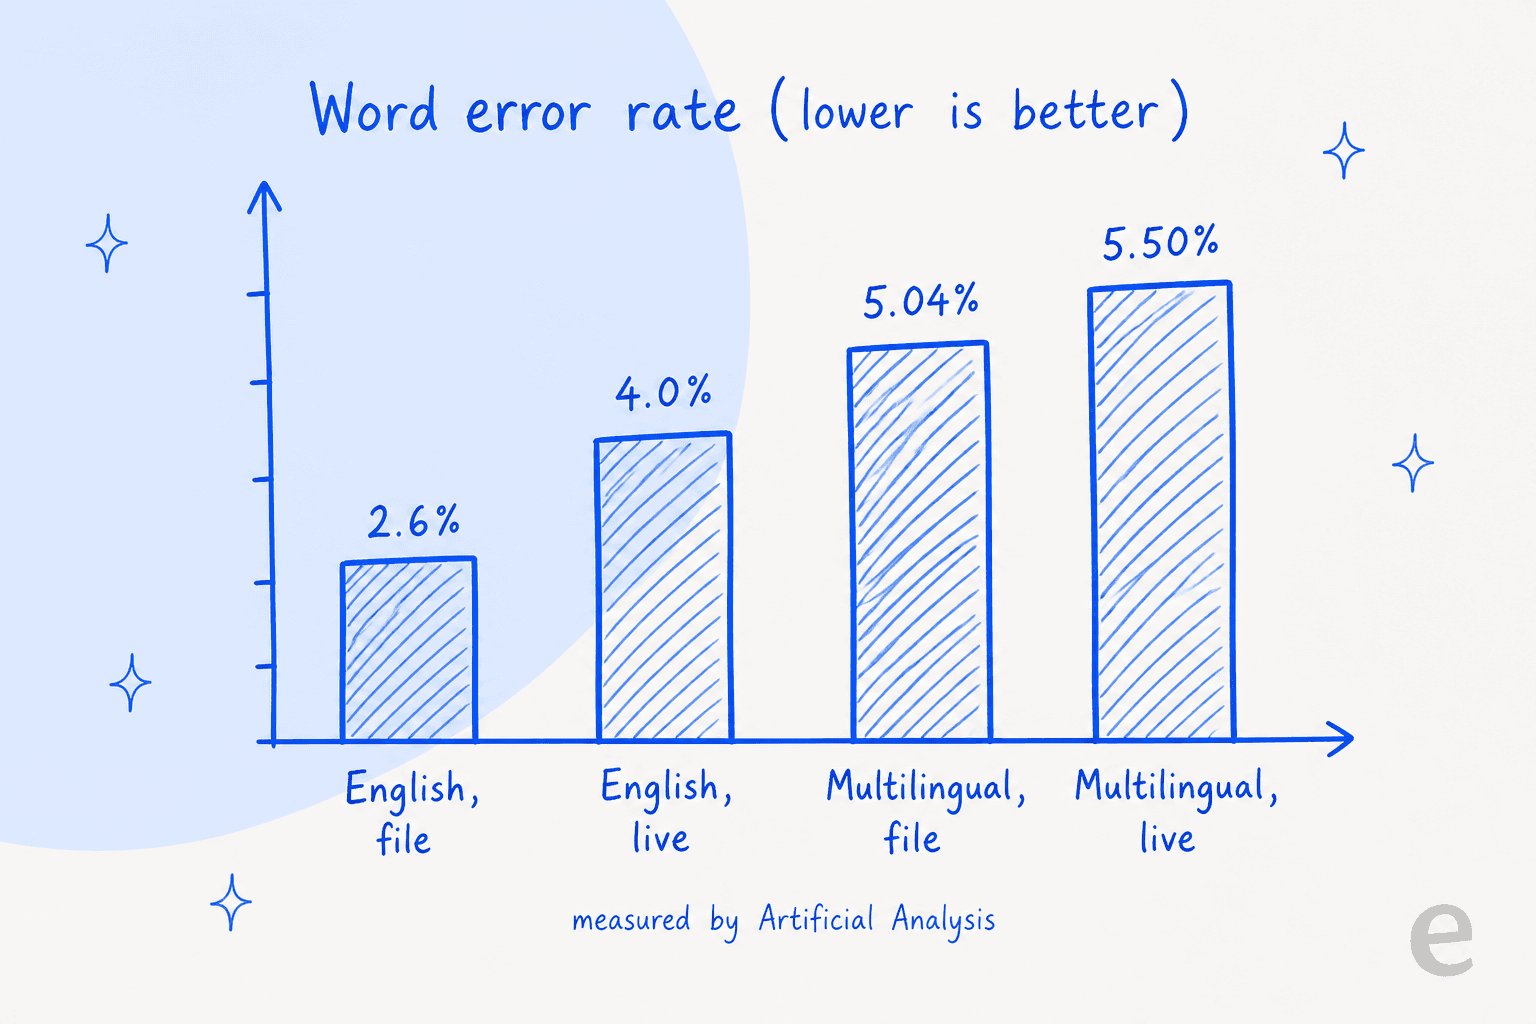
Uma taxa de erro de 2,6% em inglês sem streaming é cerca de uma palavra errada em quarenta, o que é excelente. O Google também afirma que o tempo até a transcrição final melhora 70% em relação ao Chirp 3, mas esse enquadramento é do próprio Google, então eu o classificaria como número do fornecedor, não como benchmark independente.
O sinal mais útil é o que as pessoas encontraram ao usá-lo com o próprio áudio. E aqui há divisão. Do lado muito positivo, foi quase tão elogioso quanto um feedback pode ser:
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."

Mas o tópico de lançamento está cheio de gente fazendo comparações e chegando a conclusões mais frias. Um que faz exatamente isso profissionalmente voltou a uma configuração híbrida:
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
Minha leitura: a taxa de erro em um benchmark limpo e a taxa de erro no seu áudio real (chamadas ruidosas, vários sotaques, falas cruzadas) são bichos diferentes. Os números de laboratório são um bom ponto de partida, não uma promessa. Se você o avalia para trabalho real, teste com suas próprias gravações antes de comprometer um pipeline.
O problema do Smart transcription
Esta é a parte da análise que eu sublinharia. O Smart transcription é o recurso em que o Google mais se apoia, e também a reclamação mais comum. Uma transcrição bruta da fala humana é bagunçada: as pessoas dizem "hum", recomeçam frases, murmuram números. O Smart transcription limpa tudo isso automaticamente.
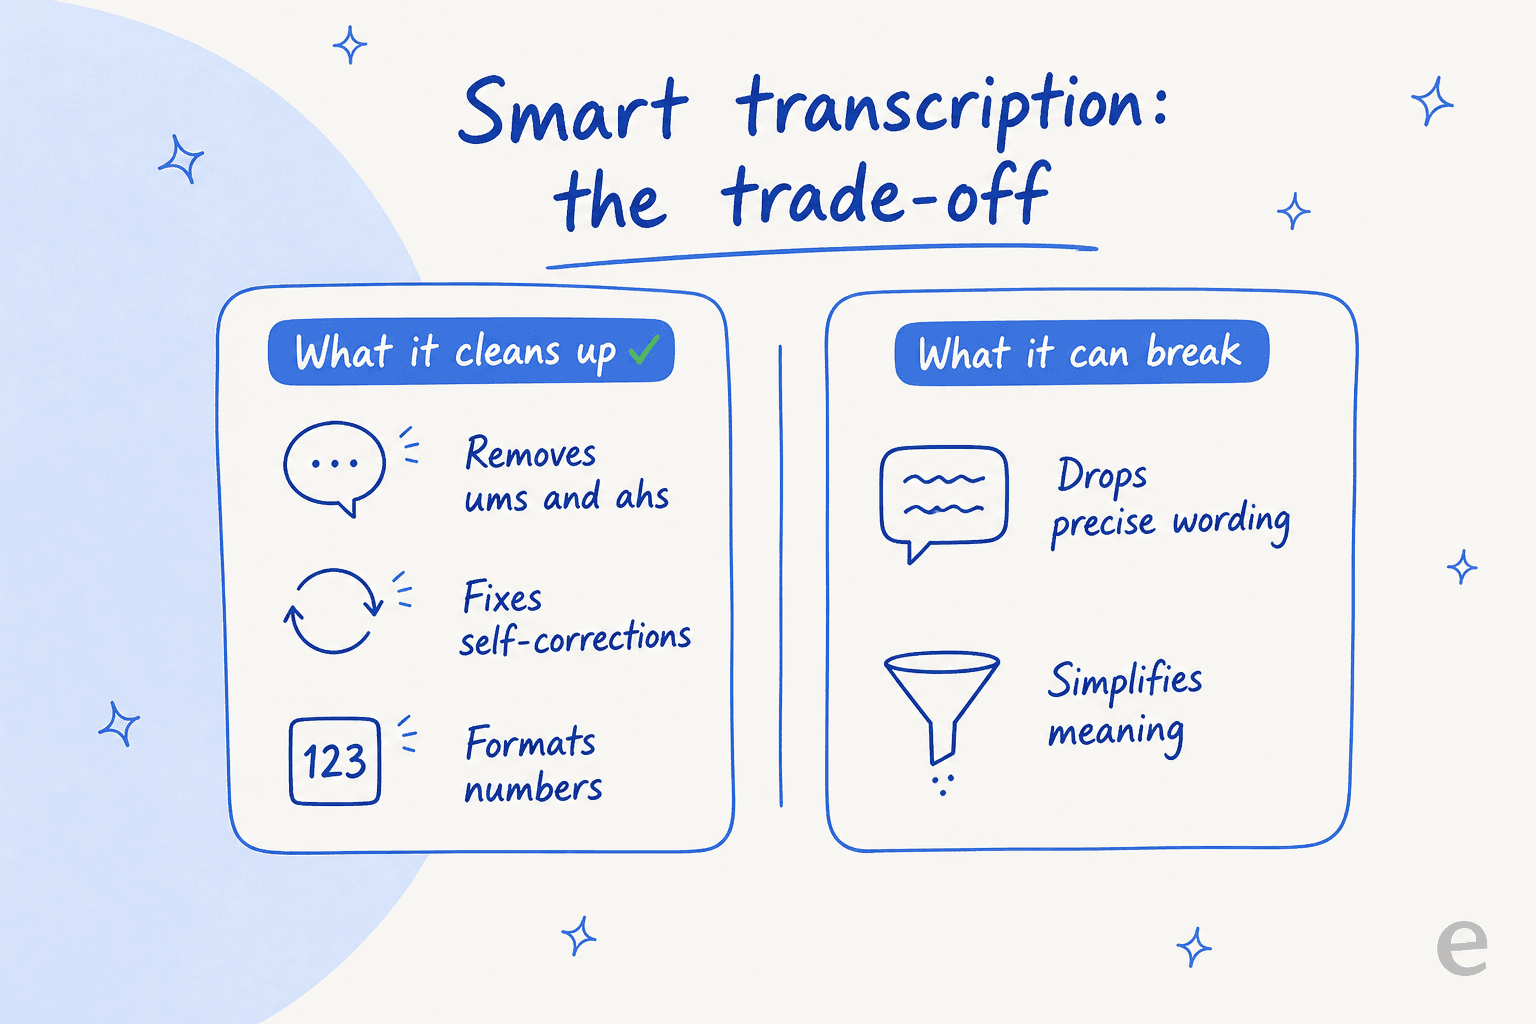
Segundo o post de lançamento, ele lida com autocorreções ("let's meet Tuesday, no, Wednesday" vira "Wednesday"), remove palavras de preenchimento e formata cadeias alfanuméricas de forma inteligente. Para ditar um e-mail ou organizar notas de reunião, é o tipo de coisa que ferramentas de ditado independentes cobram a mais, então tê-lo no modelo base é um ponto positivo genuíno.
O problema é que "limpar" é um julgamento, e o modelo nem sempre compartilha o seu. Um desenvolvedor que o testou em um Pixel 11 Pro foi direto:
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."
Então o modelo mental para uma decisão de compra é este: o Smart transcription é um recurso, não uma transcrição neutra. Para qualquer coisa em que as palavras exatas importem (jurídico, pesquisa, conformidade, medicina), é um compromisso real a ponderar, não uma nota de rodapé. É a única coisa neste modelo que eu mais gostaria de testar com meu próprio áudio antes de confiar nele.
A diarização trava depois de três falantes
A segunda reclamação recorrente é o tratamento de vários falantes, e se você faz transcrição de reuniões, é a que merece atenção. A documentação do Google lista dois limites diferentes: a página do modelo diz que o modelo de arquivos suporta "up to 8 speakers (Attribution for 3+ speakers is experimental)", enquanto o blog de lançamento diz "up to three". O teto confiável hoje é três, e eu planejaria com esse número. O modelo de streaming ao vivo não tem diarização, pois prioriza baixa latência.
Essa lacuna apareceu com força nos testes:
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
Se seu caso de uso é uma chamada de suporte entre duas pessoas ou uma nota de voz de um único falante, isso não vai te afetar. Se é uma daily de seis pessoas, é uma limitação real, e é o tipo de coisa que uma folha de especificações deixa passar até você estar três semanas dentro do desenvolvimento.
Preços: aqui ele ganha
O Google não incluiu preços no anúncio do modelo, o que irritou os desenvolvedores o bastante para que um deles mesmo os publicasse no Hacker News. Este é o quadro real da página de preços:
| Modelo | Entrada de áudio | Saída de texto | Taxa combinada |
|---|---|---|---|
gemini-3.5-transcribe (arquivo) | US$ 2,00 / 1 mi de tokens (~US$ 0,003/min) | US$ 12,00 / 1 mi de tokens (~US$ 0,002/min) | ~US$ 0,005 / min |
gemini-3.5-transcribe-live (streaming) | US$ 3,50 / 1 mi de tokens (~US$ 0,005/min) | US$ 21,00 / 1 mi de tokens (~US$ 0,004/min) | ~US$ 0,009 / min |
Para comparação, o reconhecimento padrão do Cloud Speech-to-Text v2 do próprio Google começa em US$ 0,016/min, enquanto o nível de lote dinâmico custa US$ 0,003/min. Assim, o novo modelo de arquivos fica bem abaixo do reconhecimento padrão em tempo real e logo acima da opção de lote mais barata. Ao fazer as contas, compare coisas equivalentes: tempo real com tempo real, lote com lote.
Para tornar isso concreto, insira seu próprio volume:
Um exemplo prático: uma equipe pequena que transcreve 200 horas de chamadas de suporte por mês paga cerca de US$ 60 com o modelo de arquivos contra aproximadamente US$ 192 no Cloud Speech-to-Text padrão. Economia real, mas sem mudar a vida nessa escala, e honestamente a maior questão de custo costuma ser o que você faz com as transcrições depois, não a transcrição em si. Mais sobre isso abaixo.
Como ele se compara ao Whisper, Deepgram e Scribe
Quero ser cuidadoso aqui, porque um comparativo justo precisa dos números de cada fornecedor, e a posição honesta é que os testes A/B reais estão sendo feitos pelos usuários, não por mim. Então, em vez de uma tabela de especificações que não consigo embasar totalmente, aqui está o que as pessoas que de fato comparam esses modelos encontraram.
Em custo, a reação se dividiu quase ao meio. Um desenvolvedor que mantém o whispermemos.com fez as contas e saiu impressionado:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
Outros não se convenceram de que a precisão chega perto o bastante:
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
E o Whisper ainda tem seguidores fiéis, em parte por ser gratuito para hospedar por conta própria e em parte porque as equipes já construíram pipelines em torno dele. O padrão mais comum que vi foi o híbrido: Whisper para carimbos de tempo de palavras precisos, depois um modelo Gemini para o texto em si. Em resumo, o Gemini 3.5 Transcribe é uma opção gerenciada forte e bem precificada, não um vencedor automático sobre as ferramentas ASR especializadas. Qual vence depende do seu áudio e de você precisar ou não de diarização confiável.
O veredito: para quem ele serve
Juntando tudo, é aqui que chego depois da pesquisa:
| Gemini 3.5 Transcribe | |
|---|---|
| Pontos fortes | Preço baixo (~US$ 0,005/min arquivo), 2,6% de erro em inglês, diarização + carimbos de tempo integrados, mais de 85 idiomas, API gerenciada |
| Pontos fracos | O Smart transcription pode reescrever trechos precisos, diarização pouco confiável com mais de 3 falantes, sem nível batch/Flex, a documentação se contradiz sobre status e limite de falantes |
| Melhor para | Ditado, notas de voz de um único falante, transcrição sensível a custo em escala |
| Procure outra opção se | Você precisa de saída literal, reuniões com 4+ falantes ou o menor custo possível em lote |
A decisão depende, na verdade, do seu áudio:
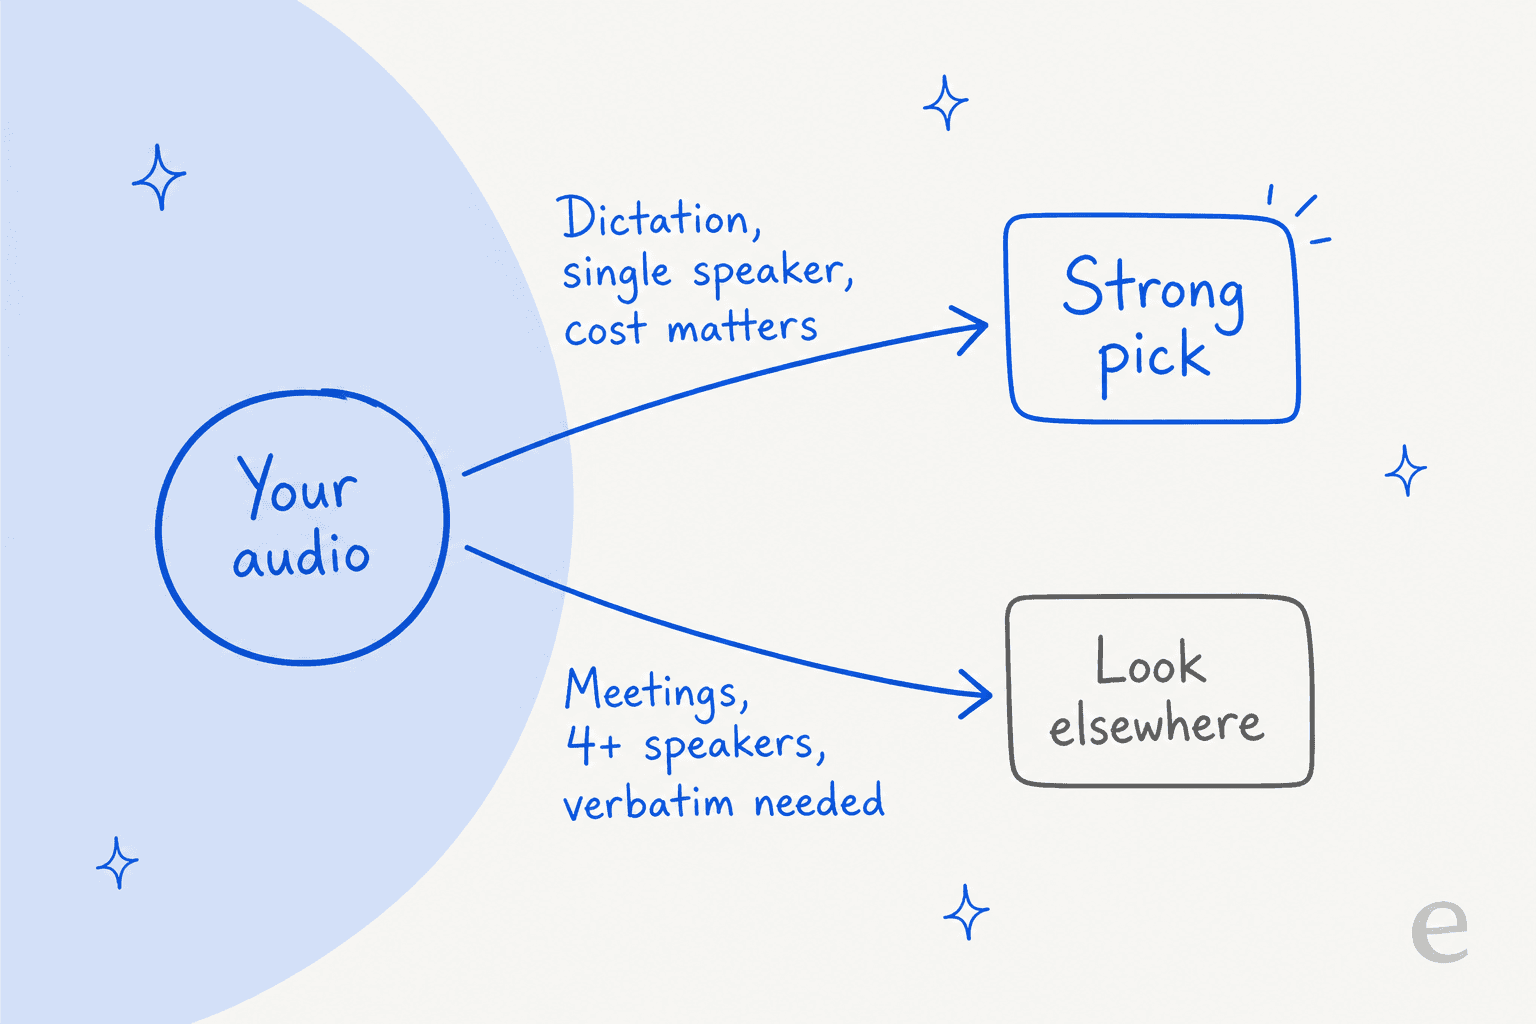
Se eu estivesse lançando um recurso de ditado ou transcrevendo uma fila de notas de voz de um único falante, eu o escolheria com prazer: o preço e a precisão em inglês são difíceis de superar para um modelo gerenciado. Se eu estivesse criando atas para reuniões de seis pessoas, ou qualquer coisa em que as palavras exatas tenham peso jurídico, testaria Deepgram ou ElevenLabs Scribe ao lado dele antes de decidir, e não presumiria que os números de benchmark valem para o meu áudio.
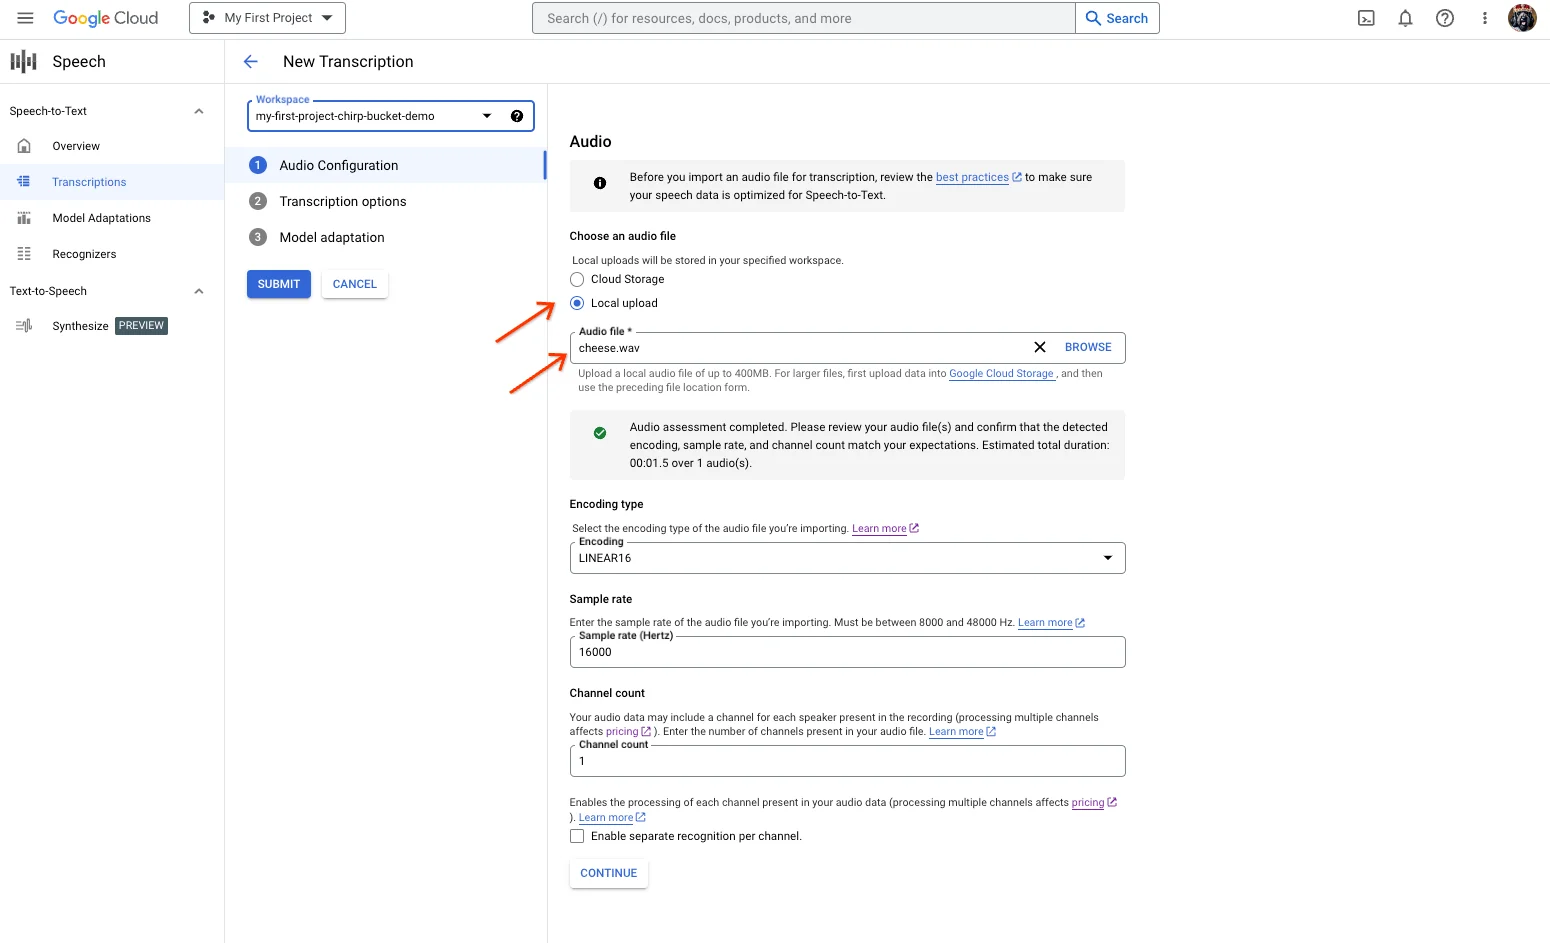
Como referência, se você já usou o console de transcrição do Google Cloud, o fluxo de upload de arquivos vai parecer familiar: você aponta para o áudio e escolhe suas opções:
Onde a transcrição se encaixa para uma equipe de suporte
Aqui está algo que vale dizer com clareza, porque é a parte que uma análise pode deixar passar: o Gemini 3.5 Transcribe é infraestrutura. Ele transforma áudio em texto e faz esse trabalho difícil bem. Mas a transcrição de uma ligação ou nota de voz de um cliente não é uma resposta, é só o começo. Algo ainda precisa ler esse texto, entender o que o cliente precisa, buscar as informações certas e de fato resolver o ticket.
Essa camada de resolução é aquilo em que trabalho. Passei os últimos anos perto de IA que atua em filas de suporte reais, e o padrão nunca muda: acertar as palavras é o mínimo; agir corretamente sobre elas é a parte difícil. Um modelo de transcrição entrega as palavras. Ele não conhece sua política de reembolso, seu sistema de pedidos nem os três últimos tickets que aquele cliente abriu.
Essa é a diferença entre um modelo e um colega de equipe. O Gemini 3.5 Transcribe é um modelo, brilhante em uma tarefa restrita. A eesel é uma plataforma de colegas de IA: você contrata colegas de IA prontos para trabalhar em tarefas específicas, e o time atual inclui um colega de IA para helpdesk e um redator de blog com IA. O colega de helpdesk se conecta ao helpdesk que você já usa, Zendesk, Freshdesk, Gorgias, e entra na fila existente, treinado com sua central de ajuda e tickets anteriores.
Experimente a eesel para tickets de voz e chat
Se você chegou a uma análise de transcrição porque sua equipe está se afogando em tickets de voz ou chat, lembre-se de que a transcrição é só metade do trabalho. O colega de IA para helpdesk da eesel continua de onde um modelo como o Gemini 3.5 Transcribe para: lê a mensagem do cliente, redige ou envia a resposta e fecha o ciclo, em mais de 1.000 integrações.
A parte que eu apontaria primeiro é o modo de simulação. Antes que qualquer IA toque em um cliente real, você a executa sobre milhares dos seus próprios tickets históricos e vê exatamente como ela teria respondido, então você não aperta um botão e torce: o mesmo conselho de "teste primeiro com seus dados" que eu daria para qualquer modelo de transcrição, embutido no produto. O preço é uma mensalidade fixa, a partir de US$ 299/mês por 500 créditos (1 crédito por ticket ou chat) sem cobrança por usuário, e há um plano gratuito com 100 créditos, sem cartão. É a diferença entre uma transcrição inteligente de um problema e sua resolução de fato.