

Resumo
O Gemini 3.5 Transcribe é o primeiro modelo de fala para texto do Google com a marca Gemini, e é uma opção gerenciada forte e bem precificada, com cerca de US$ 0,005 por minuto no modelo de arquivos e taxa de erro de palavras de 2,6% em inglês limpo. Mas não é a escolha automática, e duas coisas fazem as pessoas procurarem outras opções: a transcrição inteligente reescreve suas palavras exatas para "limpá-las", e a diarização fica instável com mais de três falantes.
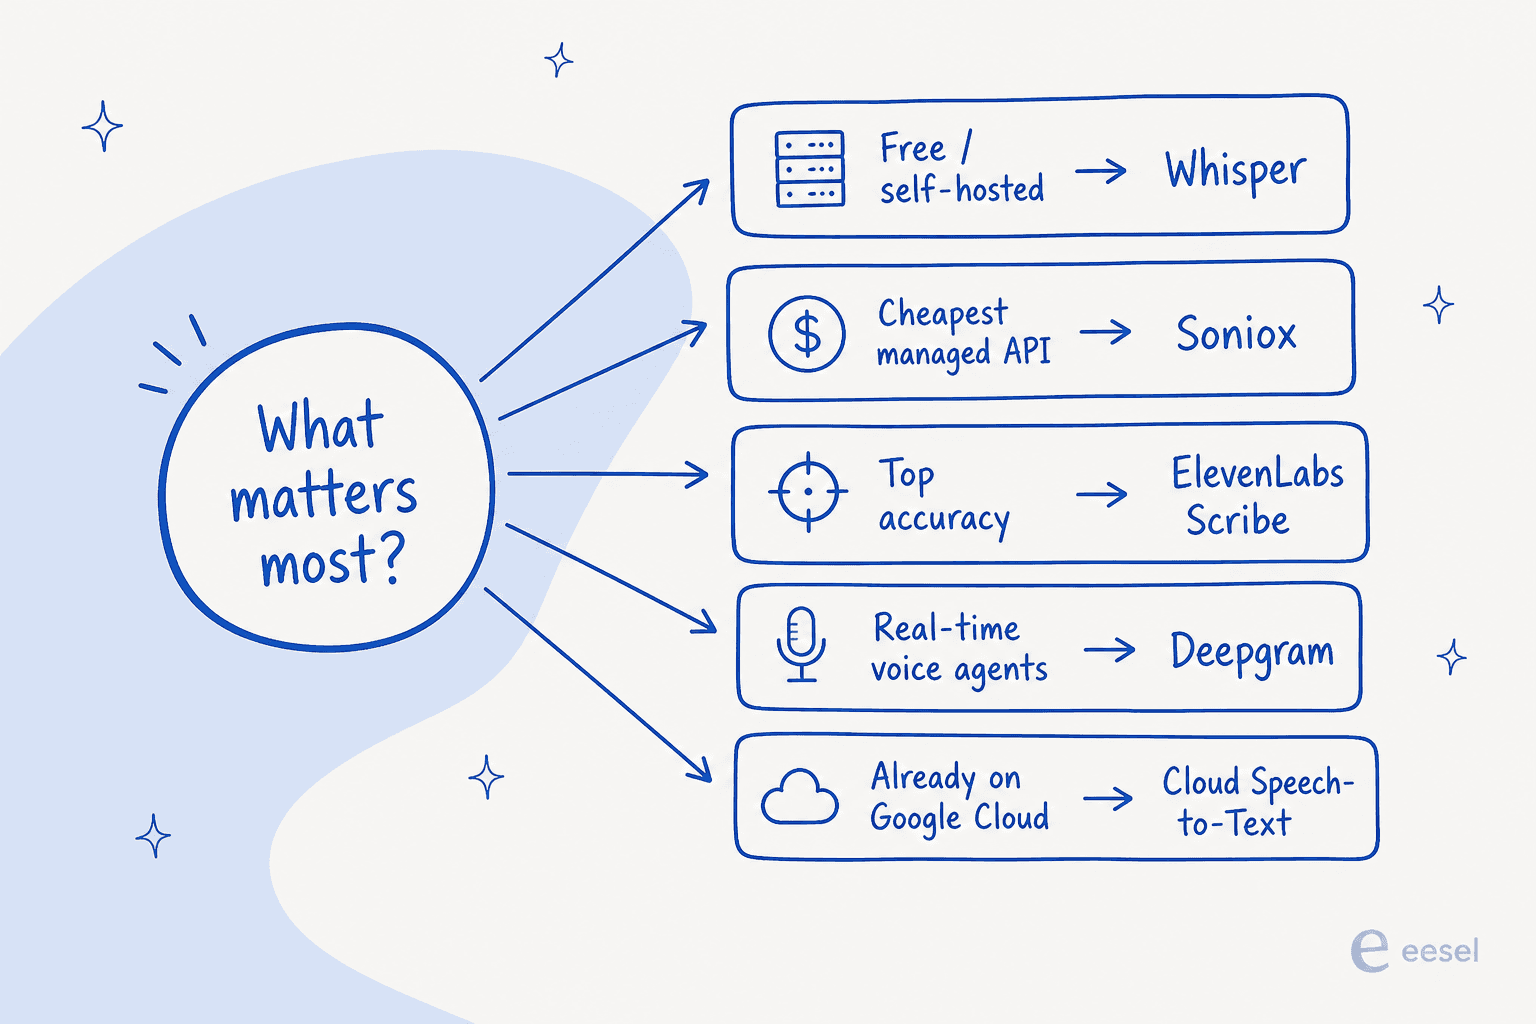
Se você procura uma alternativa ao Gemini 3.5 Transcribe, aqui está o que eu indicaria conforme a necessidade:
- Gratuito e auto-hospedado: OpenAI Whisper (licença MIT, roda no seu próprio hardware).
- API gerenciada mais barata: Soniox, cerca de US$ 0,10 por hora com diarização e detecção de idioma incluídas.
- Maior precisão: ElevenLabs Scribe, mais de 98% de precisão e diarização de até 32 falantes.
- Agentes de voz em tempo real: Deepgram, o especialista em streaming de baixa latência.
- Já está no Google Cloud: Cloud Speech-to-Text (Chirp 3), com o nível em lote mais barato, a US$ 0,003 por minuto.
Uma coisa que vale dizer de antemão: a transcrição é apenas a camada de entrada. Se você é uma equipe de suporte que transforma voz e chat em tickets, a transcrição é a metade fácil. Resolver de fato o ticket é a parte difícil, o trabalho de um colega de IA para helpdesk que um modelo de transcrição não consegue fazer.
Por que olhar além do Gemini 3.5 Transcribe
Primeiro, sendo justo: o Gemini 3.5 Transcribe é um modelo muito bom. É o sucessor do Chirp 3 do Google, informa uma taxa de erro de palavras de 2,6% em inglês sem streaming, detecta automaticamente mais de 85 idiomas e, a cerca de US$ 0,005 por minuto no modelo de arquivos, custa menos que o nível padrão do próprio Cloud Speech-to-Text do Google. Para ditado com um único falante, é difícil de superar. Aprofundei tudo isso na minha análise do Gemini 3.5 Transcribe.
Então por que trocar? Três razões concretas aparecem o tempo todo.
A transcrição inteligente reescreve suas palavras. É o recurso que o Google mais destaca e também a reclamação mais comum. A transcrição inteligente remove palavras de preenchimento e autocorreções e reformata no caminho, o que é ótimo para ditar um e-mail e um problema real quando o texto exato importa. Um desenvolvedor que a testou descobriu que ela "simplificava" uma frase e quebrava o sentido, perdendo a primeira metade de uma oração precisa em testes repetidos. Para trabalho jurídico, médico, de pesquisa ou de conformidade, isso é um impeditivo, não uma nota de rodapé.
A diarização trava acima de três falantes. A documentação do Google não concorda consigo mesma: a página do modelo diz até 8 falantes com "3+ experimental", enquanto o blog de lançamento diz até três. O número confiável hoje é três, e o modelo de streaming ao vivo não faz diarização alguma. Se você transcreve reuniões de seis pessoas, é um limite rígido.
Na verdade não é o mais barato. A cerca de US$ 0,30 por hora no modelo de arquivos, o Gemini fica na faixa mais alta do mercado. Vários especialistas cobram menos, e alguns ainda incluem a diarização e a detecção de idioma, que o Gemini não cobra à parte, mas que outros detalham separadamente. Veja o panorama:
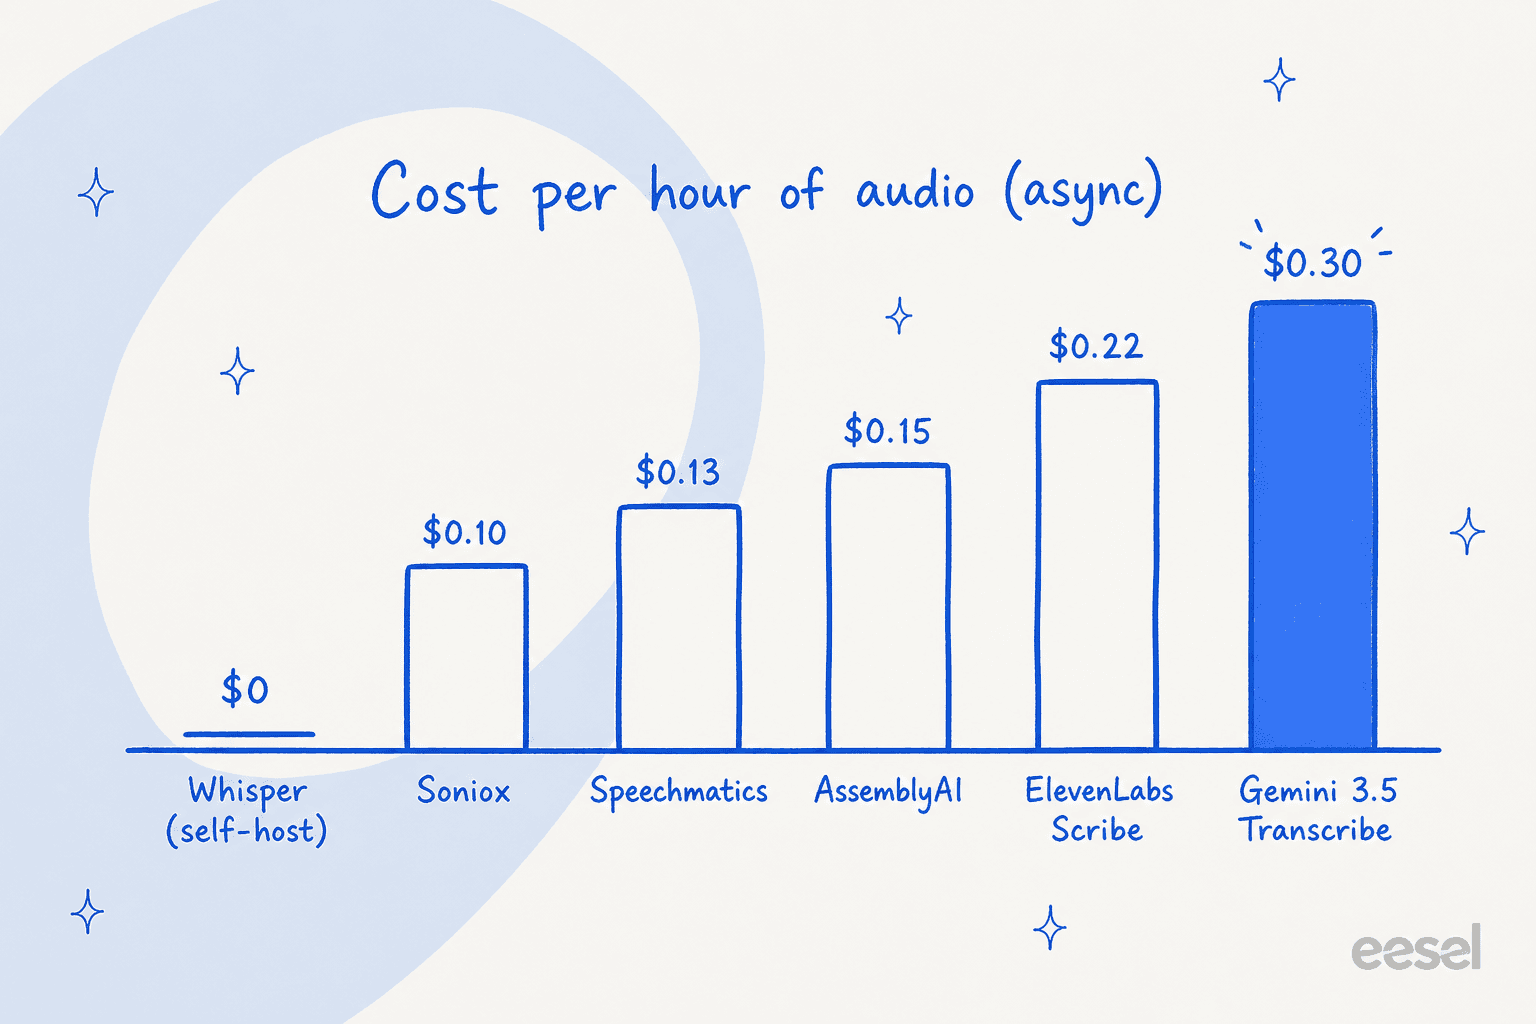
Nada disso faz do Gemini um modelo ruim. Significa apenas que a escolha certa depende do seu áudio, e para muitos casos de uso reais, uma das alternativas abaixo se encaixa melhor.
Como eu as comparei
Avaliei cada alternativa pelas dimensões que de fato mudam uma decisão de desenvolvimento: custo real por hora (não o preço de vitrine), se a diarização e a detecção de idioma são incluídas ou cobradas como extras, cobertura de idiomas, se há modo de streaming em tempo real e o nível gratuito para testar. Li os preços e a documentação de cada fornecedor e me apoiei em desenvolvedores que executam esses modelos lado a lado, porque um número limpo de benchmark e o seu resultado no mundo real podem ser bem diferentes.
Aqui está a tabela-resumo antes dos aprofundamentos. Todos os preços são as tarifas públicas de pagamento por uso do próprio fornecedor para transcrição assíncrona (de arquivos), salvo indicação em contrário.
| Ferramenta | Preço assíncrono | Streaming | Idiomas | Diarização | Nível gratuito | Melhor para |
|---|---|---|---|---|---|---|
| Whisper | US$ 0 (auto-hospedado) | Você mesmo monta | 99 | Bibliotecas extras | Pesos abertos | Controle, sem tarifa por minuto |
| Deepgram | ~US$ 0,29/h (Nova-3) | Sim | 30+ | +US$ 0,0020/min | US$ 200 de crédito | Agentes de voz em tempo real |
| AssemblyAI | US$ 0,15/h (Universal-2) | Sim | 99 | +US$ 0,02/h | Pagamento por uso gratuito | Inteligência de áudio |
| ElevenLabs Scribe | US$ 0,22/h | US$ 0,39/h | 90+ | Até 32 falantes | Nível gratuito | Maior precisão, muitos falantes |
| Speechmatics | a partir de US$ 0,129/h | a partir de US$ 0,24/h | 55+ | Incluída | US$ 100 de crédito | Sotaques e dialetos |
| Soniox | ~US$ 0,10/h | ~US$ 0,12/h | 60+ | Incluída | Crédito gratuito | API gerenciada mais barata |
| Cloud Speech-to-Text | US$ 0,003/min (lote) | US$ 0,016/min | 125+ | Incluída | US$ 300 de crédito do GCP | Equipes que já usam o GCP |
| Rev AI | US$ 0,20/h | Sim | 57+ | Incluída | Teste gratuito | Precisão com sotaques, HIPAA |
| Gemini 3.5 Transcribe | ~US$ 0,30/h | ~US$ 0,54/h | 85+ | Até 3 falantes | Nível gratuito | Ditado com um único falante |
1. OpenAI Whisper
Melhor para: equipes que querem controle total, sem dependência de tarifas por minuto, ou um ponto de partida gratuito.
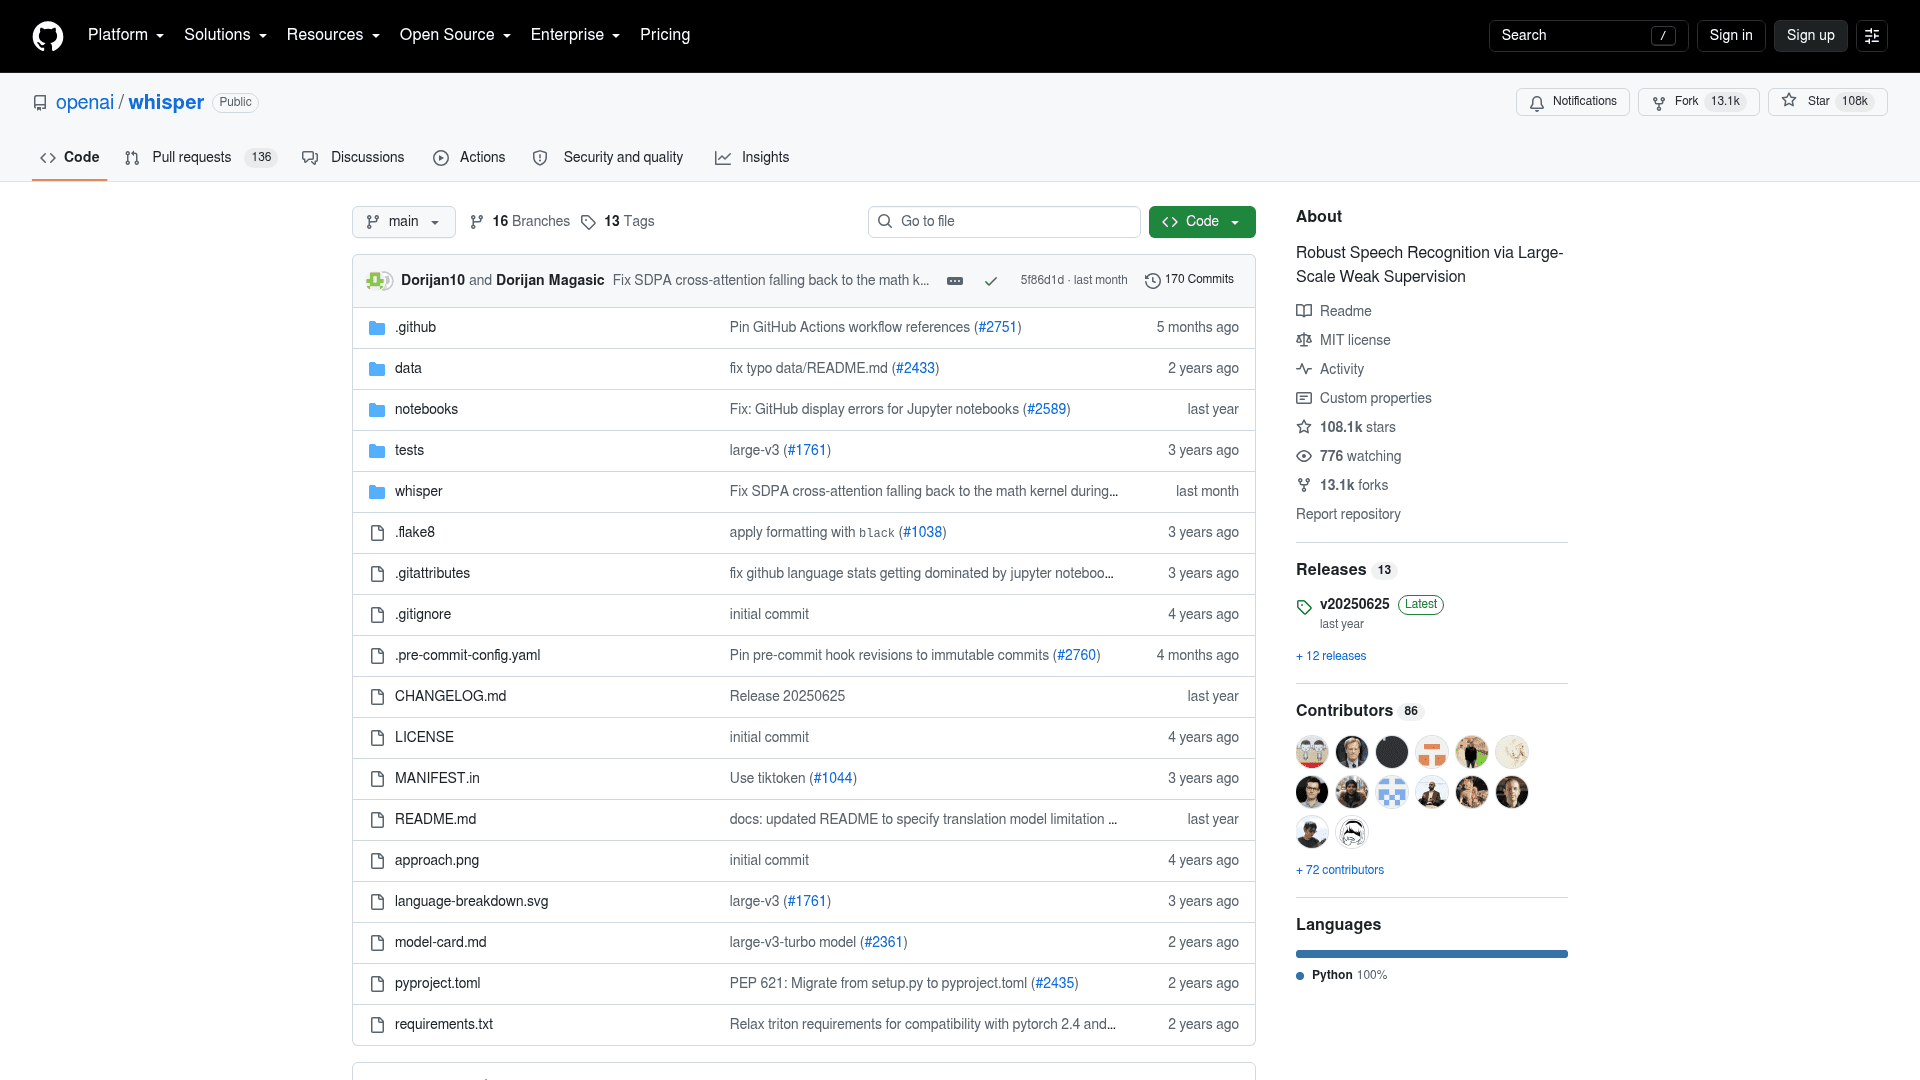
O Whisper é o modelo que redefiniu as expectativas de reconhecimento de fala aberto. Tem licença MIT, mais de 108.000 estrelas no GitHub e se descreve como "Robust Speech Recognition via Large-Scale Weak Supervision". Como os pesos são abertos, você pode rodá-lo no seu próprio hardware pelo custo do processamento, sem conta de API por minuto e sem que os dados saiam da sua infraestrutura. Este último ponto é o motivo de tantas equipes preocupadas com privacidade começarem por aqui.
Ele continua sendo um favorito da comunidade por bons motivos:
"Whisper Large-v3 is still the most stable open model across diverse domains. Great accuracy, predictable output, and decent handling of accents."

Prós: Gratuito para auto-hospedar, pesos abertos, forte precisão multilíngue, enorme ecossistema de ferramentas e ajustes finos, funciona totalmente offline.
Contras: Auto-hospedar dá trabalho de engenharia de verdade (GPUs, processamento em lote, escalabilidade). Diarização e carimbos de tempo por palavra não vêm embutidos, então é preciso acrescentar bibliotecas. O Whisper também é conhecido por inventar texto em trechos silenciosos ou ruidosos. Se você prefere não operar infraestrutura, a API gerenciada GPT-Transcribe da própria OpenAI custa cerca de US$ 0,0045 por minuto (aproximadamente US$ 0,27 por hora) no modo assíncrono e US$ 0,017 por minuto em streaming ao vivo.
Veredito: O Whisper é o padrão para quem valoriza controle e custo acima de conveniência. Se você tem capacidade de engenharia para hospedá-lo, é praticamente gratuito e privado. Se não tem, os endpoints gerenciados da OpenAI dão a mesma linhagem sem o peso operacional. Muitas equipes usam um híbrido: Whisper para carimbos de tempo por palavra e um modelo de chat para corrigir o texto.
2. Deepgram
Melhor para: agentes de voz em tempo real e streaming de baixa latência em escala.
A Deepgram é a especialista em ASR criada para velocidade. Ela alimenta a infraestrutura de voz de empresas como Twilio, Cloudflare e Vapi, e toda a sua arquitetura é ajustada para streaming de baixa latência, exatamente o que um agente de voz ao vivo precisa. Seu atual modelo Nova-3 custa US$ 0,0048 por minuto em streaming monolíngue (cerca de US$ 0,29 por hora), com US$ 200 de crédito gratuito para começar.
Desenvolvedores que comparam o mercado costumam ver a Deepgram como a rápida, e não como a mais precisa:
"AssemblyAI and Speechmatics too, who both have much greater accuracy - especially in real-time for Speechmatics. Deepgram are only fastest at..."
Prós: Excelente latência de streaming, enorme concorrência, auto-hospedagem para setores regulados e uma tabela clara de tarifas por minuto.
Contras: Os extras se acumulam: a diarização de falantes custa US$ 0,0020 a mais por minuto, e a remoção de dados sensíveis e o keyterm prompting custam ainda mais. Sua precisão bruta em áudio difícil fica atrás dos líderes em precisão em alguns testes de usuários.
Veredito: Se você está criando voz em tempo real, a Deepgram é o primeiro nome da lista. É o mais próximo do caso de uso do Gemini 3.5 Transcribe Live e trata o streaming como prioridade, não como um meio-termo de baixa latência. Para trabalho em lote com arquivos em que a precisão importa mais que a velocidade, eu a testaria contra a AssemblyAI ou o Scribe antes de me comprometer.
3. AssemblyAI
Melhor para: equipes que querem transcrição mais inteligência de áudio em uma só API.
A AssemblyAI une uma transcrição forte a um conjunto amplo de recursos de "inteligência de áudio": sentimento, detecção de tópicos, resumo e proteções de segurança, tudo pela mesma API. Seu modelo Universal-2 custa US$ 0,15 por hora em 99 idiomas, e o mais novo Universal-3.5 Pro, a US$ 0,21 por hora, acrescenta alternância nativa de idiomas e sua diarização mais precisa até agora em 18 idiomas. A AssemblyAI afirma uma precisão de palavras maior que a do Whisper, 94,1% contra 92,4%.
Prós: Alta precisão em arquivos, cobertura de 99 idiomas no Universal-2, uma camada de inteligência útil para trabalho com tickets de suporte e preços por hora de autoatendimento com nível gratuito.
Contras: Os extras são medidos: a diarização de falantes soma US$ 0,02 por hora e o keyterm prompting soma US$ 0,05 por hora no modelo Pro. O nível superior Universal-3.5 Pro se limita a 18 idiomas, então o trabalho multilíngue amplo fica no Universal-2.
Veredito: A AssemblyAI é a escolha quando você quer mais do que uma transcrição bruta. Se o seu produto precisa resumir chamadas, sinalizar sentimento ou extrair tópicos, fazer isso em uma só chamada é melhor do que costurar um modelo de transcrição a uma etapa separada de LLM. Em precisão pura ela está no nível dos líderes, e o nível gratuito de pagamento por uso facilita comparar com o seu próprio áudio.
4. ElevenLabs Scribe
Melhor para: a maior precisão e áudio com muitos falantes.
A ElevenLabs ficou conhecida pela geração de voz, mas o Scribe é um modelo de fala para texto sério por mérito próprio. Anuncia mais de 98% de precisão, mais de 90 idiomas e o número de destaque, diarização de até 32 falantes, uma ordem de grandeza acima dos três do Gemini. O Scribe v1 e o v2 custam US$ 0,22 por hora, com um modelo em tempo real, o Scribe v2 Realtime, a US$ 0,39 por hora e cerca de 150 ms de latência.
A relação entre preço e precisão é o que conquista as pessoas. Um desenvolvedor que trabalha com transcrição fez as contas em comparação ao Gemini:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."

Prós: Líder em precisão com áudio limpo, diarização que realmente escala para reuniões grandes, ampla cobertura de idiomas e uma opção em tempo real.
Contras: Mais caro por hora que o Soniox, o Speechmatics ou o nível básico da AssemblyAI. Fala para texto é um produto dentro de uma empresa de geração de voz, então a documentação e a comunidade tendem ao TTS.
Veredito: Se o seu critério é "acertar exatamente as palavras, mesmo com uma sala cheia de gente falando", eu começaria pelo Scribe. Só a diarização de 32 falantes já o torna a resposta óbvia para transcrição de reuniões e painéis, exatamente onde o Gemini 3.5 Transcribe mais sofre.
5. Speechmatics
Melhor para: ampla cobertura de sotaques e dialetos e implantações corporativas.
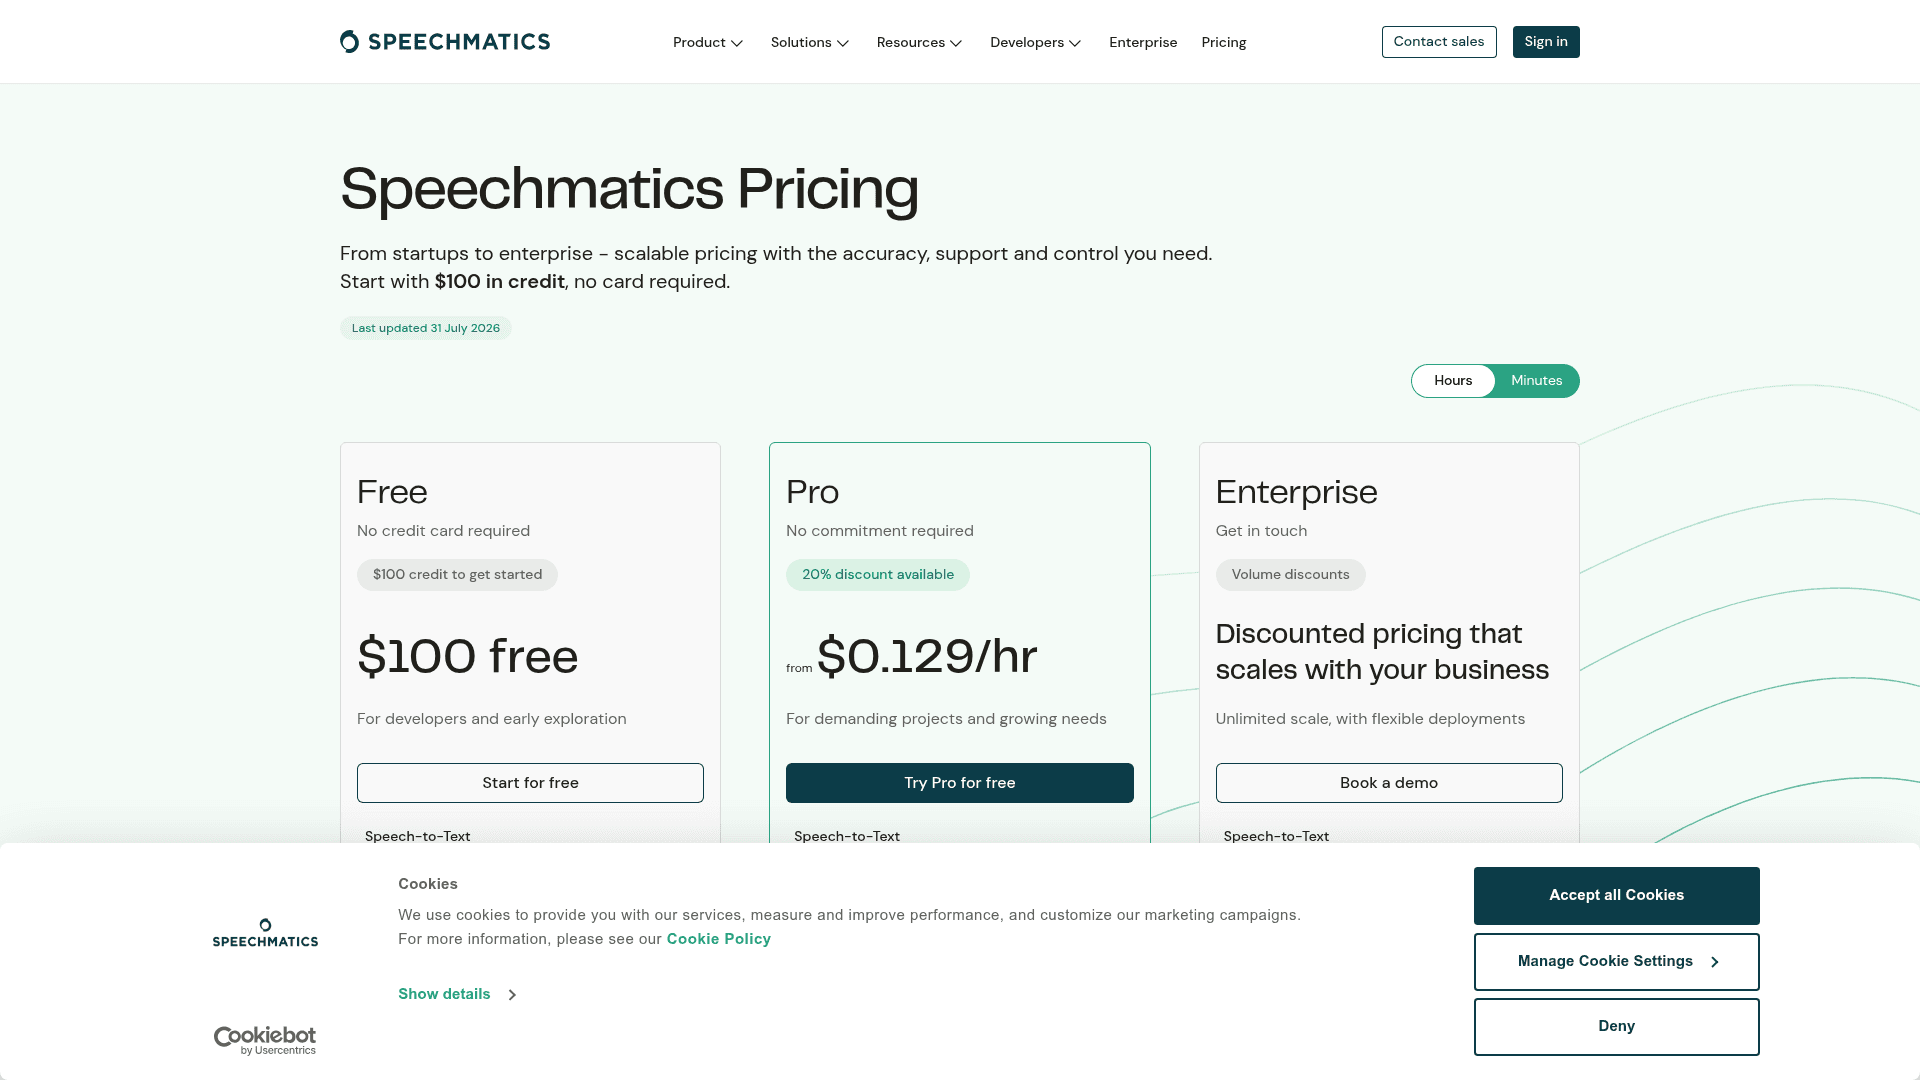
O Speechmatics é o especialista em precisão e sotaques. Cobre mais de 55 idiomas e dialetos e se vende como capaz de transcrever com precisão "over 4 billion people", o tipo de cobertura de sotaques que importa se seus clientes não falam todos um mesmo sotaque padrão. Seu nível em lote Melia 1 começa em US$ 0,129 por hora, com um nível padrão em tempo real a US$ 0,24 por hora, US$ 100 de crédito gratuito e 20% de desconto acima de 500 horas por mês.
Usuários no debate sobre precisão o citam de forma consistente entre os primeiros, especialmente em tempo real, que é o problema mais difícil.
Prós: Forte tratamento de sotaques e dialetos, preços competitivos em lote, diarização incluída em vez de cobrada à parte e implantação on-premise para empresas.
Contras: A estrutura de níveis (Melia 1, Standard, Enhanced, em lote e em tempo real) leva um tempo para entender. O nível Melia 1, o mais barato, é onde está o US$ 0,129 do título, então leia o nível antes de orçar.
Veredito: O Speechmatics é o que eu escolheria quando o áudio é linguisticamente bagunçado: sotaques misturados, dialetos, gravações reais de call center. Se a transcrição inteligente do Gemini está "corrigindo" discretamente a fala de alguém que você precisava preservar, um modelo construído em torno do tratamento fiel de sotaques é a aposta mais segura.
6. Soniox
Melhor para: a API gerenciada mais barata com recursos incluídos.
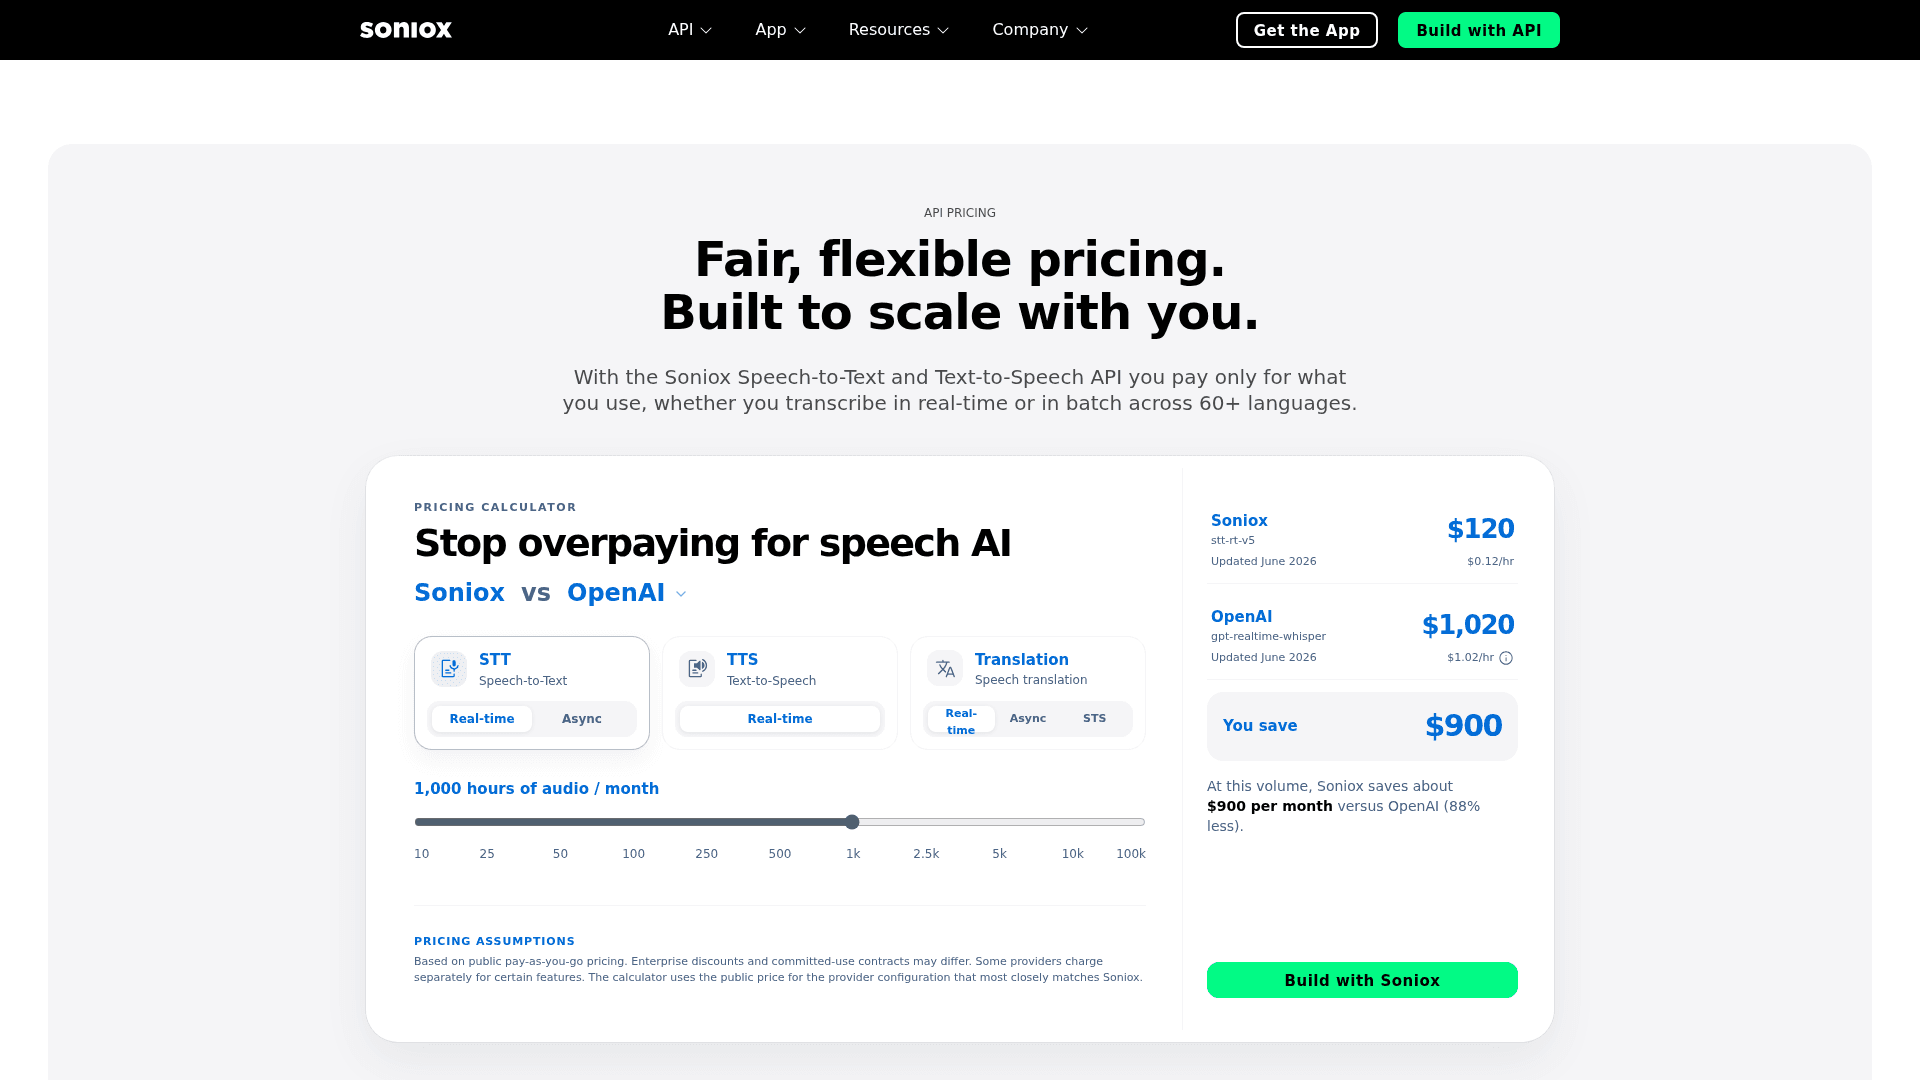
O Soniox é a aposta em custo-benefício, e não esconde isso. Fala para texto custa cerca de US$ 0,10 por hora no modo assíncrono e US$ 0,12 por hora em tempo real, em mais de 60 idiomas. O diferencial não é só o número: diarização de falantes, identificação de idioma, formatação inteligente e até tradução estão incluídas nessa tarifa por hora, em vez de cobradas como extras. O Soniox se apresenta como cerca de 4,5 vezes mais barato que o Google e 8 vezes mais barato que o Azure em tempo real.
Prós: O menor preço gerenciado daqui, tudo incluído (sem sobretaxa de diarização ou detecção de idioma), tempo real e lote no mesmo modelo e tradução em mais de 60 idiomas na mesma chamada.
Contras: É um nome menor e mais novo que a Deepgram ou o Google, então tem menos comparativos de terceiros e menos reconhecimento de marca. Vale testá-lo no seu próprio áudio em vez de confiar na conta do marketing.
Veredito: Para transcrição sensível a custo e em volume, o Soniox é a oferta mais afiada deste comparativo. Incluir diarização e tradução em uma tarifa fixa de US$ 0,10 por hora é uma vantagem real sobre o Gemini e a Deepgram, que cobram esses recursos separadamente. Se a precisão se mantiver nas suas gravações, a economia se acumula rápido em escala.
7. Google Cloud Speech-to-Text (Chirp 3)
Melhor para: equipes que já estão no Google Cloud e o nível em lote mais barato.
Este é o caso interessante: o Cloud Speech-to-Text do Google é o modelo que o Gemini 3.5 Transcribe foi criado para suceder, e continua bem vivo. Seu modelo de base Chirp 3 oferece suporte a mais de 125 idiomas, e os preços vão de US$ 0,016 por minuto no reconhecimento padrão até US$ 0,003 por minuto no dynamic batch, a tarifa em lote mais barata de toda esta comparação. Novos clientes também recebem US$ 300 em créditos do Google Cloud.
Prós: O nível em lote grande mais barato, a US$ 0,003 por minuto, a mais ampla cobertura de idiomas, integração profunda com o restante do Google Cloud e ferramentas de nível corporativo.
Contras: O reconhecimento padrão em tempo real, a US$ 0,016 por minuto, é mais caro que o próprio modelo de arquivos do Gemini. Há mais trabalho de configuração do que em um único endpoint limpo, e o Google claramente está direcionando o trabalho novo para o Gemini 3.5 Transcribe.
Veredito: Se a sua stack já vive no Google Cloud, ou você executa grandes trabalhos em lote em que US$ 0,003 por minuto vence, o Chirp 3 é uma escolha perfeitamente racional, às vezes mais barata que o novo e brilhante modelo Gemini. Apenas compare coisas equivalentes: lote com lote, tempo real com tempo real.
8. Rev AI
Melhor para: precisão entre sotaques, conformidade com HIPAA e uma opção humana de reserva.
A Rev AI vem da Rev, a empresa de transcrição humana, e se apoia nessa herança: seus modelos são treinados com mais de 7 milhões de horas de fala verificada por humanos, e ela promove equidade entre "ethnic background, nationality, gender, and accent". Cobre mais de 57 idiomas, tem SOC 2, HIPAA, GDPR e PCI com 99,99% de disponibilidade e cobra a transcrição automática a US$ 0,20 por hora, um modelo turbo a US$ 0,10 por hora e transcrição humana a US$ 1,99 por minuto quando você precisa de uma pessoa no processo.
Prós: Precisão consistente entre sotaques e áudio desafiador, uma forte postura de conformidade para setores regulados e a opção de escalar para transcrição humana nos arquivos mais difíceis.
Contras: A marca ainda é mais conhecida pela transcrição humana, então a API para desenvolvedores recebe menos atenção da comunidade que a Deepgram ou a AssemblyAI. Streaming e modelos premium ficam acima das tarifas básicas de US$ 0,10 a 0,20.
Veredito: A Rev AI é a escolha quando conformidade e equidade entre vozes são inegociáveis, ou quando você ocasionalmente precisa de uma transcrição de nível humano para um arquivo crítico. A cobertura de HIPAA e o caminho de escalonamento para humanos são coisas que a maioria dos fornecedores só de modelos não oferece, o que a torna uma opção natural para fluxos de saúde e jurídicos.
Como escolher de fato
A resposta honesta é que não há um único vencedor, só o encaixe certo para o seu áudio. Depois de passar pelos oito, este é o caminho mais curto até uma decisão:
Duas regras práticas de observar quem constrói sobre esses modelos. Primeiro, teste sempre dois ou três com as suas próprias gravações antes de comprometer um pipeline. O WER de benchmark e o WER do seu áudio ruidoso, com sotaques e vozes sobrepostas são coisas bem diferentes, ponto que também reforço na análise do Gemini 3.5 Transcribe. Segundo, conte os extras. Uma tarifa de vitrine que exclui diarização e detecção de idioma não é comparável a uma que os inclui, e por isso o Soniox, a uma tarifa fixa de US$ 0,10 por hora, pode vencer um modelo "mais barato" quando você liga os extras.
Onde a transcrição termina e a resolução começa
Esta é a parte que um panorama só de modelos deixa passar, e a que mais me importa. Toda ferramenta desta lista faz o mesmo trabalho: transforma áudio em texto. Mesmo a melhor, fazendo isso com perfeição, entrega uma transcrição. E a transcrição de uma ligação ou nota de voz de um cliente não é uma resposta, é o começo de uma.
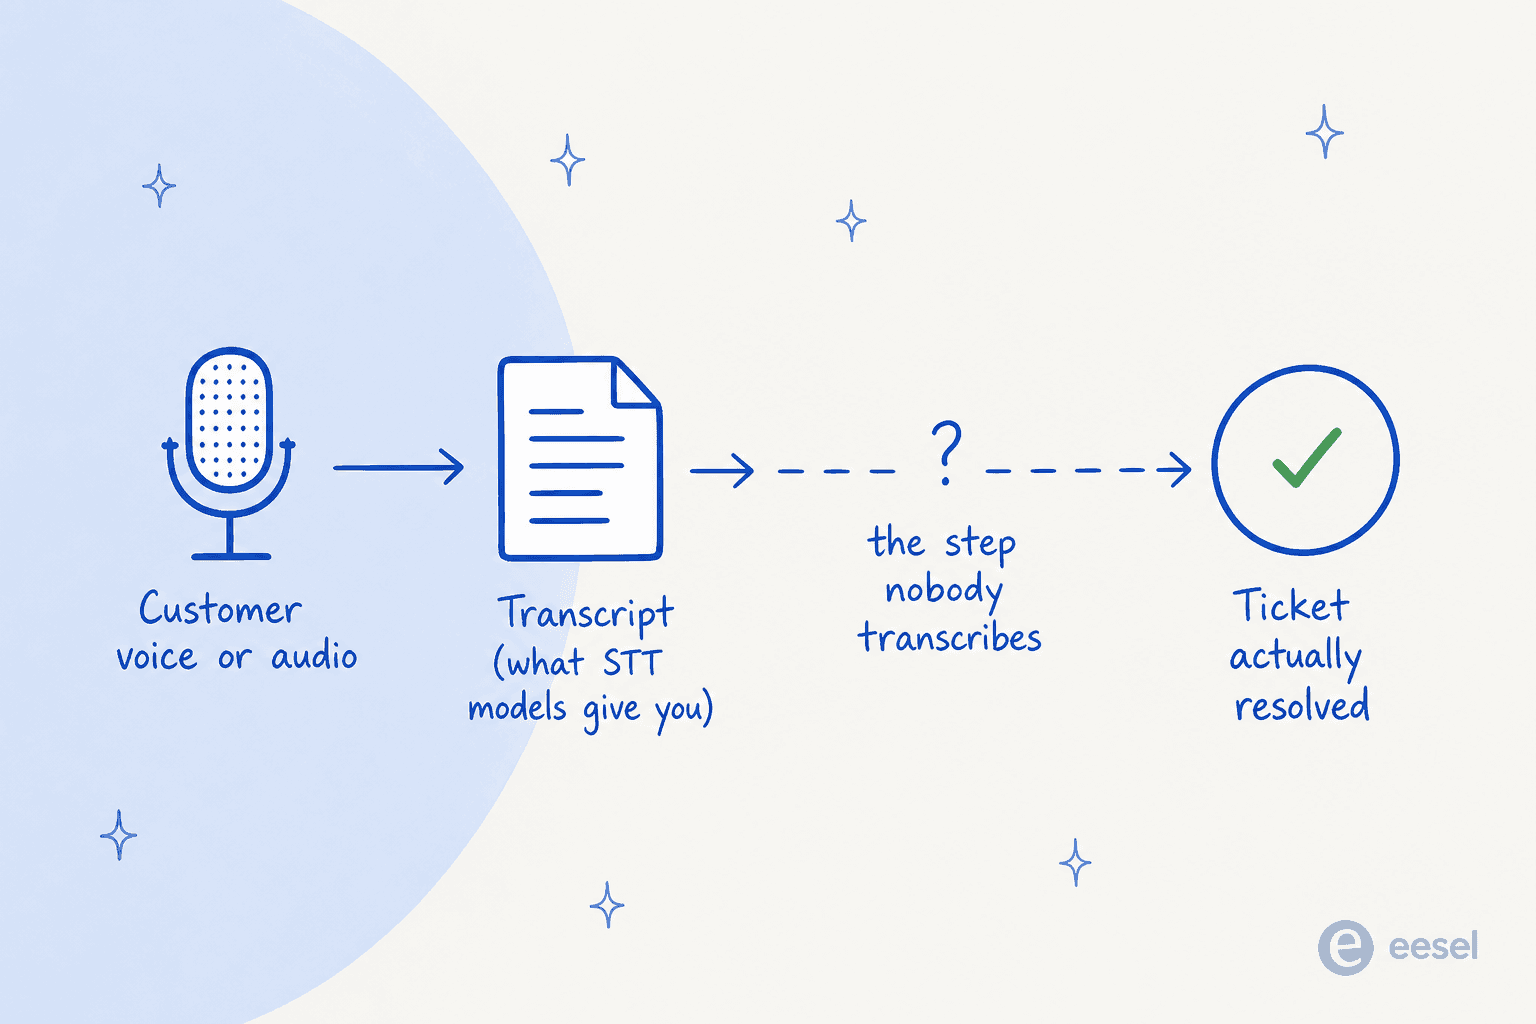
Algo ainda precisa ler esse texto, entender o que o cliente realmente precisa, buscar a informação certa e resolver o ticket. Essa camada de resolução é o que eu faço. Passei os últimos anos perto de IA que atua em filas de suporte ao vivo, e o padrão nunca muda: acertar as palavras é o mínimo, agir corretamente sobre elas é a parte difícil. Um modelo de transcrição entrega as palavras. Ele não conhece sua política de reembolso, seu sistema de pedidos nem os três últimos tickets que esse cliente abriu.
Essa é a diferença entre um modelo e um colega de equipe. Gemini 3.5 Transcribe, Whisper, Deepgram e os demais são modelos, brilhantes em uma tarefa estreita. A eesel é uma plataforma de colegas de equipe: você contrata colegas de IA prontos para trabalhar em tarefas específicas, e o elenco atual inclui um colega de IA para helpdesk e um redator de blog com IA. O colega de helpdesk se conecta ao helpdesk que você já usa, Zendesk, Freshdesk, Gorgias, e entra na fila existente, treinado com a sua central de ajuda e seus tickets anteriores.
Experimente a eesel com tickets de voz e chat
Se você está comparando modelos de transcrição porque sua equipe está se afogando em tickets de voz ou chat, lembre-se de que a transcrição é só metade do trabalho. O colega de IA para helpdesk da eesel continua de onde um modelo como o Gemini 3.5 Transcribe para: lê a mensagem do cliente, redige ou envia a resposta e fecha o ciclo, em mais de 1.000 integrações.
A primeira coisa que eu apontaria é o modo de simulação. Antes que qualquer IA toque em um cliente real, você a executa sobre milhares dos seus tickets históricos e vê exatamente como ela teria respondido, o mesmo conselho de "teste primeiro nos seus próprios dados" que eu daria para qualquer modelo de transcrição, embutido no produto. O preço é uma mensalidade fixa, a partir de US$ 299/mês por 500 créditos (1 crédito por ticket ou chat) sem cobrança por usuário, e há um plano gratuito com 100 créditos, sem cartão. É a diferença entre uma transcrição inteligente de um problema e a resolução real dele.