

Resumo
Quando um produto SaaS cai, o volume de suporte não sobe aos poucos, ele dispara. As mesmas poucas perguntas ("é só comigo?", "quando vai voltar?") chegam centenas ou milhares de vezes em uma hora, e uma equipe humana as resolve uma de cada vez, enquanto os tickets realmente incomuns afundam para o fim da fila.
O papel da IA durante uma queda não é ser esperta, é absorver a enxurrada repetitiva para que as suas pessoas possam cuidar dos poucos tickets que realmente exigem julgamento. Um agente de IA para helpdesk bem configurado reconhece os tickets da queda, responde com a mensagem de problema conhecido já reconhecido mais um link da página de status, aplica tags para a limpeza em massa depois e escala tudo o que não segue o padrão.
A armadilha a evitar: uma IA que chuta. Se ela inventar uma previsão de retorno, confirmar uma causa errada ou prometer um reembolso, você transformou um incidente em dois. Mantenha-a baseada em confiança e configure o seu modo de incidente antes de precisar dele, não às 2h da manhã, quando o alerta tocar. Se você quer que a IA fique dentro do helpdesk que já usa e cobre um preço mensal fixo em vez de cobrar por usuário, é aí que a eesel entra.
O que uma queda realmente faz com a sua fila de suporte
Eu trabalho na fila de suporte, então deixe-me descrever o formato dela em vez da teoria. Em um dia normal, os tickets chegam aos poucos, espalhados por uma grande variedade de assuntos: uma dúvida de cobrança aqui, um "como faço" ali, um relato de bug de vez em quando. Dá para fazer a triagem conforme eles chegam.
Uma queda colapsa tudo isso em um único assunto. No momento em que algo essencial quebra, o gráfico deixa de parecer um fio d'água e passa a parecer uma parede.
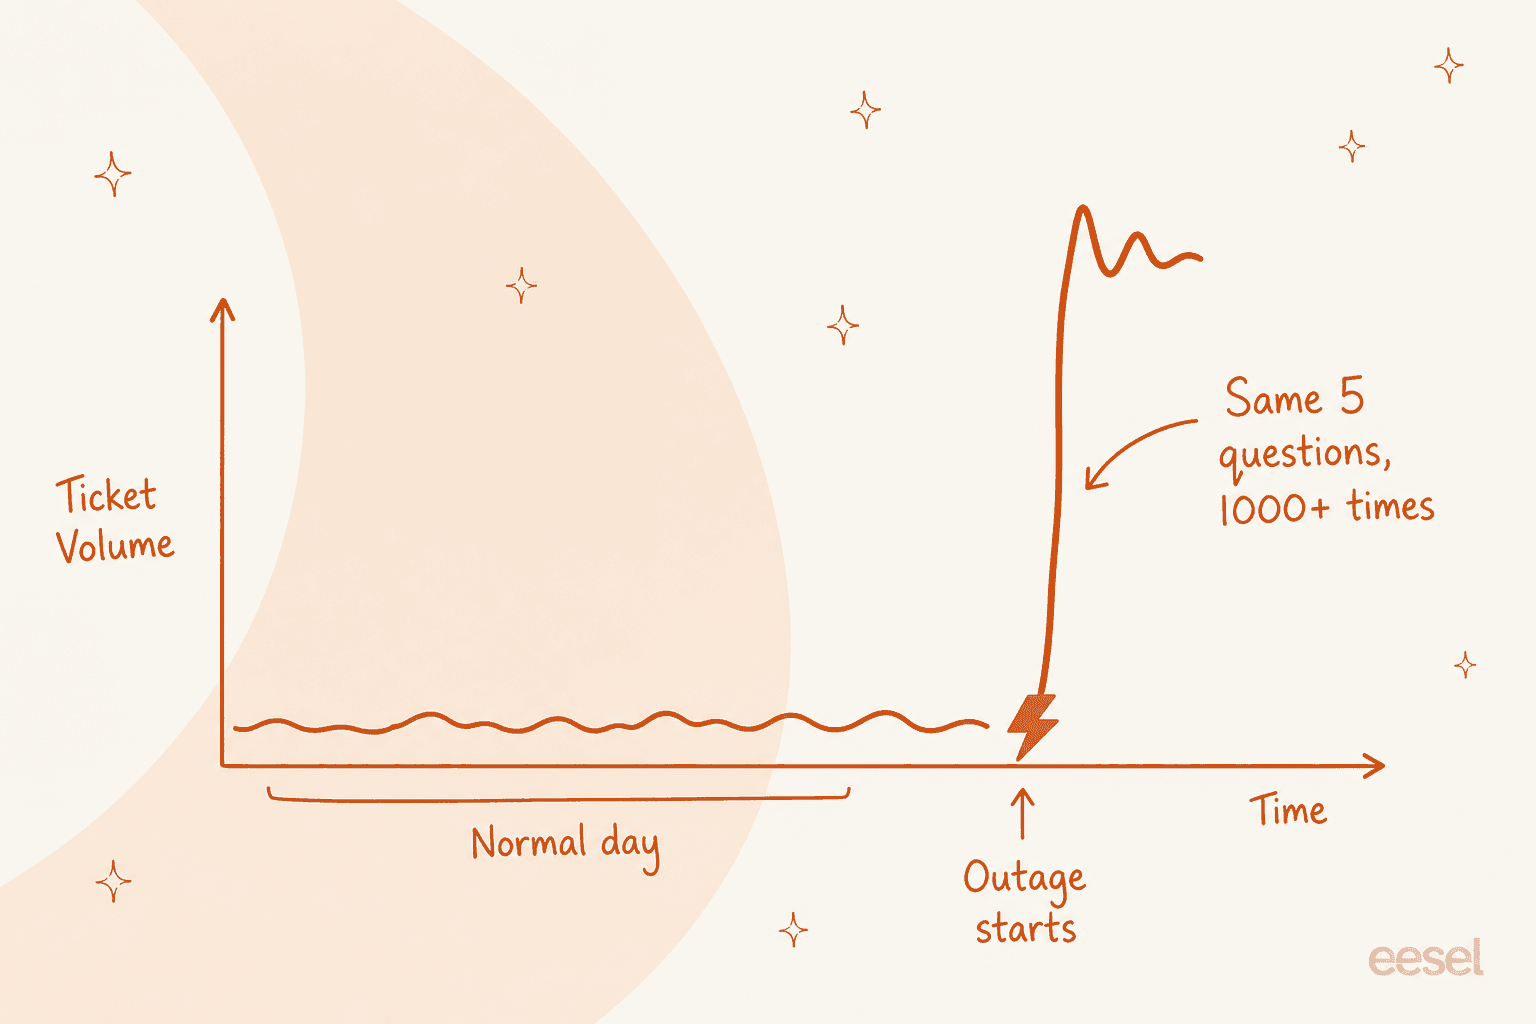
O mais cruel é que é quase tudo o mesmo ticket. Um operador de e-commerce com várias marcas, cujos números eu vi, recebe mais de 500 tickets por dia, em sua maioria pedidos repetitivos de reembolso, cancelamento de assinatura e rastreamento de pedidos, mesmo em um dia calmo. Jogue uma queda em cima de uma base assim e a repetição vai à vertical: as mesmas cinco perguntas, escritas de cinquenta jeitos diferentes, mil vezes.
Uma equipe humana é especialmente ruim justamente nisso. Responder à mesma pergunta pela quadringentésima vez é desgastante, é lento porque cada resposta ainda é digitada à mão e, enquanto os seus agentes fazem isso, o cliente com um problema realmente diferente e sério está parado na posição 812 da fila.
Por que as pessoas chegam ao limite primeiro
As equipes de suporte costumam ser as menores possíveis, porque o volume de tickets em um dia médio não justifica dimensionar a equipe para o pior dia. Essa conta funciona bem até o pior dia chegar.
Ouço a mesma coisa dos líderes de suporte o tempo todo: a equipe está sobrecarregada e não dá conta, e o que eles realmente precisam é que uma máquina assuma os tickets que uma máquina obviamente consegue resolver. Um gestor de suporte de um serviço de rastreamento de ônibus, com 200 a 250 tickets por mês no Zendesk, nos disse com todas as letras que queria que a IA resolvesse 60% dos tickets e, o mais importante, soubesse quando chamar uma pessoa de verdade. Essa cláusula de "saber quando escalar" é o jogo inteiro durante um incidente.
Porque o problema não é só a demora nas respostas. É que os seus profissionais mais experientes, aqueles que deveriam estar ajudando o canal de incidentes a descobrir o que quebrou, ficam duas horas de cabeça baixa copiando e colando "estamos cientes do problema". A queda custa duas vezes: uma no tempo fora do ar e outra em cada pessoa qualificada que você puxou para o plantão da fila.
Como o suporte com IA absorve a enxurrada
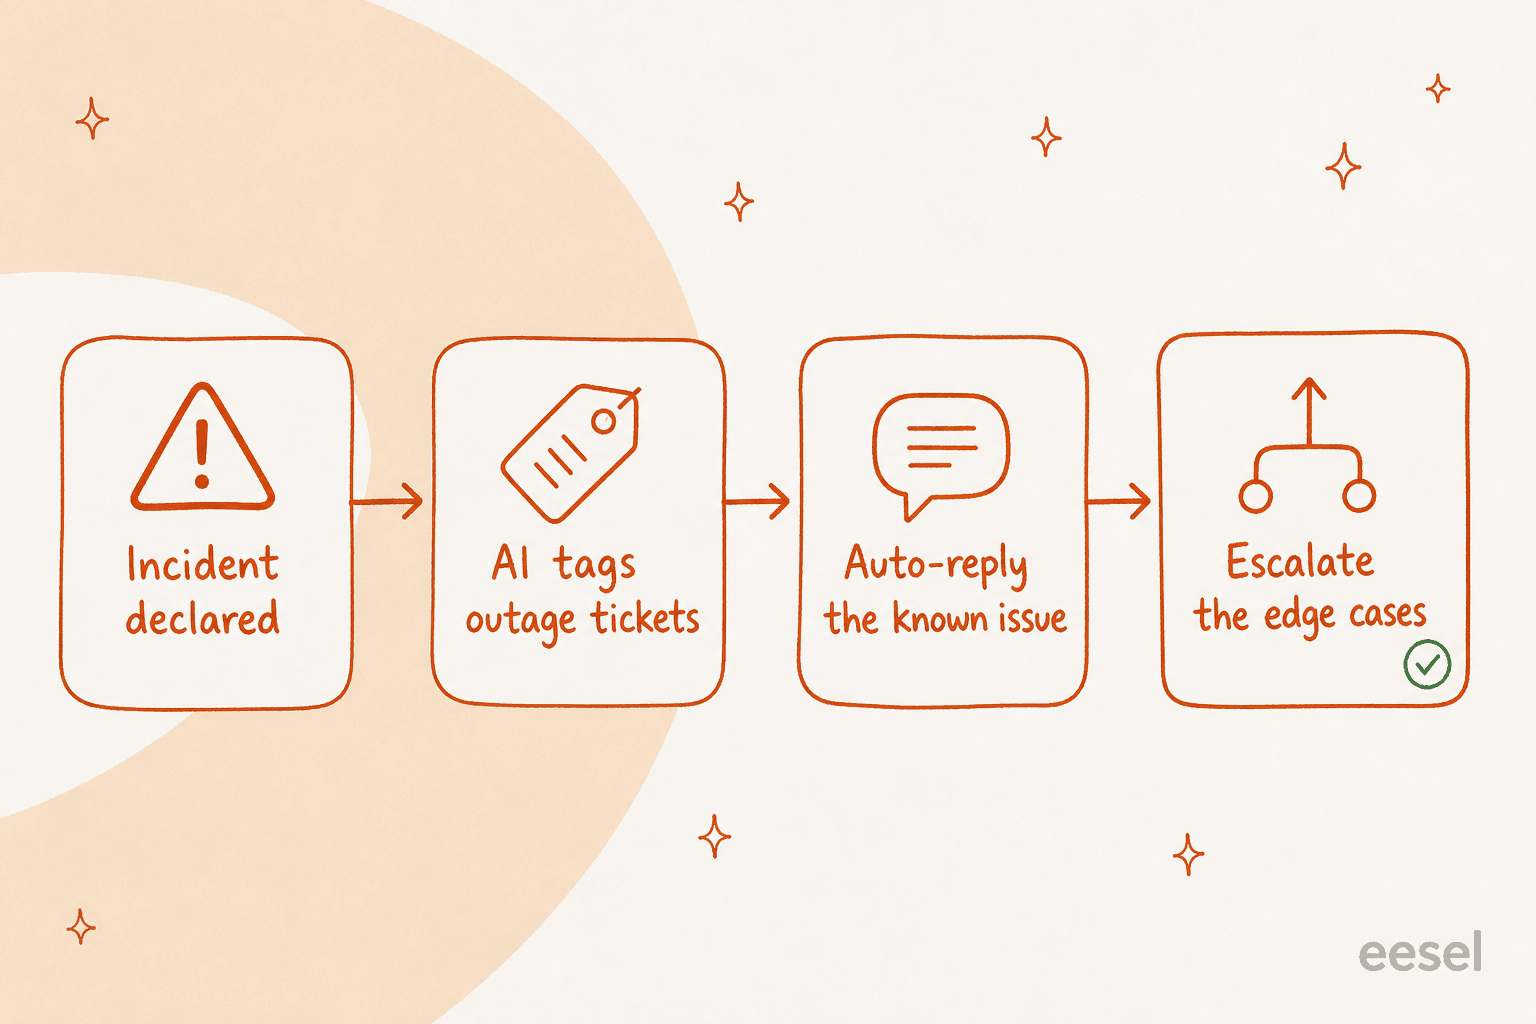
Este é o modelo mental que eu uso. Durante um incidente, os tickets se dividem em dois grupos: a enxurrada (o mesmo problema conhecido, repetidamente) e as exceções (tudo o que não se encaixa). A IA é muito boa no primeiro grupo e deve ficar fora do segundo.
Veja o passo a passo:
- Reconheça o padrão. Quando você sabe o que quebrou, os tickets que o descrevem são fáceis de identificar. A IA os compara com a descrição do problema conhecido que você escreveu.
- Responda, não apenas desvie. Um ticket correspondente recebe uma resposta de verdade: sim, estamos cientes, isto é o que foi afetado, esta é a página de status, vamos manter você atualizado. Isso é uma resolução genuína para aquele cliente, não uma esquiva.
- Aplique tags em tudo o que ela tocar. Todo ticket da queda recebe uma tag, para que, quando a correção for publicada, você possa fechar tudo em massa com um único acompanhamento de "isto já foi resolvido", em vez de reabrir cada conversa.
- Escale as exceções. Um ticket que menciona a queda e uma contestação de cobrança, ou um ticket que não se parece em nada com o problema conhecido, vai para uma pessoa sem ser tocado.
É exatamente essa divisão que um agente de IA para helpdesk foi feito para fazer. Ele se conecta à fila do Zendesk ou do Freshdesk que você já usa (e também do Gorgias e do Help Scout), entra nela como um colega de equipe e tira o grupo repetitivo das costas do seu time.
Nas contas da própria eesel, um cliente, a Gridwise, viu a IA resolver 73% das solicitações de nível 1 no primeiro mês, e isso em dias comuns, não só em incidentes. Durante uma queda, em que os tickets são ainda mais uniformes, essa fatia aumenta.
O custo também importa aqui e é fácil de passar despercebido. Se a sua ferramenta cobra por usuário, um dia com 10x o volume de tickets custa o mesmo em software e uma fortuna em hora extra, porque a única maneira de os humanos escalarem para um pico é trabalhando mais horas. Um preço mensal fixo inverte isso: a eesel começa em $299/mês por 500 créditos (1 crédito por ticket ou chat), sem taxa por usuário nem taxa de plataforma, para que a IA dê conta de uma enxurrada de duas horas sem mudar a equipe, e o excedente é opcional, com um limite definido por você.
Configure um modo de incidente antes de precisar dele
O pior momento para configurar qualquer coisa disso é no meio da queda. Faça agora, enquanto é tedioso. Esta é a configuração que eu gostaria de ter pronta antes do próximo incidente.
- Escreva a macro de problema conhecido com antecedência. Você não vai saber a causa específica de antemão, mas pode pré-escrever o formato: "Estamos cientes de um problema que afeta [X]. Nossa equipe está trabalhando nisso. Acompanhe as atualizações em tempo real em [página de status]." Durante o incidente, você preenche os espaços uma vez e a IA usa o texto em todo ticket correspondente.
- Conecte o helpdesk e a página de status. A IA precisa ler a sua central de ajuda e tickets anteriores reais para que as respostas soem como as suas, e precisa da URL da página de status para direcionar os clientes a uma fonte confiável.
- Limite a automação por tipo de ticket e confiança. Decida com antecedência quais categorias a IA pode fechar automaticamente e quais deve deixar em paz. Reembolsos, contestações e qualquer coisa com cara de questão jurídica ficam sempre com pessoas.
- Simule com quedas anteriores. Este é o passo que as pessoas pulam e depois se arrependem. A eesel executa o agente sobre os seus tickets históricos reais antes de ele entrar no ar, para que você veja como ele teria lidado com o seu último incidente antes de confiar a ele o próximo. É o mais próximo de um simulado de incêndio que o suporte consegue.
- Defina o caminho de escalação. Confirme que um ticket escalado chega onde uma pessoa vai vê-lo rápido, e não em uma pasta que ninguém abre até segunda-feira.
Se você usa o Slack como canal de incidentes, vale conectá-lo também, para que a IA poste no mesmo lugar em que os seus engenheiros estão se coordenando e as equipes de suporte e de engenharia não leiam duas histórias diferentes.
O que a IA nunca deve fazer no meio de uma queda
Esta é a parte que eu tatuaria na parede. Uma queda é exatamente o momento em que uma IA empolgada demais faz mais estrago, porque os clientes já estão estressados e uma resposta errada dita com confiança cai muito mal.
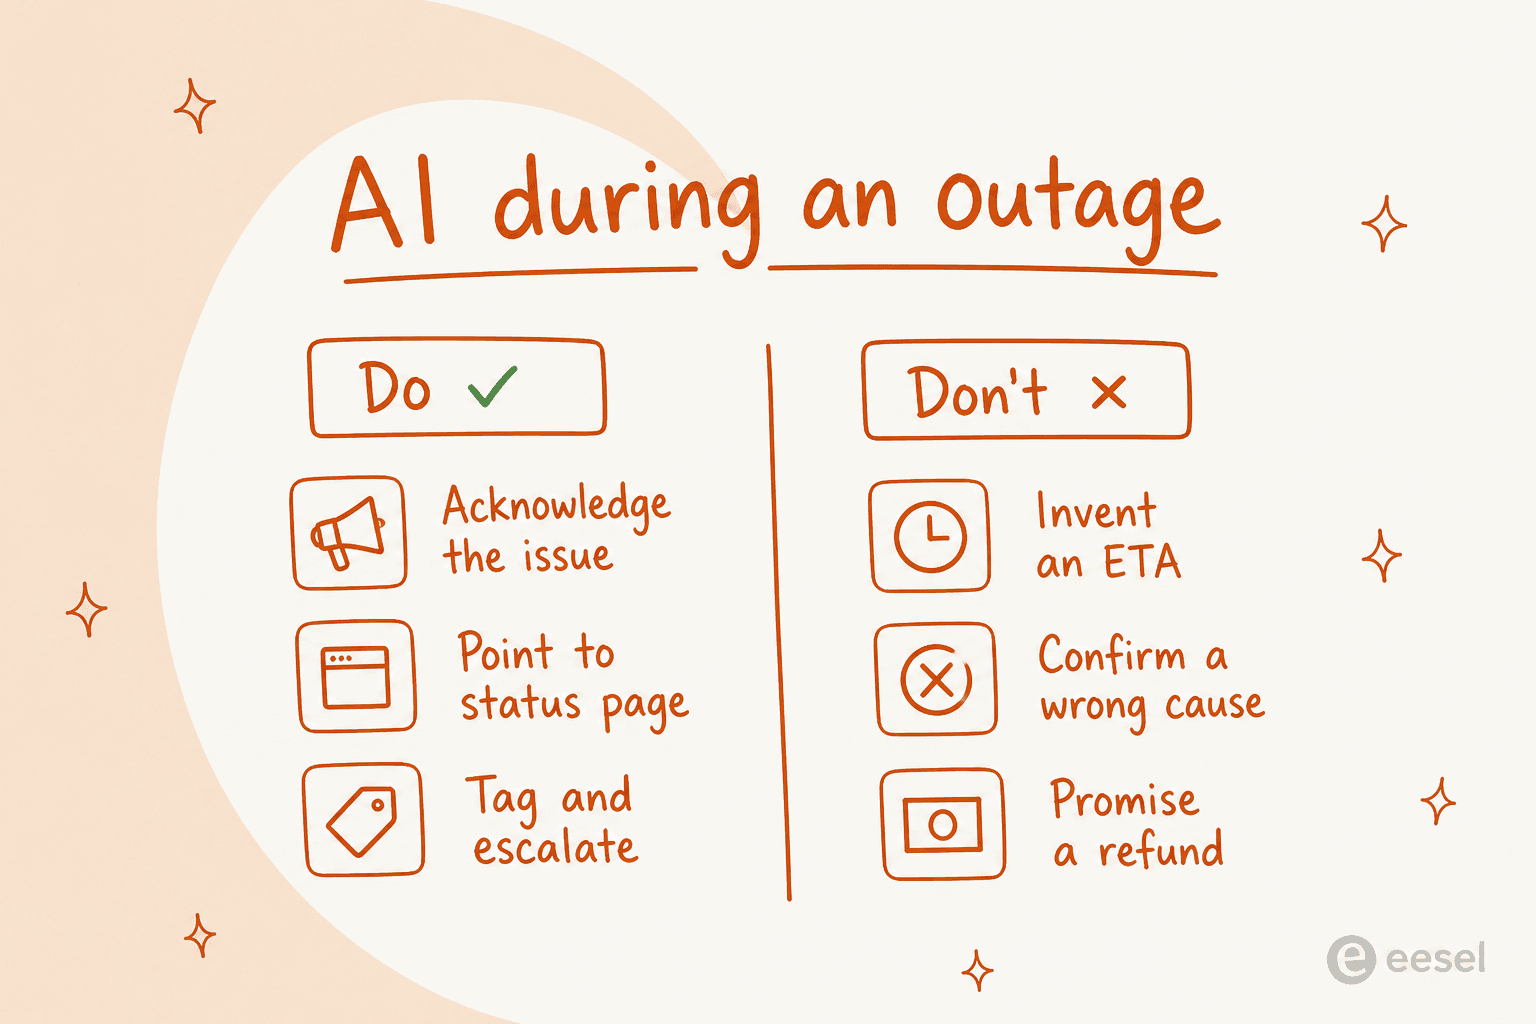
Tudo o que não se deve fazer é uma versão do mesmo pecado: chutar. Uma previsão de retorno inventada vira uma promessa que você quebra. Uma causa raiz confirmada que se revela errada é uma correção pública que você passa a dever. Um reembolso oferecido por um bot é dinheiro e precedente que você não autorizou. Nada disso é hipotético, é o que acontece quando a automação é configurada de forma ampla demais e recebe a ordem de "ser prestativa" sem limites.
A forma de evitar isso é controle, não esperança. Um líder de CX que vou manter anônimo, de uma marca DTC de suplementos, resumiu o princípio melhor do que eu conseguiria:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Essa é a configuração que torna a IA segura durante um incidente: ela faz o trabalho confiante e repetitivo e tem a disciplina de manter as mãos longe de todo o resto. Limitar por confiança não é um extra aqui, é a diferença entre a IA encurtar a queda e prolongá-la.
Experimente a eesel no seu próximo incidente
Se você quer um colega de equipe de IA para helpdesk que fique dentro da sua fila atual, absorva a enxurrada de problemas conhecidos e escale de forma limpa assim que um ticket parecer incomum, é para isso que a eesel foi feita. Ela treina com os seus tickets anteriores e a sua central de ajuda para que as respostas durante a queda pareçam escritas pela sua equipe, limita a automação por tipo de ticket e confiança para nunca chutar nos tickets que importam e simula com o seu histórico real para que você ensaie um incidente antes de vivê-lo.

E, como ela é cobrada em créditos em vez de por usuário, você pode dimensioná-la para um pico sem montar equipe para a pior hora do pior dia. Você pode conectar o seu helpdesk, apontá-la para o seu conhecimento e começar de graça com 100 créditos, sem cartão de crédito e sem conversa com vendas. A próxima queda vem, você estando pronto ou não, então a jogada útil é ter o seu modo de incidente montado e simulado antes dela.