

Resumen
Cuando un producto SaaS se cae, el volumen de soporte no sube poco a poco, se dispara. Las mismas preguntas de siempre ("¿soy solo yo?", "¿cuándo lo arreglarán?") llegan cientos o miles de veces en una hora, y un equipo humano las despacha una a una mientras los tickets realmente inusuales se hunden al fondo.
El trabajo de la IA durante una caída no es ser lista, sino absorber la avalancha repetitiva para que tus personas puedan atender los pocos tickets que de verdad requieren criterio. Un agente de IA para helpdesk bien acotado reconoce los tickets de la caída, responde con el mensaje de incidencia conocida más un enlace a la página de estado, los etiqueta para limpiarlos en bloque después y escala todo lo que no encaje con el patrón.
La trampa que hay que evitar: una IA que adivina. Si inventa un plazo, confirma una causa equivocada o promete un reembolso, has convertido un incidente en dos. Mantenla limitada por confianza y configura tu modo de incidente antes de necesitarlo, no a las 2 de la madrugada cuando suena el busca. Si quieres que la IA trabaje dentro del helpdesk que ya usas y que cobre un precio mensual fijo en lugar de por puesto, ahí es donde encaja eesel.
Qué le hace realmente una caída a tu cola de soporte
Trabajo en la cola de soporte, así que te describo su forma en lugar de la teoría. En un día normal, los tickets llegan con cuentagotas y sobre una gran variedad de temas: una duda de facturación por aquí, un "¿cómo hago...?" por allá, un informe de error de vez en cuando. Puedes ir clasificando sobre la marcha.
Una caída colapsa todo eso en un único tema. En cuanto se rompe algo esencial, la gráfica deja de parecer un goteo y empieza a parecer un muro.
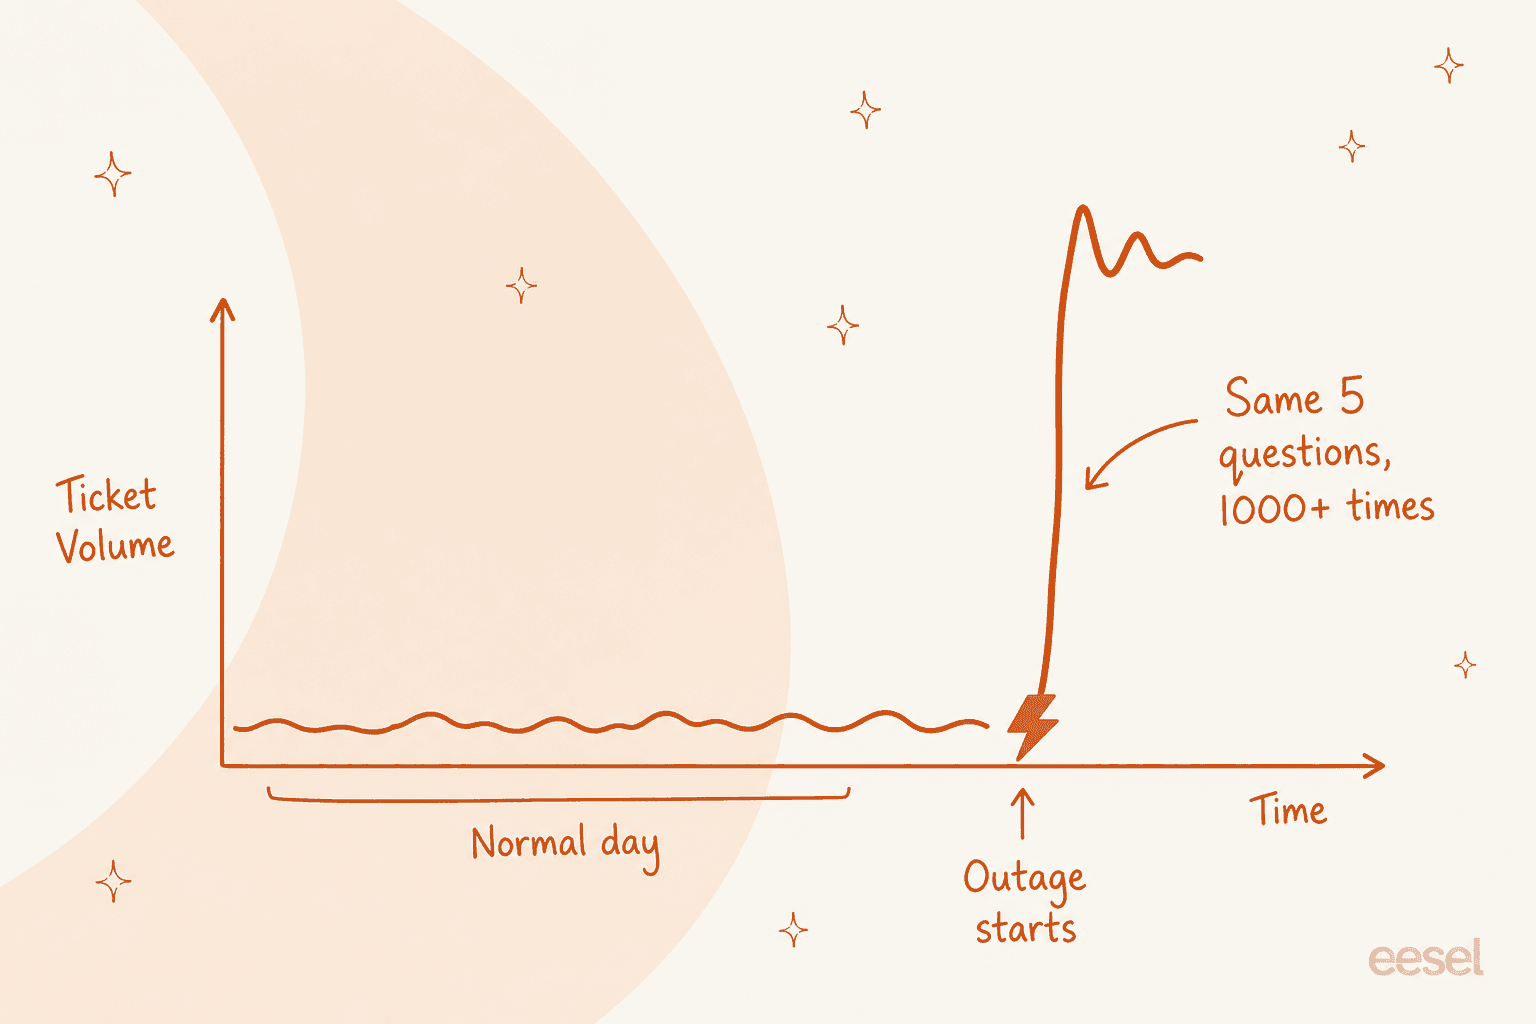
Lo cruel es que casi todo es el mismo ticket. Un operador de comercio electrónico multimarca cuyas cifras he visto gestiona más de 500 tickets al día, en su mayoría consultas repetitivas de reembolsos, bajas y seguimiento de pedidos, incluso en un día tranquilo. Suma una caída a una base así y la repetición se vuelve vertical: las mismas cinco preguntas, redactadas de cincuenta maneras distintas, mil veces seguidas.
Un equipo humano es especialmente malo justo en esto. Responder la misma pregunta por cuadringentésima vez desgasta el ánimo, es lento porque cada respuesta se sigue escribiendo a mano y, mientras tus agentes hacen eso, el cliente con un problema serio y distinto está atascado en el puesto 812 de la cola.
Por qué las personas chocan primero con el muro
Los equipos de soporte suelen ser lo más pequeños posible, porque el volumen de tickets de un día medio no justifica contratar para el peor día. Ese cálculo funciona bien hasta que llega el peor día.
Oigo lo mismo una y otra vez de responsables de soporte: el equipo está desbordado y no da abasto, y lo que realmente necesitan es que una máquina se encargue de los tickets que una máquina puede resolver sin problema. Un responsable de soporte de un servicio de seguimiento de autobuses, con entre 200 y 250 tickets de Zendesk al mes, nos dijo sin rodeos que quería que la IA gestionara el 60 % de los tickets y, sobre todo, que supiera cuándo recurrir a una persona. Esa cláusula de "saber cuándo escalar" lo es todo durante un incidente.
Porque el modo de fallo no son solo las respuestas lentas. Es que tu gente más senior, la que debería ayudar al canal del incidente a averiguar qué se rompió, acaba dos horas con la cabeza gacha copiando y pegando "estamos al tanto del problema". La caída te cuesta dos veces: una por el tiempo de inactividad y otra por cada persona cualificada que sacaste para atender la cola.
Cómo el soporte con IA absorbe la avalancha
Este es el modelo mental que uso. Durante un incidente, los tickets se reparten en dos grupos: la avalancha (la misma incidencia conocida, una y otra vez) y las excepciones (todo lo que no encaja). La IA es muy buena con el primer grupo y debe mantenerse al margen del segundo.
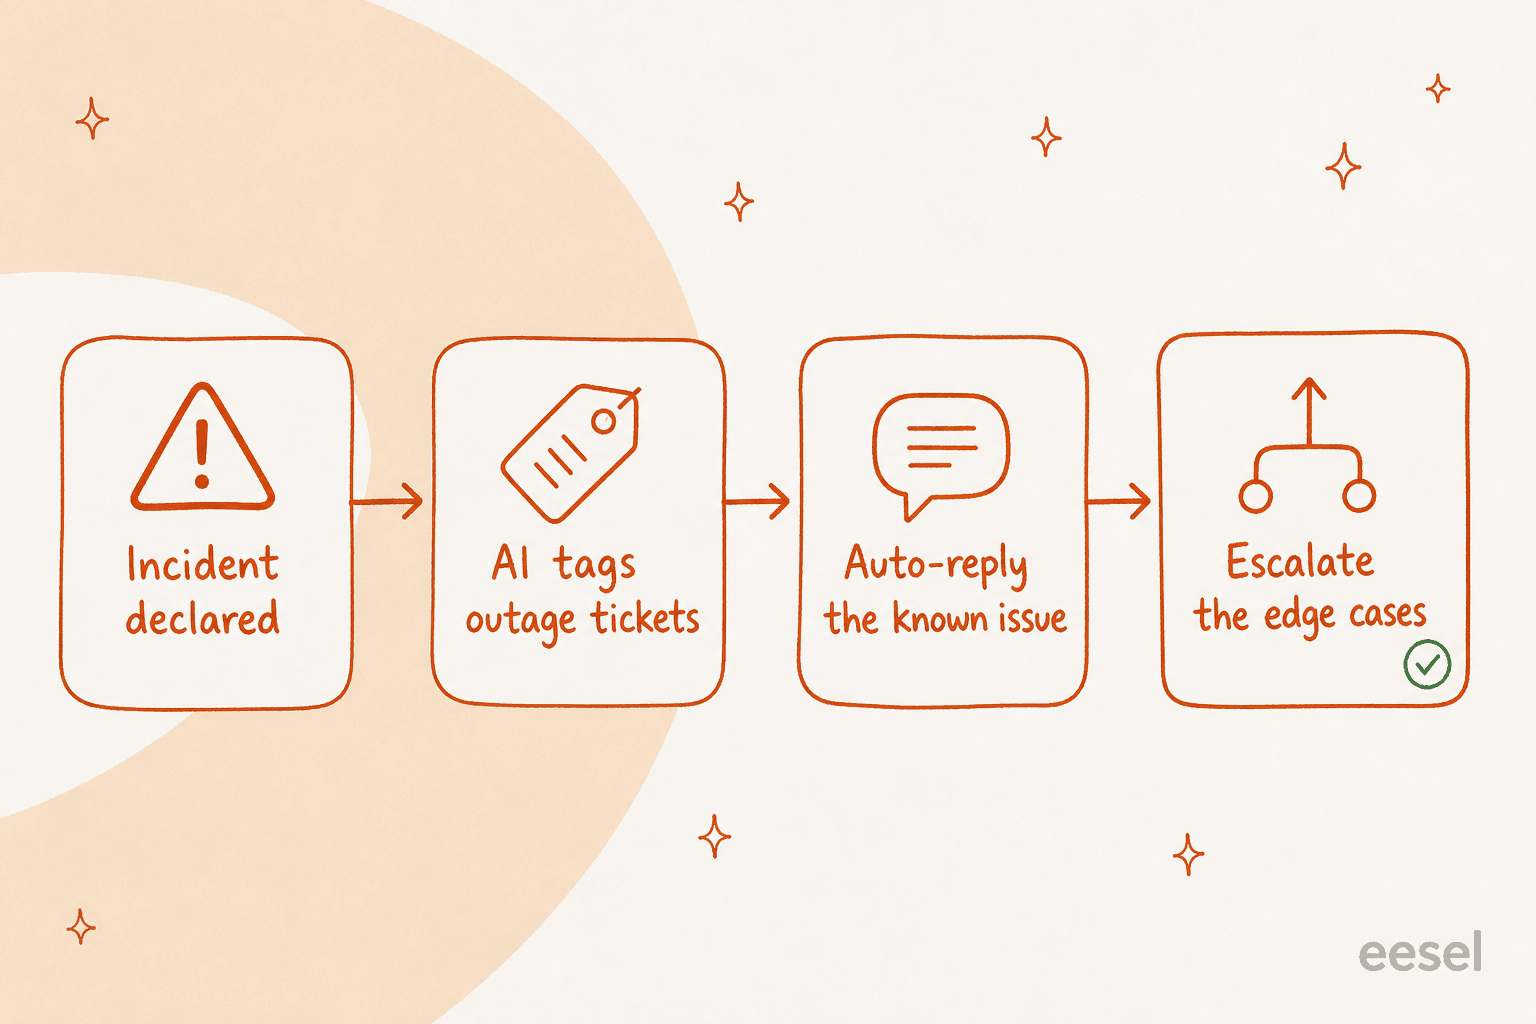
Veámoslo paso a paso:
- Reconocer el patrón. Cuando sabes qué se ha roto, los tickets entrantes que lo describen son fáciles de detectar. La IA los compara con la descripción de la incidencia conocida que has redactado.
- Responder, no solo desviar. Un ticket coincidente recibe una respuesta de verdad: sí, estamos al tanto, esto es lo que está afectado, esta es la página de estado, te mantendremos informado. Es una resolución genuina para ese cliente, no una evasiva.
- Etiquetar todo lo que toca. Cada ticket de la caída se etiqueta para que, cuando llegue la solución, puedas cerrarlos todos en bloque con un único seguimiento de "esto ya está resuelto" en lugar de reabrir cada hilo.
- Escalar las excepciones. Un ticket que menciona la caída y una disputa de cobro, o uno que no se parece en nada a la incidencia conocida, llega a una persona sin tocar.
Esta es exactamente la división para la que está pensado un agente de IA para helpdesk. Se conecta a la cola de Zendesk o Freshdesk que ya usas (y también a Gorgias y Help Scout), se une a ella como un compañero más y quita de las manos de tu equipo el grupo repetitivo.
En las propias cuentas de eesel, un cliente, Gridwise, vio cómo la IA resolvía el 73 % de sus solicitudes de nivel 1 en el primer mes, y eso en días normales, no solo en incidentes. Durante una caída, donde los tickets son todavía más uniformes, ese porcentaje sube.
El aspecto del coste también importa y es fácil pasarlo por alto. Si tus herramientas facturan por puesto, un día con 10 veces más tickets te cuesta lo mismo en software y una fortuna en horas extra, porque la única forma de que las personas escalen ante un pico es trabajar más horas. Un precio mensual fijo lo cambia: eesel empieza en 299 $/mes por 500 créditos (1 crédito por ticket o chat) sin cargo por puesto ni por plataforma, así que la IA puede absorber una avalancha de dos horas sin cambios de plantilla, y el exceso es opcional con un límite que tú fijas.
Configura un modo de incidente antes de necesitarlo
El peor momento para configurar todo esto es en mitad de una caída. Hazlo ahora, mientras es aburrido. Esta es la configuración que querría tener lista antes del próximo incidente.
- Escribe de antemano la macro de incidencia conocida. No sabrás la causa concreta con antelación, pero puedes redactar la estructura: "Estamos al tanto de un problema que afecta a [X]. Nuestro equipo está trabajando en ello. Sigue las actualizaciones en directo en [página de estado]." Durante el incidente rellenas los huecos una vez y la IA la usa en cada ticket coincidente.
- Conecta el helpdesk y la página de estado. La IA necesita leer tu centro de ayuda y tus tickets anteriores reales para que sus respuestas suenen como las tuyas, y necesita la URL de la página de estado para dirigir a los clientes a una fuente fiable.
- Acota la automatización por tipo de ticket y confianza. Decide de antemano qué categorías puede cerrar automáticamente la IA y cuáles debe dejar en paz. Reembolsos, disputas y cualquier cosa de tipo legal siguen siendo siempre humanos.
- Simula con caídas pasadas. Este es el paso que la gente se salta y luego lamenta. eesel ejecuta el agente sobre tus tickets históricos reales antes de ponerlo en marcha, así que puedes ver cómo habría gestionado tu último incidente antes de confiarle el próximo. Es lo más parecido a un simulacro de incendio que tiene el soporte.
- Conecta la ruta de escalado. Confirma que un ticket escalado llega adonde una persona lo verá rápido, no a una carpeta que nadie revisa hasta el lunes.
Si usas Slack como canal de incidentes, conviene conectarlo también, para que la IA pueda publicar en el mismo lugar donde coordina tu equipo de ingeniería y que soporte e ingeniería no lean dos historias distintas.
Lo que la IA nunca debe hacer en plena caída
Esta es la parte que tatuaría en la pared. Una caída es precisamente el momento en que una IA demasiado entusiasta hace más daño, porque los clientes ya están estresados y una respuesta equivocada dicha con seguridad cae muy mal.
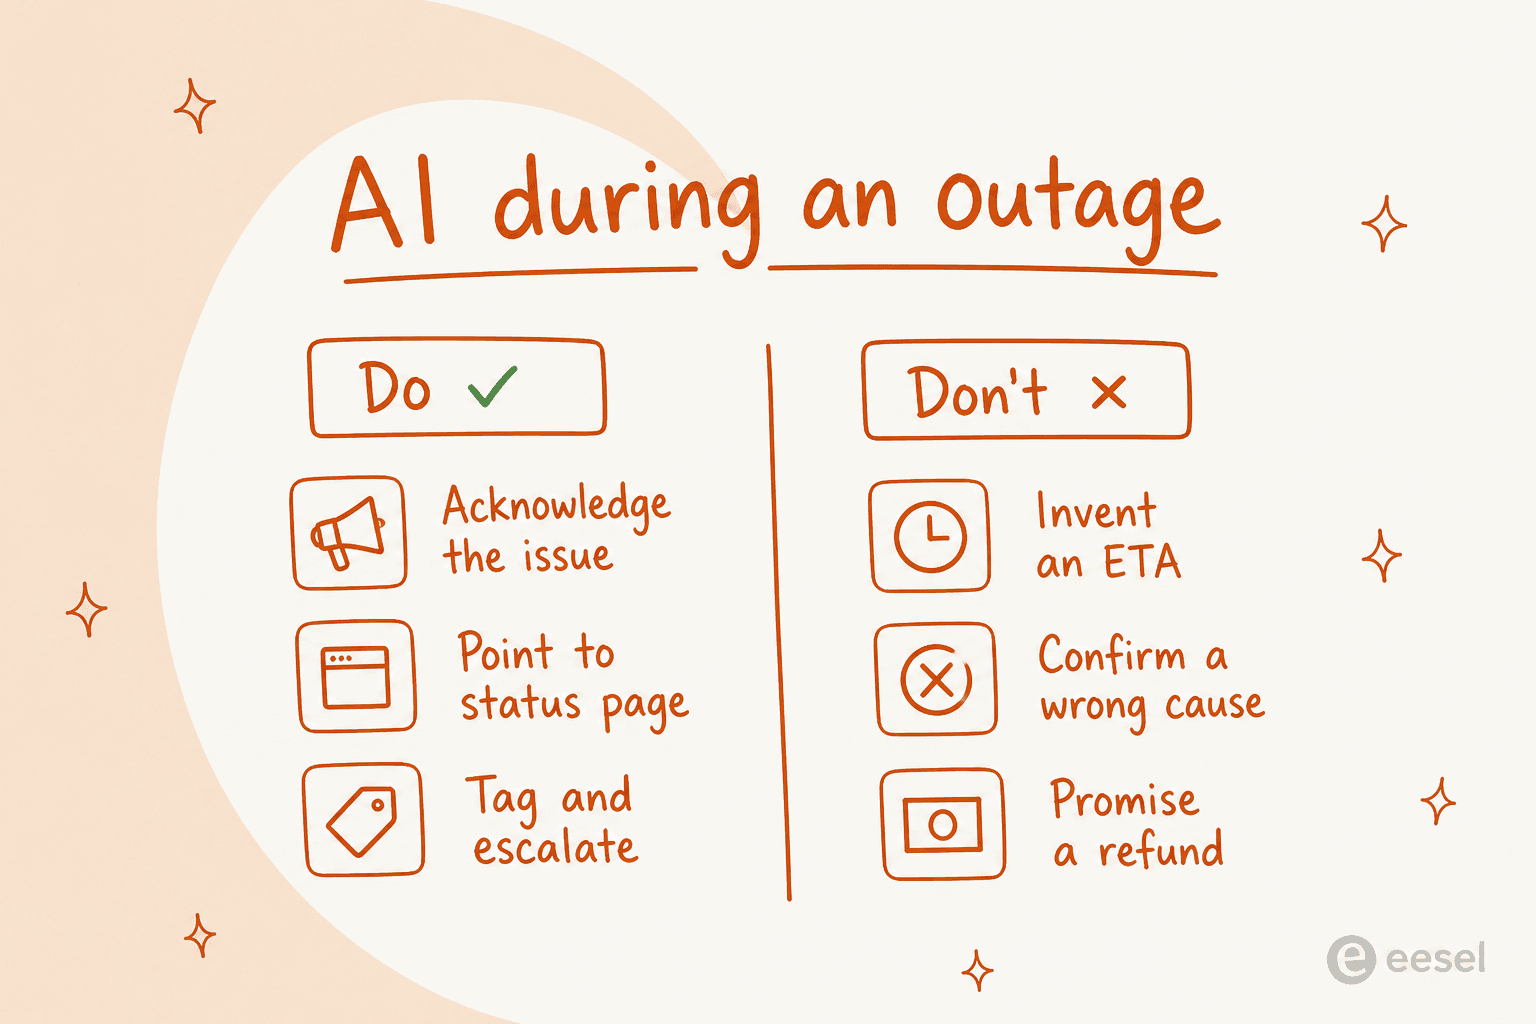
Lo que no se debe hacer son todas versiones del mismo pecado: adivinar. Un plazo inventado se convierte en una promesa que incumples. Una causa raíz confirmada que resulta ser errónea es una rectificación pública que ahora debes. Un reembolso ofrecido por un bot es dinero y un precedente que no autorizaste. Nada de esto es hipotético: es lo que pasa cuando la automatización se acota demasiado y se le dice que "sea útil" sin límites.
La forma de evitarlo es el control, no la esperanza. Una responsable de experiencia de cliente de una marca DTC de suplementos, a quien mantendré en el anonimato, expresó el principio mejor de lo que yo podría (cita traducida del original en inglés):
"La IA nunca podrá responder al 100 % de las preguntas. Necesito una IA que solo gestione los tickets que está segura de poder gestionar y que deje en paz todos los demás."
Esa es la configuración que hace segura a la IA durante un incidente: hace el trabajo repetitivo y seguro, y tiene la disciplina de no tocar todo lo demás. Acotar por confianza no es un extra aquí, es la diferencia entre que la IA acorte la caída o la alargue.
Prueba eesel en tu próximo incidente
Si quieres un compañero de IA para el helpdesk que trabaje dentro de tu cola actual, absorba la avalancha de incidencias conocidas y escale limpiamente en cuanto un ticket parezca inusual, para eso está diseñado eesel. Se entrena con tus tickets pasados y tu centro de ayuda para que sus respuestas durante la caída parezcan escritas por tu equipo, acota la automatización por tipo de ticket y confianza para no adivinar nunca en los tickets que importan, y simula con tu historial real para que puedas ensayar un incidente antes de vivirlo.

Y como el precio es en créditos en lugar de por puesto, puedes dimensionarlo para un pico sin contratar para la peor hora del peor día. Puedes conectar tu helpdesk, apuntarlo a tu conocimiento y empezar gratis con 100 créditos, sin tarjeta de crédito ni llamada comercial. La próxima caída llegará estés listo o no, así que lo útil es tener tu modo de incidente construido y simulado antes de que llegue.