

Gemini 3.5 Transcribe es el primer modelo de voz a texto de Google con marca Gemini, y tras revisar a fondo su documentación, sus benchmarks y lo que dicen quienes lo usan en producción, mi veredicto breve es: es un modelo gestionado sólido y bien tarifado con un problema real.
Lo bueno: unos 0,005 $ por minuto para el modelo de archivos (aproximadamente un tercio del nivel estándar de Cloud Speech-to-Text de Google), una tasa de error de palabras del 2,6 % con audio limpio en inglés, diarización integrada, marcas de tiempo por palabra y detección automática de idioma en más de 85 idiomas.
El problema: Smart transcription, la función que Google vende con más fuerza, reescribe tu habla para limpiarla, y no siempre coincide contigo en qué es ruido. Los evaluadores lo vieron omitir redacciones precisas. La diarización también se vuelve inestable con más de tres hablantes, lo cual importa para notas de reuniones.
Para quién es: dictado, grabaciones de un solo hablante y transcripción sensible al costo a gran escala. Quién debería mirar otras opciones: quienes necesitan salida literal (legal, investigación) y reuniones con varios hablantes, donde un especialista como Deepgram o ElevenLabs Scribe sigue liderando. Y recuerda: si eres un equipo de soporte, la transcripción es solo la capa de entrada; aún necesitas algo que resuelva el ticket, y ahí entra un compañero de IA para el helpdesk.
Qué es Gemini 3.5 Transcribe, en breve
Hasta ahora, transcribir audio con Google significaba una de dos cosas: la Speech-to-Text API de Google Cloud (la línea Chirp), o pasarle un archivo de audio a un modelo de chat Gemini general y pedírselo con amabilidad. Gemini 3.5 Transcribe, anunciado alrededor del 26 de agosto de 2026, es el primer modelo que Google construyó específicamente para esta tarea, y se posiciona como el sucesor de Chirp 3.
La página del modelo de Google lo describe como "a speech-to-text model based on Gemini's audio understanding capabilities" con detección de idioma, diarización de hablantes, marcas de tiempo a nivel de palabra, Smart transcription y sesgo de vocabulario personalizado. En realidad son dos endpoints: gemini-3.5-transcribe para archivos pregrabados y gemini-3.5-transcribe-live para streaming en tiempo real. Analicé el desglose completo de precios y especificaciones por separado; esta reseña trata de si de verdad es bueno.
Esta es la propia página del modelo, que es donde empezará la mayoría de los desarrolladores:
Una advertencia antes de construir sobre él: la propia documentación de Google no se pone de acuerdo sobre su estado. La página de resumen de modelos lo etiqueta como "New Stable", mientras que el blog de lanzamiento lo llama "in public preview". Ya está activo en productos de consumo (Rambler en Gboard, la app de Gemini en macOS), así que trátalo como casi listo para producción pero no del todo asentado.
Cómo lo evalué
No tenía meses de registros de producción, así que seré franco sobre la base de esta reseña: leí por completo la model card y la documentación de precios, contrasté las afirmaciones de benchmark de Google con cómo están planteadas, y me apoyé mucho en los desarrolladores que sí estaban comparándolo (A/B) con Whisper, Deepgram y ElevenLabs Scribe en los días posteriores al lanzamiento. La transcripción es un área donde la cifra limpia del benchmark del proveedor y tu resultado real pueden estar a mundos de distancia, por eso la señal de la comunidad importa tanto como la hoja de especificaciones.
La versión corta de lo que salió: las cifras son reales y buenas, el precio es muy competitivo, y las quejas más sonoras se concentran en dos cosas concretas. Vamos por orden.
Precisión: las cifras de laboratorio son geniales, el audio real es la prueba
Sobre el papel, este modelo es muy bueno. Google informa las siguientes tasas de error de palabras, todas atribuidas a Artificial Analysis:
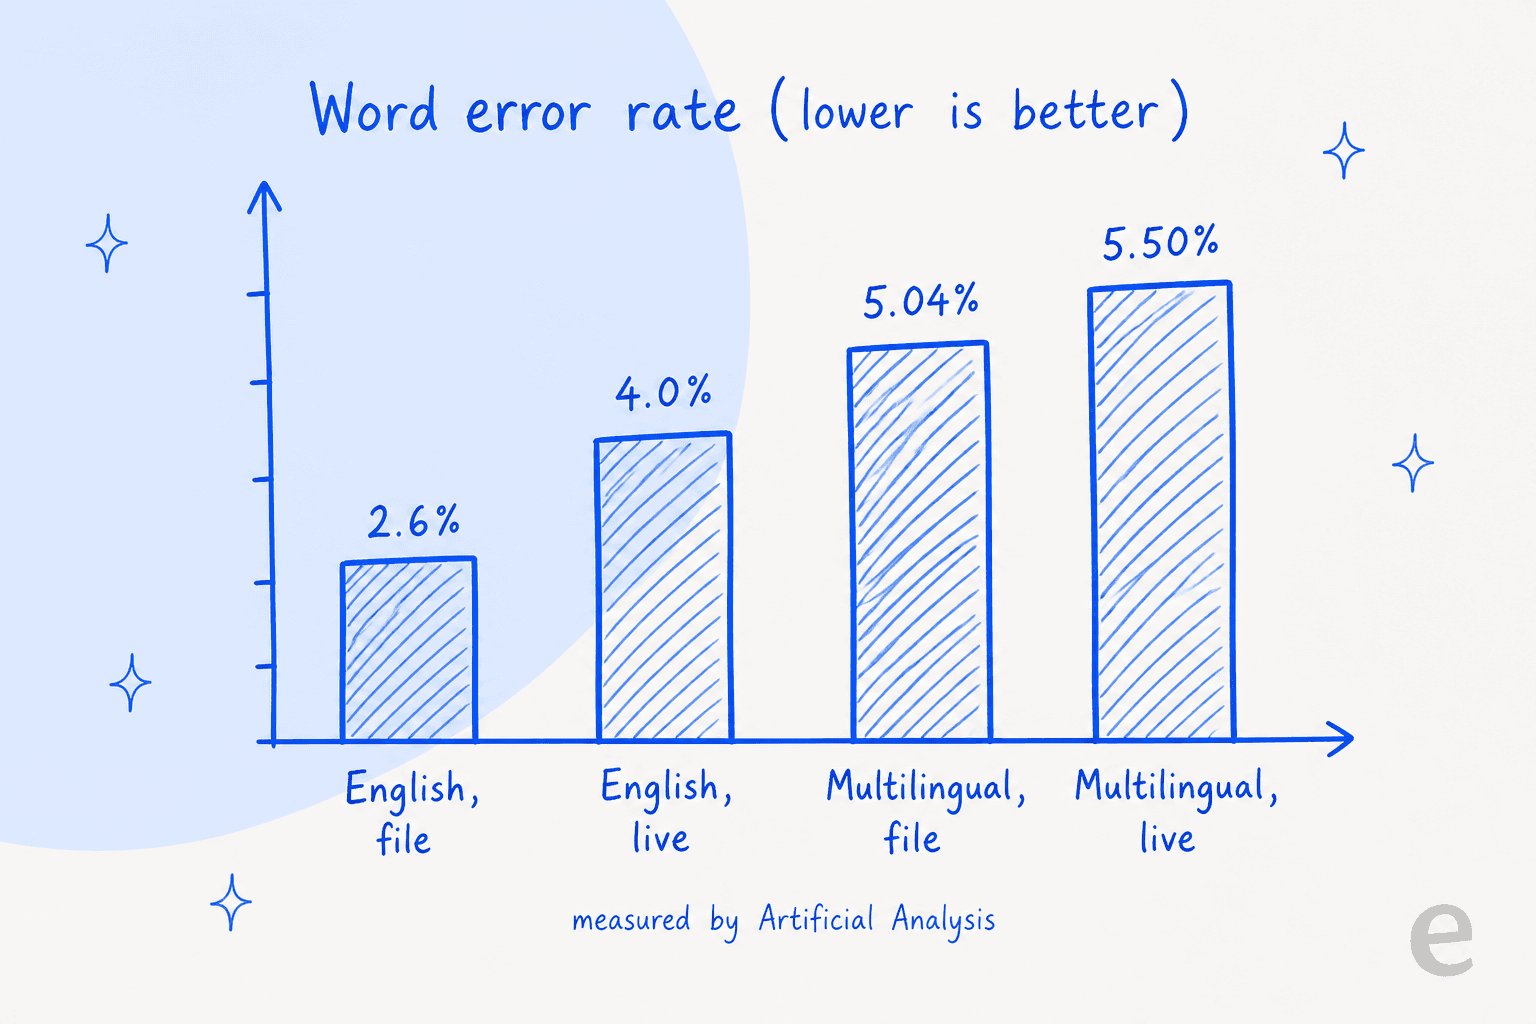
Una tasa de error del 2,6 % en inglés sin streaming equivale a aproximadamente una palabra errónea de cada cuarenta, lo cual es excelente. Google también afirma que el tiempo hasta la transcripción final mejora un 70 % frente a Chirp 3, aunque ese planteamiento es de la propia Google, así que lo archivaría como cifra del proveedor y no como un benchmark independiente.
La señal más útil es lo que encontró la gente al usarlo con su propio audio. Y aquí se divide. En el lado muy positivo, fue casi tan elogioso como puede ser una opinión:
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."

Pero el hilo de lanzamiento está lleno de gente haciendo comparaciones y llegando a conclusiones más frías. Uno que hace justo esto para ganarse la vida volvió a una configuración híbrida:
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
Mi lectura: la tasa de error en un benchmark limpio y la tasa de error con tu audio real (llamadas con ruido, varios acentos, voces cruzadas) son animales distintos. Las cifras de laboratorio son un buen punto de partida, no una promesa. Si lo evalúas para trabajo real, pruébalo con tus propias grabaciones antes de comprometer un pipeline.
El problema de Smart transcription
Esta es la parte de la reseña que subrayaría. Smart transcription es la función en la que Google más se apoya, y también la queja más común. Una transcripción en bruto del habla humana es desordenada: la gente dice "eh", reinicia frases, murmura números. Smart transcription limpia todo eso automáticamente.
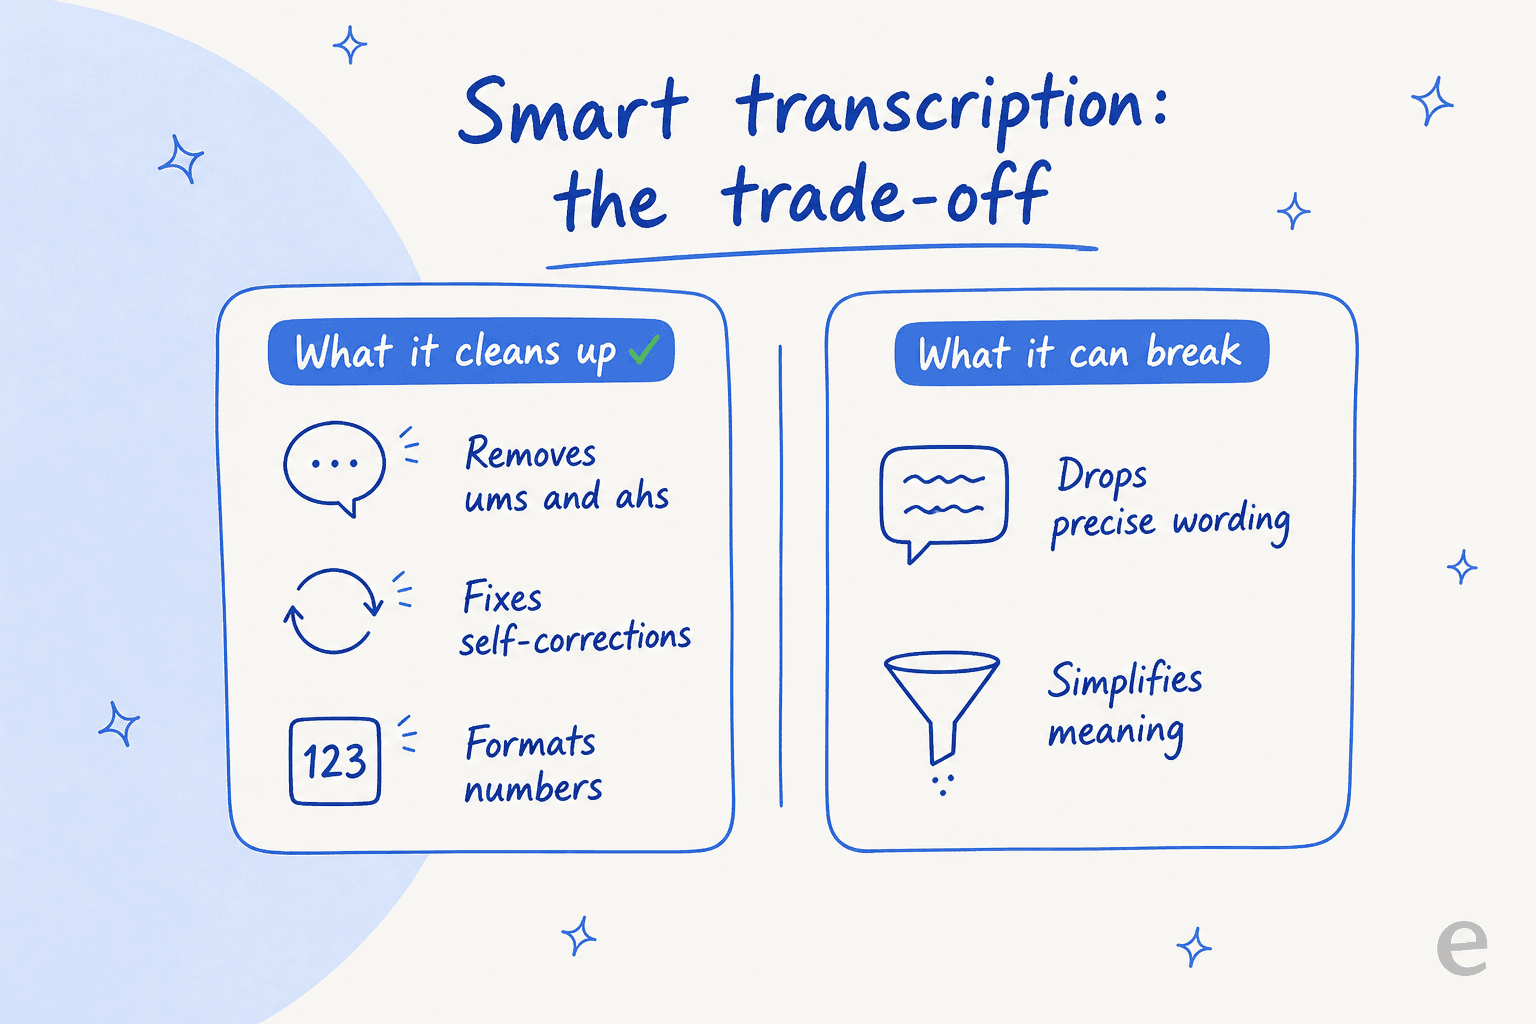
Según la publicación de lanzamiento, maneja autocorrecciones ("let's meet Tuesday, no, Wednesday" se convierte en "Wednesday"), elimina muletillas y formatea con inteligencia las cadenas alfanuméricas. Para dictar un correo o pulir notas de reuniones, es justo lo que las herramientas de dictado independientes cobran aparte, así que tenerlo en el modelo base es una ventaja real.
El problema es que "limpiar" es una decisión de criterio, y el modelo no siempre comparte el tuyo. Un desarrollador que lo probó en un Pixel 11 Pro lo dijo sin rodeos:
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."
Así que el modelo mental para una decisión de compra es este: Smart transcription es una función, no una transcripción neutral. Para todo lo que dependa de las palabras exactas (legal, investigación, cumplimiento, medicina), es un compromiso real que sopesar, no una nota al pie. Es lo que más querría probar con mi propio audio antes de confiar en este modelo.
La diarización se atasca con más de tres hablantes
La segunda queja recurrente es el manejo de varios hablantes, y si transcribes reuniones, esta es la que debes vigilar. La documentación de Google indica dos límites distintos: la página del modelo dice que el modelo de archivos admite "up to 8 speakers (Attribution for 3+ speakers is experimental)", mientras que el blog de lanzamiento dice "up to three". El techo fiable hoy es tres, y planificaría con esa cifra. El modelo de streaming en vivo no tiene diarización, ya que prioriza la baja latencia.
Esa brecha apareció con fuerza en las pruebas:
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
Si tu caso de uso es una llamada de soporte entre dos personas o una nota de voz de un solo hablante, esto no te afecta. Si es una reunión diaria de seis personas, es una limitación real, y es de esas cosas que una hoja de especificaciones te deja pasar por alto hasta que llevas tres semanas de desarrollo.
Precios: aquí es donde gana
Google no incluyó precios en el anuncio del modelo, lo que molestó tanto a los desarrolladores que uno mismo los publicó en Hacker News. Este es el panorama real según la página de precios:
| Modelo | Entrada de audio | Salida de texto | Tarifa combinada |
|---|---|---|---|
gemini-3.5-transcribe (archivo) | 2,00 $ / 1 M de tokens (~0,003 $/min) | 12,00 $ / 1 M de tokens (~0,002 $/min) | ~0,005 $ / min |
gemini-3.5-transcribe-live (streaming) | 3,50 $ / 1 M de tokens (~0,005 $/min) | 21,00 $ / 1 M de tokens (~0,004 $/min) | ~0,009 $ / min |
Como comparación, el reconocimiento estándar de Cloud Speech-to-Text v2 de Google empieza en 0,016 $/min, mientras que su nivel de lote dinámico cuesta 0,003 $/min. Así que el nuevo modelo de archivos queda claramente por debajo del reconocimiento estándar en tiempo real y justo por encima de la opción por lotes más barata. Al hacer las cuentas, compara lo comparable: tiempo real con tiempo real, lote con lote.
Para hacerlo concreto, introduce tu propio volumen:
Un ejemplo práctico: un equipo pequeño que transcribe 200 horas de llamadas de soporte al mes paga aproximadamente 60 $ con el modelo de archivos frente a unos 192 $ con Cloud Speech-to-Text estándar. Es un ahorro real, pero no cambia la vida a esa escala, y sinceramente la pregunta de costo más grande suele ser qué haces con las transcripciones después, no la transcripción en sí. Más sobre eso abajo.
Cómo se compara con Whisper, Deepgram y Scribe
Quiero ser cuidadoso aquí, porque una comparación justa cara a cara necesita las cifras propias de cada proveedor, y la posición honesta es que las pruebas A/B reales las están haciendo los usuarios, no yo. Así que en lugar de una tabla de especificaciones que no puedo respaldar del todo, esto es lo que encontraron las personas que de verdad comparan estos modelos.
En cuanto al costo, la reacción se dividió casi por la mitad. Un desarrollador que gestiona whispermemos.com hizo las cuentas y quedó impresionado:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
Otros no estaban convencidos de que la precisión se acerque lo suficiente:
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
Y Whisper sigue teniendo seguidores leales, en parte porque es gratis de alojar por cuenta propia y en parte porque los equipos ya construyeron pipelines a su alrededor. El patrón más común que vi fue el híbrido: Whisper para marcas de tiempo de palabras precisas, luego un modelo Gemini para el texto en sí. En resumen, Gemini 3.5 Transcribe es una opción gestionada sólida y bien tarifada, no un ganador automático frente a las herramientas ASR especializadas. Cuál gane depende de tu audio y de si necesitas diarización fiable.
El veredicto: para quién es
Resumiendo, esto es donde aterrizo tras la investigación:
| Gemini 3.5 Transcribe | |
|---|---|
| Puntos fuertes | Precio bajo (~0,005 $/min archivo), 2,6 % de error en inglés, diarización + marcas de tiempo integradas, más de 85 idiomas, API gestionada |
| Puntos débiles | Smart transcription puede reescribir redacciones precisas, diarización poco fiable con más de 3 hablantes, sin nivel batch/Flex, la documentación se contradice sobre el estado y el límite de hablantes |
| Ideal para | Dictado, notas de voz de un solo hablante, transcripción sensible al costo a gran escala |
| Busca otra opción si | Necesitas salida literal, reuniones con 4+ hablantes o el costo por lotes más bajo posible |
La decisión depende realmente de tu audio:
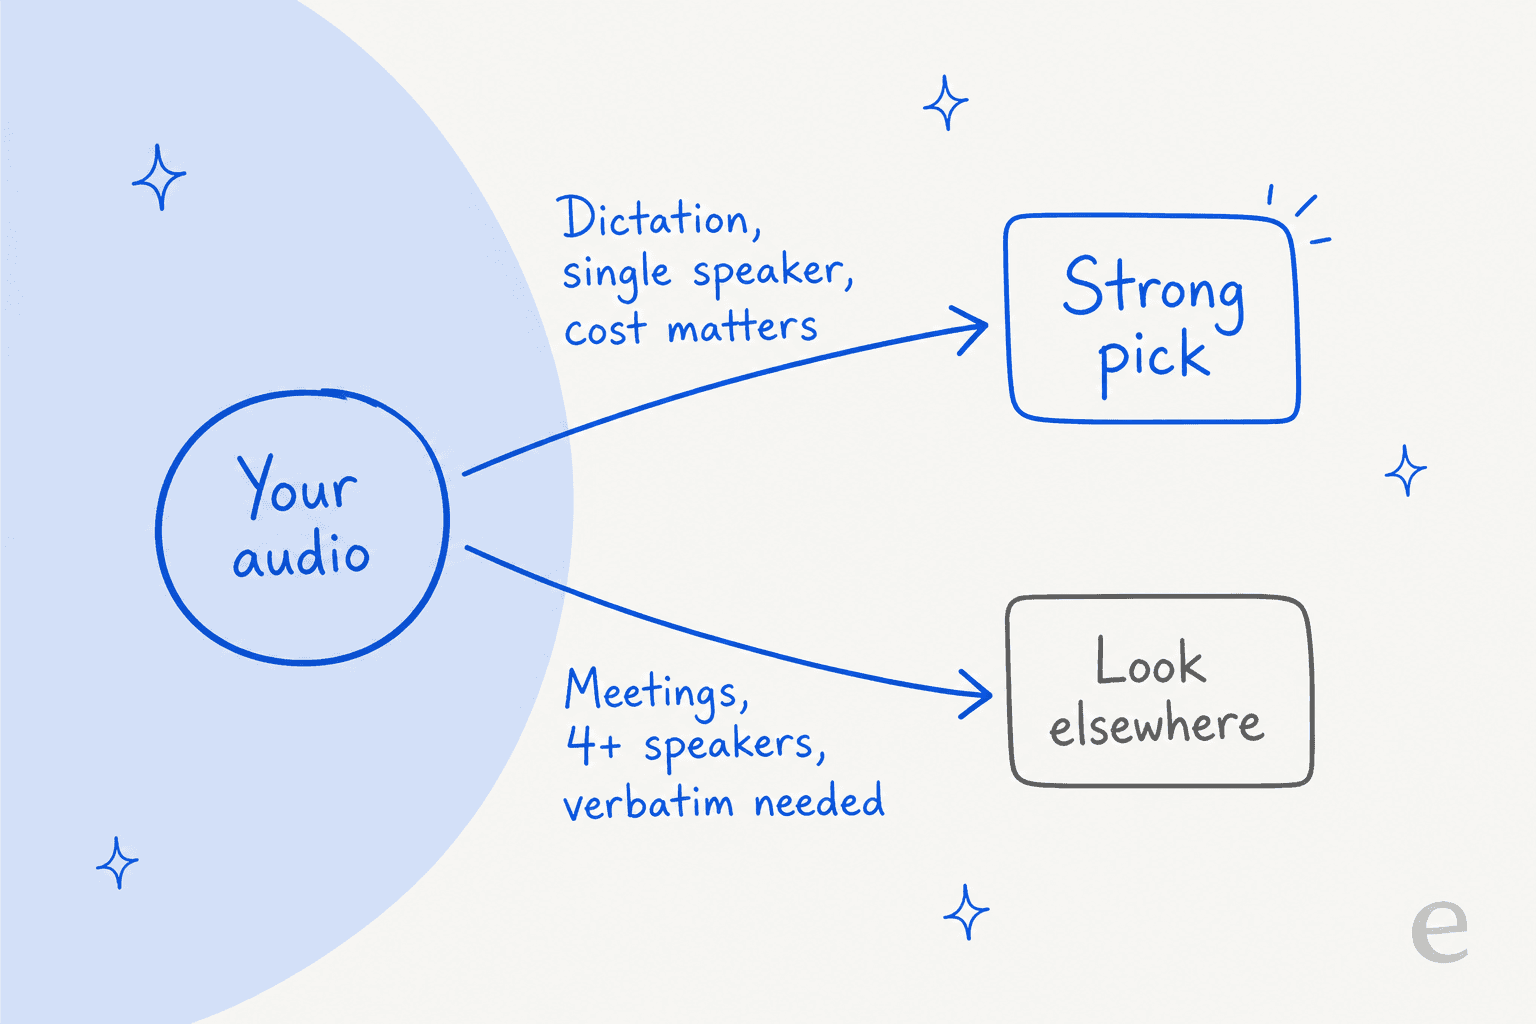
Si estuviera lanzando una función de dictado o transcribiendo una cola de notas de voz de un solo hablante, lo elegiría encantado: el precio y la precisión en inglés son difíciles de superar para un modelo gestionado. Si estuviera construyendo notas de reunión para llamadas de seis personas, o cualquier cosa donde las palabras exactas tengan peso legal, probaría Deepgram o ElevenLabs Scribe junto a él antes de decidir, y no asumiría que las cifras del benchmark se trasladan a mi audio.
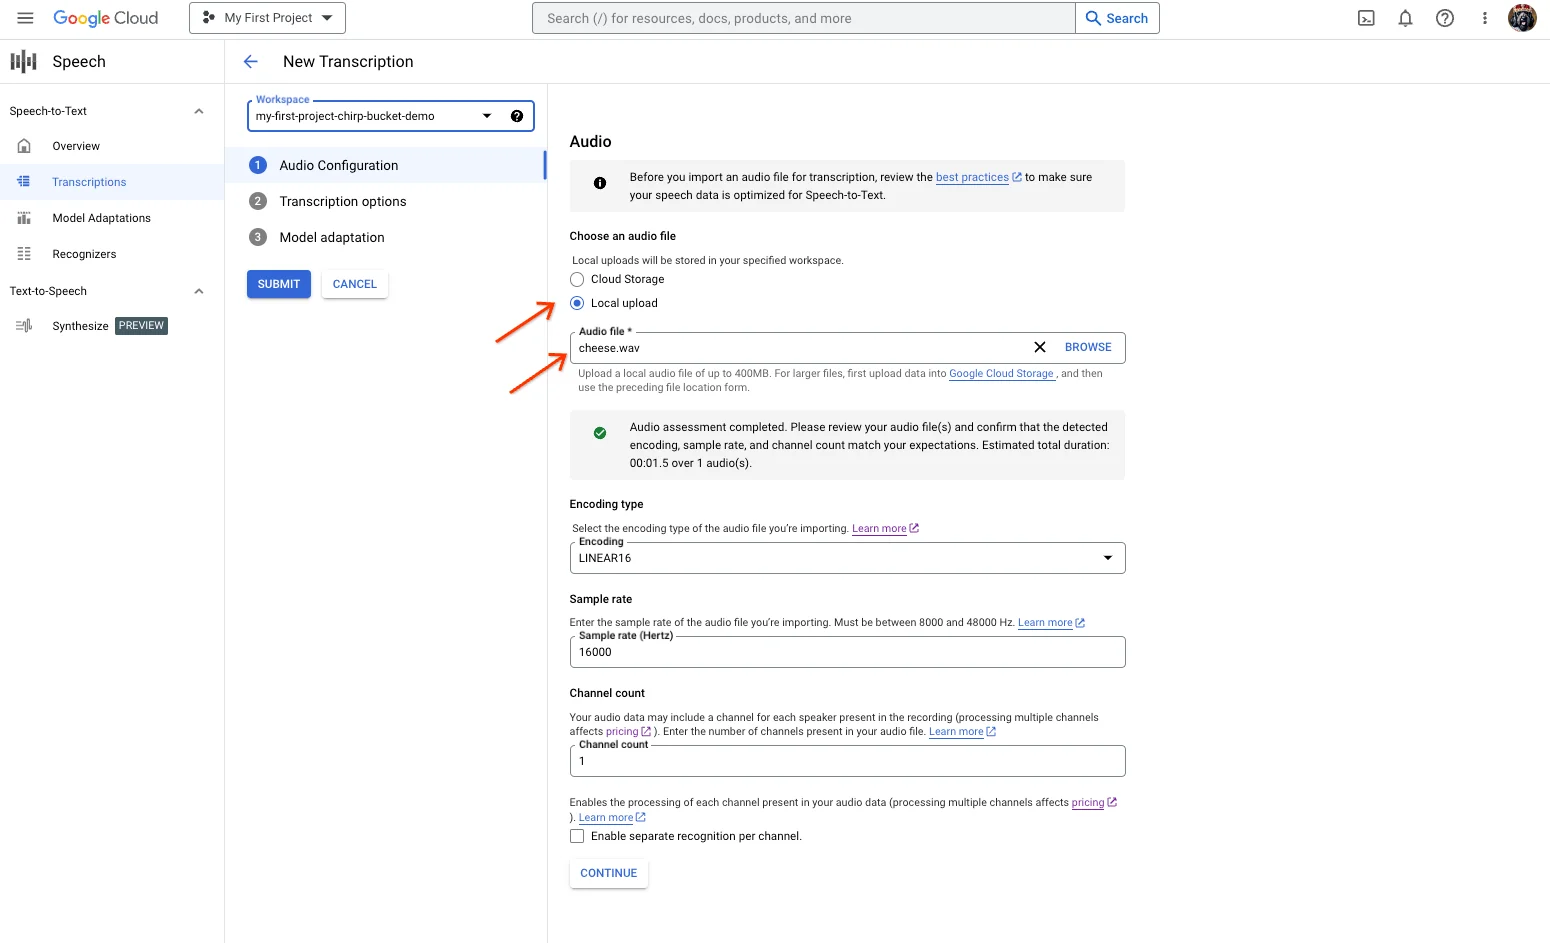
Como referencia, si has usado antes la consola de transcripción de Google Cloud, el flujo de subida de archivos te resultará familiar: apuntas al audio y eliges tus opciones:
Dónde encaja la transcripción para un equipo de soporte
Esto merece decirse con claridad, porque es la parte que una reseña puede pasar por alto: Gemini 3.5 Transcribe es infraestructura. Convierte audio en texto, y hace ese trabajo difícil bien. Pero la transcripción de una llamada o nota de voz de un cliente no es una respuesta, es solo el comienzo. Algo todavía tiene que leer ese texto, entender lo que necesita el cliente, obtener la información correcta y resolver realmente el ticket.
Esa capa de resolución es en lo que trabajo. He pasado los últimos años rodeado de IA que trabaja en colas de soporte reales, y el patrón nunca cambia: acertar con las palabras es lo mínimo; actuar correctamente sobre ellas es lo difícil. Un modelo de transcripción te da las palabras. No conoce tu política de reembolsos, tu sistema de pedidos ni los tres últimos tickets que abrió ese cliente.
Esa es la diferencia entre un modelo y un compañero de equipo. Gemini 3.5 Transcribe es un modelo, brillante en una tarea acotada. eesel es una plataforma de compañeros de IA: contratas compañeros de IA listos para trabajar en tareas específicas, y el equipo actual incluye un compañero de IA para el helpdesk y un redactor de blog con IA. El compañero de helpdesk se conecta al helpdesk que ya usas, Zendesk, Freshdesk, Gorgias, y se une a la cola existente, entrenado con tu centro de ayuda y tus tickets anteriores.
Prueba eesel con tickets de voz y chat
Si llegaste a una reseña de transcripción porque tu equipo se ahoga en tickets de voz o chat, recuerda que la transcripción es solo la mitad del trabajo. El compañero de IA para helpdesk de eesel continúa donde termina un modelo como Gemini 3.5 Transcribe: lee el mensaje del cliente, redacta o envía la respuesta y cierra el ciclo, a través de más de 1.000 integraciones.
Lo primero que señalaría es el modo de simulación. Antes de que cualquier IA toque a un cliente real, la ejecutas sobre miles de tus propios tickets históricos y ves exactamente cómo habría respondido, así que no activas un interruptor y esperas lo mejor: el mismo consejo de "pruébalo primero con tus datos" que daría para cualquier modelo de transcripción, integrado en el producto. El precio es una cuota mensual fija, desde 299 $/mes por 500 créditos (1 crédito por ticket o chat) sin cargos por asiento, y hay un plan gratuito con 100 créditos, sin tarjeta. Es la diferencia entre una transcripción inteligente de un problema y su resolución real.