

Resumen
Gemini 3.5 Transcribe es el primer modelo de voz a texto de Google con la marca Gemini, y es una opción gestionada sólida y bien tarifada, con unos 0,005 $ por minuto para el modelo de archivos y una tasa de error de palabras del 2,6 % en inglés limpio. Pero no es la elección automática, y dos cosas hacen que la gente busque otras opciones: la transcripción inteligente reescribe tus palabras exactas para "limpiarlas", y la diarización se vuelve inestable a partir de tres hablantes.
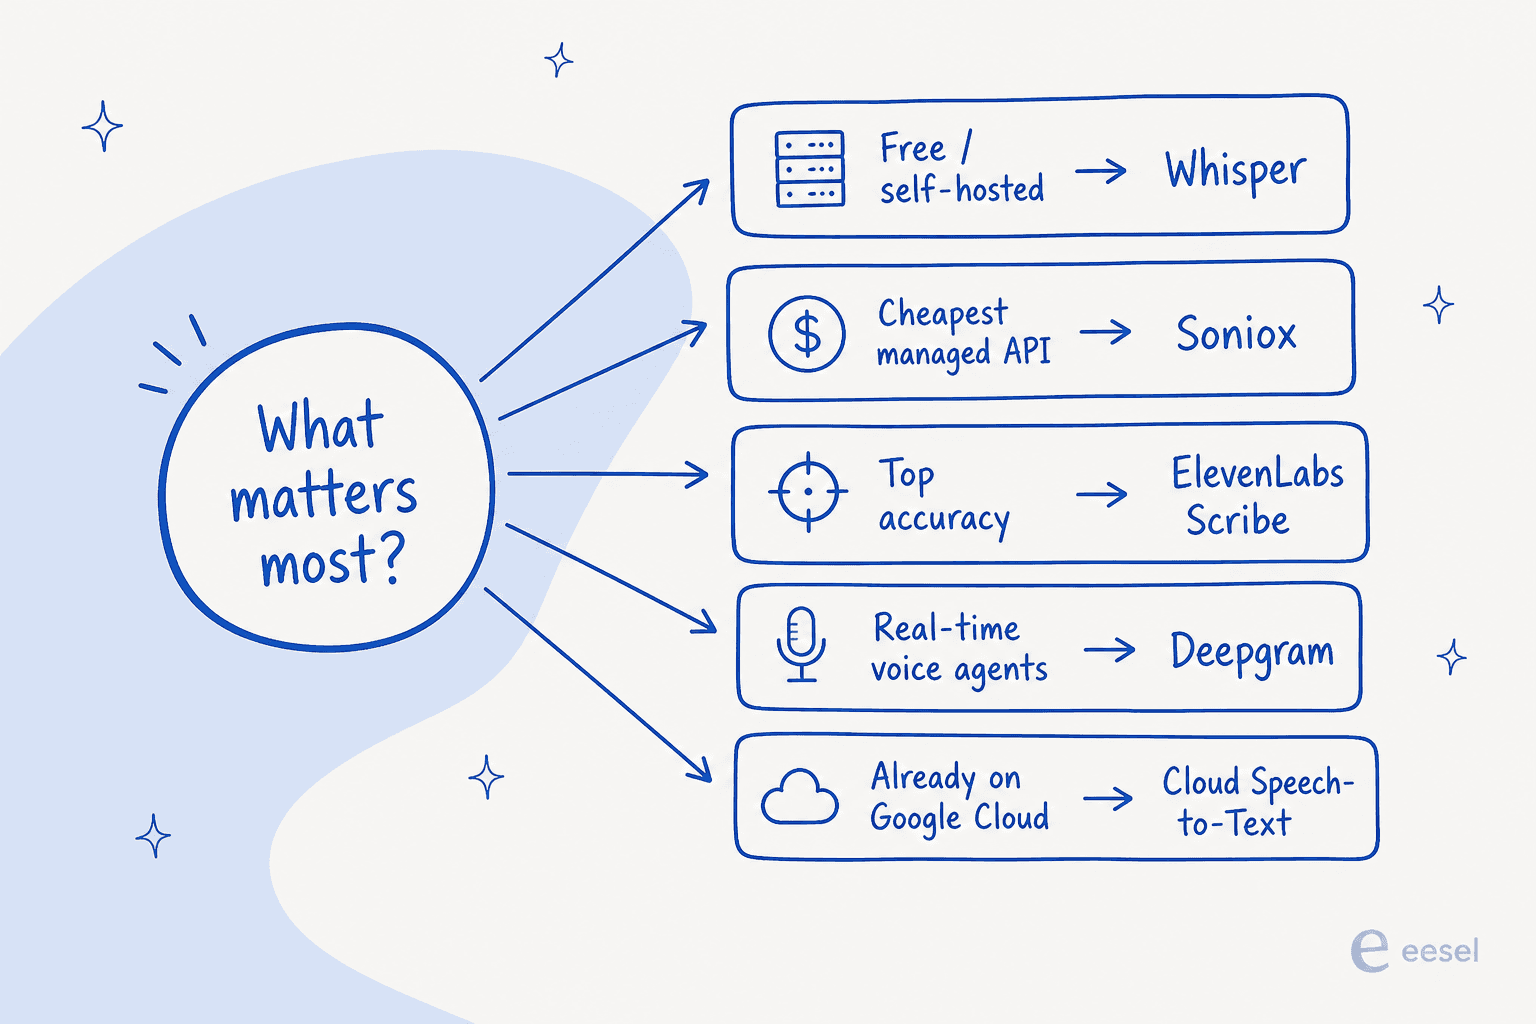
Si buscas una alternativa a Gemini 3.5 Transcribe, esto es lo que recomiendo según la necesidad:
- Gratuito y autoalojado: OpenAI Whisper (licencia MIT, lo ejecutas en tu propio hardware).
- API gestionada más barata: Soniox, unos 0,10 $ por hora con diarización y detección de idioma incluidas.
- Máxima precisión: ElevenLabs Scribe, precisión superior al 98 % y diarización de hasta 32 hablantes.
- Agentes de voz en tiempo real: Deepgram, el especialista en streaming de baja latencia.
- Ya en Google Cloud: Cloud Speech-to-Text (Chirp 3), con el nivel por lotes más barato, a 0,003 $ por minuto.
Algo que conviene decir desde el principio: la transcripción es solo la capa de entrada. Si eres un equipo de soporte que convierte voz y chat en tickets, la transcripción es la mitad fácil. Resolver de verdad el ticket es la parte difícil, el trabajo de un compañero de IA para el helpdesk que un modelo de transcripción no puede hacer.
Por qué mirar más allá de Gemini 3.5 Transcribe
Primero, siendo justos: Gemini 3.5 Transcribe es un modelo muy bueno. Es el sucesor de Chirp 3 de Google, informa de una tasa de error de palabras del 2,6 % en inglés sin streaming, detecta automáticamente más de 85 idiomas y, a unos 0,005 $ por minuto para el modelo de archivos, es más barato que el nivel estándar del propio Cloud Speech-to-Text de Google. Para dictado con un solo hablante, es difícil de superar. Lo analicé a fondo en mi reseña de Gemini 3.5 Transcribe.
Entonces, ¿por qué cambiar? Tres razones concretas aparecen una y otra vez.
La transcripción inteligente reescribe tus palabras. Es la función en la que Google más insiste, y también la queja más común. La transcripción inteligente elimina muletillas y autocorrecciones y reformatea sobre la marcha, lo cual es genial para dictar un correo y un problema real cuando importa la redacción exacta. Un desarrollador que la probó comprobó que "simplificaba" una frase y rompía el significado, eliminando la primera mitad de una cláusula precisa en pruebas repetidas. Para trabajo legal, médico, de investigación o de cumplimiento normativo, eso es un impedimento definitivo, no una nota al pie.
La diarización se atasca a partir de tres hablantes. La documentación de Google no se pone de acuerdo consigo misma: la página del modelo dice hasta 8 hablantes con "3+ experimental", mientras que el blog de lanzamiento dice hasta tres. La cifra fiable hoy es tres, y el modelo de streaming en vivo no hace diarización en absoluto. Si transcribes reuniones de seis personas, es un límite duro.
En realidad no es el más barato. A unos 0,30 $ por hora para el modelo de archivos, Gemini está en la parte alta del mercado. Varios especialistas lo superan en precio, y algunos incluyen la diarización y la detección de idioma, que Gemini no cobra aparte pero que otros desglosan. Así se ve:
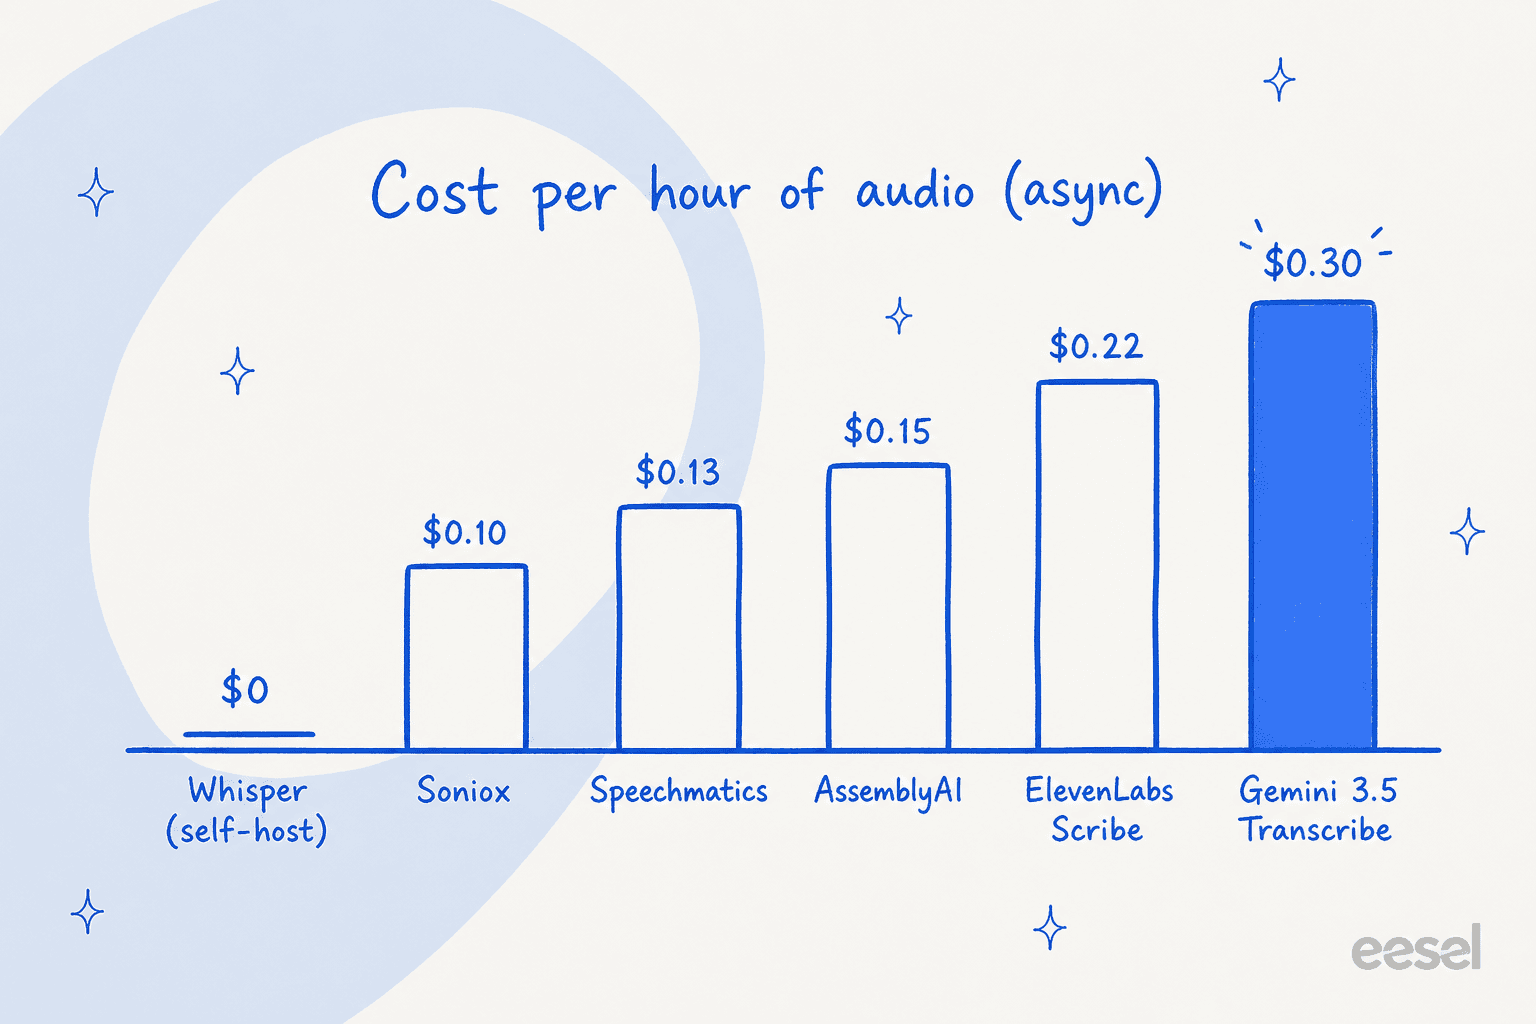
Nada de esto convierte a Gemini en un mal modelo. Solo significa que la elección correcta depende de tu audio, y para muchos casos reales, una de las alternativas siguientes encaja mejor.
Cómo las comparé
Juzgué cada alternativa según las dimensiones que realmente cambian una decisión de desarrollo: coste real por hora (no el precio de cartel), si la diarización y la detección de idioma van incluidas o se cobran como extras, cobertura de idiomas, si hay modo de streaming en tiempo real y el nivel gratuito con el que puedes probar. Leí los precios y la documentación de cada proveedor y me apoyé en desarrolladores que ejecutan estos modelos lado a lado, porque un resultado limpio de benchmark y tu resultado en el mundo real pueden ser mundos distintos.
Esta es la tabla resumen antes de los análisis detallados. Todos los precios son las tarifas públicas de pago por uso del propio proveedor para transcripción asíncrona (de archivos), salvo que se indique lo contrario.
| Herramienta | Precio asíncrono | Streaming | Idiomas | Diarización | Nivel gratuito | Ideal para |
|---|---|---|---|---|---|---|
| Whisper | 0 $ (autoalojado) | Lo construyes tú | 99 | Librerías adicionales | Pesos abiertos | Control, sin tarifa por minuto |
| Deepgram | ~0,29 $/h (Nova-3) | Sí | 30+ | +0,0020 $/min | 200 $ de crédito | Agentes de voz en tiempo real |
| AssemblyAI | 0,15 $/h (Universal-2) | Sí | 99 | +0,02 $/h | Pago por uso gratuito | Inteligencia de audio |
| ElevenLabs Scribe | 0,22 $/h | 0,39 $/h | 90+ | Hasta 32 hablantes | Nivel gratuito | Máxima precisión, muchos hablantes |
| Speechmatics | desde 0,129 $/h | desde 0,24 $/h | 55+ | Incluida | 100 $ de crédito | Acentos y dialectos |
| Soniox | ~0,10 $/h | ~0,12 $/h | 60+ | Incluida | Crédito gratuito | La API gestionada más barata |
| Cloud Speech-to-Text | 0,003 $/min (por lotes) | 0,016 $/min | 125+ | Incluida | 300 $ de crédito de GCP | Equipos que ya usan GCP |
| Rev AI | 0,20 $/h | Sí | 57+ | Incluida | Prueba gratuita | Precisión con acentos, HIPAA |
| Gemini 3.5 Transcribe | ~0,30 $/h | ~0,54 $/h | 85+ | Hasta 3 hablantes | Nivel gratuito | Dictado con un solo hablante |
1. OpenAI Whisper
Ideal para: equipos que quieren control total, sin dependencia de tarifas por minuto, o un punto de partida gratuito.
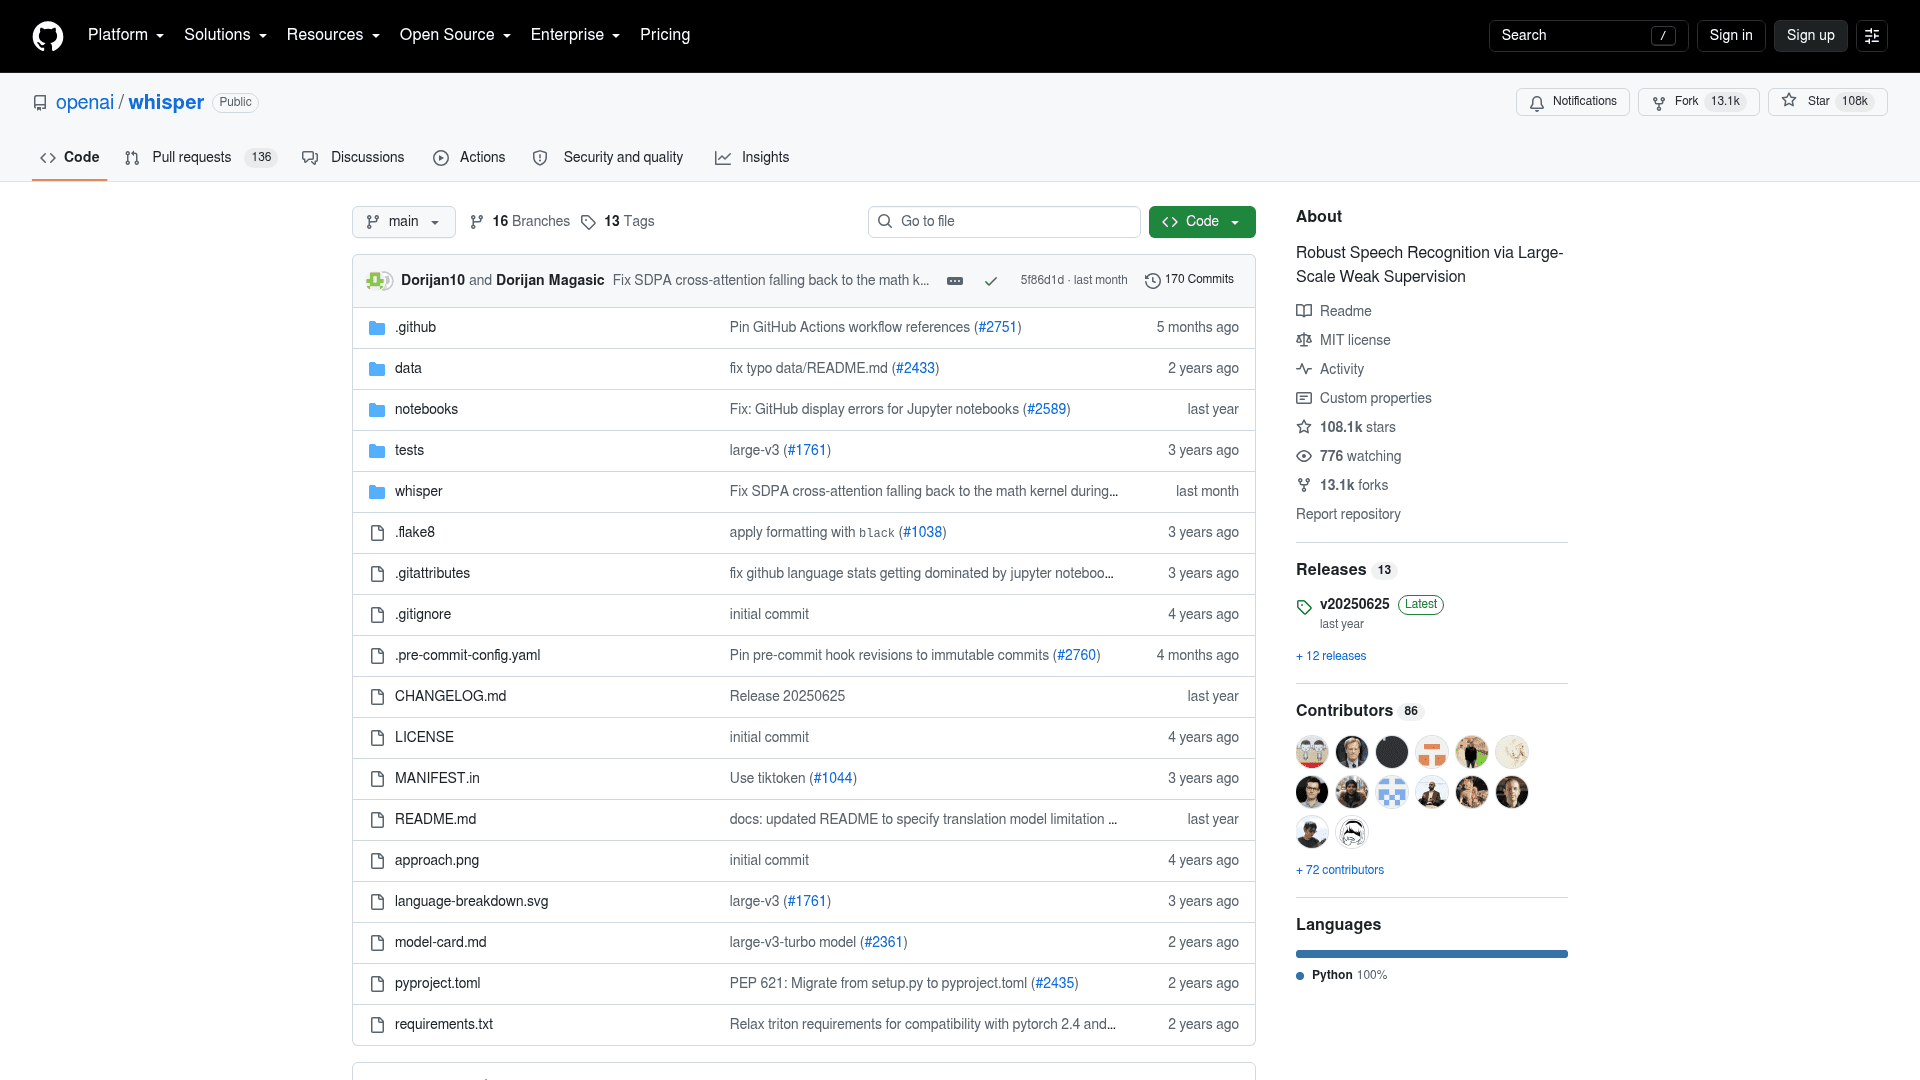
Whisper es el modelo que cambió las expectativas del reconocimiento de voz abierto. Tiene licencia MIT, más de 108.000 estrellas en GitHub y se describe como "Robust Speech Recognition via Large-Scale Weak Supervision". Como los pesos son abiertos, puedes ejecutarlo en tu propio hardware por el coste del cómputo, sin factura por minuto de API y sin que los datos salgan de tu infraestructura. Este último punto es la razón por la que tantos equipos sensibles a la privacidad empiezan aquí.
Sigue siendo un favorito de la comunidad por buenos motivos:
"Whisper Large-v3 is still the most stable open model across diverse domains. Great accuracy, predictable output, and decent handling of accents."

Ventajas: Gratuito si lo autoalojas, pesos abiertos, sólida precisión multilingüe, enorme ecosistema de herramientas y ajustes finos, funciona totalmente sin conexión.
Desventajas: Autoalojarlo es trabajo de ingeniería real (GPUs, procesamiento por lotes, escalado). La diarización y las marcas de tiempo por palabra no vienen incluidas, así que hay que añadir librerías extra. Whisper también es conocido por inventar texto en segmentos silenciosos o ruidosos. Si prefieres no gestionar infraestructura, la API gestionada GPT-Transcribe de OpenAI cuesta unos 0,0045 $ por minuto (aprox. 0,27 $ por hora) en modo asíncrono y 0,017 $ por minuto en streaming en vivo.
Veredicto: Whisper es la opción por defecto para quien valora el control y el coste por encima de la comodidad. Si tienes la capacidad de ingeniería para alojarlo, es prácticamente gratuito y privado. Si no, los endpoints gestionados de OpenAI te dan el mismo linaje sin la carga operativa. Muchos equipos usan un híbrido: Whisper para las marcas de tiempo por palabra y un modelo de chat para corregir el texto.
2. Deepgram
Ideal para: agentes de voz en tiempo real y streaming de baja latencia a gran escala.
Deepgram es el especialista en ASR creado para la velocidad. Impulsa la infraestructura de voz de empresas como Twilio, Cloudflare y Vapi, y toda su arquitectura está ajustada para streaming de baja latencia, justo lo que necesita un agente de voz en vivo. Su actual modelo Nova-3 cuesta 0,0048 $ por minuto en streaming monolingüe (unos 0,29 $ por hora), con 200 $ de crédito gratuito para empezar.
Los desarrolladores que comparan el sector tienden a ver a Deepgram como el rápido más que como el más preciso:
"AssemblyAI and Speechmatics too, who both have much greater accuracy - especially in real-time for Speechmatics. Deepgram are only fastest at..."
Ventajas: Excelente latencia de streaming, enorme concurrencia, autoalojamiento para sectores regulados y una tarifa clara por minuto.
Desventajas: Los extras se acumulan: la diarización de hablantes cuesta 0,0020 $ más por minuto, y la redacción de datos sensibles y el keyterm prompting cuestan aún más. Su precisión bruta con audio difícil queda por detrás de los líderes en precisión en algunas pruebas de usuarios.
Veredicto: Si estás creando voz en tiempo real, Deepgram es el primer nombre de la lista. Es lo más parecido al caso de uso de Gemini 3.5 Transcribe Live, y trata el streaming como ciudadano de primera en lugar de un compromiso de baja latencia. Para trabajo por lotes con archivos donde la precisión importa más que la velocidad, lo probaría frente a AssemblyAI o Scribe antes de decidirme.
3. AssemblyAI
Ideal para: equipos que quieren transcripción más inteligencia de audio en una sola API.
AssemblyAI combina una transcripción sólida con un amplio conjunto de funciones de "inteligencia de audio": sentimiento, detección de temas, resúmenes y protecciones de seguridad, todo desde la misma API. Su modelo Universal-2 cuesta 0,15 $ por hora en 99 idiomas, y el más nuevo Universal-3.5 Pro, a 0,21 $ por hora, añade cambio de código nativo y su diarización más precisa hasta ahora en 18 idiomas. AssemblyAI afirma una mayor precisión de palabras que Whisper, 94,1 % frente a 92,4 %.
Ventajas: Alta precisión en archivos, cobertura de 99 idiomas con Universal-2, una capa de inteligencia útil para el trabajo con tickets de soporte y precios por hora de autoservicio con nivel gratuito.
Desventajas: Los extras se miden: la diarización de hablantes suma 0,02 $ por hora y el keyterm prompting suma 0,05 $ por hora en el modelo Pro. El nivel superior Universal-3.5 Pro se limita a 18 idiomas, así que el trabajo multilingüe amplio se queda en Universal-2.
Veredicto: AssemblyAI es la elección cuando quieres más que una transcripción en bruto. Si tu producto necesita resumir llamadas, marcar sentimiento o extraer temas, hacerlo en una sola llamada es mejor que unir un modelo de transcripción con un paso LLM aparte. En precisión pura está a la altura de los líderes, y el nivel gratuito de pago por uso facilita compararlo con tu propio audio.
4. ElevenLabs Scribe
Ideal para: la máxima precisión y audio con muchos hablantes.
ElevenLabs se hizo un nombre en la generación de voz, pero Scribe es un modelo de voz a texto serio por derecho propio. Anuncia una precisión superior al 98 %, más de 90 idiomas y la cifra destacada, diarización de hasta 32 hablantes, un orden de magnitud por encima de los tres de Gemini. Scribe v1 y v2 cuestan 0,22 $ por hora, con un modelo en tiempo real, Scribe v2 Realtime, a 0,39 $ por hora y unos 150 ms de latencia.
Su relación entre precio y precisión es lo que conquista a la gente. Un desarrollador que se dedica a transcribir hizo las cuentas frente a Gemini:
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."

Ventajas: Líder en precisión con audio limpio, diarización que de verdad escala a reuniones grandes, amplia cobertura de idiomas y una opción en tiempo real.
Desventajas: Más caro por hora que Soniox, Speechmatics o el nivel base de AssemblyAI. La voz a texto es un producto dentro de una empresa de generación de voz, así que la documentación y la comunidad se inclinan hacia TTS.
Veredicto: Si tu listón es "acertar exactamente las palabras, incluso con una sala llena de gente hablando", empezaría por Scribe. Solo la diarización de 32 hablantes lo convierte en la respuesta obvia para transcribir reuniones y paneles, justo donde Gemini 3.5 Transcribe más sufre.
5. Speechmatics
Ideal para: amplia cobertura de acentos y dialectos, y despliegues empresariales.
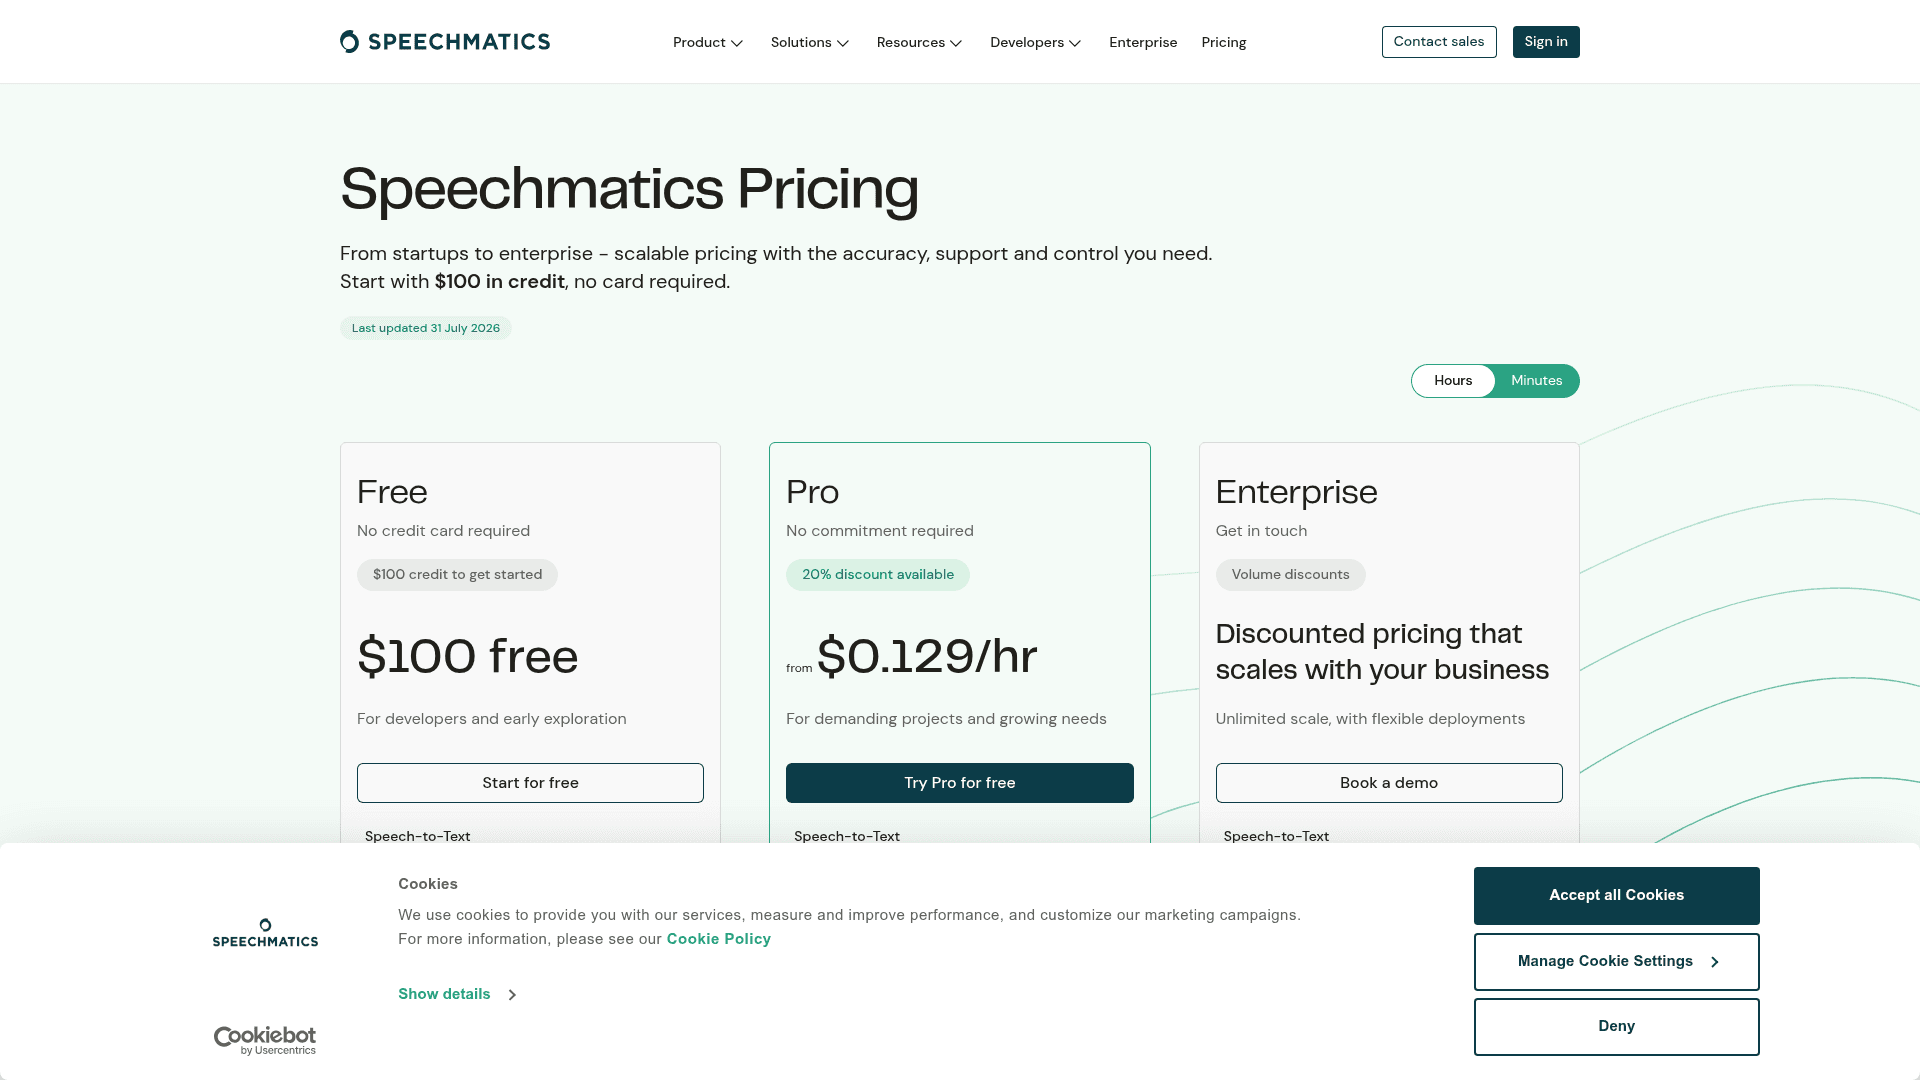
Speechmatics es el especialista en precisión y acentos. Cubre más de 55 idiomas y dialectos y presume de transcribir con precisión a "over 4 billion people", el tipo de cobertura de acentos que importa si tus llamantes no hablan todos un mismo acento estándar. Su nivel por lotes Melia 1 empieza en 0,129 $ por hora, con un nivel estándar en tiempo real a 0,24 $ por hora, 100 $ de crédito gratuito y un 20 % de descuento por encima de 500 horas al mes.
Los usuarios en el debate sobre precisión lo nombran sistemáticamente entre los primeros, especialmente en tiempo real, que es el problema más difícil.
Ventajas: Gran manejo de acentos y dialectos, precios por lotes competitivos, diarización incluida en lugar de cobrarse aparte y despliegue on-premise para empresas.
Desventajas: La estructura de niveles (Melia 1, Standard, Enhanced, en lotes y tiempo real) lleva un rato entenderla. El nivel Melia 1, el más barato, es donde se sitúan los 0,129 $ del titular, así que lee el nivel antes de presupuestar.
Veredicto: Speechmatics es el que elegiría cuando el audio es lingüísticamente desordenado: acentos mezclados, dialectos, grabaciones reales de centros de llamadas. Si la transcripción inteligente de Gemini está "corrigiendo" discretamente la forma de hablar de alguien que necesitabas conservar, un modelo centrado en el manejo fiel de acentos es la apuesta más segura.
6. Soniox
Ideal para: la API gestionada más barata con funciones incluidas.
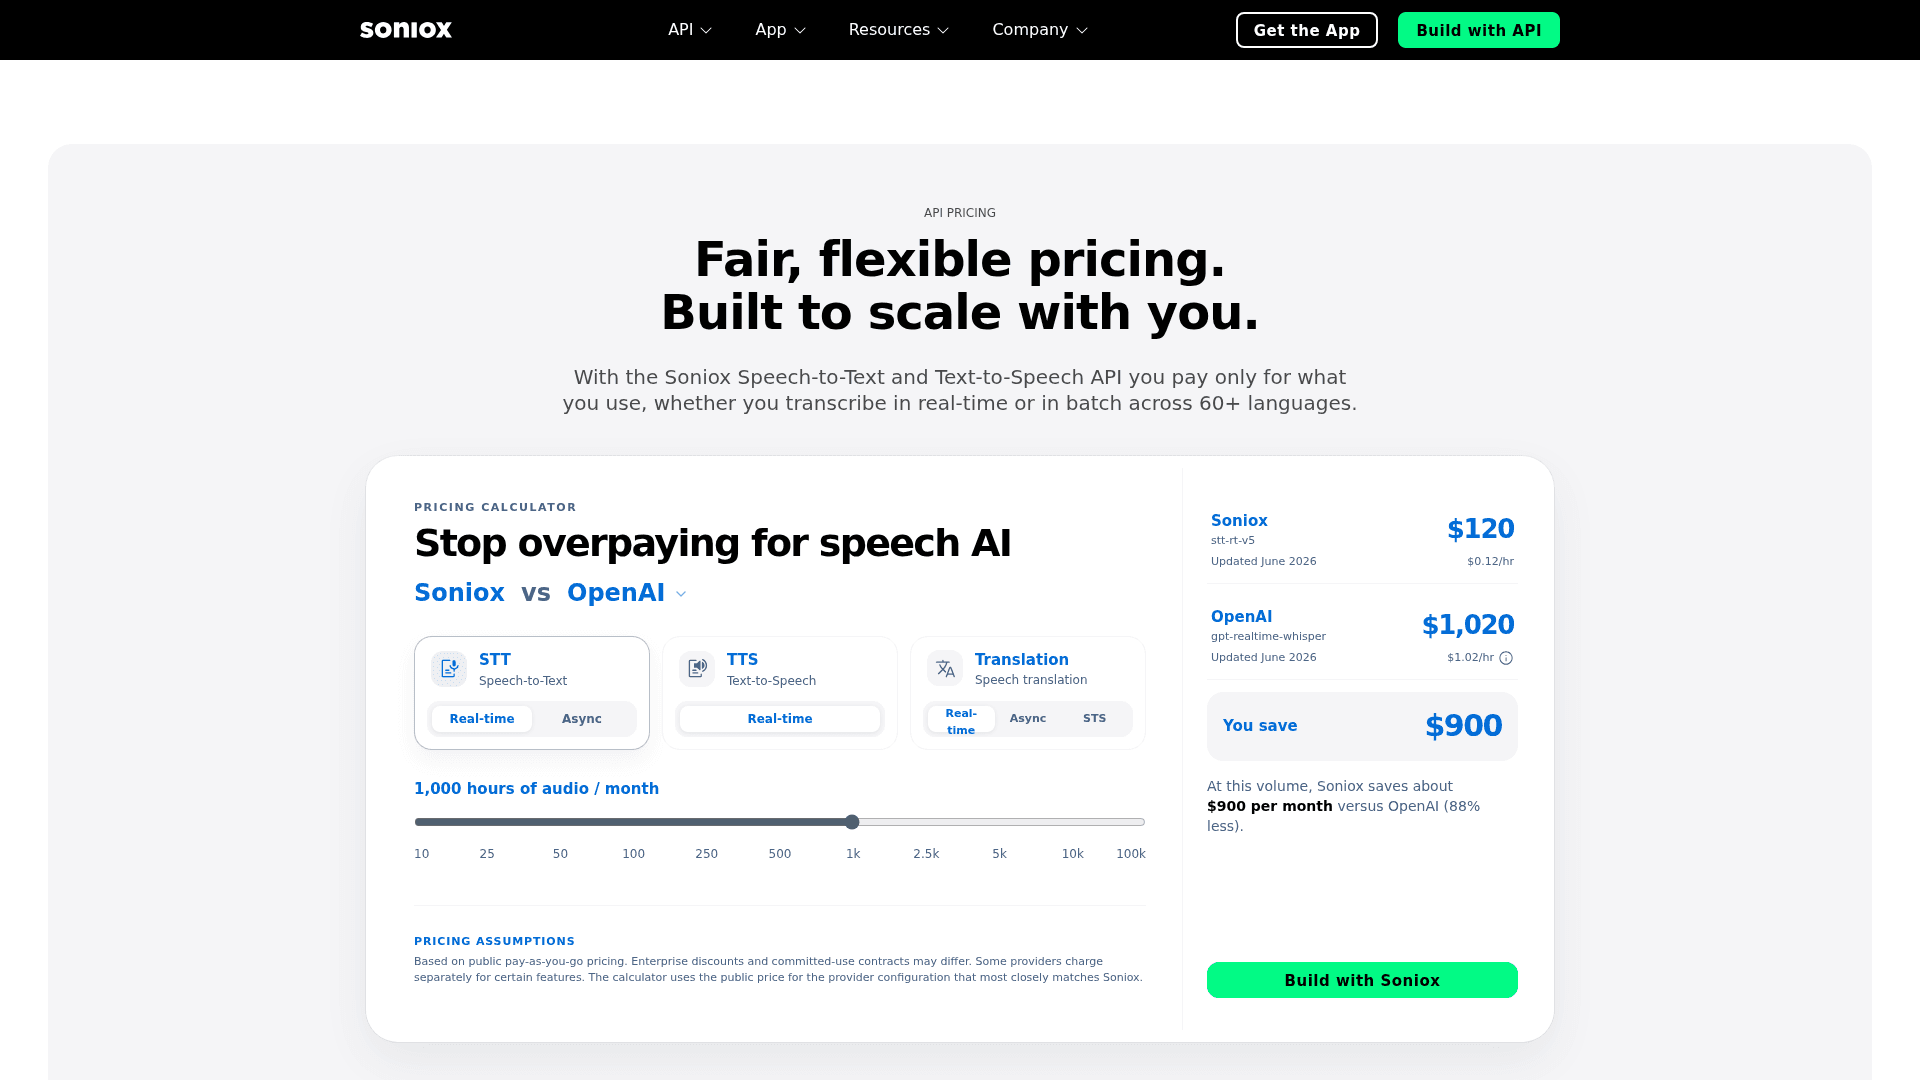
Soniox es la apuesta por el valor, y no lo disimula. La voz a texto cuesta unos 0,10 $ por hora en modo asíncrono y 0,12 $ por hora en tiempo real, en más de 60 idiomas. Lo que lo distingue no es solo la cifra: la diarización de hablantes, la identificación de idioma, el formato inteligente e incluso la traducción están incluidos en esa tarifa por hora en lugar de cobrarse como extras. Soniox presume de ser unas 4,5 veces más barato que Google y 8 veces más barato que Azure en tiempo real.
Ventajas: El precio gestionado más bajo de esta lista, todo incluido (sin recargo por diarización ni detección de idioma), tiempo real y lotes con el mismo modelo, y traducción en más de 60 idiomas en la misma llamada.
Desventajas: Es un nombre más pequeño y nuevo que Deepgram o Google, así que tiene menos pruebas comparativas de terceros y menos reconocimiento de marca. Conviene probarlo con tu propio audio en lugar de fiarte de las cuentas del marketing.
Veredicto: Para transcripción sensible al coste y en volumen, Soniox es la mejor oferta de esta lista. Incluir diarización y traducción en una tarifa plana de 0,10 $ por hora es una ventaja real frente a Gemini y Deepgram, que cobran esas funciones por separado. Si la precisión se mantiene con tus grabaciones, el ahorro se acumula rápido a escala.
7. Google Cloud Speech-to-Text (Chirp 3)
Ideal para: equipos que ya están en Google Cloud y el nivel por lotes más barato.
Este es el caso interesante: el Cloud Speech-to-Text de Google es el modelo al que Gemini 3.5 Transcribe debía suceder, y sigue muy vivo. Su modelo base Chirp 3 admite más de 125 idiomas, y los precios van desde 0,016 $ por minuto para reconocimiento estándar hasta 0,003 $ por minuto para dynamic batch, la tarifa por lotes más barata de toda esta comparación. Los clientes nuevos también reciben 300 $ en créditos de Google Cloud.
Ventajas: El nivel por lotes grande más barato, a 0,003 $ por minuto, la cobertura de idiomas más amplia, integración profunda con el resto de Google Cloud y herramientas de nivel empresarial.
Desventajas: El reconocimiento estándar en tiempo real, a 0,016 $ por minuto, es más caro que el propio modelo de archivos de Gemini. Hay más sobrecarga de configuración que con un único endpoint limpio, y Google claramente está orientando el trabajo nuevo hacia Gemini 3.5 Transcribe.
Veredicto: Si tu stack ya vive en Google Cloud, o ejecutas grandes trabajos por lotes donde 0,003 $ por minuto gana, Chirp 3 es una elección perfectamente racional, a veces más barata que el nuevo y brillante modelo Gemini. Solo compara lo comparable: lotes con lotes, tiempo real con tiempo real.
8. Rev AI
Ideal para: precisión con distintos acentos, cumplimiento de HIPAA y una opción humana de respaldo.
Rev AI viene de Rev, la empresa de transcripción humana, y se apoya en esa herencia: sus modelos están entrenados con más de 7 M de horas de voz verificada por humanos, y promueve la equidad entre "ethnic background, nationality, gender, and accent". Cubre más de 57 idiomas, cuenta con SOC 2, HIPAA, GDPR y PCI con un 99,99 % de disponibilidad, y cobra la transcripción automática a 0,20 $ por hora, un modelo turbo a 0,10 $ por hora y transcripción humana a 1,99 $ por minuto cuando necesitas a una persona en el proceso.
Ventajas: Precisión constante con distintos acentos y audio difícil, una sólida postura de cumplimiento para sectores regulados y la opción de escalar a transcripción humana para los archivos más difíciles.
Desventajas: La marca sigue siendo más conocida por la transcripción humana, así que la API para desarrolladores recibe menos atención de la comunidad que Deepgram o AssemblyAI. El streaming y los modelos premium quedan por encima de las tarifas base de 0,10 a 0,20 $.
Veredicto: Rev AI es la elección cuando el cumplimiento y la equidad entre voces son innegociables, o cuando ocasionalmente necesitas una transcripción de calidad humana para un archivo crítico. La cobertura de HIPAA y la vía de escalado a humanos son cosas que la mayoría de los proveedores solo de modelos no pueden ofrecer, lo que lo hace una opción natural para flujos de trabajo sanitarios y legales.
Cómo elegir de verdad
La respuesta honesta es que no hay un único ganador, solo el encaje adecuado para tu audio. Tras revisar los ocho, este es el camino más corto hacia una decisión:
Dos reglas prácticas de observar a quienes construyen sobre estos modelos. Primero, prueba siempre dos o tres con tus propias grabaciones antes de comprometer un pipeline. El WER de los benchmarks y el WER de tu audio con ruido, acentos y voces superpuestas son cosas muy distintas, un punto en el que también insisto en la reseña de Gemini 3.5 Transcribe. Segundo, cuenta los extras. Una tarifa de cartel que excluye diarización y detección de idioma no es comparable con una que los incluye, y por eso Soniox a una tarifa plana de 0,10 $ por hora puede superar a un modelo "más barato" cuando activas los extras.
Dónde termina la transcripción y empieza la resolución
Esta es la parte que un repaso de modelos sin más pasa por alto, y la que más me importa. Todas las herramientas de esta lista hacen el mismo trabajo: convierten audio en texto. Incluso la mejor, haciéndolo sin fallos, te entrega una transcripción. Y la transcripción de la llamada o la nota de voz de un cliente no es una respuesta, es el comienzo de una.
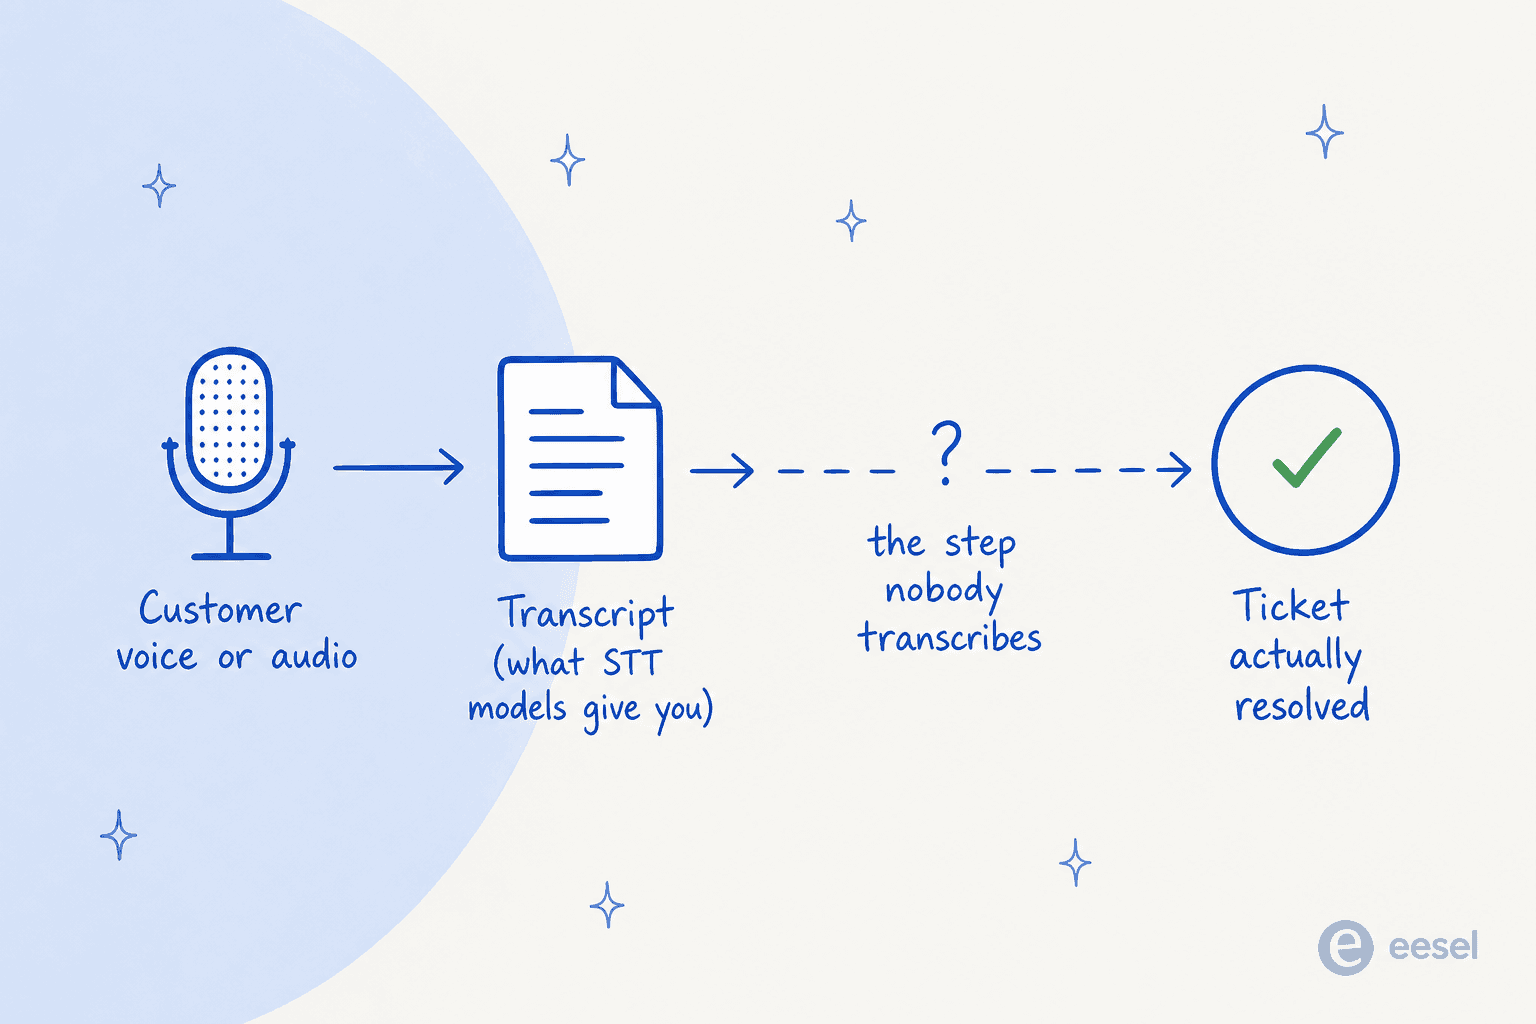
Algo todavía tiene que leer ese texto, entender qué necesita realmente el cliente, buscar la información correcta y resolver el ticket. Esa capa de resolución es en lo que trabajo. He pasado los últimos años en torno a IA que trabaja en colas de soporte en vivo, y el patrón nunca cambia: acertar con las palabras es lo mínimo, actuar sobre ellas correctamente es la parte difícil. Un modelo de transcripción te da las palabras. No conoce tu política de reembolsos, tu sistema de pedidos ni los últimos tres tickets que abrió ese cliente.
Esta es la diferencia entre un modelo y un compañero de equipo. Gemini 3.5 Transcribe, Whisper, Deepgram y los demás son modelos, brillantes en un trabajo muy concreto. eesel es una plataforma de compañeros de equipo: contratas compañeros de IA listos para trabajar en tareas específicas, y la plantilla actual incluye un compañero de IA para el helpdesk y un redactor de blog con IA. El compañero de helpdesk se conecta al helpdesk que ya usas, Zendesk, Freshdesk, Gorgias, y se une a la cola existente, entrenado con tu centro de ayuda y tus tickets anteriores.
Prueba eesel con tickets de voz y chat
Si estás comparando modelos de transcripción porque tu equipo se ahoga en tickets de voz o chat, recuerda que la transcripción es solo la mitad del trabajo. El compañero de IA para el helpdesk de eesel retoma donde termina un modelo como Gemini 3.5 Transcribe: lee el mensaje del cliente, redacta o envía la respuesta y cierra el ciclo, a través de más de 1.000 integraciones.
Lo primero que señalaría es el modo de simulación. Antes de que ninguna IA toque a un cliente real, la ejecutas sobre miles de tus tickets históricos y ves exactamente cómo habría respondido, el mismo consejo de "pruébalo primero con tus propios datos" que daría para cualquier modelo de transcripción, integrado en el producto. El precio es una tarifa mensual fija, desde 299 $/mes por 500 créditos (1 crédito por ticket o chat) sin tarifas por usuario, y hay un plan gratuito con 100 créditos, sin tarjeta. Es la diferencia entre una transcripción inteligente de un problema y una resolución real del mismo.