Die 10 besten Pluno AI Alternativen 2026
Riellvriany Indriawan

Katelin Teen
Zuletzt bearbeitet August 18, 2026
Was Pluno tatsächlich richtig macht
Ich will hier anfangen, denn die faire Version dieses Beitrags lautet nicht „Pluno ist schlecht". Die meisten KI-Support-Agenten gründen sich auf dein Help Center und hören dort auf. Das funktioniert bei Passwort-Resets und Versandfragen. Es bricht in dem Moment zusammen, in dem ein Kunde schreibt „unser Webhook liefert seit eurem Dienstags-Deploy 429er", denn die Antwort darauf stand nie in einem Artikel. Sie stand in einem Ticket, das dein Senior-Agent vor sechs Wochen geschlossen hat.
Plunos gesamtes Versprechen ist genau diese zweite Ebene. Seine Deflection AI trainiert neben deiner Wissensdatenbank, den Docs, Slack-Threads und verbundenen APIs auch mit vergangenen gelösten Tickets und durchläuft vor der Antwort eine iterative Recherche-Schleife. Der Troubleshooting Agent geht noch eine Ebene weiter und gründet sich auf lebende Engineering-Systeme: die Codebasis und aktuelle Deploys, den Account-Status in der Datenbank, Sentry und Datadog, Request-Traces, Session-Replays. Er entscheidet sich gegen eine Eskalation, wenn die Beweislage dagegenspricht, sodass ein sauberes Sentry plus ein 200-OK-Log plus ein Replay zu „das ist kein Produktfehler" wird, festgehalten als interne Notiz.
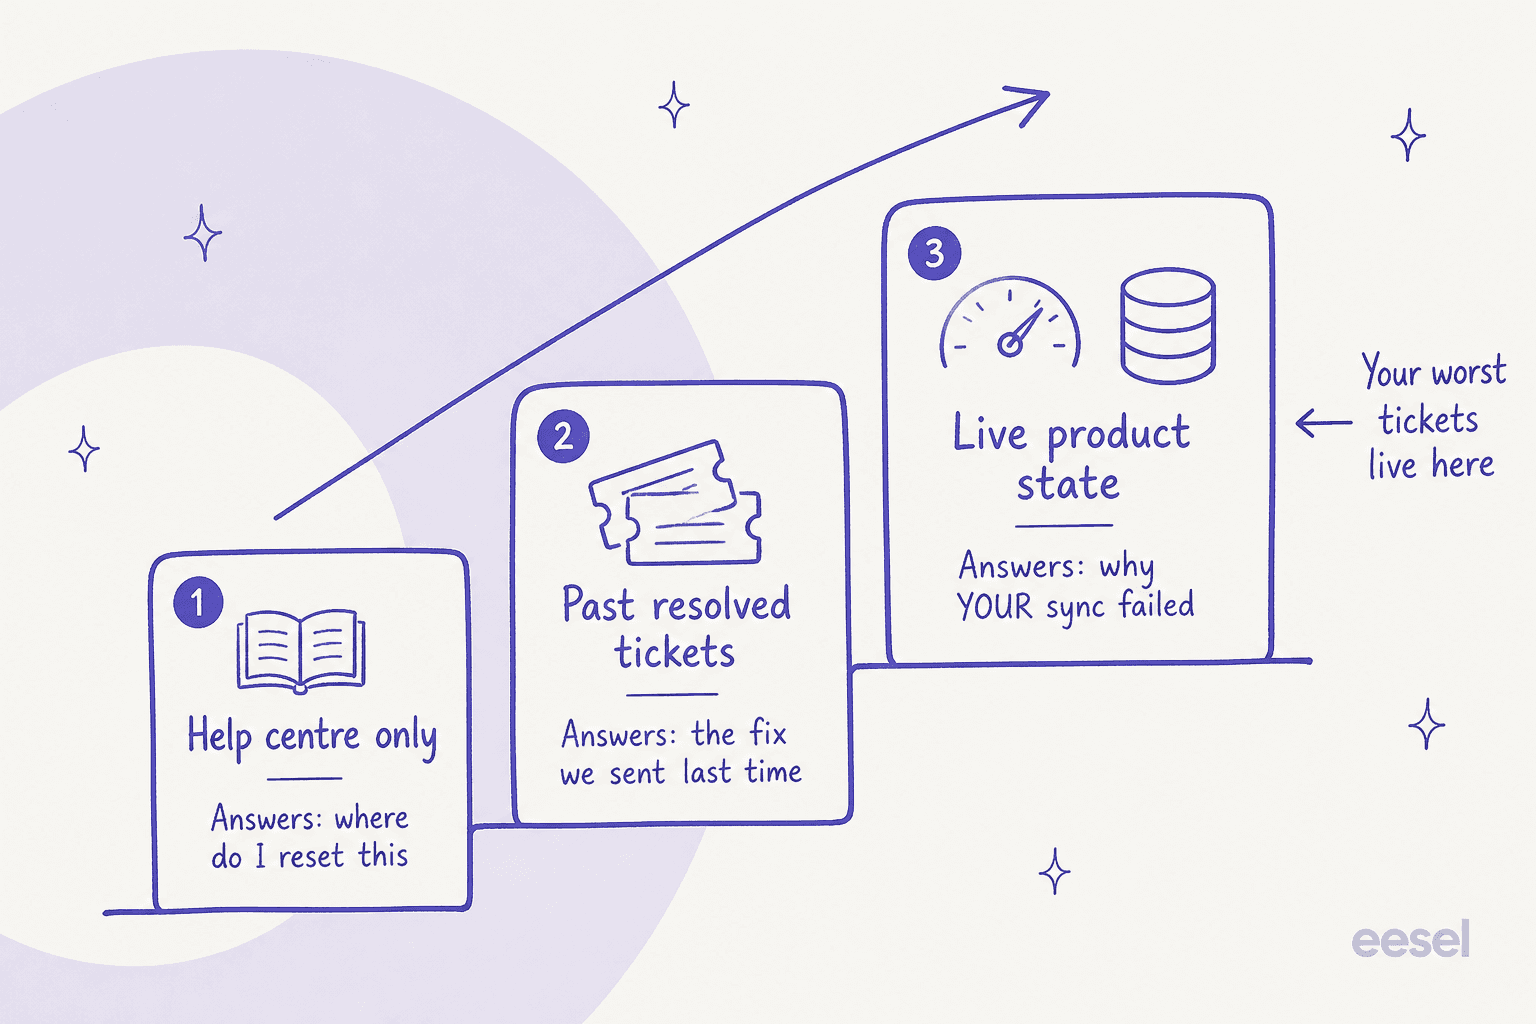
Diese Leiter ist die ehrliche Landkarte der gesamten Kategorie, und deshalb ist es fast nutzlos, Tools anhand einer einzelnen Lösungsquote zu vergleichen. Eine 70-%-Zahl, die auf Ebene eins erzielt wurde, und eine 70-%-Zahl, die auf Ebene drei erzielt wurde, sind nicht dasselbe Produkt.
Pluno ist an einer Stelle außerdem ungewöhnlich ehrlich, wo es die meisten Anbieter nicht sind. Der eigene ROI-Rechner veröffentlicht eine Deflection-Kurve nach Ticket-Komplexität: etwa 90 % bei „sehr einfach", 60 % bei „mittel" und 20 % bei „extrem komplex". Dass ein Anbieter, der sich gegen FAQ-Bots positioniert, am schwierigen Ende der Kurve eine so niedrige Zahl veröffentlicht, ist ein gutes Zeichen für diesen Anbieter. Es ist außerdem die Zahl, mit der ein technischer B2B-Käufer planen sollte, nicht die 65 % auf der Startseite oder die 70 % auf der Deflection-Seite.
Auch die veröffentlichten Kundenergebnisse liegen in einer breiten Spanne, und diese Spanne ist nützlicher als jeder einzelne Durchschnittswert. Innovorder stieg innerhalb von sechs Monaten bei 3.000 Tickets im Monat von 0 % auf 67 % Deflection, wobei sich diese Zahl nur auf Chat und WhatsApp bezieht. Kojo berichtet von 30 % bis 50 % bei 1.000 Tickets im Monat mit fünf Agents. Waste Vision berichtet von 10 % bis 20 %, beziehungsweise 100 bis 200 Tickets im Monat, plus zwei bis fünf gesparte Minuten pro Ticket. Der Schlusssatz auf allen vier Case-Study-Seiten behauptet, Pluno „löst 70 % der Tickets", was über jeder einzelnen Kundenzahl liegt, die auf denselben Seiten veröffentlicht wird.
Wo der Vergleich beginnt: die Zähler
Plunos Preistabelle ist das interessanteste Dokument, das der Anbieter veröffentlicht, auch weil die Preisseite sie als Schieberegler darstellt, sodass du immer nur eine Stufe siehst. Hier die vollständige Übersicht.
| Monatliches Ticketvolumen | Grundgebühr, monatlich | Grundgebühr, jährlich (−15 %) |
|---|---|---|
| Unter 500 | 249 € | 210 € |
| Unter 1.000 | 499 € | 425 € |
| Unter 3.000 | 999 € | 850 € |
| Unter 5.000 | 1.499 € | 1.275 € |
| Unter 10.000 | 2.499 € | 2.125 € |
| Unter 20.000 | 3.799 € | 3.230 € |
| Unter 30.000 | 4.649 € | 3.950 € |
| 30.000+ | Individuell | Individuell |
Dann kommt noch oben drauf:
| Zähler | Satz | Einheit | Was ihn auslöst |
|---|---|---|---|
| AI Copilot | 49 € | pro Sitzplatz / Monat | Jeder menschliche Agent, der Entwürfe und Zusammenfassungen bekommt |
| Deflection AI | 0,90 € | pro Lösung | Ein Ticket, das ohne menschliche Beteiligung geschlossen wird |
| Quality Assurance | 35 € | pro Agent / Monat | Bewertung jedes gelösten Tickets |
| Troubleshooting Agent | ab 99 € | pro Credit-Paket | 4.000 Credits, etwa 50 Untersuchungen zu je rund 80 Credits |
| Enterprise | Angebot | - | Schaltet SSO, SAML, DPA und Banküberweisung frei |
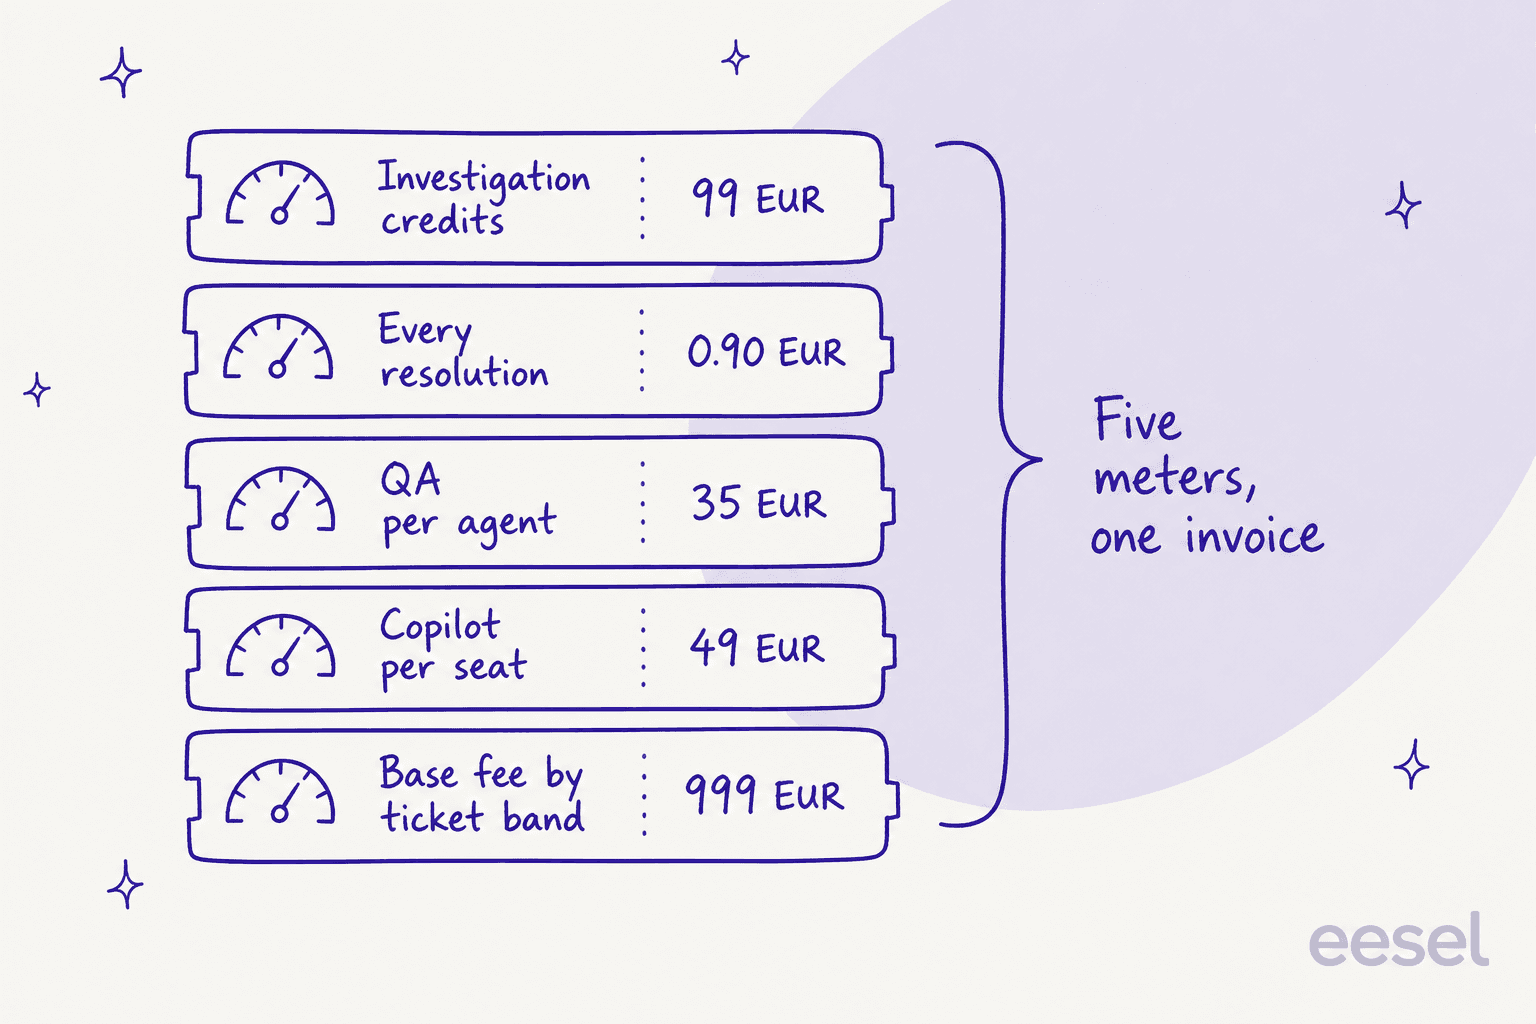
Drei Dinge an dieser Struktur sind eine echte Pause wert.
Die Grundgebühr wird für Tickets berechnet, die du nie an die KI weiterleitest. Sie richtet sich nach dem „gesamten monatlichen Support-Ticketvolumen über alle Kanäle", sodass eine Warteschlange, in der Menschen 80 % bearbeiten, trotzdem die volle Stufe zahlt. Das ist das Gegenteil davon, wie die meisten Nutzungspreise funktionieren, und es ist die größte Kalkulationsfalle auf der ganzen Seite.
Schweigen ist eine abrechenbare Lösung. Plunos eigene FAQ definiert es so: "A ticket is marked resolved 72 hours after Pluno's last reply if there is no further response from the customer." Eskalationen werden nie berechnet, was fair ist, und jedes KI-gelöste Ticket wird im Helpdesk markiert, sodass du es prüfen kannst. Aber eine falsche Antwort, bei der der Kunde aufgibt, sieht identisch aus wie eine richtige Antwort, mit der er zufrieden war. Das ist übrigens nicht nur bei Pluno so: Zendesk verifiziert seine eigenen automatisierten Lösungen nach demselben 72-Stunden-Fenster. Es lohnt sich nur zu wissen, dass deine Deflection-Kennzahl und deine Rechnung beide zum Teil messen, dass Leute nicht antworten.
Leistung kostet Geld. Bei 10.000 Tickets im Monat kommt der Sprung von 30 % auf 60 % Deflection zu 2.700 € zusätzlich auf die monatliche Rechnung, ohne dass sich die Grundgebühr ändert. Bei einem 25-köpfigen Team in diesem Volumen macht allein der Lösungs-Zähler etwa 57 % der Rechnung aus. Der jährliche 15-%-Rabatt rührt daran nichts, weil er nur für die Grundgebühr gilt.
Was das bei drei realen Teamgrößen bedeutet
Unten steht, was jedes engere Tool bei drei Größen eines technischen B2B-Teams kostet, jeweils nach den eigenen veröffentlichten Sätzen der Anbieter. Plunos Tabelle steht in Euro, alle anderen in Dollar, daher habe ich beide in ihrer eigenen Währung belassen, statt eine Umrechnung zu erfinden. Anbieter mit reinen Angebotspreisen sind entsprechend markiert, weil das die ehrliche Antwort ist.
Das Muster in dieser Tabelle ist der eigentliche Befund. Sitzplatzbasierte Tools werden günstiger, je besser die KI wird; lösungsbasierte Tools werden teurer. Keines von beiden ist falsch, aber sie belohnen entgegengesetztes Verhalten, und du solltest wissen, welches davon du unterschreibst.
Wie ich diese zehn bewertet habe
Ich arbeite in eesels Support-Warteschlange, daher liegt meine Neigung bei der unglamourösen Frage: Was passiert bei dem Ticket, das die Demo nicht abgedeckt hat. Fünf Kriterien, in der Reihenfolge, in der ich sie tatsächlich gewichte.
- Worauf es sich gründet. Help Center, gelöste Tickets, oder live Produktstatus. Siehe die Leiter oben.
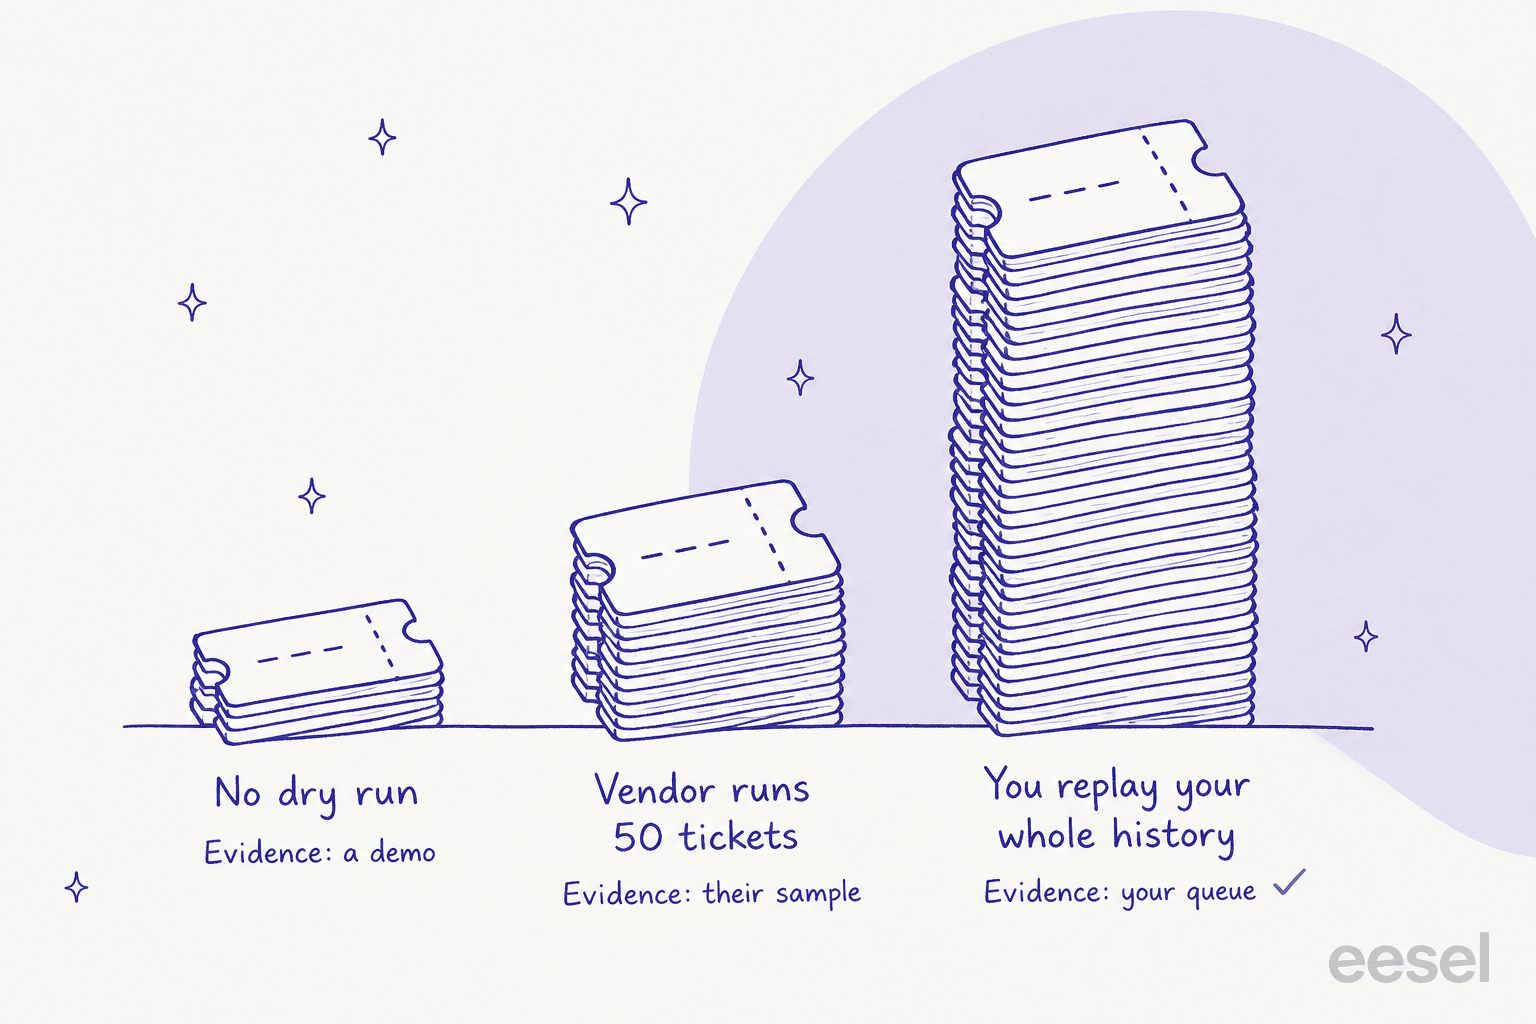
- Ob du es an deinen eigenen Tickets testen kannst, bevor du kaufst. Keine geskriptete Demo, keine Sandbox, keine handgeschriebenen Szenarien. Deine echten, geschlossenen Tickets.
- Die abrechenbare Einheit, und ob sie definiert ist. „Pro Lösung" bedeutet in dieser Liste mindestens vier verschiedene Dinge.
- Eskalationsqualität. Was der Mensch bekommt, wenn die KI aufhört, und ob die KI überhaupt weiß, wann sie aufhören soll.
- In welchem Helpdesk es tatsächlich lebt. Die meisten davon haben einen Heimatstack und werden außerhalb davon dünner.
Kriterium zwei ist der Punkt, an dem fast jedes Tool auf dieser Liste scheitert, und es lohnt sich, genau zu benennen, warum das wichtig ist.
Wir haben einen vollständigen Test auf echtem Zendesk-Traffic für einen deutschen Schmuckhändler durchgeführt, der etwa 1.000 Tickets im Monat auf Zendesk und Shopify bearbeitet, und die Ergebnisse über 100 Tickets plus 284 Chats kreuzvalidiert. Die Triage-Genauigkeit lag bei 93 %. Die Spam-Erkennung erreichte 100 % ohne falsch-positive Treffer bei einem Posteingang, der zu 22 % aus Spam bestand. Entwürfe waren zu 88 % inhaltlich zutreffend. Und Agents haben 12 % dieser Entwürfe unverändert abgeschickt.
Genau diese Lücke ist der ganze Grund, warum mir Kriterium zwei wichtig ist. Nichts war kaputt. Das dominante Muster war „drüberschauen und umschreiben", Agents machten aus 8- bis 15-Satz-Entwürfen 1- bis 3-Satz-Antworten, und etwa 65 % dieser Überarbeitungen betrafen Länge und Tonfall, behebbar durch Training auf den eigenen gesendeten Nachrichten des Teams. Nur etwa 5 % lagen daran, dass die KI sachlich falsch lag. Aber nichts davon siehst du an einer Genauigkeitszahl in einer Präsentation. Du siehst es, wenn du das Ding ein paar Wochen lang auf deiner eigenen Warteschlange laufen lässt. Wie mein Kollege Amogh nach einem Call sagte: "Also - past ticket training strikes again. Classic. People really, really, really want to train on past tickets."
Das Fehlverhalten, wovor das schützt, ist nicht, dass die KI sagt „ich weiß es nicht". Es ist, dass die KI selbstbewusst falschliegt, auf eine Art, die durch deine Docs technisch gedeckt ist. Ein Käufer, ein dänisches B2B-Team für Fahrzeug-Telematik auf Zendesk mit etwa 200 Tickets im Monat, entdeckte das im eigenen Test: Der Bot bestätigte fröhlich die Unterstützung für Automodelle, die gar nicht in der eigenen Datenbank standen, weil die Wissensdatenbank sagt „wir unterstützen alle Modelle". Der Artikel war korrekt. Die Antwort war falsch. Ein regelbasierter Chatbot hätte diesen Fehler nie gemacht, weil er es nie versucht hätte.
Hier ist noch einer, über den ich viel nachdenke, von einer CX-Leitung bei einer DTC-Nahrungsergänzungsmarke auf Gorgias und Shopify mit etwa 7.000 Tickets im Monat:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Wir haben diesen Deal wahrscheinlich genau an dieser Lücke verloren. Es ist die richtige Anforderung, und deshalb gewichte ich Confidence Thresholds genauso stark wie die Lösungsquote.
Die Shortlist auf einen Blick
| Tool | Am besten für | Startpreis | Abrechenbare Einheit | Trainiert mit gelösten Tickets | Testlauf mit eigenen Tickets | Heimat-Helpdesk | SOC 2 | G2 |
|---|---|---|---|---|---|---|---|---|
| eesel AI | Es zuerst an der eigenen Historie beweisen | $0,40/Ticket | Pro bearbeitetem Ticket | Ja | Ja, volle Historie | Zendesk, Freshdesk, Front, Gorgias, HubSpot, JSM, Salesforce | Type II in Arbeit | Nicht genug Bewertungen |
| Pluno | Zendesk-Teams, die auf Engineering gestützte Antworten wollen | 249 €/Monat Grundgebühr | Grundgebühr + Sitzplatz + Lösung + QA + Credits | Ja | Vom Anbieter durchgeführt, letzte 50 Tickets | Zendesk | Type 2 | 4,8/5 (3 Bewertungen) |
| Zendesk AI | Ablehnen, einen weiteren Anbieter hinzuzufügen | $19/Agent/Monat | Sitzplatz + $1,50 pro Lösung | Nein | Nein | Zendesk | Type 2 | 4,3/5 (6.964) |
| Decagon | Consumer-CX bei hohem Volumen | Nur Angebot | Pro Konversation oder Lösung | Nicht veröffentlicht | Nein | Nicht öffentlich benannt | Nicht aufgeführt | 4,9/5 (~18) |
| Sierra | Ergebnispreise und Voice | Nur Angebot | Pro Ergebnis, pro Vertrag | Nicht veröffentlicht | Umfang nicht angegeben | Nicht öffentlich benannt | Typ nicht veröffentlicht | 4,1-4,3/5 (17) |
| Twig AI | Docs-gestützte Deflection mit kleinem Budget | $0 kostenlos, $99/Monat | KI-Chats und Voice-Minuten | Auf einer Seite behauptet | Nein | Zendesk, Freshdesk | Type II | 4,9/5 (10) |
| IrisAgent | Tagging und Triage inklusive | Kostenlos, dann $500/Monat | Nicht offengelegt | Ja | Nein | Zendesk, Salesforce, Freshworks, HubSpot, Zoho, Gorgias | Type II | 4,8/5 (2 Bewertungen) |
| Thena | B2B-Accounts, die in Slack leben | $29/Nutzer/Monat | Pro Sitzplatz, kein KI-Zähler | Nein | Nicht dokumentiert | Slack, E-Mail, Teams | Type II | 4,9/5 (65) |
| Unthread | Slack-first mit echtem Ticketing-Rückgrat | $50/Agent/Monat, 5 Min. | Pro Sitzplatz, kein KI-Zähler | Teilweise, über verfasste Docs | Nicht dokumentiert | Slack, Teams, E-Mail | Type II | 4,9/5 (13) |
| Ada | Mehrsprachiger Self-Service im Enterprise-Maßstab | Nur Angebot | Nicht veröffentlicht | Nein | Handgeschriebene Szenarien | Zendesk, Salesforce, ServiceNow, Genesys | Type II | 4,6/5 (173) |
| Crescendo | Menschen und Software gemeinsam kaufen | $2.900/Monat + $1,25/Lösung | Pro Lösung, plus Plattformgebühr | Nein | Nein | Zendesk, Freshdesk, Gorgias, Front | Type II | 0 Bewertungen |
Eine Anmerkung zu den G2-Spalten, weil das die am häufigsten falsch gelesenen Zahlen in dieser Kategorie sind. Plunos Website sagt „4.8/5 auf G2", und das stimmt genau: Es sind 4,8 über drei Bewertungen, mit drei weiteren auf Capterra, und zwei Rezensenten tauchen auf beiden Plattformen auf, sodass die belastbare Zahl vier verschiedene Personen sind. G2 druckt den Grund selbst auf der Seite: Es gibt nicht genug Bewertungen, um daraus Kaufhilfe abzuleiten. Es gibt außerdem 87 Bewertungen verteilt über Plunos sieben Zendesk-Marketplace-Einträge, und einer der wiederkehrenden Rezensenten dort ist auf Plunos eigener Team-Seite genannt. Nichts davon heißt, dass das Produkt schlecht ist, und die Kundenzahlen in diesen Bewertungen sind echt. Es heißt, dass eine 4,8 mit n=3 weniger aussagt als eine 4,3 mit n=6.964, und beide sollten mit dem Nenner gelesen werden.
1. eesel AI
Am besten für: Teams, die die Lösungsquote an ihren eigenen Tickets gemessen haben wollen, bevor irgendetwas live geht.
Ich arbeite hier, also gewichte den Enthusiasmus entsprechend, aber der Grund, warum eesel diese Liste anführt, ist das eine Kriterium, das sonst niemand auf ihr erfüllt. Der Simulationsmodus spielt deine gelöste Tickethistorie noch einmal ab, zeigt die Abdeckung nach Thema aufgeschlüsselt, sagt dir, welche Themen es bearbeitet und welche es eskaliert hätte, und lässt dich die Lücken füllen und neu laufen lassen, bevor du irgendetwas einschaltest. Du bekommst eine Lösungsprognose, die aus deiner eigenen Warteschlange gebaut ist, nicht aus der Stichprobe eines Anbieters.
Die Grundierung sitzt auf Ebene zwei und reicht in Ebene drei hinein: vergangene Tickets, Hilfe-Docs, Makros und verbundene Tools über mehr als 100 Integrationen. Der Rollout ist bewusst schrittweise, zuerst Entwürfe, dann Autonomie für die Themen, die die Simulation bereits bewiesen hat, wobei vertrauensbasiertes Routing alles Wacklige an einen Entwurf statt an eine Live-Antwort schickt. Es findet außerdem Themen, die deine Wissensdatenbank nicht abdeckt, und entwirft die fehlenden Artikel – das ist die andere Hälfte des Tricks mit den vergangenen Tickets.
Preise
| Position | Preis | Einheit |
|---|---|---|
| Kostenloser Start | $50 an Nutzung + 2 Blog-Generierungen | Einmalig, keine Karte |
| Leichte Aufgabe | Kostenlos | Dashboard-Fragen, Nachschlagen |
| Reguläre Aufgabe | $0,40 | Ein Ticket oder eine Chat-Session, egal wie viele Antworten |
| Schwere Aufgabe | $4,00 | Ein Blogbeitrag-Entwurf |
| Jährliche Bindung | 25 % Rabatt | Ein Jahr im Voraus buchen |
| Enterprise | $1.000/Monat | Feste Plattformgebühr zusätzlich zur Nutzung |
Keine Plattformgebühr, keine Sitzplatzgebühr, kein Minimum im Standardplan. Abgerechnet wird pro bearbeitetem Ticket, nicht pro Antwort, und niemals für Tickets, die deine Menschen übernehmen: Leite 200 von deinen 1.000 weiter, und du zahlst für 200.
Pro
- Das einzige Tool hier mit einem Self-Service-Testlauf über die gesamte eigene Tickethistorie.
- Preise pro Ticket bedeuten, dass die Kosten gleich bleiben, ob die KI löst oder eskaliert, du zahlst also nicht mehr dafür, dass es besser funktioniert.
- Lebt in dem Helpdesk, den du schon nutzt: Zendesk, Freshdesk, Front, Gorgias, HubSpot, Jira Service Management, Salesforce, Slack.
- Über 80 Sprachen, trainiert auf mehrsprachiger Tickethistorie statt zum Antwortzeitpunkt übersetzt.
Contra
- SOC 2 Type II ist in Arbeit, nicht zertifiziert. Wenn deine Sicherheitsprüfung heute einen fertigen Bericht braucht, ist das eine echte Blockade.
- HIPAA und ein BAA gibt es nur auf der $1.000/Monat-Enterprise-Stufe.
- Kein eigener Voice-Kanal, eine telefonlastige Warteschlange braucht also etwas Zusätzliches daneben.
- Die Abrechnung pro Ticket berechnet auch eskalierte Tickets, was bei einer Warteschlange mit niedriger Deflection-Obergrenze schlechter ist als ein Pro-Lösung-Modell.
Fazit: Wähle eesel, wenn du die Antwort auf „wird das bei unseren Tickets funktionieren" willst, bevor du unterschreibst, und wenn Preise pro Ticket zu einer Warteschlange passen, in der ein ordentlicher Anteil weiterhin einen Menschen braucht. Global Pay berichtet von bis zu 80 % Zeitersparnis beim Finden von Antworten; InDebted brachte seinen IT-Helpdesk von 15 % Deflection auf ein 55-%-Ziel auf Jira Service Management; Gridwise sah 73 % der Tier-1-Anfragen im ersten Monat gelöst, mit Ergebnissen innerhalb einer siebentägigen Testphase. Überspringe es, wenn du heute einen fertigen SOC-2-Bericht oder Voice brauchst.
2. Zendesk AI Agents
Am besten für: Teams, die lieber einen Rechnungsposten einschalten, als einen Anbieter zu onboarden.
Wenn Plunos Reiz ist, dass es in Zendesk lebt, lautet die naheliegende erste Frage: Warum nicht Zendesks eigene Ebene nutzen? Zendesks Resolution Platform ist deutlich besser als früher: Generative Procedures verwandeln eine Klartext-Richtlinie in etwas, das der Agent ausführt, adaptives Reasoning behandelt mehrere Anliegen in einer Nachricht, und Reasoning Controls zeigen, warum jede Aktion im Konversationsprotokoll ausgelöst wurde.
Der strukturelle Haken ist die Grundierung. Ein KI-Agent kann genau zwei Arten von Quellen verbinden: Zendesk-Help-Center und externe Inhalte, die per Crawler oder Connector eingebunden werden. Dein Archiv gelöster Tickets ist keine anbindbare Wissensquelle. Zendesk macht aus Tickets stattdessen Inhalt: Der Knowledge Builder generiert Artikel aus der Tickethistorie, und vorgeschlagene Makros werden aus historischen Daten gezogen, und dann liest der Agent die Artikel. Für eine technische B2B-Warteschlange ist das ein spürbarer Schritt nach unten auf der Leiter. Auch wissenswert: Verbundene Help-Center werden live durchsucht, aber externe Quellen werden gegen den letzten Sync durchsucht, der meist alle 24 Stunden läuft.
Preise
| Position | Jährlich | Monatlich |
|---|---|---|
| Support Team | $19/Agent | $25/Agent |
| Suite Team | $55/Agent | $69/Agent |
| Suite Professional | $115/Agent | $149/Agent |
| Suite Enterprise + Copilot | Vertrieb kontaktieren | Vertrieb kontaktieren |
| Vereinbarte automatisierte Lösungen | je $1,50 | je $1,50 |
| Pay-as-you-go-Lösungen | je $2,00 | je $2,00 |
| Copilot-Add-on | $50/Agent (Professional und höher) | - |
Das Kontingent liegt bei 5 automatisierten Lösungen pro Agent im Monat bei Support Team und Suite Team, 10 bei Suite Professional. Seit Mai 2026 zieht nur eine verifizierte Lösung von diesem Kontingent ab: Ein LLM prüft nach einem 72-Stunden-Ruhefenster, ob das Anliegen tatsächlich erfüllt wurde, und enthaltene Lösungen, die die Prüfung nicht bestehen, plus unterstützte Eskalationen werden nicht berechnet. Das ist eine echte Verbesserung gegenüber der alten Zählweise, und die Zahlen addieren sich trotzdem schnell. Unser Leitfaden zu Zendesk-AI-Preisen geht tiefer auf das Stapeln ein.
Pro
- Keine Integrationsarbeit, eine Rechnung, und die KI sieht alles, was der Helpdesk sieht.
- Die Abrechnung nach verifizierter Lösung ist strenger als die meisten Pro-Lösung-Zähler, und unterstützte Eskalationen sind kostenlos.
- 80 Sprachen mit automatischem Wechsel, und Reasoning-Protokolle, die gut genug für Audits sind.
Contra
- Die Tickethistorie ist keine Wissensquelle für den Agenten, das ist der schärfste Kontrast zu einem mit vergangenen Tickets trainierten Tool.
- Kein Testlauf mit eigenen Tickets. Die drei dokumentierten Testpfade sind eine Testumgebung, ein Test-E-Mail-Trigger und ein „Test AI agent"-Button, alle zukunftsgerichtet.
- E-Mail eskaliert standardmäßig in häufigen gemischten Fällen, etwa bei einer Wissensfrage und einer Prozessanfrage in einer Nachricht.
- Die Kosten stapeln sich drei Ebenen tief: Sitzplätze, dann Lösungen, dann $50/Agent-Copilot, der erst ab Suite Professional dazukommt.
- AI Agents - Essential läuft seit Mai 2026 aus und wird am 10. Dezember 2026 entfernt, plane also die Migration jetzt.
Fazit: die Standardoption, die es zu schlagen gilt, und schlagbar. Die Stimmung hier ist geteilt, meist eher wegen des Zählers als wegen der Antworten:
"Complete trash lol, stuff I used to get free now counts as an AR. Most of the ARs are abandoned chats. There's no dispute resolution process. Complete scam. I used to like Zendesk but since trying the new bot and now this I have little good will left"

Nimm es, wenn die Warteschlange FAQ-förmig ist und Beschaffung wichtiger ist als die Obergrenze. Sieh dir Zendesk-AI-Alternativen an, wenn deine schwierigsten Tickets Tickethistorie brauchen.
3. Decagon
Am besten für: Consumer-orientierten CX bei ernsthaftem Volumen, mit Engineering-Zeit zum Einsetzen.
Decagon ist derzeit der stärkste Name in der Enterprise-Conversational-KI, und seine Agent Operating Procedures sind eine clevere Idee: in natürlicher Sprache geschriebene Workflows, die zu ausführbarem Code kompilieren, ausdrücklich positioniert gegen Konfigurationssprachen, die "inflate costs and drain engineering time." Eine Laufzeitumgebung deckt Chat, Voice, E-Mail und SMS ab, mit kanalübergreifendem Gedächtnis, Voice auf Basis von ElevenLabs, über 70 Sprachen mit automatischer Erkennung.
Die Passungsfrage für einen technischen B2B-Leser ist ehrlich und dreht sich um das ICP. Decagons eigenes Demo-Formular macht das monatliche Ticketvolumen zu einem Pflichtfeld mit Klammern, die bei „weniger als 9.999" beginnen und bis „250.000+" reichen. Das sagt dir, für wen das preislich gedacht ist. Das veröffentlichte Material nennt außerdem nie eine konkrete Helpdesk-Integration, nur Kategorien, sodass du auf Front oder Help Scout die Unterstützung nicht über die Website bestätigen kannst.
Preise. Nur auf Anfrage. decagon.ai/pricing liefert einen 404-Fehler, und es gibt keinen Preis-Link in der Navigation. Decagon beschreibt aber beide Modelle, die dir verkauft werden: pro Konversation (abgerechnet bei jeder Interaktion, die die KI berührt, gelöst oder nicht, und laut eigener Aussage wählen die meisten Kunden das) oder pro Lösung (höherer Einheitspreis, nichts berechnet, wenn eskaliert wird). Für keines der beiden ist ein Dollarbetrag angegeben. Es gibt keine kostenlose Stufe, keine Testphase, keinen Self-Service-Weg. Unsere Aufschlüsselung zu Decagon-Preisen hat, was bekannt ist.
Pro
- Workflows in natürlicher Sprache, die kompilieren, statt eines Regel-Builders, den du ewig pflegst.
- Volle Beobachtbarkeit: Jeder Modellaufruf, jeder Workflow-Schritt und jede Wissensabfrage wird nachverfolgt, plus Live-A/B-Tests über Agent-Versionen.
- Starke Referenzen bei echtem Maßstab, und 4,9/5 über rund 18 G2-Bewertungen.
Contra
- Kein veröffentlichter Preis, keine Untergrenze, keine Self-Service-Testphase. Die Bewertung beginnt mit einem Verkaufsgespräch, das an dein Ticketvolumen gekoppelt ist.
- Tests sind simulierte Konversationen plus A/B-Tests nach dem Launch, kein Abspielen des eigenen Archivs.
- Ob vergangene gelöste Tickets eine Quelle für die Einspeisung sind, steht auf den öffentlichen Seiten nicht.
- Die wiederkehrende Rezensenten-Beschwerde ist der Einrichtungsaufwand, "significant upfront engineering resources" und eine steile Anfangskurve, nicht die Antwortqualität.
Fazit: Wenn du eine Consumer-Marke mit über 50.000 Konversationen im Monat und Engineers zum Einsetzen bist, verdient Decagon das Gespräch. Für eine technische B2B-Warteschlange mit 3.000 Tickets ist das die falsche Gewichtsklasse, und Decagon für SaaS ist die Seite, die du lesen solltest, bevor du etwas anderes annimmst.
4. Sierra
Am besten für: Käufer, die nur für Ergebnisse zahlen wollen und Rechtsabteilungen haben, um zu verhandeln, was ein Ergebnis ist.
Sierra verkauft ergebnisbasierte Preise klarer als jeder andere: "outcome-based pricing is tied to tangible business impacts, such as a resolved support conversation, a saved cancellation, an upsell." Bleibt die Konversation ungelöst, gibt es in den meisten Fällen keine Kosten. Das Ghostwriter-Tool baut den Agenten aus deinem Rohmaterial, und die akzeptierten Eingaben sind ungewöhnlich breit: SOPs, Anruf- und Chat-Transkripte, Whiteboard-Fotos, Audioaufnahmen, oder eine Klartext-Beschreibung des Ziels.
Zwei Vorbehalte begleiten die Preisgeschichte. Die Kriterien für ein bezahltes Ergebnis werden pro Vertrag vereinbart, nicht universell definiert, sodass „pro Lösung" bedeutet, was auch immer dein MSA sagt, dass es bedeutet. Und Sierra räumt ein, dass die tatsächliche Rechnung gemischt ist: Routing und Empfangs-artiger Traffic "may align better with consumption-based pricing, where payment is based on conversation count, regardless of the outcome." Eine Sierra-Rechnung kann also eine Pro-Konversation-Zeile neben der Pro-Ergebnis-Zeile enthalten.
Preise. Nur auf Anfrage, und es gibt nirgendwo auf sierra.ai eine Dollarzahl. Die Preisseite liefert einen 404-Fehler und tat das schon immer. Es wird keine Plattformgebühr erwähnt, aber Sierra sagt auch nie, dass es keine gibt, also nimm nichts an. Siehe Sierra-Preise für das vollständige Bild.
Pro
- Die breiteste Compliance-Fläche auf dieser Liste: SOC 2, ISO 27001, ISO 42001, HIPAA, DSGVO, EU-KI-Gesetz, CSA STAR Level One, FedRAMP und PCI-DSS-Abzeichen.
- Echte Aktionen, nicht nur Antworten. Das Agent SDK deckt das Aktualisieren eines Abonnements oder das Einreichen eines Garantieanspruchs ab, mit API-Call- und Logik-Trace-Debugging.
- 59 Sprachen auf der Plattform, über 55 bei Voice, und Voice-Simulationen für Grenzfälle.
Contra
- Keine Testphase, keine Sandbox, keine Self-Service-Anmeldung, die Budgetfreigabe geht also jeder praktischen Bewertung voraus.
- Hinter diesen Abzeichen steht kein Trust Center:
/securityund/trustliefern beide einen 404-Fehler, es gibt also keine Audit-Daten, keinen Berichtsumfang und keine veröffentlichte Unterscheidung zwischen SOC-2-Typ-I und -II. - Simulationen existieren, aber Sierra sagt nie, ob sie die eigene Historie abspielen oder verfasste Szenarien durchlaufen.
- Keine benannte Helpdesk-Integration ist veröffentlicht, und die Eskalationsausnahme ist mit "in most cases" abgesichert.
Fazit: das am besten begründete Preismodell der Kategorie, auf einer Plattform, die die Arbeit klar erledigen kann, aber du verhandelst die Definition eines bezahlten Ergebnisses, bevor du eine Rechnung kalkulieren kannst. Großartig für eine große Marke mit Einkaufsmacht; zäh für ein 25-köpfiges Support-Team. Sierra-Alternativen deckt die leichteren Optionen ab.
5. Twig AI
Am besten für: kleine technische Teams, die Docs-gestützte Deflection ohne Vertriebszyklus wollen.
Twig ist hier das, was Plunos Positionierung am nächsten kommt, zu einem Self-Service-Preis, und es ist der eine Punkt auf dieser Liste, bei dem ich Verwirrung im eigenen Material des Anbieters melden muss, statt nur Fakten zu berichten. Twig betreibt zwei Produkte auf einer Domain: eine autonome KI-Supportplattform für B2B-SaaS, Fintech und E-Commerce, und „Sera", einen Voice-und-Chat-Empfang für Zahnarztpraxen, Medspas und Autohändler. Die beiden teilen sich kaum den Stack.
Diese Aufspaltung zeigt sich bei der Quellenfrage, die am meisten zählt. twig.so/industries/saas sagt zweimal, dass Twig "help center articles, product docs, past tickets, and internal wikis" einspeist. Die begleitende Tier-1-Use-Case-Seite listet die Quellen als "your knowledge base, help center, and product docs", ohne vergangene Tickets. Die Startseite listet nur Website, Docs und FAQs. Das würde ich schriftlich bestätigen lassen, bevor es ein Kaufgrund wird.
Preise. Zwei Preistabellen, zwei Einheiten, keine Seite erkennt die andere an.
| Sera-Plan | Preis | KI-Chats/Monat | Voice-Minuten | Chat-Überschreitung | Voice-Überschreitung |
|---|---|---|---|---|---|
| Kostenlos | $0, für immer | 100 | - | - | - |
| Starter | $99/Monat | 500 | - | $100/1.000 Chats | - |
| Growth | $499/Monat | 2.000 | 300 | $100/1.000 Chats | $1/Min. |
| Scale | $1.499/Monat | 10.000 | 2.000 | $100/1.000 Chats | $1/Min. |
Getrennt davon erklärt der Vergleichs-Hub: "Twig is an Autonomous AI Support platform that starts at $5/ticket." Ein Ticket wird dort nie definiert: nichts dazu, ob bei Erstellung, bei KI-Kontakt oder bei Lösung berechnet wird, und nichts dazu, ob ein eskaliertes Ticket trotzdem $5 kostet.
Pro
- Eine echte, dauerhaft kostenlose Stufe mit 100 KI-Chats im Monat, und eine 15-tägige Testphase auf jedem bezahlten Plan.
- SOC 2 Type II mit Vanta-Abzeichen, AES-256 im Ruhezustand, TLS 1.3, US- und EU-Residenz, und PII-Schwärzung, bevor Inhalte das Modell erreichen.
- 4,9/5 auf G2, und die Bewertungen beschreiben eine gut funktionierende interne Wissensabfrage.
Contra
- Keine Simulation, kein Backtest, kein Testlauf, kein Schattenmodus, nirgendwo. Das einzige Qualitätsgatter ist die Selbstbewertung pro Antwort auf Live-Traffic.
- Zwei Preistabellen in unterschiedlichen Einheiten, und die $5/Ticket-Zahl hat weder Plan-Seite noch Stufentabelle dahinter.
- Der MCP-Server ist nur lesbar: drei Tools, keine Schreibaktion, kann also nicht auf ein Ticket einwirken.
- Die G2-Stichprobe ist 10, davon vier gebündelt in einem Zwei-Wochen-Fenster, und keine erwähnt das Sera-Produkt überhaupt.
- Zwei Anbieterzahlen widersprechen sich beim selben Kunden: Die Startseite behauptet 90 % schnellere Erstantwort, die verlinkte Case Study sagt 60 % im eigenen Titel.
Fazit: 20 Minuten auf der kostenlosen Stufe wert, wenn deine Produkt-Docs stark sind und dein Budget klein ist. Der jüngste G2-Rezensent ist fair, was die Reibung angeht:
"I think the onboarding process could be sped up. It initially took a while to get things set up, but I believe things have improved since then. The Twig AI implementation team made it easy, though it took a little bit longer than we anticipated."

6. IrisAgent
Am besten für: Teams, deren eigentlicher Schmerz Tagging und Triage ist, nicht Deflection.
IrisAgent ist das einzige Tool im Faktenblatt A, das die Tickethistorie eindeutig als erstklassige Grundierungsquelle behandelt, und Gründerin Palak Dalal Bhatia sagt es direkt: KI für Support "only works if the answers are grounded in the company's own knowledge base and ticket history, not the LLM's training data." Es gibt eine namentlich benannte Hallucination Removal Engine, die Antworten gegen deine Inhalte validiert, und Smart Operating Procedures kompilieren Klartext-Prozeduren zu Workflows, wobei Prozeduren Vorrang vor Wissensdatenbank-Antworten haben.
Das Stärkste daran ist aber die Ebene rund um den Agenten. Case Triggers können automatisch antworten, weiterleiten, zuweisen, taggen, benutzerdefinierte Felder schreiben und private Notizen posten. Eine 11-Panel-Copilot-Seitenleiste sitzt im Helpdesk mit Suggested Resolution, einem 0-100-Priority-Score pro Fall, Sentiment, ähnlichen Fällen und Jira-Verknüpfung. Das ist das praktische Zeug, mit dem ein technisches B2B-Team täglich ringt.
Preise. Kostenlos, dann „Startet bei $500/Monat" bei Standard, dann Enterprise auf Anfrage. Die abrechenbare Einheit ist für keine Stufe offengelegt: keine Sitzplatzzahl, kein Konversationslimit, keine Lösungszahl, kein Dokumentenlimit. Die Stufentabelle ist eine Feature-Checkliste, in der keine einzige Zeile eine Zahl trägt. Zwei separate Ergebniszähler existieren anderswo: Managed Resolution ist pro Lösung abgerechnet, ohne veröffentlichten Satz, und Voice AI kostet $2 pro vollständig gelöstem Anruf. Unser Beitrag zu IrisAgent-Preisen geht dem nach, was das in der Praxis bedeutet.
Pro
- Tickethistorie ist eine echte Grundierungsquelle, kein Marketing-Satz.
- Die Ebene aus Tagging und Feldbefüllung ist hier die vollständigste, und genau das loben Nutzer tatsächlich.
- SOC 2 Type II zertifiziert, DSGVO, HIPAA „Ready", 99,9 % Uptime-SLA, plus eine selbst gehostete Option mit null Datenabfluss.
- Benannte Integrationen über Zendesk, Salesforce Service Cloud, Freshworks, HubSpot Service Hub, Zoho Desk und Gorgias.
Contra
- $500/Monat ohne zugehörige Einheit bedeutet, dass du die Kosten von der Seite aus nicht kalkulieren kannst.
- Kein Testlauf. Die Validierung vor dem Launch ist der IrisGPT Playground, eine Frage nach der anderen, plus ein Rollout privater Notizen auf Live-Tickets.
- Die Startseite veröffentlicht sowohl 60 %+ als auch 50 %+ als Lösungszahl, ohne Methodik oder Datum für beides.
- Die Preisseite markiert fünf Funktionen als in einer Stufe enthalten, während sie sie gleichzeitig als bezahlte Add-ons verkauft.
- SLA-Garantien und SSO/SAML sind nur Enterprise, und G2 hat gerade einmal zwei Bewertungen.
Fazit: die Geheimtipp-Wahl, wenn deine Tickethygiene der Flaschenhals ist. Die eine unabhängige Nutzerstimme, die ich finden konnte, sagt genau das, und es geht um Tagging, nicht um Deflection:
"OP, you should checkout IrisAgent. We're using them at my company (Fintech) - I haven't had to manually update a field or tag a ticket in 9 months because of it. Soooo nice lol"
7. Thena
Am besten für: B2B-Teams, deren Kunden bereits in gemeinsamen Slack-Channels mit ihnen reden.
Wenn deine Enterprise-Kunden Anliegen in Slack Connect statt in einem Webformular melden, ist Plunos Zendesk-förmige Welt komplett die falsche Form, und Thena ist die Antwort auf eine andere Frage. Es verwandelt Slack-, E-Mail-, Webchat-, Teams- und Discord-Konversationen in nachverfolgbare Tickets, mit KI-Ticketerkennung in der Einstiegsstufe und Emoji-Reaktionen, die auf allen Stufen Ticket-Aktionen auslösen. Die KI erstellt Tickets, füllt Felder, erinnert, übergibt, fasst zusammen, extrahiert Erkenntnisse und sammelt Feedback.
Preise
| Plan | Preis | Einheit | Grenzen |
|---|---|---|---|
| Starter | $29 | pro Nutzer/Monat, jährlich abgerechnet | Bis zu 5 Sitzplätze, 1.000 Tickets/Monat, nur Slack und E-Mail |
| Standard | $79 | pro Nutzer/Monat, jährlich abgerechnet | Keine veröffentlichten Grenzen |
| Enterprise | $119 | jährlich abgerechnet | Fügt Microsoft Teams hinzu |
Nichts hier ist an ein Angebot gebunden, was erfrischend ist, und es gibt überhaupt keinen KI-Zähler: Automatisierung ist im Sitzplatzpreis gebündelt, unter dem Motto „KI ist die Basis".
Pro
- Sitzplatzpreise ohne Pro-Lösung-Gebühr, die Rechnung wächst also nicht, wenn die Deflection besser wird.
- Wirklich Multi-Persona: SLA-Richtlinien mit Arbeitszeiten, Routing zu Gruppen, RBAC, und ein MCP-Server, der Tickets für Claude, Cursor und Raycast bereitstellt.
- SOC 2 Type II mit jährlichen Audits durch Dritte und halbjährlichen Penetrationstests, überwacht via Vanta.
- 4,9/5 aus 65 G2-Bewertungen, die gesündeste Stichprobe der hier vertretenen Slack-nativen Tools.
Contra
- Wissen stammt aus Help-Centern und in Thena verfassten Artikeln. Training über den eigenen historischen Ticket-Rückstand ist nicht dokumentiert.
- Kein dokumentierter Testlauf. KI-Protokolle sind stattdessen eine nachträgliche Audit-Spur.
- Microsoft Teams ist nur Enterprise für $119/Nutzer/Monat, ein Teams-first-Unternehmen kann also nicht unterhalb der Top-Stufe einsteigen.
- Die jährliche Bindung ist der einzige veröffentlichte Einstiegsweg, und für die 1.000-Ticket-Grenze von Starter ist kein Überschreitungssatz angegeben.
- Die Sitzplatzgrenze widerspricht sich zwischen den Seiten: Die Preisseite sagt 5 Starter-Sitzplätze, die Startseite sagt 10.
Fazit: das richtige Tool, wenn der Kanal das Problem ist. Ein G2-Rezensent ist bewundernswert klar über die Grenze:
"Limited Platform Support – While Thena integrates well with Slack, Microsoft Teams, and email, companies that rely on other platforms (e.g., Discord, WhatsApp, or in-app chat systems) might find it lacking."
8. Unthread
Am besten für: Slack-first-Support, der trotzdem ein echtes Ticketing-System darunter braucht.
Unthread sitzt neben Thena, lehnt sich aber stärker daran an, ein Helpdesk zu sein statt einer Slack-Schicht. E-Mail-zu-Ticket ist erstklassig mit Threading und Anhängen, und das eigene Beispiel des Anbieters ist gezielt technisch: eine Slack-Nachricht über eine defekte Okta-SSO-Integration, eine E-Mail vom Billing, und ein Webchat über eine API, die 429er liefert, alle landen in einer Warteschlange. Es verkauft dasselbe Produkt auch an internes IT und externen Kundensupport, was zu Unternehmen passt, in denen sich diese beiden Warteschlangen Personal teilen.
Sein Umgang mit vergangenen Tickets ist ein Mittelweg, den es sich zu verstehen lohnt. Die KI entwirft Wissensdatenbank-Artikel aus gelösten Tickets bei Pro, und der Agent ruft dann aus dieser Wissensdatenbank ab. Tickethistorie erreicht die Antwort also, aber über einen Artikel, denselben indirekten Weg wie bei Zendesk.
Preise
| Plan | Preis | Einheit | Minimum | Untergrenze | Grenze |
|---|---|---|---|---|---|
| Basic | $50 | pro Agent/Monat | 5 Sitzplätze | $250/Monat | 100 Konversationen/Monat, keine KI |
| Pro | $75 | pro Agent/Monat | 5 Sitzplätze | $375/Monat | Nicht angegeben |
| Enterprise | Nicht veröffentlicht | - | - | - | - |
Zwei Dinge sind zu beachten. Basic hat null KI, der eigentliche Einstiegspunkt für Automatisierung ist also Pro für $375/Monat. Und die 100-Konversationen-Grenze bei Basic gilt pro Plan, nicht pro Agent, fünf Agents teilen sie sich also.
Pro
- Kein KI-Zähler auf irgendeiner Stufe, Automatisierung fügt also keine variable Position hinzu.
- SOC 2 Type II, HIPAA-konform mit verfügbarem BAA, TLS 1.3, AES-256, Penetrationstests durch Dritte, und optionale isolierte Datenbankinstanzen in bestimmten Ländern.
- Über 100 Integrationen, davon über 50 zweiseitig, darunter Zendesk, Jira, Linear, HubSpot, Salesforce, PagerDuty und Okta.
- Lemonades Head of IT berichtet, es "automatically resolves about 40% of all tickets that come in across different teams."
Contra
- Kein Testlauf mit eigenen Tickets irgendwo dokumentiert.
- SSO, Slack Enterprise Grid und HIPAA/BAA sind alle nur Enterprise, eine große Slack-Organisation auf Grid kann also nicht zum Listenpreis kaufen.
- Die Testphase ist nicht Self-Service: Beide „Try for free"-Buttons führen zu einem Demo-Formular.
- G2 liegt bei 4,9/5 aus 13 Bewertungen, lies die Zahl also mit der Stichprobe im Kopf.
- Die eigenen Integrationszahlen der Startseite widersprechen sich, über 100 in einem Abschnitt und über 50 in einem anderen.
Fazit: die Wahl, wenn der Anfragende in Slack lebt, du aber trotzdem SLAs, Reporting und eine Warteschlange brauchst, die ein Audit übersteht. Ein Rezensent benennt die Lücke, die für eine Support-Leitung zählt:
"It does not have a proper customer centric dashboard to track and create reports. Need to click on few tabs to make it user friendly."
9. Ada
Am besten für: mehrsprachigen Self-Service im Enterprise-Maßstab, auf einem Helpdesk aufgesetzt, den du behältst.
Ada ist mit deutlichem Abstand das reifste Produkt auf dieser Liste: eine in Toronto ansässige KI-Agentenschicht, gebaut als Reasoning Engine, Conversation Hub, Performance Center und Developer Toolkit, mit 25 aufgeführten Integrationen über Zendesk, Salesforce, ServiceNow, Freshworks, Genesys, Gorgias, Help Scout, Kustomer und mehr, und Kanälen, die Voice, E-Mail, Chat, WhatsApp, SMS und In-App abdecken.
Es hat außerdem eine Simulations-Funktion, weshalb es sich lohnt, genau zu sein, was dieses Wort bedeutet. Adas Simulationen spielen handgeschriebene Testfälle ab: Du verfasst den Namen, die Kundenanfrage und das Szenario. Die dokumentierten Grenzen sind nur Webchat, E-Mail und Voice, bis zu 40 Runden, Bestanden/Nicht-bestanden-Bewertungen, nur Produktionskonfiguration, und Adas eigene Warnung, dass es "executes API calls against configured production endpoints. Actions are not mocked." Das ist ein guter Regressionstest für eine Konfigurationsänderung. Es ist keine Prognose, was dein Rückstand getan hätte.
Preise. Nur auf Anfrage, ohne Dollarbetrag, Währungssymbol, Satz oder Stufenname irgendwo. Die Preisseite ist ein Lead-Erfassungsformular, dessen Absende-Button "Speak to an expert" heißt, und dessen zentrales Feld das jährliche Kontaktvolumen ist. Unser Beitrag zu Ada-CX-Preisen hat, was sich feststellen lässt.
Pro
- Die breiteste Integrationsfläche hier, und die einzige mit einer tiefen mehrsprachigen Geschichte in echtem Maßstab.
- SOC 2 Type II plus HIPAA, DSGVO, PCI DSS, AIUC-1 und null Datenspeicherung über LLM-Anbieter hinweg.
- 4,6/5 aus 173 G2-Bewertungen, die zweitgrößte verifizierte Stichprobe auf dieser Liste.
Contra
- Kein veröffentlichter Preis jeglicher Art, und keine Self-Service-Testphase.
- Vergangene Konversationen speisen Coaching, was von Menschen geschriebene Anweisungen sind, statt Abruf zum Antwortzeitpunkt, Tickethistorie gründet Antworten also nicht.
- Simulationen laufen mit handgeschriebenen Szenarien gegen Produktions-Endpunkte mit ungemockten Aktionen.
- Der Trustpilot-Score liegt bei 1,8/5 aus 20 Bewertungen. Diese Kluft lohnt sich, fair zu lesen: Die G2-Stichprobe sind Käufer und Admins, die Ada eingesetzt haben, während fast alle Trustpilot-Bewertungen Verbraucher sind, die auf einer fremden Website auf einen Ada-Bot gestoßen sind.
Fazit: eine sichere Enterprise-Wahl, wenn dein Volumen im Consumer-Maßstab und mehrsprachig ist und wenn Help-Center-Grundierung reicht. Für eine technische B2B-Warteschlange sitzt es eine Sprosse zu niedrig auf der Grundierungsleiter. Ada-Alternativen deckt das Feld ab.
10. Crescendo
Am besten für: Teams, die Menschen und Software vom selben Anbieter kaufen wollen.
Crescendo ist hier der Ausreißer, und zwar absichtlich. Es ist eine vollständig gemanagte Plattform, die KI-Agenten mit ihren eigenen angestellten menschlichen Agents paart, größtenteils aus der PartnerHero-Übernahme, positioniert als Ersatz für den gesamten CX-Stack: Agents, Routing, Ticketing, QA, Wissen und Workforce-Management. Wenn dein eigentliches Problem ist, dass du nicht genug Personal hast, ist das der einzige Eintrag auf der Liste, der das löst.
Preise. Zwei veröffentlichte Zahlen, und sie stapeln sich.
| Position | Preis | Einheit |
|---|---|---|
| Managed AI | $1,25 | pro Lösung, Mengenrabatte verfügbar |
| Monatliche Startgebühr für Service | $2.900 | pro Monat |
| Menschliche-Agent-Stufe | Angebot | - |
Die ehrliche Untergrenze liegt also bei $2.900/Monat plus $1,25 pro Lösung, das sind $34.800 im Jahr, bevor auch nur ein Ticket gelöst ist. Bei 2.000 Lösungen im Monat liegt der effektive Satz bei $2,70 pro Lösung; bei 10.000 fällt er auf $1,54. Und „Lösung" ist nirgendwo auf der Seite definiert: Das Wort taucht einmal auf, im Einheiten-Label. Unser Beitrag zu Crescendo-Preisen geht die Umschlagsrechnung durch.
Pro
- Kauft Kapazität, nicht nur Software, was kein anderes Tool hier tut.
- SOC 2 Type II, HIPAA, ISO 27001, DSGVO und ein Safe Action Framework.
- Über 20 behauptete native Verbindungen, darunter Zendesk, Freshdesk, Freshservice, Kustomer, Gorgias, Salesforce, HubSpot, Slack und Front.
Contra
- Eine $2.900/Monat-Untergrenze sind $29 pro Ticket in der niedrigsten Stufe des eigenen Demo-Formulars, das ist 0 bis 100 Tickets im Monat.
- „Lösung" ist undefiniert, $1,25 lässt sich also mit niemandes Pro-Lösung-Satz vergleichen.
- Kein Testlauf. Testing ist Entwurfsmodus, Versionsvergleich und selbst geschriebene Beispielanfragen.
- Ticket-Rückstand ist keine dokumentierte Wissensquelle.
- G2 zeigt 0 Bewertungen. Die einzige verifizierte Bewertungsfläche ist Gartner Peer Insights mit 4,5 aus zwei Bewertungen.
Fazit: ein Gespräch wert, wenn du ohnehin auslagerst und die KI und die Agents auf einem Vertrag willst. Alle anderen sollten die $2.900-Untergrenze als entscheidende Zahl behandeln. Decagon gegen Crescendo ist der nützliche direkte Vergleich.
Was ich tatsächlich tun würde
Wenn du auf Zendesk bist und deine schwierigsten Tickets Engineering-Kontext brauchen, ist Pluno ein echtes Produkt, und du solltest es seine Simulation laufen lassen. Mach nur drei Dinge explizit, bevor du unterschreibst: was die Grundgebühr bei deinem Volumen kostet, sogar für Tickets, die du nie an die KI weiterleitest, dass eine Lösung nach 72 Stunden Schweigen gezählt wird, und was mit der Rechnung passiert, wenn die Deflection von 30 % auf 60 % steigt.
Lass dann dieselbe Bewertung laufen, die du bei allem anderen auch laufen lassen würdest, und bewerte mehr als Genauigkeit. Ein Käufer hat 67 einzelne Tests mit uns gefahren, die Antworten „solide" gefunden, und ist trotzdem abgesprungen, weil das Chat-Widget langsam war und hängen blieb. Ein anderer hat vier Monate bezahlt und ist abgewandert, weil der Test von Anfang an nie etwas Brauchbares beantwortet hatte. Beides sind Dinge, die eine Lösungsquoten-Zahl komplett verdeckt.
Das Einzige, worauf ich mich weigern würde zu verzichten, ist ein Testlauf mit den eigenen Tickets. Nicht weil die Anbieter etwas verstecken, sondern weil 93 % Triage-Genauigkeit und 12 % unverändert versendete Entwürfe in derselben Woche für dasselbe System stimmten, und nur eine dieser Zahlen den Kontakt mit einer echten Warteschlange übersteht. Wenn ein Anbieter dir das erst nach einem Call zeigt, ist auch das eine Information. Wie es ein Kunde formulierte, der es stattdessen selbst bauen wollte:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, via eesel
Das ist der richtige Instinkt, und Build versus Buy ist eine echte Weggabelung, die es sich lohnt zu durchdenken, bevor du überhaupt eine Shortlist erstellst.
Teste eesel für deine technische Warteschlange
Wenn du bei Pluno einkaufst, weil es mit gelösten Tickets trainiert und du das an deinen gelösten Tickets sehen willst, ist genau dafür eesels Simulation da. Verbinde Zendesk, Freshdesk, Front, Gorgias, HubSpot oder Jira Service Management, spiele deine Tickethistorie ab, und lies die nach Thema aufgeschlüsselte Lösungsquote, bevor auch nur ein Kunde eine Antwort sieht. Geh dann im Entwurfsmodus live für die Themen, die es bereits beherrscht, und gewähre von dort aus Autonomie.
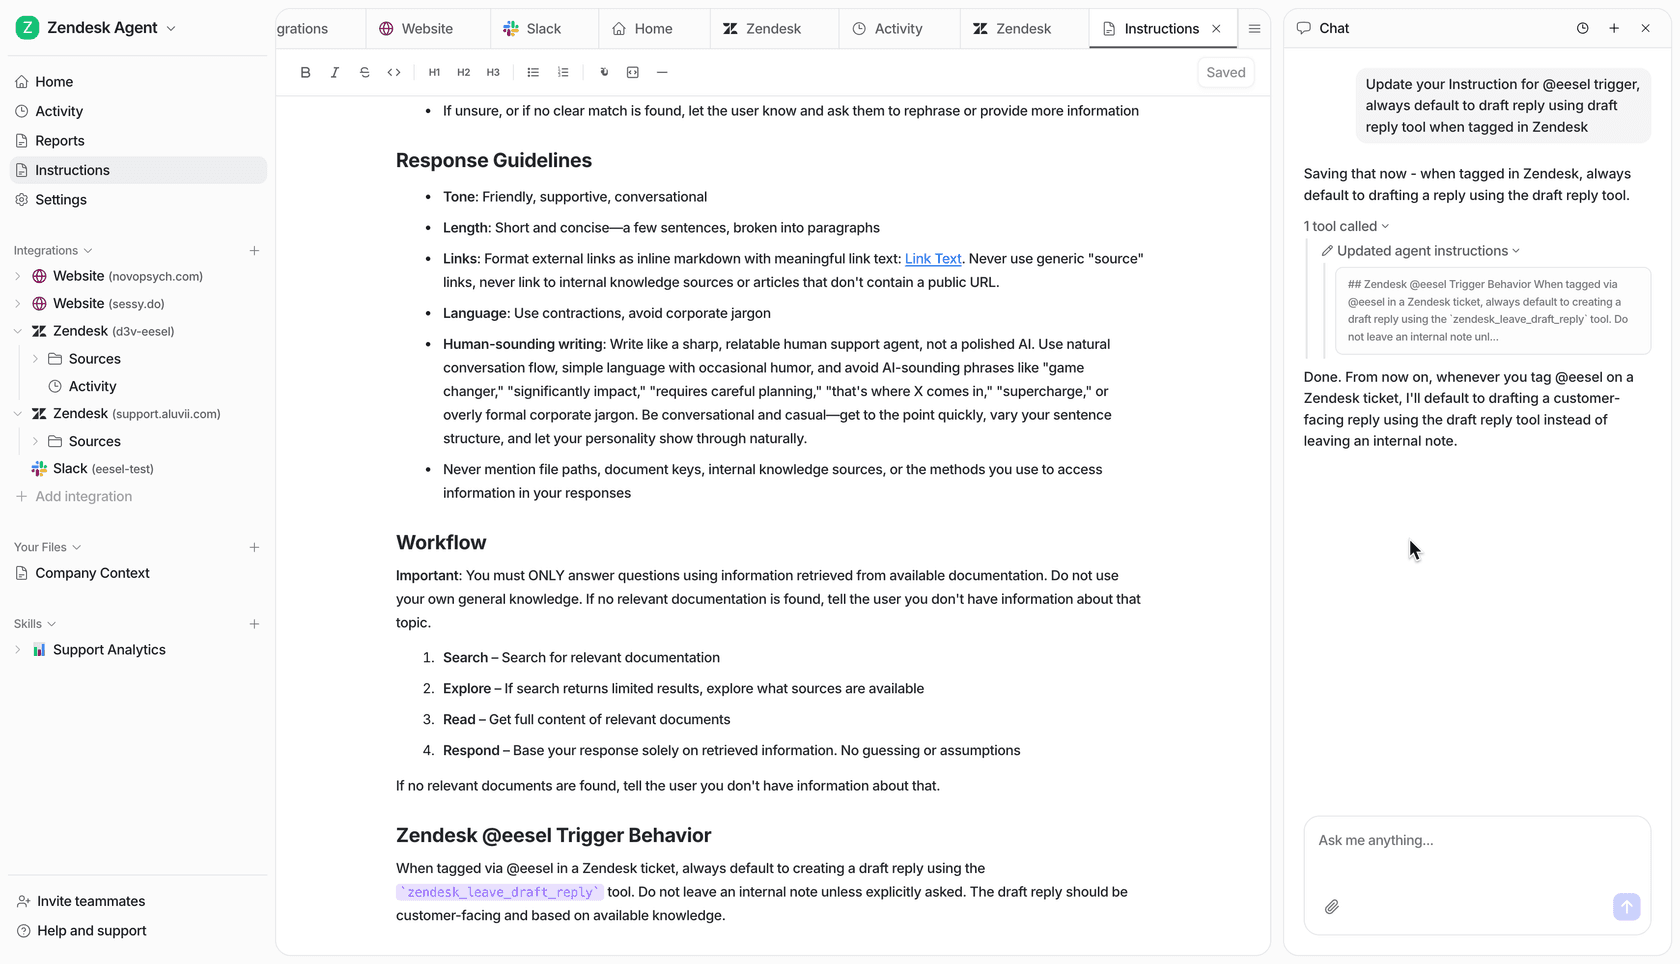
Es kostet $0,40 pro bearbeitetem Ticket, keine Plattformgebühr, keine Sitzplatzgebühr, und du zahlst nie für Tickets, die deine Menschen übernehmen. Es warten $50 an Nutzung ohne Karte, was bei einer technischen Warteschlange reicht, um herauszufinden, ob das für dich funktioniert. Teste eesel.
Häufig gestellte Fragen
Wie viel kostet Pluno AI?
Was ist die beste Pluno AI Alternative für ein technisches B2B-SaaS-Team?
Funktioniert Pluno AI auch mit anderen Helpdesks als Zendesk?
Gibt es eine kostenlose Pluno AI Alternative?
Was passiert, wenn die KI ein technisches Ticket falsch beantwortet?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.