Claude Fable 5.1 Preise auf einen Blick
Hier ist die komplette Preistabelle, direkt aus den Preisunterlagen der Claude Platform. Alle Zahlen sind pro Million Token (MTok), in USD.
| Kennzahl | Claude Fable 5.1 | Claude Fable 5 (vorher) |
|---|---|---|
| Basis-Input | $10 / MTok | $10 / MTok |
| Output | $50 / MTok | $50 / MTok |
| Cache-Reads (Hits und Refreshes) | $0,25 / MTok | $1 / MTok |
| 5-Minuten-Cache-Writes | $12,50 / MTok | $12,50 / MTok |
| 1-Stunden-Cache-Writes | $20 / MTok | $20 / MTok |
Das Muster, das auffällt: Vier der fünf Zahlen sind identisch mit Fable 5. Das ist keine neue Preisstufe, sondern dieselbe Modell-Preistabelle mit einer neu geschriebenen Zeile. Wer seine Kalkulation also auf Fable 5 aufgebaut hat, muss an der Input- und Output-Rechnung überhaupt nichts ändern.
Noch etwas, das man vor jeder Kalkulation festhalten sollte: Fable 5.1 verwendet denselben Tokenizer wie Fable 5 (denjenigen, der mit Opus 4.7 eingeführt wurde). Gegenüber Modellen, die älter als Opus 4.7 sind, erzeugt derselbe Text etwa 30% mehr Token. Eine Token-Schätzung aus einem Vor-4.7-Modell sollte man also nicht ungeprüft übernehmen.
Die eine Zahl, die sich geändert hat: Cache-Reads
Wer nur einen Abschnitt liest, sollte es dieser sein. Der Cache-Read-Preis ist von $1 auf $0,25 pro Million Token gefallen, ein Rückgang von 75%.
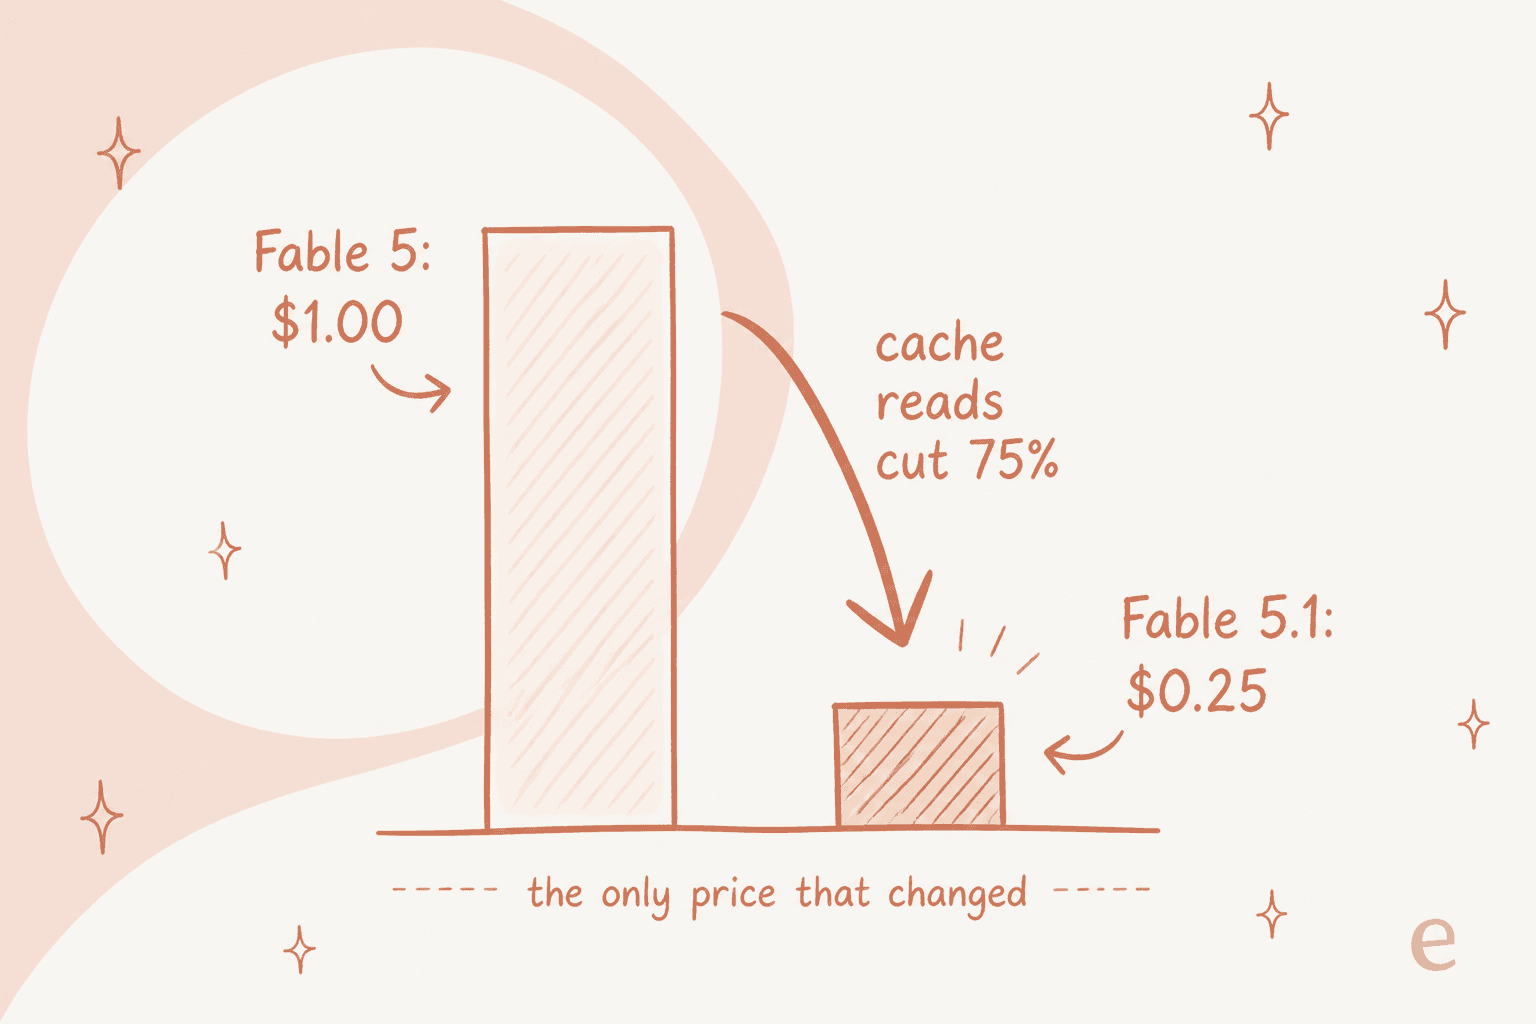
Warum ist eine einzelne Kennzahl so wichtig? Prompt-Caching erlaubt es, einen Teil eines Prompts (einen System-Prompt, ein großes Dokument, Tool-Definitionen) einmal zu speichern und ihn bei späteren Aufrufen wiederzuverwenden, statt jedes Mal den vollen Input-Preis zu zahlen. Bei Fable 5.1 kostet ein Cache-Read jetzt 0,025x des Basis-Input-Preises, gegenüber 0,1x bei anderen Claude-Modellen. Die Mindestlänge von 512 Token für Caching bleibt unverändert.
Der Grund, warum das bei agentischer Arbeit so stark einschlägt: Ein lange laufender Agent liest seinen Kontext bei jedem Schritt neu ein. Braucht ein Agent vierzig Tool-Calls, um eine Aufgabe abzuschließen, liest er diesen zwischengespeicherten Präfix vierzigmal. Senkt man den Preis für dieses Lesen um drei Viertel, bewegt sich die Gesamtrechnung deutlich, obwohl sich die Schlagzeilenzahlen $10/$50 nie geändert haben. Die Änderung belohnt genau die Art von Arbeit, für die Fable 5.1 gebaut wurde.
Was "tatsächliche Ersparnis" wirklich bedeutet
Anthropic nennt zwei Ersparnis-Zahlen, die man genau lesen sollte, statt sie als eine einzige Kennzahl zu behandeln. Die Senkung des Cache-Read-Preises reduziert die Kosten eines typischen Workloads um etwa 25% und die eines stark agentischen Workloads um bis zu 45%, jeweils im Vergleich zu Fable 5.
Zwei Vorbehalte zu diesen Zahlen, denn ein Prozentsatz ist nur so gut wie seine Basis:
- Sie werden gegen Fable 5 gemessen, nicht gegen Opus 5 oder einen Wettbewerber. Es handelt sich um einen Vergleich innerhalb desselben Modells.
- Sie wurden bei Standard-Effort über vier Wochen realer Nutzung im August 2026 auf Claude Enterprise, Claude Code und der API gemessen. Der eigene Mix aus zwischengespeicherten und frischen Token entscheidet, wo man in dieser Bandbreite von 25 bis 45% landet. Ein Workload, der Caching kaum nutzt, sieht davon kaum etwas.
Praktiker, die es im Alltagseinsatz nutzen, berichten von einem ähnlichen Muster. Ein Team brachte es nach einer Woche mit Multi-Agenten-Loops auf den Punkt:
"One team ran Claude Fable 5.1 for 7 days straight on multi-agent coding loops and cut token spend 25%"
Das ist das untere Ende der Bandbreite, was für einen Coding-Loop, der nicht maximal Cache-intensiv ist, etwa zu erwarten ist.
Batch, US-only und die übrigen Posten
Zwei Tarife stehen außerhalb der Haupttabelle und verändern die Rechnung für bestimmte Setups.
Batch-Verarbeitung läuft mit 50% Rabatt auf den Standardtarif: $5 pro Million Input-Token und $25 pro Million Output. Wer nicht latenzsensibel arbeitet (nächtliche Dokumentenverarbeitung, Massenklassifizierung, offline Evals), findet hier den größten Hebel der gesamten Tabelle – größer als die Cache-Senkung, zumindest für nicht-interaktive Jobs.
US-only-Inferenz steht für Workloads mit Anforderungen an die Datenresidenz zur Verfügung, zum 1,1-fachen Input- und Output-Preis. Also $11 Input / $55 Output pro Million Token, wenn jede Anfrage in den USA laufen muss.
Claude Mythos 5.1, dasselbe zugrunde liegende Modell mit leichteren Schutzmechanismen, ist preislich identisch mit Fable 5.1. Es ist keine günstigere Stufe und auf Teilnehmer von Project Glasswing beschränkt (geprüfte Cyberdefender und Biowissenschaftler), sodass es für fast alle sowieso keine Kaufoption ist.
Fable 5.1 vs. Opus 5 vs. Sonnet 5
Ein einzelnes Modell isoliert zu bepreisen verdeckt die eigentliche Entscheidung: welches Claude-Modell man überhaupt bezahlen sollte. Hier ist die aktuelle Modellfamilie mit API-Tarifen pro Million Token, aus der Preistabelle der Plattform.
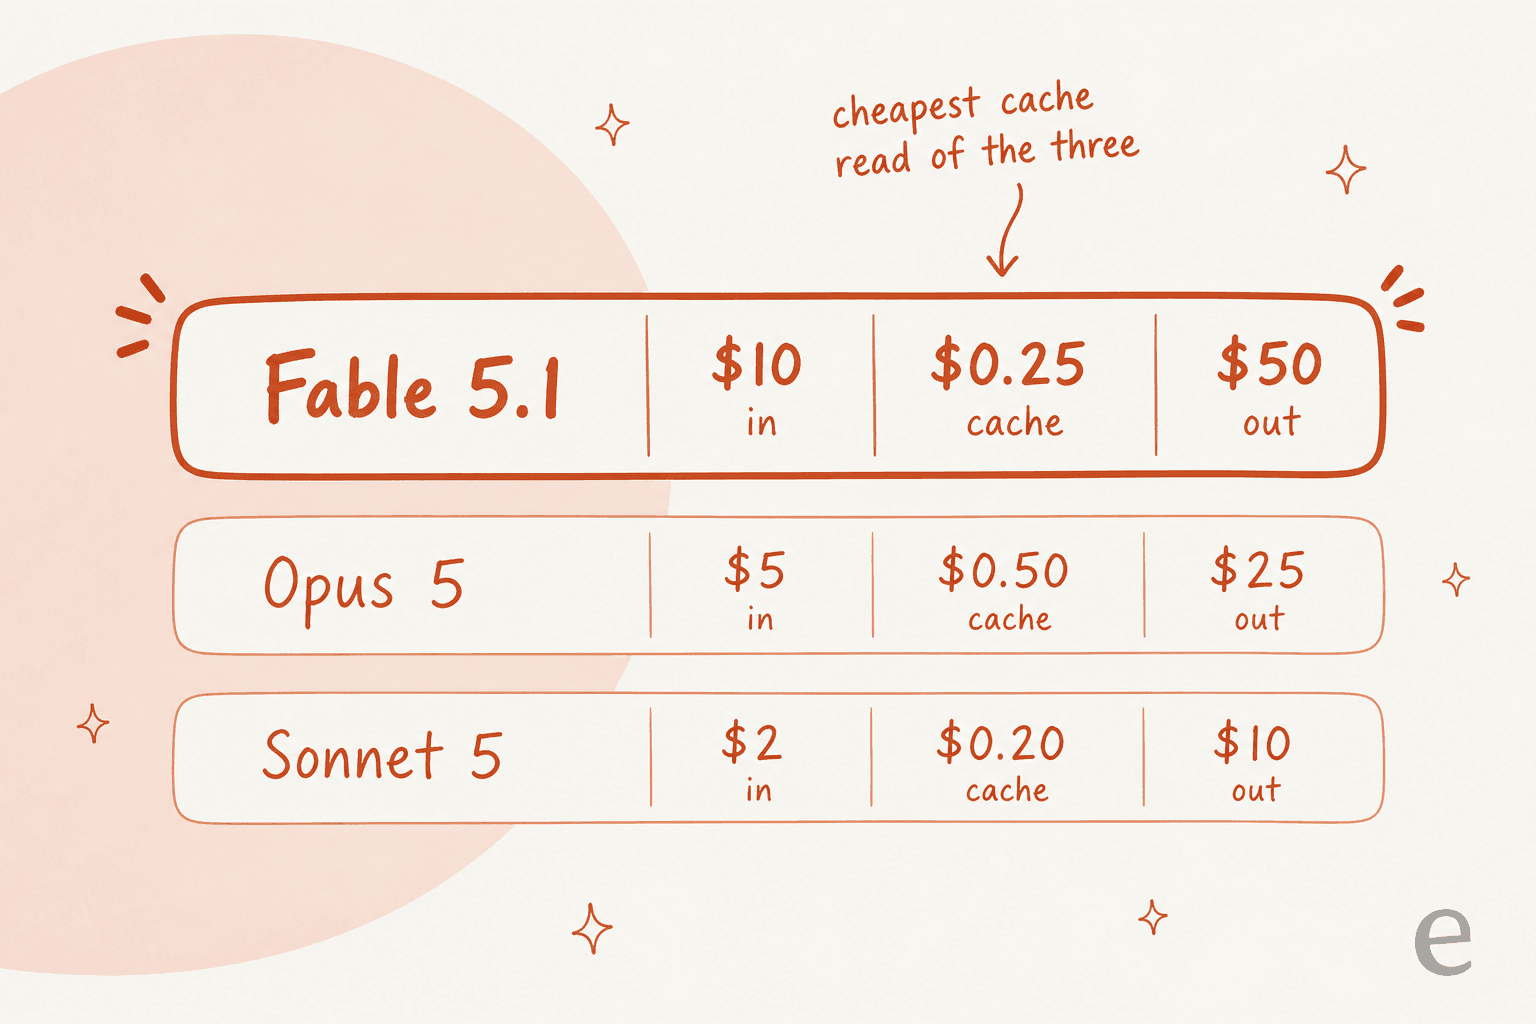
| Modell | Input | Cache-Read | Output |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0,25 | $50 |
| Claude Opus 5 | $5 | $0,50 | $25 |
| Claude Sonnet 5 | $2 | $0,20 | $10 |
Das Kontraintuitive daran: Fable 5.1 ist bei Basis-Input und -Output das teuerste Claude-Modell, doppelt so teuer wie Opus 5 und fünfmal so teuer wie Sonnet 5 – und trotzdem ist sein Cache-Read zu $0,25 der günstigste der drei, sogar günstiger als die $0,50 von Opus 5. Das ist kein Zufall. Anthropic hat genau die Kennzahl bepreist, die eine lange Agenten-Session am stärksten strapaziert – je agentischer der eigene Workload, desto mehr wirkt dieser Unterschied zugunsten von Fable.
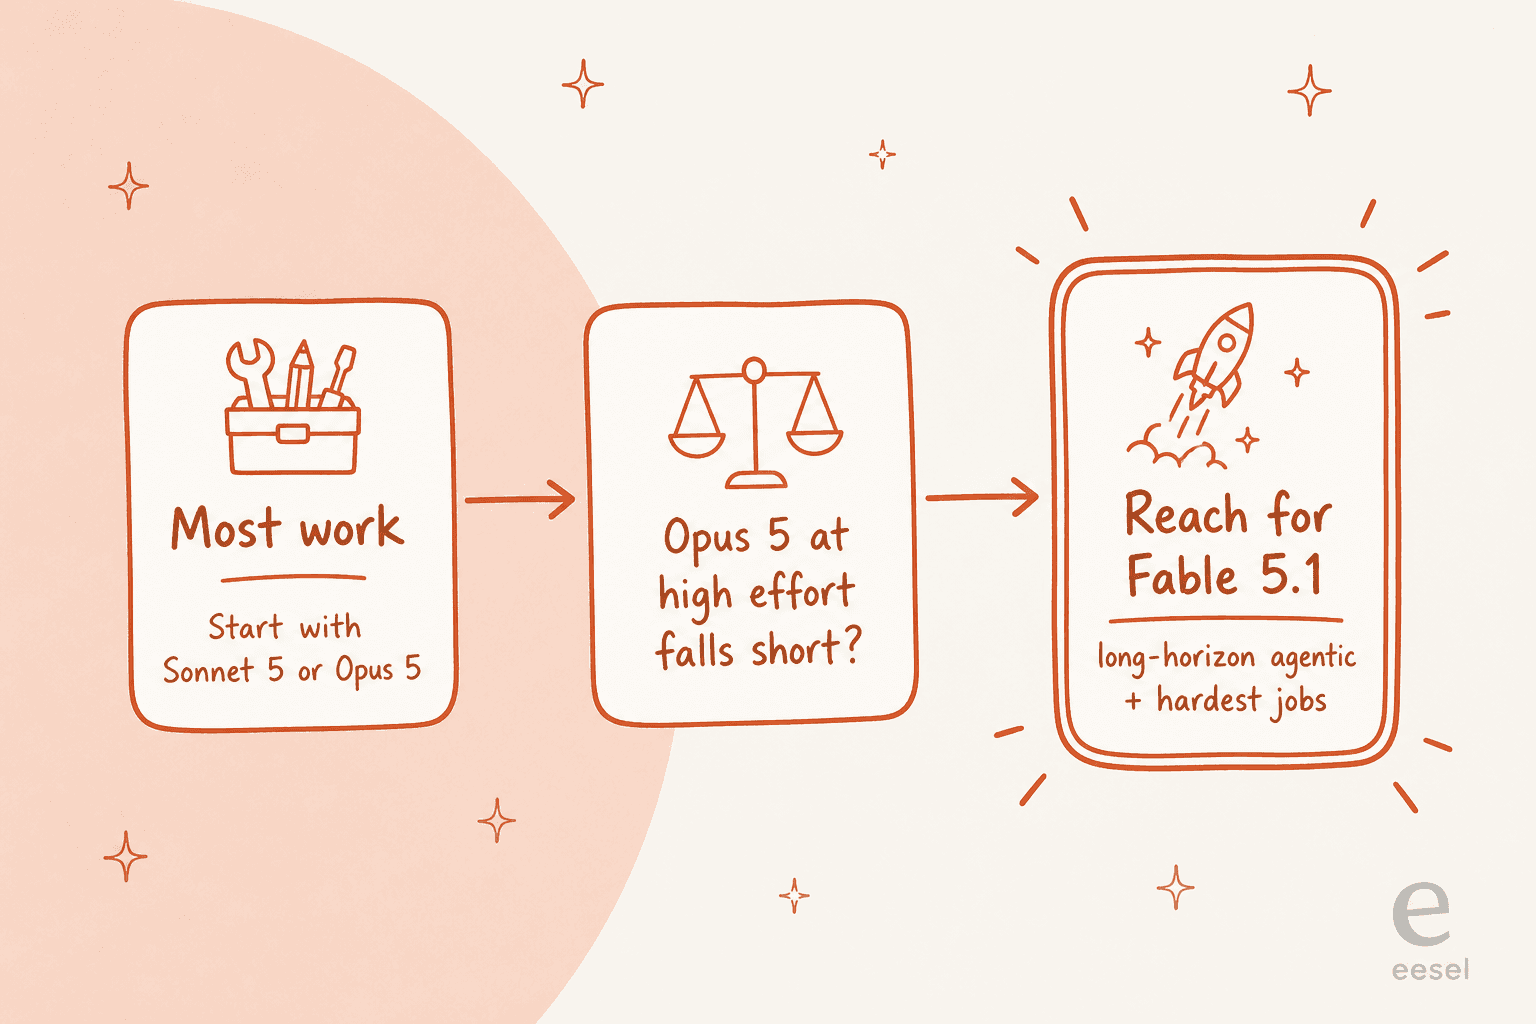
Anthropics eigene Empfehlung ist erfrischend unverblümt, wann man wirklich für Fable bezahlen sollte. In den Unterlagen heißt es, man solle für die meisten Workloads mit Opus 5 starten und erst zu Fable 5.1 greifen, wenn Opus 5 bei höherem Effort immer noch nicht ausreicht, oder für die ambitioniertesten, lange laufenden Projekte.
Mindestens ein Entwickler fand die Rechnung mit geringerem Effort für sich genommen überzeugend:
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
Effort ist der Hebel, den die meisten beim Vergleich von Preistabellen übersehen: Ein Modell mit niedrigem Effort denkt weniger und verbraucht weniger Token, sodass die Kosten pro Aufgabe eines "teuren" Modells niedriger ausfallen können, als der Listenpreis vermuten lässt. Das adaptive Denken von Fable 5.1 ist immer aktiv und wird über den Parameter effort gesteuert, standardmäßig auf hoch gesetzt.
Wofür man nicht bezahlt
Ein kleiner, aber realer Teil der Claude Fable 5.1 Preise ist das, was jetzt kostenlos ist, aber früher bei einer Ablehnung Geld gekostet hätte.
Fable 5.1 leitet manche Anfragen an Schutzmodelle um, anstatt sie selbst zu beantworten. Als riskant markierte Cyber-Anfragen fallen zurück auf Opus 4.8, als riskant markierte Biologie-Anfragen auf Opus 5, und entscheidend ist: Für eine umgeleitete Anfrage werden keine Fable-Preise berechnet. Außerdem gibt es ein Fallback-Guthaben, das die Prompt-Cache-Kosten für den Modellwechsel bei einer abgelehnten Anfrage erstattet, und eine Ablehnung, die vor jeglicher Ausgabe erfolgt, wird nicht abgerechnet.
Dieses Abrechnungsdetail ist wichtig, weil Ablehnungen ein aktuelles Streitthema sind. Entwickler stoßen auf False Positives im eigenen Code:
"Fable is useless. Me: "Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company." Fable: "yeah, no.""

Fairerweise muss man sagen, dass sich die Richtung hier verbessert und nicht verschlechtert: Claude-Code-Nutzer können mit rund 60% weniger Cyber-Schutzeingriffen pro Session rechnen als bei Fable 5, und Fable 5.1 kann jetzt Softwareschwachstellen defensiv identifizieren. Für das Budget zählt aber ein engerer Punkt: Eine Ablehnung ist ärgerlich, steht aber immerhin nicht auf der Rechnung.
Plan-Verfügbarkeit und wo man es aufrufen kann
Die Token-Preistabelle betrifft die API. Auf der Verbraucherseite steht Fable 5.1 Pro-, Max-, Team- und Enterprise-Nutzern zur Verfügung, aber nicht in der kostenlosen Stufe. Für die genauen monatlichen Abo-Beträge verweist Anthropic auf claude.com/pricing – das ist die verlässliche Quelle, die man live prüfen sollte, bevor man eine Pro- oder Max-Zahl zitiert, da sich diese unabhängig von den oben genannten API-Tarifen ändern.
Eine Nuance für alle mit Abo statt API: Der Standard-Effort unterscheidet sich je nach Oberfläche. Fable 5.1 läuft standardmäßig mit hohem Effort in Claude Code und mit mittlerem Effort in Claude Cowork und auf Claude.ai. Höherer Effort verbraucht mehr Token, was mit erklärt, warum selbst Max-Nutzer berichten, bei Fable-Modellen schnell an Nutzungslimits zu stoßen.
Über die API lässt sich claude-fable-5-1 auf allen großen Plattformen aufrufen: direkt über die Claude API, Amazon Bedrock und Claude Platform auf AWS, Google Cloud Vertex AI und Microsoft Foundry. Die Preistabelle ist überall dieselbe, egal von wo aus man aufruft.
Die eigenen Claude Fable 5.1 Kosten schätzen
Preistabellen bleiben abstrakt, bis man die eigenen Zahlen einsetzt. Dieser Rechner nimmt Token-Volumen und den Anteil aus frischem und zwischengespeichertem Input entgegen und liefert einen Monatsbetrag zu Fable 5.1-Tarifen, mit Opus 5 und Sonnet 5 zum Vergleich daneben. Alles läuft im eigenen Browser, nichts wird irgendwohin gesendet.
Wer mit dem Cache-Prozentsatz spielt, sieht den ganzen Sinn des 5.1-Updates: Je mehr Input durch den Cache läuft, desto schneller sinkt Fables Gesamtsumme – denn das ist die eine Kennzahl, die Anthropic radikal gesenkt hat.
Das Modell ist Infrastruktur, eesel ist der Teammate
Was eine Preistabelle nicht verraten kann: Der Token-Preis ist nicht die Kosten für die Lösung des eigentlichen Problems, sondern die Kosten für eine rohe Zutat. Claude Fable 5.1 ist ein Modell. Um daraus etwas zu machen, das tatsächlich ein Kundenticket löst, muss man immer noch Retrieval über die eigenen Hilfe-Dokumente aufbauen, Guardrails, damit es nicht selbstbewusst eine Rückerstattungsrichtlinie erfindet, einen Eskalationsweg zu Menschen und eine Möglichkeit, es zu testen, bevor es echte Kunden erreicht. Genau dort liegen die echten Kosten und das echte Risiko, nicht in der Zeile $10 gegen $50.
Genau diese Lücke schließt eesel. eesel ist eine Plattform für KI-Teammates, und der KI-Support-Teammate kommt bereits mit dem nötigen Know-how: Er bindet sich in das bestehende Helpdesk ein, trainiert auf den eigenen vergangenen Tickets und der Wissensdatenbank und reiht sich in die Warteschlange ein wie ein neuer Mitarbeiter. Man baut ihn nicht selbst aus einem Modell und einem Stapel Klebe-Code zusammen. Und weil ein Coding-Agent wie Claude Code, Codex oder Cursor denselben Teammate über die eesel CLI steuern kann, lässt sich die gebaute Automatisierung durchgängig skripten statt hinter einem Dashboard eingesperrt zu sein.
Der Preisunterschied ist der Teil, der für alle zählt, die gerade diese ganze Preistabelle gelesen haben. Die Token-Abrechnung ist naturgemäß variabel: Ein gesprächiger Agenten-Lauf kostet mehr als ein knapper, und man erfährt es erst hinterher. eesel rechnet stattdessen pro gelöstem Ticket ab, sodass die Support-Automatisierung ein kalkulierbarer Posten bleibt, egal wie oft das zugrunde liegende Modell seinen Kontext neu einliest. Man kann eesel kostenlos testen und es zunächst gegen die eigenen historischen Tickets laufen lassen, um Lösungsrate und Kosten zu sehen, bevor es je einen echten Kunden beantwortet.
Häufig gestellte Fragen
Wie viel kostet Claude Fable 5.1 pro Million Token?
Ist die Nutzung von Claude Fable 5.1 kostenlos?
Warum sind die Preise von Claude Fable 5.1 höher als bei Opus 5 oder Sonnet 5?
Wie hoch ist der Cache-Read-Rabatt bei Claude Fable 5.1?
Wie halte ich die Claude Fable 5.1 Preise im Produktivbetrieb kalkulierbar?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.