

O Qwen Image 2.1 é o novo modelo de imagem de pesos abertos da Alibaba, lançado em 20 de setembro de 2026, e seu grande truque é a transparência nativa: ele gera imagens RGBA com um canal alfa real direto de um prompt, sem etapa manual de remoção de fundo (blog da Qwen). Também é bem menor que antes, um gerador visual de 7B contra o antigo modelo de 20B, então roda em uma única GPU de consumo, e pode editar com até 10 imagens de referência em 2K nativo.
Há uma pegadinha que vale conhecer antes de construir em cima dele. A licença mudou da Apache 2.0, que cobria o Qwen-Image original, para uma licença só para pesquisa que proíbe uso comercial sem uma concessão separada (LICENSE). E não existe uma API paga qwen-image-2.1; a API de imagem comercial da Alibaba roda no mais novo qwen-image-3.0.
Então, para quem é? Se você quer gerar PNGs transparentes localmente, experimentar ou fazer pesquisa, é um lançamento realmente empolgante e gratuito para rodar. Se você entrega trabalho criativo comercial, leia a licença primeiro ou use a API paga.
O que o Qwen Image 2.1 realmente é
O Qwen Image 2.1 é o modelo de imagem mais recente da equipe Qwen da Alibaba, e faz dois trabalhos em um único conjunto de pesos: geração de texto para imagem e edição de imagem. A parte que desenha é um diffusion transformer de apenas 7B de parâmetros, construído com 32 camadas Single-Stream DiT (blog da Qwen). Foi lançado em 20 de setembro de 2026 no Hugging Face, no ModelScope e no GitHub ao mesmo tempo, com suporte desde o primeiro dia no ComfyUI, Diffusers, vLLM-Omni e SGLang.
O número a guardar é esse 7B. O modelo de imagem aberto anterior da Qwen tinha 20B, com um transformer de imagem de 40,9 GB, e este chega a 7B / 14,2 GB (7,26 GB em INT8), como um testador explicou no X:
"Qwen's Image 2.1 released but it come with lots of improvements but just as many caveats. The old Qwen-Image-2512 was a 20B model with a massive 40.9GB BF16 image transformer. But the new Qwen-Image-2.1 comes with 7B visual generator, 14.2GB BF16, 7.26GB INT8"
Essa redução é toda a história do lançamento: a Alibaba manteve a maior parte do que o modelo maior fazia, adicionou um recurso de destaque e fez o conjunto rodar em hardware que as pessoas realmente têm.
A transparência nativa é a verdadeira manchete
Todo modelo de imagem consegue desenhar uma imagem. Quase nenhum consegue entregar um recorte transparente limpo. O fluxo usual é gerar primeiro, depois passar o resultado por um removedor de fundo e torcer para que as bordas ao redor de cabelo e vidro sobrevivam. O Qwen Image 2.1 simplifica isso: ele decide, a partir do seu prompt, se gera uma imagem normal ou uma imagem RGBA com um canal alfa real, e gera a versão transparente diretamente (blog da Qwen).
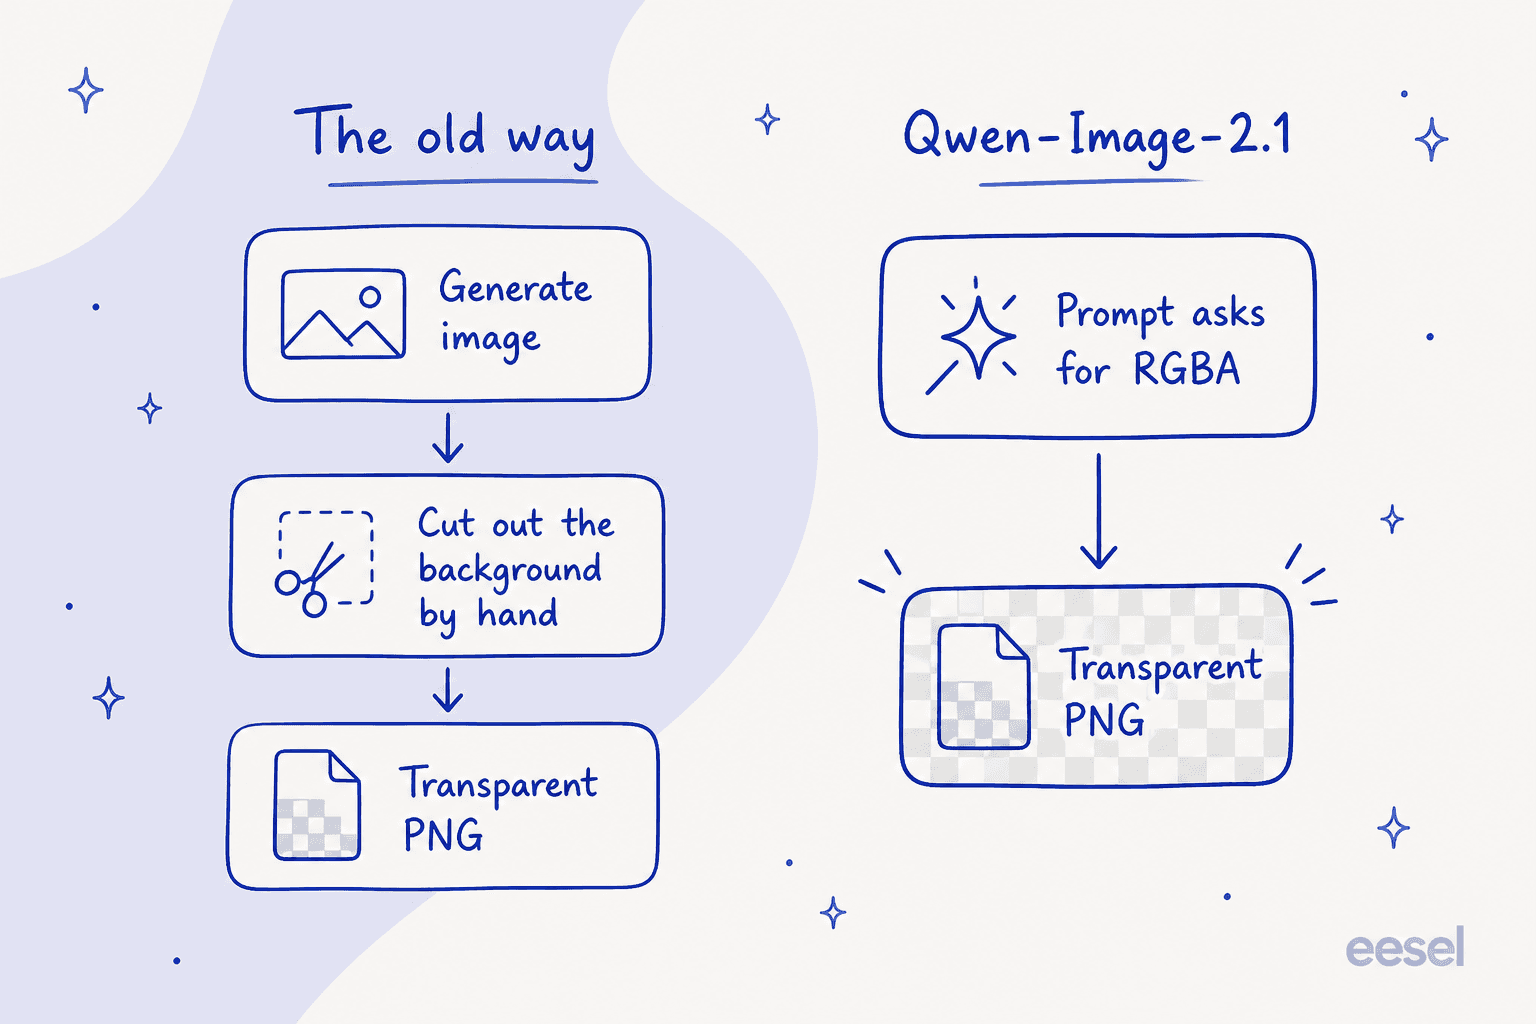
Não é uma ciência inédita para a Qwen. Em dezembro de 2025 a equipe lançou isso como um modelo separado chamado Qwen-Image-Layered; a versão 2.1 incorpora essa capacidade no modelo único e unificado, para você não precisar lidar com dois checkpoints (blog da Qwen). Na prática, isso significa quatro coisas: gerar um elemento transparente a partir de texto, editar uma imagem transparente mantendo o fundo limpo, editar o texto dentro de uma camada transparente e extrair um sujeito de uma foto comum como camada RGBA. O model card até sugere a redação do prompt para ativar o recurso, algo como "This is an RGBA image with transparency ... the background is transparent" (model card do HF).
Se você faz thumbnails, stickers, fotos de produto ou assets de UI, esse único recurso é o motivo para se importar. É a parte que um criador de IA no X apontou como a mais promissora, e é a coisa mais clara que o Qwen Image 2.1 faz e que os modelos fechados maiores ainda obrigam você a fazer à mão.
O que mais melhorou
A transparência leva a manchete, mas as melhorias de edição são onde a maioria das pessoas vai passar o tempo.
- Até 10 imagens de referência. Você pode dar ao modelo até dez entradas e pedir que ele as componha em uma cena coerente: uma foto de grupo feita de seis retratos separados, uma prova virtual a partir de uma modelo mais roupas, sapatos, bolsa e chapéu, ou um cômodo montado a partir de dez fotos de mobília (blog da Qwen).
- Edição local flexível. Você indica o que mudar com círculos coloridos, anotações pintadas ou um par de imagem original mais máscara, e a opção de máscara preserva o resto da imagem intacto (blog da Qwen).
- Preservação de fidelidade. Rostos continuam reconhecíveis entre as edições, e produtos mantêm texto, textura e forma, que é justamente o que costuma quebrar quando você pede a um modelo para reestilizar um objeto com rótulo (blog da Qwen).
- 2K nativo, sete proporções. A saída chega a 2048x2048 em 1:1 e 2752x1536 em 16:9, então você não precisa ampliar depois uma renderização de 1 MP (model card do HF).
A renderização de texto merece uma linha própria, porque é o ponto a que a turma dos pesos abertos sempre volta. O modelo pondera não só as palavras, mas também o estilo da fonte e o layout em relação a toda a composição (blog da Qwen), e no Hacker News o veredito foi direto:
"The text rendering definitely is much, much better than anything else on the open weights market right now. Small text fidelity is quite good. It seems like the text encoder however gets a little bit overloaded with larger prompts"

Esse "much, much better" vem com um asterisco, que explico na seção de opiniões, porque nem todos concordam que o texto sai limpo.
Como funciona por dentro
Esta é a parte que explica por que um modelo de 7B consegue acompanhar outros muito maiores. O Qwen Image 2.1 se apoia em dois truques de eficiência em vez de tamanho bruto.
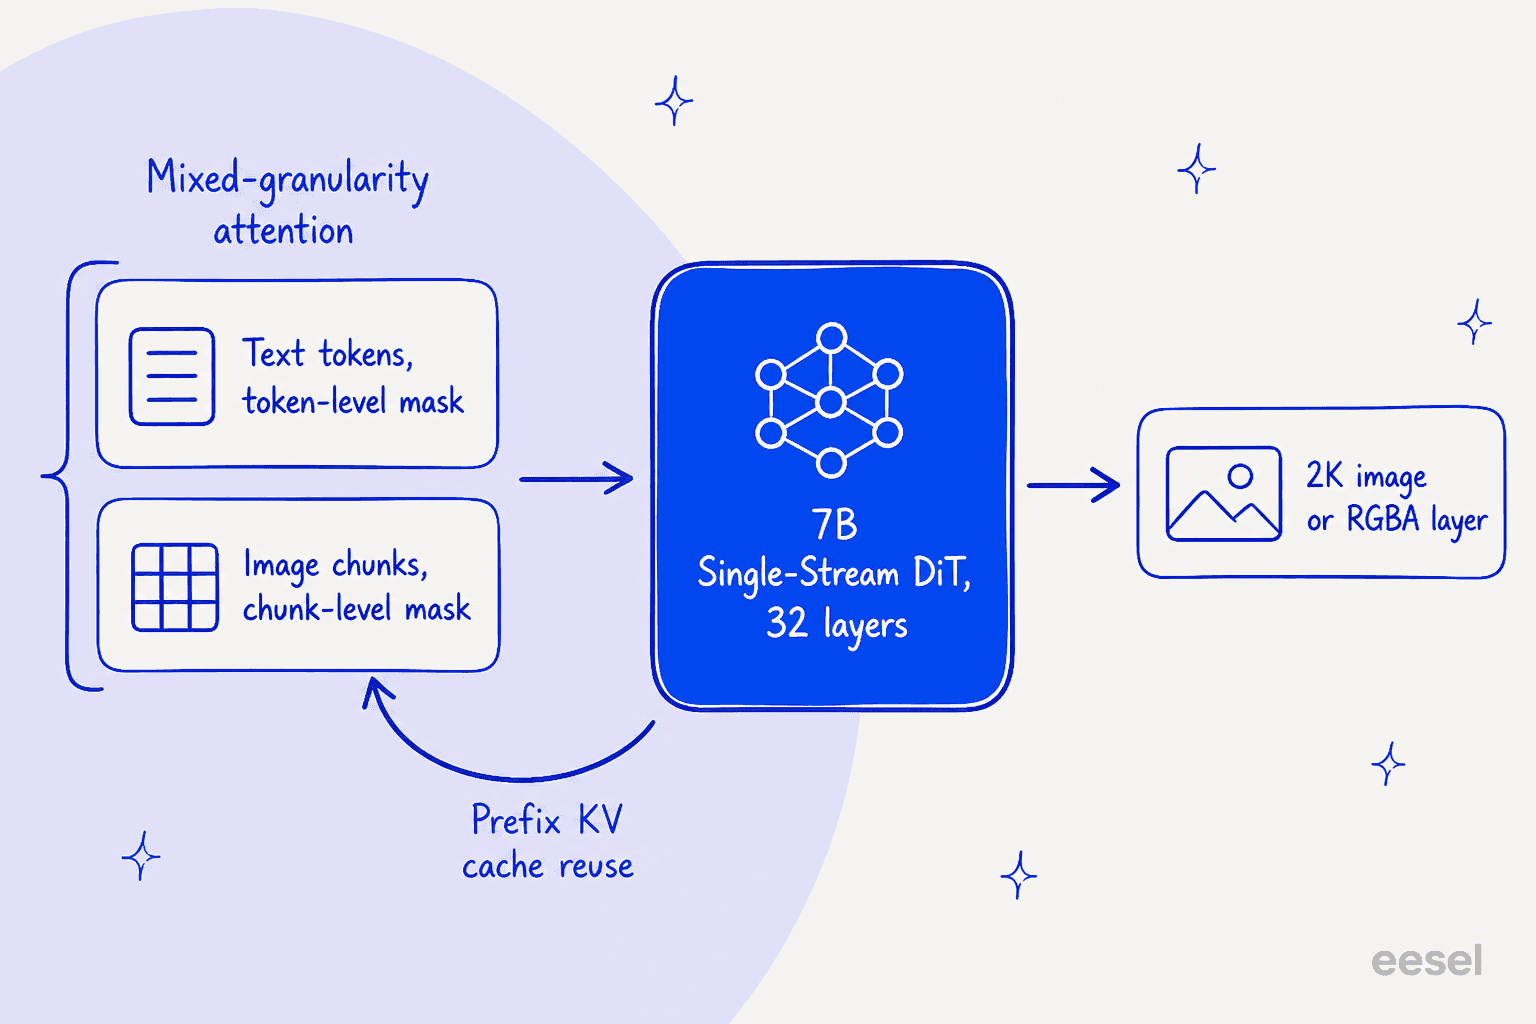
O primeiro é a atenção de granularidade mista. Os tokens de texto, ou seja, o prefixo do sistema e suas instruções de edição, recebem uma máscara causal fina em nível de token, enquanto a imagem em si é tratada com uma máscara mais grossa em nível de chunk. É no texto que a precisão importa, então ele recebe o tratamento detalhado; a imagem recebe o mais barato (blog da Qwen). O segundo é a reutilização do cache KV de prefixo: suas imagens de entrada e instruções são contexto estático, então o modelo as calcula uma vez, guarda em cache e reutiliza em cada passo seguinte em vez de recalcular (blog da Qwen). Ambos miram diretamente o custo de editar com várias imagens de referência, que é exatamente onde um modelo ingênuo engasgaria.
Se você quer construir em cima dele, o modelo já tem um ecossistema: treinamento de LoRA pelo DiffSynth-Studio do ModelScope, além de adaptadores da comunidade, finetunes e quantizações listados na árvore de modelos. O ControlNet, notavelmente, não é mencionado em nenhum material oficial, então trate-o como inexistente até aparecer um port da comunidade.
A pegadinha da licença
Esta é a parte que eu leria antes de você se apegar. O Qwen-Image original saiu sob Apache 2.0, a licença permissiva que deixa você fazer basicamente qualquer coisa, inclusive trabalho comercial. O Qwen Image 2.1 não. Ele sai sob a Qwen Research License, que concede uma "non-exclusive, worldwide ... royalty-free limited license ... for non-commercial purposes only", com uso comercial exigindo uma concessão separada da Alibaba.
A comunidade open source percebeu imediatamente, e a reação no Hacker News foi pontual:
"Calling open-weights as open-source in marketing materials is the usual misrepresentation. But now with the restriction on commercial use (which is against opensource definition) it is not even open-weights, technically it would be more accurate to call it weights-available."
É uma leitura justa. Você pode baixar os pesos, rodá-los, fazer fine-tuning e compartilhar suas alterações, desde que seja para pesquisa ou avaliação e você mantenha os avisos de atribuição. O que você não pode é colocar a saída em um produto comercial sem escrever para a Alibaba pedindo uma licença. É uma mudança real no que "aberto" significa aqui, e é a maior reclamação sobre o lançamento. Para ser justo com a Qwen, muitos laboratórios estão indo nessa direção, e uma licença de pesquisa ainda é mais do que a maioria dos modelos fechados oferece. Só não é a liberdade total da Apache que as pessoas esperavam.
Como acessar e quanto custa
Há várias formas de entrar, e a certa depende inteiramente do que você vai fazer com ele.
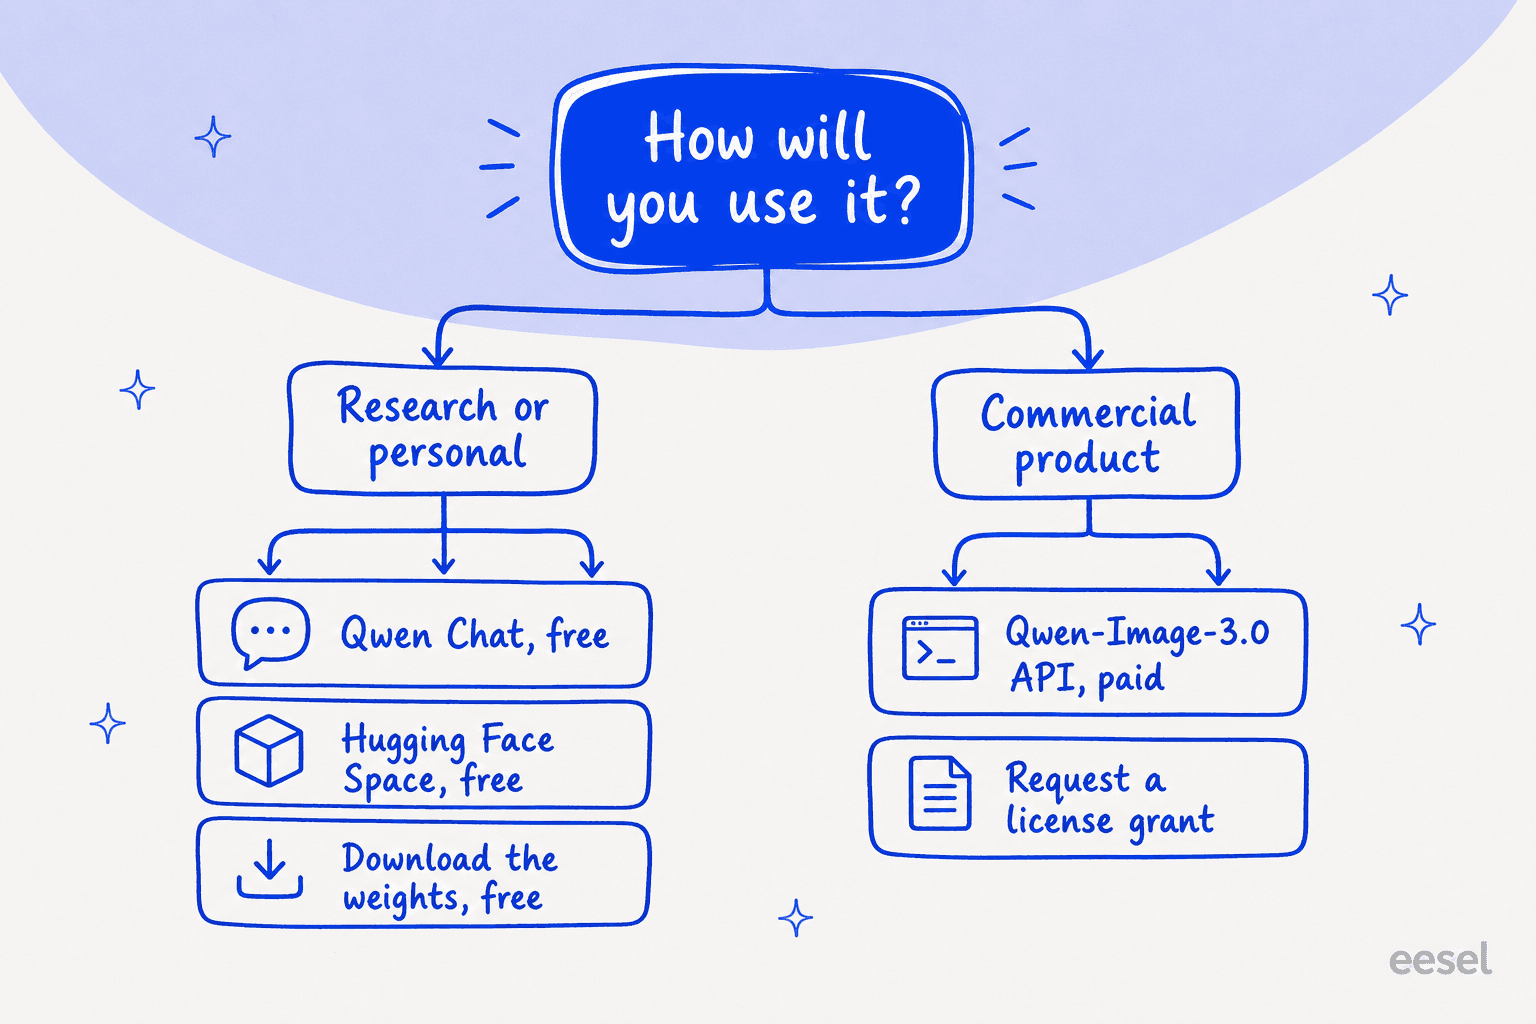
Se você só quer testar, os caminhos mais rápidos são gratuitos:
| Caminho | Custo | Observações |
|---|---|---|
| Hugging Face Space | Grátis | Demo hospedada oficial do modelo 2.1 exato, sem instalação, fila limitada |
| Qwen Chat | Grátis | Geração e edição de imagens integradas ao assistente da Qwen |
| Pesos no Hugging Face | Download gratuito | Licença não comercial, exige sua própria GPU |
| Pesos no ModelScope | Download gratuito | Os mesmos pesos, espelhados para a Ásia |
API paga oficial (qwen-image-2.1) | Não oferecida | O Model Studio serve geração de imagem com os IDs 3.0 |
Para uma carga de trabalho comercial, o que você tem é a API paga, e ela roda na linha 3.0, não na 2.1. O Alibaba Cloud Model Studio cobra por imagem gerada com sucesso (preços do Model Studio):
| Modelo | Resolução | Preço de saída |
|---|---|---|
qwen-image-3.0 | 1k e 2k | US$ 0,03 / imagem |
qwen-image-3.0-pro | 1k | US$ 0,04 / imagem |
qwen-image-3.0-pro | 2k | US$ 0,075 / imagem |
Imagens de entrada custam US$ 0,003 cada, gerações com falha não são cobradas e há uma cota gratuita de 10 imagens válida por 90 dias. Hospedagens de terceiros como fal.ai e Replicate oferecem o Qwen Image 2.0, não o 2.1, muito provavelmente porque a licença não comercial as impede de hospedar o 2.1 para uso pago (Price Per Token).
Mais uma observação prática sobre rodar você mesmo: o rótulo "7B" subestima o hardware. Ele precisa de cerca de 16 GiB em Q8 e até 17 GB durante uma execução de 50 passos, embora com offload para a CPU um usuário tenha conseguido baixar para 3,05 GiB de VRAM. As velocidades ficam em torno de 5 a 25 segundos por imagem de 1 MP em uma placa moderna, e cerca de 90 segundos para uma renderização 4K em uma 5080.
O que as pessoas realmente dizem
A reação da comunidade está realmente dividida, e os dois lados merecem ser ouvidos. Os pontos positivos se concentram na relação tamanho-qualidade e na velocidade. Do r/comfyui:
"I tested image editing with the default 25 steps at 2K resolution, and it takes about 2 minutes on a 5060 Ti. The output images are noticeably sharper than 2511, so I'd say this is a huge step forward. Considering the model is only 7B, I really can't ask for much more."

A avaliação mais equilibrada que encontrei elogiava o modelo como local e citava o defeito de qualidade específico que as pessoas continuam apontando, um tom amarelado sintético (r/StableDiffusion):
"In terms of being able to run it at a reasonable speed in a local environment, I'd say it's a good model. However, at commonly used resolutions ... the results did feel quite synthetic. In particular, the characteristic yellowish color tone and graininess made it feel like the model was trained on a lot of GPT Image data."
E o elogio à renderização de texto é contestado. As mesmas imagens de comparação que impressionaram um leitor do Hacker News pareceram embaralhadas para outro, que avaliou o Ideogram melhor para texto limpo. Uma falha recorrente e bem concreta apareceu no r/comfyui: um usuário "just can't get the model to generate infographics only in English ... it always adds some other parts I never prompted for in Chinese." A aderência ao prompt em prompts de composição complexa é o outro ponto fraco apontado pelos primeiros testadores.
No saldo, uma execução independente do GenAI Showdown deu a ele 7 de 15 contra 4 de 15 da versão aberta anterior, um salto real com um terço do tamanho, com artefatos visíveis de dados sintéticos.
Você deveria usar o Qwen Image 2.1?
Minha opinião: este é o modelo de imagem de pesos abertos mais interessante do momento para um tipo específico de pessoa, e uma armadilha para outro. Se você quer geração nativa de PNG transparente rodando no seu próprio hardware, para pesquisa, prototipagem ou projetos pessoais, baixe hoje, porque nenhum outro modelo aberto faz isso de forma tão limpa, e 7B em uma GPU de consumo é um presente. Com o sampler e a quantidade de passos certos, vários testadores o avaliam como a melhor opção local.
Se você produz trabalho comercial, vá com calma. A licença só para pesquisa significa que os pesos gratuitos não são almoço grátis, e a "API oficial" que você usaria é na verdade o qwen-image-3.0, um modelo diferente. E se o seu trabalho vive ou morre de texto pequeno impecável ou de um visual fotográfico limpo e não sintético, teste contra o Ideogram ou um modelo maior antes de se comprometer; o tom amarelado e os problemas de texto em prompts longos são reais e relatados por quem queria gostar dele.
eesel para transformar modelos como este em trabalho finalizado
Um modelo é infraestrutura. O Qwen Image 2.1 entrega geração de imagem bruta, mas você ainda precisa integrá-lo a um fluxo de trabalho, alimentá-lo com contexto e transformar a saída em algo que seja publicado. Essa é a lacuna que a eesel foi criada para fechar: em vez de um modelo bruto, a eesel entrega colegas de equipe de IA prontos para trabalhar em tarefas definidas, cada um chegando com as habilidades, integrações e contexto da empresa que a função exige.
O mais próximo dos modelos de imagem é o redator de blog com IA da eesel, um colega que pesquisa, redige e ilustra conteúdo longo de ponta a ponta; a geração de imagens como a da Qwen é uma das ferramentas que ele usa por baixo dos panos, não algo que sobra para você operar. Você traz o tema e a marca; ele cuida do processo, da pesquisa até um rascunho pronto para publicar com imagens.
Se você prefere contratar a capacidade pronta em vez de montá-la a partir de pesos e scripts, pode testar a eesel de graça.
Perguntas frequentes
O Qwen Image 2.1 é gratuito?
É gratuito para testar e gratuito para rodar. Você pode usá-lo sem custo no Qwen Chat, no Space de demonstração oficial do Hugging Face, ou baixando os pesos abertos e rodando na sua própria GPU. A pegadinha é a licença: o Qwen Image 2.1 é licenciado apenas para uso não comercial (pesquisa e avaliação), então "gratuito para rodar" não é o mesmo que "gratuito para vender com ele".
Quanto custa a API do Qwen Image 2.1?
Não existe um modelo de API pago qwen-image-2.1. O Model Studio da Alibaba Cloud oferece sua API de imagem comercial com os IDs do qwen-image-3.0, a US$ 0,03 por imagem gerada (1k e 2k) no qwen-image-3.0 e até US$ 0,075 por imagem 2k no qwen-image-3.0-pro. Se você precisa do Qwen Image 2.1 especificamente para trabalho comercial, baixe os pesos e peça uma concessão de licença separada.
Que GPU preciso para rodar o Qwen Image 2.1?
Apesar do rótulo "7B", é mais pesado do que parece. Usuários relatam cerca de 16 GiB de VRAM em Q8 e até 17 GB durante uma geração de 50 passos, então uma placa da classe 3090, 4090 ou 5080 atende com folga. Com offload para a CPU ele roda com apenas ~3 GiB de VRAM, até em um notebook, embora uma única imagem 512x512 possa levar cerca de três minutos só na CPU.
O que é transparência nativa no Qwen Image 2.1?
Transparência nativa significa que o modelo pode gerar diretamente imagens RGBA com um canal alfa real a partir de um prompt, em vez de obrigar você a gerar uma imagem e depois recortar o fundo. Ele também edita camadas transparentes e consegue extrair um sujeito de uma foto comum como recorte transparente. É a principal mudança do Qwen Image 2.1, que incorpora o que antes era um modelo separado, o Qwen-Image-Layered.
O Qwen Image 2.1 é melhor que os modelos de imagem anteriores da Qwen?
Na maioria dos aspectos, sim: tem cerca de um terço do tamanho (7B contra 20B), adiciona transparência nativa, edita com até 10 imagens de referência, e testadores no r/comfyui dizem que o resultado é visivelmente mais nítido que o da versão 2511. As contrapartidas são a licença restritiva e um visual sintético, levemente amarelado, de que alguns avaliadores não gostam.