

Qwen Image 2.1 ist Alibabas neues Open-Weight-Bildmodell, veröffentlicht am 20. September 2026, und sein Hauptkniff ist native Transparenz: Es erzeugt RGBA-Bilder mit echtem Alphakanal direkt aus einem Prompt, ganz ohne manuelles Freistellen des Hintergrunds (Qwen-Blog). Es ist außerdem deutlich kleiner als zuvor, ein 7B-Bildgenerator statt des alten 20B-Modells, läuft also auf einer einzelnen Consumer-GPU und kann mit bis zu 10 Referenzbildern in nativem 2K bearbeiten.
Es gibt einen Haken, den du kennen solltest, bevor du darauf aufbaust. Die Lizenz wechselte von Apache 2.0, die das ursprüngliche Qwen-Image abdeckte, zu einer Lizenz nur für Forschung, die kommerzielle Nutzung untersagt, sofern keine separate Genehmigung vorliegt (LICENSE). Und es gibt keine bezahlte qwen-image-2.1-API; Alibabas kommerzielle Bild-API läuft stattdessen auf dem neueren qwen-image-3.0.
Für wen ist es also? Wenn du transparente PNGs lokal erzeugen, experimentieren oder forschen willst, ist es ein richtig spannender Release und kostenlos ausführbar. Wenn du kommerzielle Kreativarbeit auslieferst, lies zuerst die Lizenz oder greif zur bezahlten API.
Was Qwen Image 2.1 eigentlich ist
Qwen Image 2.1 ist das neueste Bildmodell des Qwen-Teams von Alibaba und erledigt in einem Satz Gewichte zwei Aufgaben: Text-zu-Bild-Generierung und Bildbearbeitung. Der Teil, der zeichnet, ist ein Diffusion Transformer mit nur 7B Parametern, aufgebaut aus 32 Single-Stream-DiT-Schichten (Qwen-Blog). Es erschien am 20. September 2026 gleichzeitig auf Hugging Face, ModelScope und GitHub, mit Day-Zero-Unterstützung in ComfyUI, Diffusers, vLLM-Omni und SGLang.
Die Zahl, die du dir merken solltest, ist die 7B. Das vorherige offene Qwen-Bildmodell hatte 20B Parameter mit einem 40,9 GB großen Bild-Transformer, dieses landet bei 7B / 14,2 GB (7,26 GB bei INT8), wie ein Tester auf X darlegte:
"Qwen's Image 2.1 released but it come with lots of improvements but just as many caveats. The old Qwen-Image-2512 was a 20B model with a massive 40.9GB BF16 image transformer. But the new Qwen-Image-2.1 comes with 7B visual generator, 14.2GB BF16, 7.26GB INT8"
Diese Verkleinerung ist die ganze Geschichte des Releases: Alibaba hat das meiste von dem behalten, was das größere Modell konnte, ein Aushängeschild-Feature hinzugefügt und das Ganze auf Hardware lauffähig gemacht, die Leute tatsächlich besitzen.
Native Transparenz ist die eigentliche Schlagzeile
Jedes Bildmodell kann ein Bild zeichnen. Fast keines kann dir einen sauberen transparenten Ausschnitt liefern. Der übliche Ablauf ist: erst generieren, dann das Ergebnis durch einen Hintergrundentferner schicken und hoffen, dass die Kanten um Haare und Glas überleben. Qwen Image 2.1 verkürzt das: Es entscheidet anhand deines Prompts, ob es ein normales Bild oder ein RGBA-Bild mit echtem Alphakanal ausgibt, und erzeugt die transparente Version direkt (Qwen-Blog).
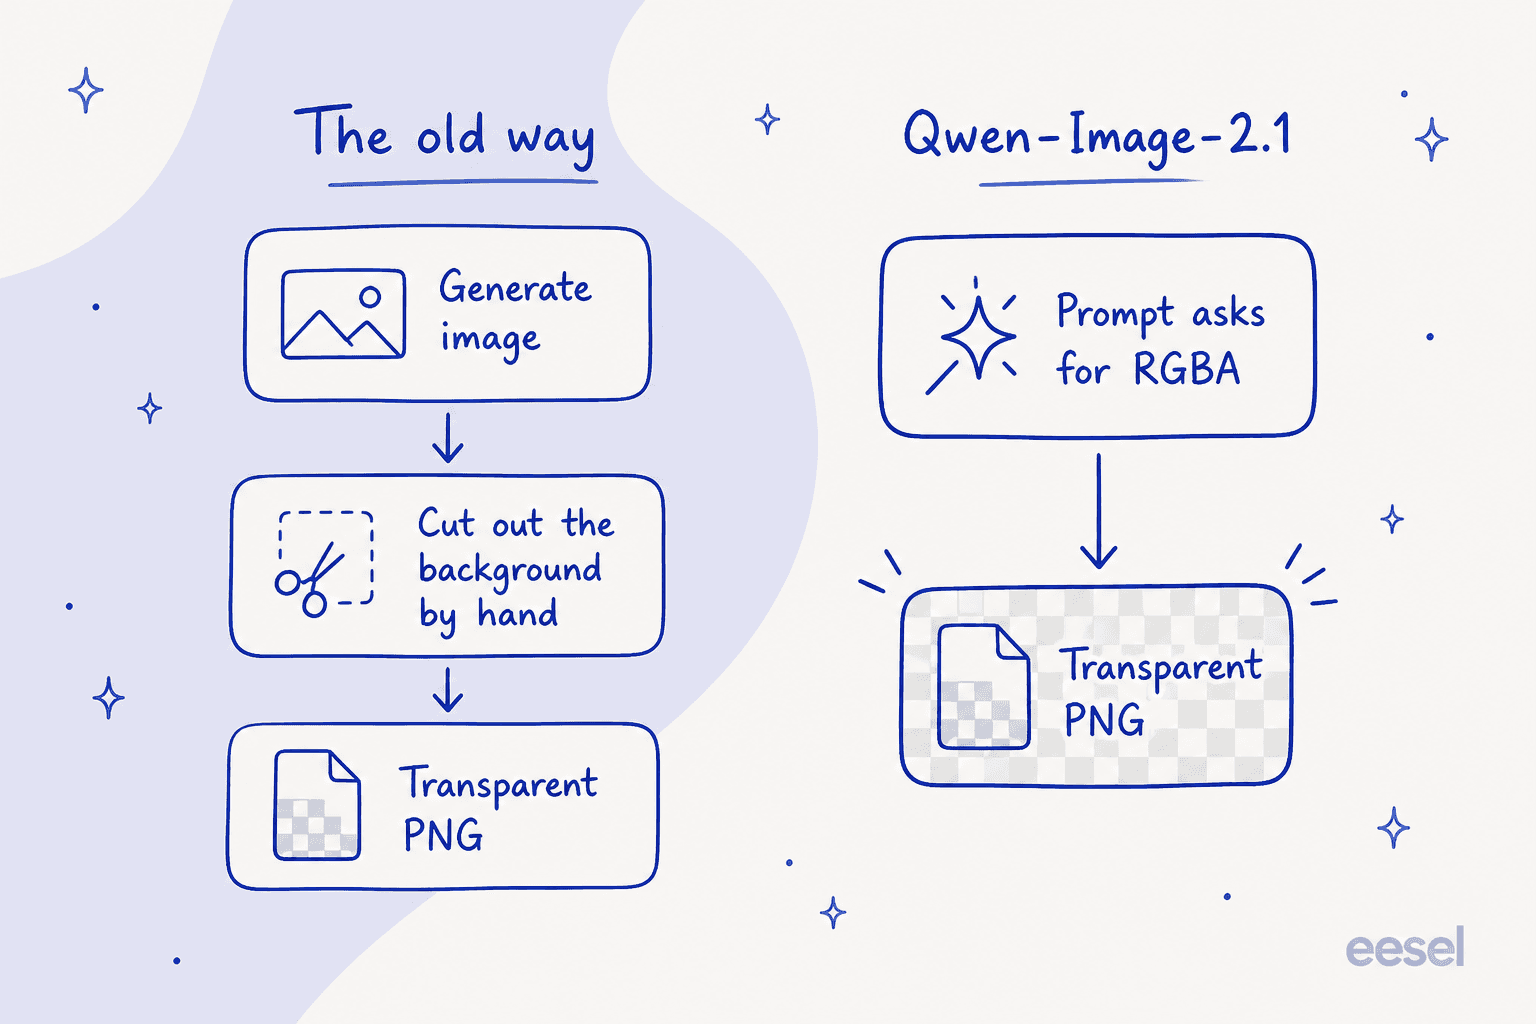
Für Qwen ist das keine ganz neue Wissenschaft. Schon im Dezember 2025 hatte das Team dies als eigenständiges Modell namens Qwen-Image-Layered veröffentlicht; 2.1 integriert diese Fähigkeit in das eine einheitliche Modell, sodass du nicht zwei Checkpoints jonglieren musst (Qwen-Blog). In der Praxis bedeutet das vier Dinge: ein transparentes Element aus Text erzeugen, ein transparentes Bild bearbeiten und dabei den Hintergrund klar halten, den Text innerhalb einer transparenten Ebene bearbeiten und ein Motiv aus einem gewöhnlichen Foto als RGBA-Ebene extrahieren. Die Model Card schlägt sogar die Prompt-Formulierung vor, die das auslöst, etwa in der Art von "This is an RGBA image with transparency ... the background is transparent" (HF-Model-Card).
Wenn du Thumbnails, Sticker, Produktfotos oder UI-Assets machst, ist dieses eine Feature der Grund, dich dafür zu interessieren. Es ist der Teil, den ein KI-Creator auf X als am vielversprechendsten bezeichnete, und es ist das Klarste, was Qwen Image 2.1 kann und wofür die größeren geschlossenen Modelle dich noch von Hand arbeiten lassen.
Was wurde sonst noch besser
Transparenz sorgt für die Schlagzeile, aber bei den Bearbeitungsverbesserungen werden die meisten Leute ihre Zeit verbringen.
- Bis zu 10 Referenzbilder. Du kannst dem Modell bis zu zehn Eingaben geben und es zu einer stimmigen Szene zusammensetzen lassen: ein Gruppenfoto aus sechs einzelnen Porträts, eine virtuelle Anprobe aus einem Model plus Kleidung, Schuhen, Tasche und Hut oder ein Raum aus zehn Einrichtungsfotos (Qwen-Blog).
- Flexible lokale Bearbeitung. Du zeigst mit farbigen Kreisen, aufgemalten Anmerkungen oder einem Paar aus Originalbild und Maske, was geändert werden soll, und die Masken-Option lässt den Rest des Bildes unangetastet (Qwen-Blog).
- Treue-Erhalt. Gesichter bleiben über Bearbeitungen hinweg erkennbar, und Produkte behalten Text, Textur und Form, also genau das, was normalerweise kaputtgeht, wenn man ein Modell bittet, ein beschriftetes Objekt umzustylen (Qwen-Blog).
- Natives 2K, sieben Seitenverhältnisse. Die Ausgabe reicht bis 2048x2048 bei 1:1 und 2752x1536 bei 16:9, du musst also kein 1-MP-Rendering nachträglich hochskalieren (HF-Model-Card).
Die Textdarstellung verdient eine eigene Zeile, denn sie ist das, worauf die Open-Weight-Szene immer wieder zurückkommt. Das Modell gewichtet nicht nur die Wörter, sondern auch ihren Schriftstil und ihr Layout gegenüber der gesamten Komposition (Qwen-Blog), und auf Hacker News fiel das Urteil deutlich aus:
"The text rendering definitely is much, much better than anything else on the open weights market right now. Small text fidelity is quite good. It seems like the text encoder however gets a little bit overloaded with larger prompts"

Dieses "much, much better" kommt mit einem Sternchen, auf das ich im Abschnitt zur Stimmung zurückkomme, denn nicht alle finden den Text sauber.
Wie es unter der Haube funktioniert
Hier erfährst du, warum ein 7B-Modell mit viel größeren mithalten kann. Qwen Image 2.1 setzt auf zwei Effizienztricks statt auf reine Größe.
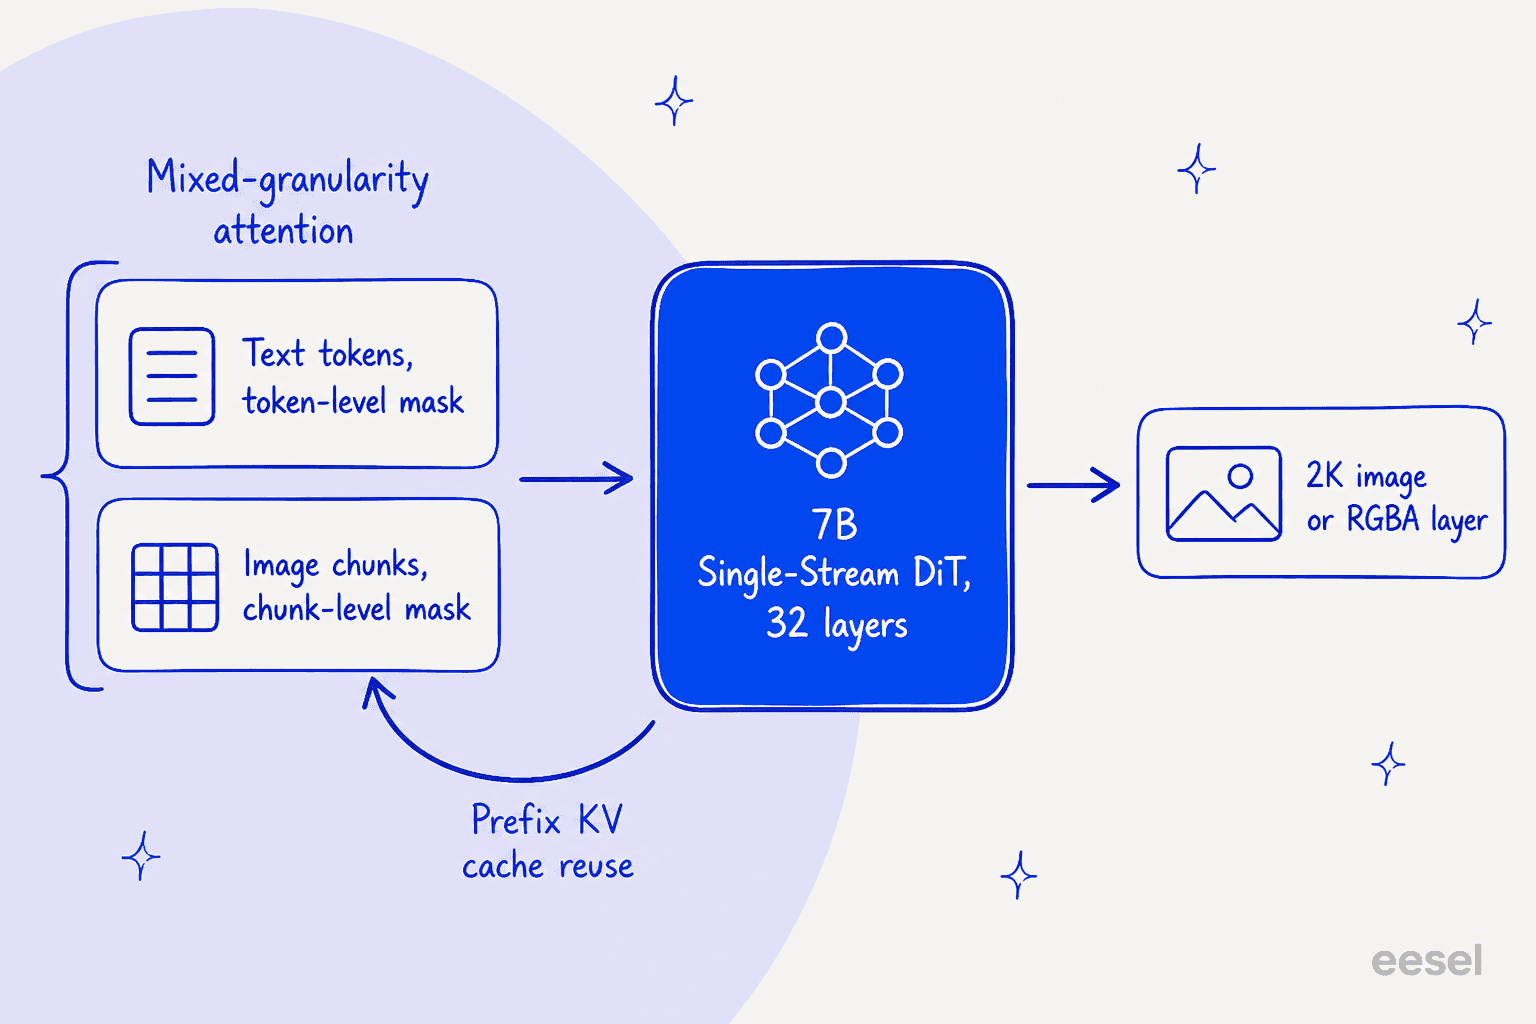
Der erste ist Aufmerksamkeit mit gemischter Granularität. Text-Tokens, also das System-Präfix und deine Bearbeitungsanweisungen, bekommen eine feine kausale Maske auf Token-Ebene, während das Bild selbst mit einer gröberen Maske auf Chunk-Ebene behandelt wird. Beim Text kommt es auf Präzision an, also bekommt er die detaillierte Behandlung; das Bild die günstigere (Qwen-Blog). Der zweite ist die Wiederverwendung des Prefix-KV-Cache: Deine Eingabebilder und Anweisungen sind statischer Kontext, also berechnet das Modell sie einmal, cached sie und verwendet sie in jedem späteren Schritt wieder, statt neu zu rechnen (Qwen-Blog). Beide zielen direkt auf die Kosten der Bearbeitung mit mehreren Referenzbildern, genau dort, wo ein naives Modell einbrechen würde.
Wenn du darauf aufbauen willst, hat das Modell bereits ein Ökosystem: LoRA-Training über DiffSynth-Studio von ModelScope sowie Community-Adapter, Finetunes und Quantisierungen, die im Model Tree aufgeführt sind. ControlNet wird in keinem der offiziellen Materialien erwähnt, behandle es also als nicht vorhanden, bis ein Community-Port auftaucht.
Der Haken bei der Lizenz
Das ist der Teil, den ich lesen würde, bevor du dich daran gewöhnst. Das ursprüngliche Qwen-Image erschien unter Apache 2.0, der permissiven Lizenz, die dir praktisch alles erlaubt, auch kommerzielle Arbeit. Qwen Image 2.1 nicht. Es erscheint unter der Qwen Research License, die eine "non-exclusive, worldwide ... royalty-free limited license ... for non-commercial purposes only" gewährt, wobei kommerzielle Nutzung eine separate Genehmigung von Alibaba erfordert.
Die Open-Source-Community bemerkte das sofort, und die Reaktion auf Hacker News fiel scharf aus:
"Calling open-weights as open-source in marketing materials is the usual misrepresentation. But now with the restriction on commercial use (which is against opensource definition) it is not even open-weights, technically it would be more accurate to call it weights-available."
Das ist eine faire Lesart. Du kannst die Gewichte herunterladen, ausführen, feinabstimmen und deine Änderungen teilen, solange es um Forschung oder Evaluierung geht und du die Hinweise zur Namensnennung beibehältst. Was du nicht darfst: die Ausgabe in ein kommerzielles Produkt einbauen, ohne Alibaba per E-Mail um eine Lizenz zu bitten. Das ist eine echte Änderung dessen, was "offen" hier bedeutet, und der größte Kritikpunkt am Release. Fairerweise gegenüber Qwen: Viele Labs bewegen sich in diese Richtung, und eine Forschungslizenz ist immer noch mehr, als die meisten geschlossenen Modelle bieten. Es ist nur nicht das Apache-Freibier, das die Leute erwartet hatten.
So kommst du heran und was es kostet
Es gibt mehrere Zugänge, und der richtige hängt ganz davon ab, was du damit vorhast.
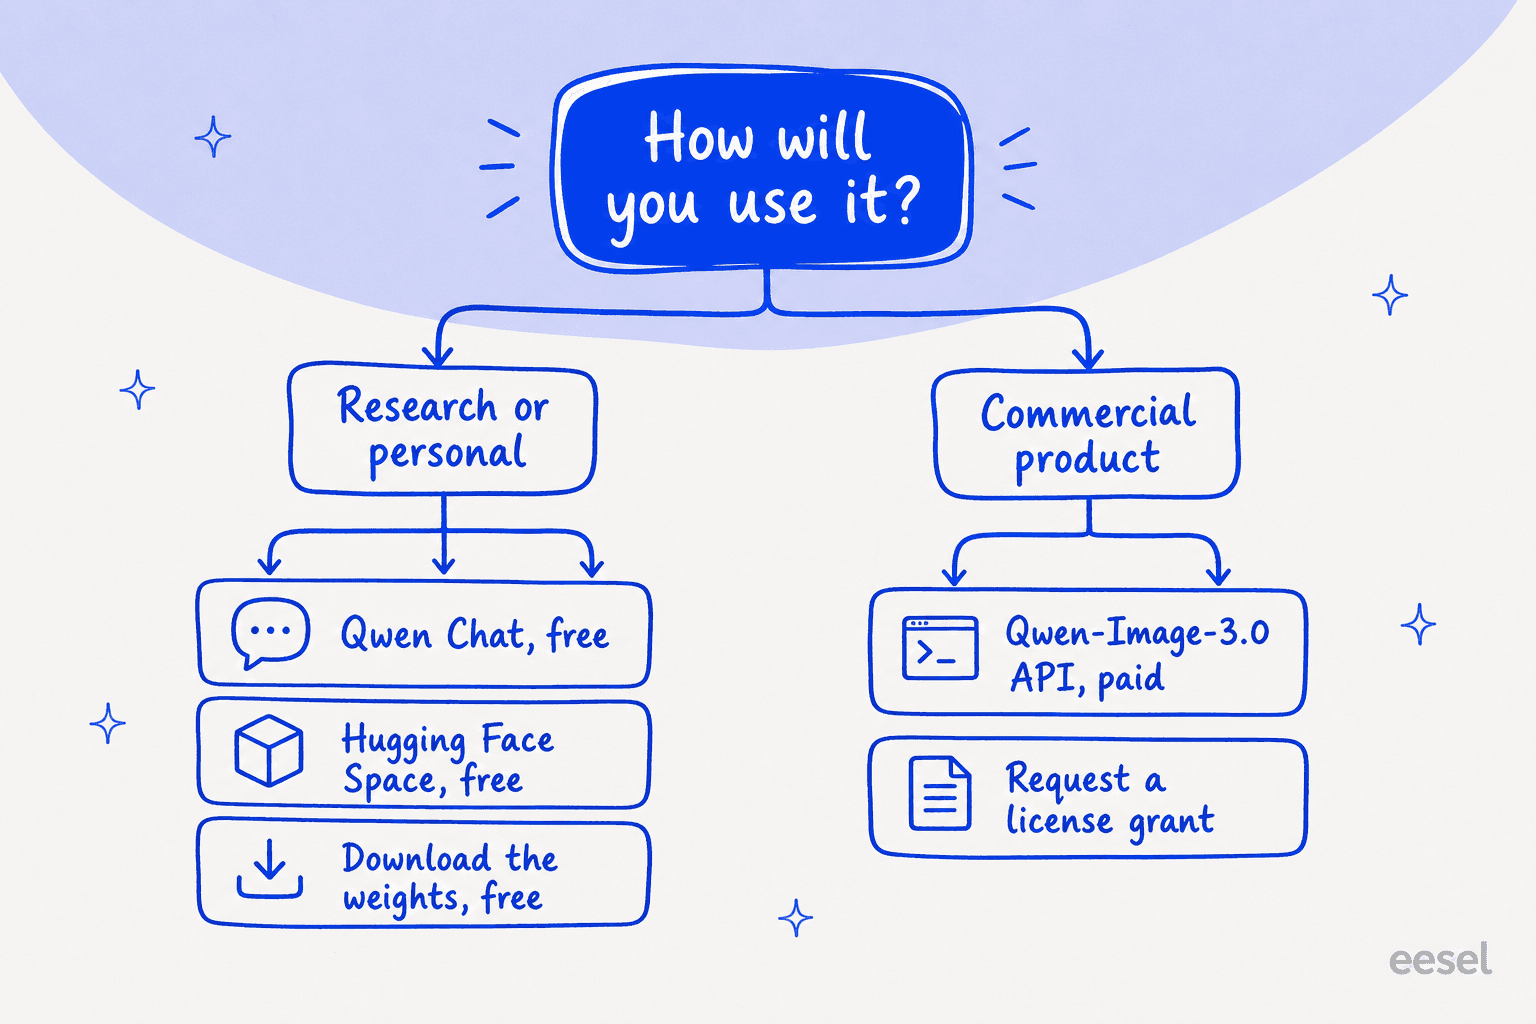
Wenn du es nur ausprobieren willst, sind die schnellsten Wege kostenlos:
| Weg | Kosten | Hinweise |
|---|---|---|
| Hugging Face Space | Kostenlos | Offizielle gehostete Demo des genauen 2.1-Modells, keine Installation, Warteschlange begrenzt |
| Qwen Chat | Kostenlos | Bildgenerierung und -bearbeitung im Assistenten von Qwen integriert |
| Hugging-Face-Gewichte | Kostenloser Download | Nicht-kommerzielle Lizenz, eigene GPU nötig |
| ModelScope-Gewichte | Kostenloser Download | Dieselben Gewichte, für Asien gespiegelt |
Offizielle bezahlte API (qwen-image-2.1) | Nicht angeboten | Model Studio bietet Bildgenerierung stattdessen unter den 3.0-IDs an |
Für einen kommerziellen Einsatz kommt eigentlich nur die bezahlte API in Frage, und die läuft auf der 3.0-Linie, nicht auf 2.1. Alibaba Cloud Model Studio berechnet sie pro erfolgreich generiertem Bild (Model-Studio-Preise):
| Modell | Auflösung | Ausgabepreis |
|---|---|---|
qwen-image-3.0 | 1k und 2k | 0,03 $ / Bild |
qwen-image-3.0-pro | 1k | 0,04 $ / Bild |
qwen-image-3.0-pro | 2k | 0,075 $ / Bild |
Eingabebilder kosten je 0,003 $, fehlgeschlagene Generierungen werden nicht berechnet, und es gibt ein Freikontingent von 10 Bildern, 90 Tage gültig. Drittanbieter wie fal.ai und Replicate führen Qwen Image 2.0, nicht 2.1, höchstwahrscheinlich weil die nicht-kommerzielle Lizenz sie daran hindert, 2.1 für bezahlte Nutzung zu hosten (Price Per Token).
Noch ein praktischer Hinweis zum eigenen Betrieb: Die Bezeichnung "7B" untertreibt die Hardware-Anforderungen. Es braucht etwa 16 GiB bei Q8 und bis zu 17 GB bei einem Lauf mit 50 Schritten, wobei ein Nutzer es mit CPU-Offload auf 3,05 GiB VRAM herunterbrachte. Die Geschwindigkeit liegt bei etwa 5 bis 25 Sekunden pro 1-MP-Bild auf einer modernen Karte und rund 90 Sekunden für ein 4K-Rendering auf einer 5080.
Was die Leute tatsächlich sagen
Die Reaktion der Community ist wirklich gespalten, und beide Seiten sind hörenswert. Das Positive dreht sich um das Verhältnis von Größe zu Qualität und um die Geschwindigkeit. Von r/comfyui:
"I tested image editing with the default 25 steps at 2K resolution, and it takes about 2 minutes on a 5060 Ti. The output images are noticeably sharper than 2511, so I'd say this is a huge step forward. Considering the model is only 7B, I really can't ask for much more."

Die ausgewogenste Bewertung, die ich fand, lobte es als lokales Modell und benannte zugleich das spezifische Qualitätsmerkmal, das die Leute immer wieder bemängeln, einen synthetischen gelblichen Stich (r/StableDiffusion):
"In terms of being able to run it at a reasonable speed in a local environment, I'd say it's a good model. However, at commonly used resolutions ... the results did feel quite synthetic. In particular, the characteristic yellowish color tone and graininess made it feel like the model was trained on a lot of GPT Image data."
Und das Lob für die Textdarstellung ist umstritten. Dieselben Vergleichsbilder, die einen Hacker-News-Leser beeindruckten, wirkten auf einen anderen verstümmelt, der Ideogram für sauberen Text höher bewertete. Ein wiederkehrender, sehr konkreter Fehler tauchte auf r/comfyui auf: Ein Nutzer "just can't get the model to generate infographics only in English ... it always adds some other parts I never prompted for in Chinese." Die Prompt-Treue bei komplexen kompositorischen Prompts ist die andere weiche Stelle, die frühe Tester bemängelten.
Unterm Strich bewertete ein unabhängiger GenAI-Showdown-Durchlauf es mit 7 von 15 gegenüber 4 von 15 für die vorherige offene Version, ein echter Sprung bei einem Drittel der Größe, mit sichtbaren Artefakten aus synthetischen Daten.
Solltest du Qwen Image 2.1 nutzen?
Meine Einschätzung: Das ist das interessanteste Open-Weight-Bildmodell des Moments für eine bestimmte Person und eine Falle für eine andere. Wenn du native Generierung transparenter PNGs auf eigener Hardware willst, für Forschung, Prototyping oder private Projekte, lade es heute herunter, denn nichts anderes Offenes macht das so sauber, und 7B auf einer Consumer-GPU ist ein Geschenk. Mit dem richtigen Sampler und der richtigen Schrittzahl bewerten mehrere Tester es als die beste lokale Option.
Wenn du kommerzielle Arbeit produzierst, geh es langsamer an. Die Lizenz nur für Forschung bedeutet, dass die kostenlosen Gewichte kein Gratis-Mittagessen sind, und die "offizielle API", zu der du greifen würdest, ist eigentlich qwen-image-3.0, ein anderes Modell. Und wenn deine Arbeit an makellosem kleinem Text oder einem sauberen, nicht synthetischen Foto-Look hängt, teste es gegen Ideogram oder ein größeres Modell, bevor du dich festlegst; der gelbliche Stich und die Textprobleme bei langen Prompts sind real und werden von Leuten berichtet, die es mögen wollten.
eesel, um aus Modellen wie diesem fertige Arbeit zu machen
Ein Modell ist Infrastruktur. Qwen Image 2.1 liefert dir rohe Bildgenerierung, aber du musst es noch in einen Workflow einbinden, mit Kontext füttern und seine Ausgabe in etwas verwandeln, das ausgeliefert wird. Diese Lücke schließt eesel: Statt eines rohen Modells bekommst du bei eesel einsatzbereite KI-Teammitglieder für klar umrissene Aufgaben, jedes mit den Skills, Integrationen und dem Unternehmenskontext, den die Rolle braucht.
Das den Bildmodellen am nächsten stehende ist der eesel AI Blog Writer, ein Teammitglied, das Long-Form-Inhalte von Anfang bis Ende recherchiert, entwirft und bebildert; Bildgenerierung wie die von Qwen ist eines der Werkzeuge, die es unter der Haube nutzt, nicht etwas, das du selbst bedienen musst. Du bringst das Thema und die Marke mit; es übernimmt die Pipeline von der Recherche bis zum veröffentlichungsreifen Entwurf mit Visuals.
Wenn du die fertige Fähigkeit lieber einstellen willst, als sie aus Gewichten und Skripten zusammenzubauen, kannst du eesel kostenlos testen.
Häufig gestellte Fragen
Ist Qwen Image 2.1 kostenlos nutzbar?
Es ist kostenlos zum Ausprobieren und kostenlos zum Ausführen. Du kannst es ohne Kosten in Qwen Chat, im offiziellen Hugging-Face-Demo-Space nutzen oder die offenen Gewichte herunterladen und auf deiner eigenen GPU laufen lassen. Der Haken ist die Lizenz: Qwen Image 2.1 ist nur für nicht-kommerzielle Nutzung (Forschung und Evaluierung) lizenziert, "kostenlos ausführen" bedeutet also nicht "kostenlos damit verkaufen".
Was kostet die Qwen Image 2.1 API?
Es gibt kein bezahltes API-Modell qwen-image-2.1. Das Model Studio von Alibaba Cloud bietet seine kommerzielle Bild-API stattdessen unter den qwen-image-3.0-IDs an, für 0,03 $ pro generiertem Bild (1k und 2k) bei qwen-image-3.0 und bis zu 0,075 $ pro 2k-Bild bei qwen-image-3.0-pro. Brauchst du Qwen Image 2.1 speziell für kommerzielle Arbeit, lädst du die Gewichte herunter und beantragst eine separate Lizenz.
Welche GPU brauche ich für Qwen Image 2.1?
Trotz der Bezeichnung "7B" ist es anspruchsvoller, als es klingt. Nutzer berichten von rund 16 GiB VRAM bei Q8 und bis zu 17 GB während einer Generierung mit 50 Schritten, mit einer Karte der Klasse 3090, 4090 oder 5080 bist du also gut bedient. Mit CPU-Offloading läuft es mit nur etwa 3 GiB VRAM, sogar auf einem Laptop, wobei ein einzelnes 512x512-Bild allein auf der CPU etwa drei Minuten dauern kann.
Was ist native Transparenz in Qwen Image 2.1?
Native Transparenz bedeutet, dass das Modell direkt aus einem Prompt RGBA-Bilder mit echtem Alphakanal ausgeben kann, statt dass du erst ein Bild generieren und dann den Hintergrund freistellen musst. Es bearbeitet außerdem transparente Ebenen und kann ein Motiv aus einem normalen Foto als transparenten Ausschnitt herauslösen. Das ist die wichtigste Neuerung in Qwen Image 2.1, die das frühere eigenständige Modell Qwen-Image-Layered integriert.
Ist Qwen Image 2.1 besser als die früheren Qwen-Bildmodelle?
In den meisten Punkten ja: Es ist etwa ein Drittel so groß (7B statt 20B), bietet native Transparenz, bearbeitet mit bis zu 10 Referenzbildern, und Tester auf r/comfyui nennen die Ausgabe spürbar schärfer als beim früheren Release 2511. Die Nachteile sind die restriktive Lizenz und ein synthetischer, leicht gelblicher Look, den manche Tester nicht mögen.