

Qwen Image 2.1 es el nuevo modelo de imagen de pesos abiertos de Alibaba, lanzado el 20 de septiembre de 2026, y su gran novedad es la transparencia nativa: genera imágenes RGBA con un canal alfa real directamente desde un prompt, sin paso manual de eliminación de fondo (blog de Qwen). Además es mucho más pequeño que antes, un generador visual de 7B frente al antiguo modelo de 20B, así que funciona en una sola GPU de consumo, y puede editar con hasta 10 imágenes de referencia en 2K nativo.
Hay un problema que conviene conocer antes de construir sobre él. La licencia pasó de la Apache 2.0 que cubría el Qwen-Image original a una licencia solo para investigación que prohíbe el uso comercial sin una autorización aparte (LICENSE). Y no hay una API de pago qwen-image-2.1; la API de imagen comercial de Alibaba funciona con el más reciente qwen-image-3.0.
¿Para quién es entonces? Si quieres generar PNG transparentes en local, experimentar o investigar, es un lanzamiento realmente emocionante y gratis de ejecutar. Si vas a entregar trabajo creativo comercial, lee primero la licencia o recurre a la API de pago.
Qué es realmente Qwen Image 2.1
Qwen Image 2.1 es el último modelo de imagen del equipo de Qwen de Alibaba, y hace dos trabajos con un solo conjunto de pesos: generación de texto a imagen y edición de imágenes. La parte que dibuja es un transformer de difusión de solo 7B de parámetros, construido con 32 capas Single-Stream DiT (blog de Qwen). Salió el 20 de septiembre de 2026 en Hugging Face, ModelScope y GitHub a la vez, con soporte desde el primer día en ComfyUI, Diffusers, vLLM-Omni y SGLang.
La cifra clave es ese 7B. El modelo de imagen abierto anterior de Qwen era de 20B, con un transformer de imagen de 40,9 GB, y este queda en 7B / 14,2 GB (7,26 GB en INT8), como explicó un tester en X:
"Qwen's Image 2.1 released but it come with lots of improvements but just as many caveats. The old Qwen-Image-2512 was a 20B model with a massive 40.9GB BF16 image transformer. But the new Qwen-Image-2.1 comes with 7B visual generator, 14.2GB BF16, 7.26GB INT8"
Esa reducción es toda la historia del lanzamiento: Alibaba conservó la mayor parte de lo que hacía el modelo grande, añadió una función estrella y lo hizo funcionar en hardware que la gente realmente tiene.
La transparencia nativa es el verdadero titular
Todos los modelos de imagen pueden dibujar una imagen. Casi ninguno puede darte un recorte transparente limpio. El flujo habitual es generar primero, pasar el resultado por un eliminador de fondo y esperar que los bordes alrededor del pelo y el cristal sobrevivan. Qwen Image 2.1 lo simplifica: decide a partir de tu prompt si genera una imagen normal o una imagen RGBA con un canal alfa real, y genera la versión transparente directamente (blog de Qwen).
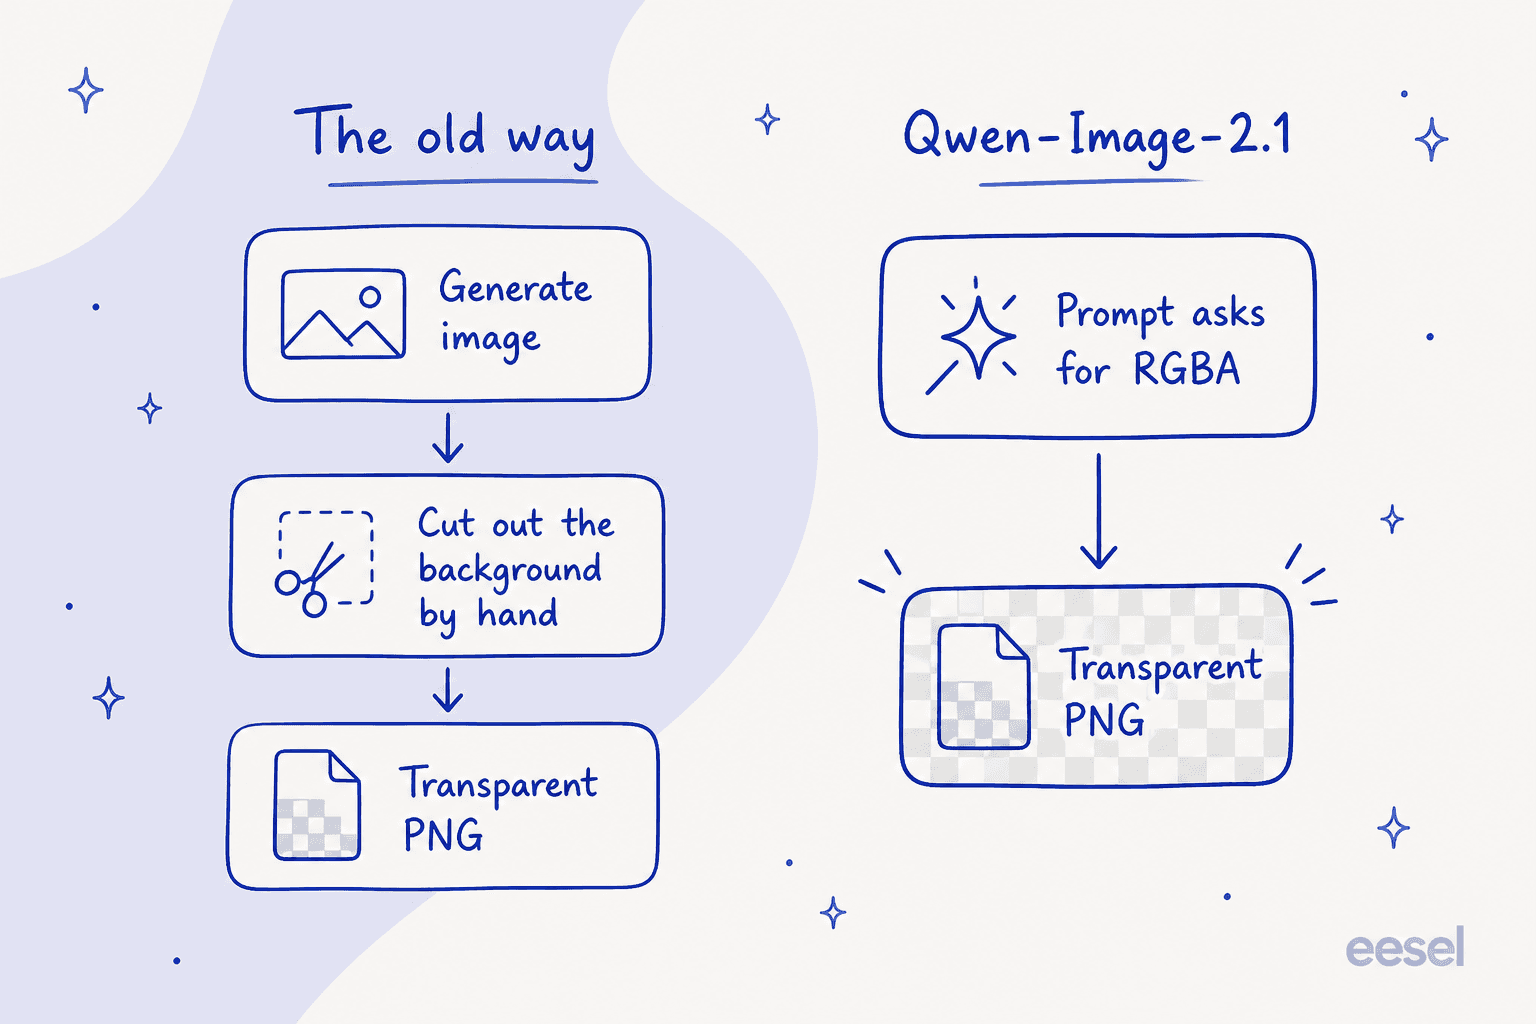
No es una ciencia totalmente nueva para Qwen. En diciembre de 2025 el equipo lanzó esto como un modelo aparte llamado Qwen-Image-Layered; la 2.1 integra esa capacidad en el modelo unificado para que no tengas que manejar dos checkpoints (blog de Qwen). En la práctica significa cuatro cosas: generar un elemento transparente a partir de texto, editar una imagen transparente manteniendo su fondo limpio, editar el texto dentro de una capa transparente y extraer un sujeto de una foto normal como capa RGBA. La model card incluso sugiere la redacción del prompt para activarlo, algo como "This is an RGBA image with transparency ... the background is transparent" (model card de HF).
Si haces miniaturas, stickers, fotos de producto o recursos de UI, esa función es el motivo para interesarte. Es lo que un creador de IA en X señaló como lo más prometedor, y es lo más claro que hace Qwen Image 2.1 y que los modelos cerrados más grandes todavía te obligan a hacer a mano.
Qué más mejoró
La transparencia se lleva el titular, pero las mejoras de edición son donde la mayoría pasará su tiempo.
- Hasta 10 imágenes de referencia. Puedes darle al modelo hasta diez entradas y pedirle que las componga en una escena coherente: una foto de grupo hecha con seis retratos separados, una prueba virtual a partir de un modelo más ropa, zapatos, bolso y sombrero, o una habitación montada con diez fotos de mobiliario (blog de Qwen).
- Edición local flexible. Señalas qué cambiar con círculos de colores, anotaciones pintadas o un par de imagen original más máscara, y la opción de máscara deja intacto el resto de la imagen (blog de Qwen).
- Preservación de la fidelidad. Los rostros siguen siendo reconocibles entre ediciones, y los productos conservan su texto, textura y forma, que es lo que suele romperse cuando le pides a un modelo que restilice un objeto con etiqueta (blog de Qwen).
- 2K nativo, siete relaciones de aspecto. La salida llega hasta 2048x2048 en 1:1 y 2752x1536 en 16:9, así que no tienes que escalar después un render de 1 MP (model card de HF).
El renderizado de texto merece su propia línea, porque es a lo que la comunidad de pesos abiertos vuelve una y otra vez. El modelo pondera no solo las palabras sino también su estilo tipográfico y su disposición respecto a toda la composición (blog de Qwen), y en Hacker News el veredicto fue contundente:
"The text rendering definitely is much, much better than anything else on the open weights market right now. Small text fidelity is quite good. It seems like the text encoder however gets a little bit overloaded with larger prompts"

Ese "much, much better" lleva un asterisco, que explico en la sección de opiniones, porque no todos coinciden en que el texto salga limpio.
Cómo funciona por dentro
Aquí está la parte que explica por qué un modelo de 7B puede competir con otros mucho más grandes. Qwen Image 2.1 se apoya en dos trucos de eficiencia en lugar de en el tamaño bruto.
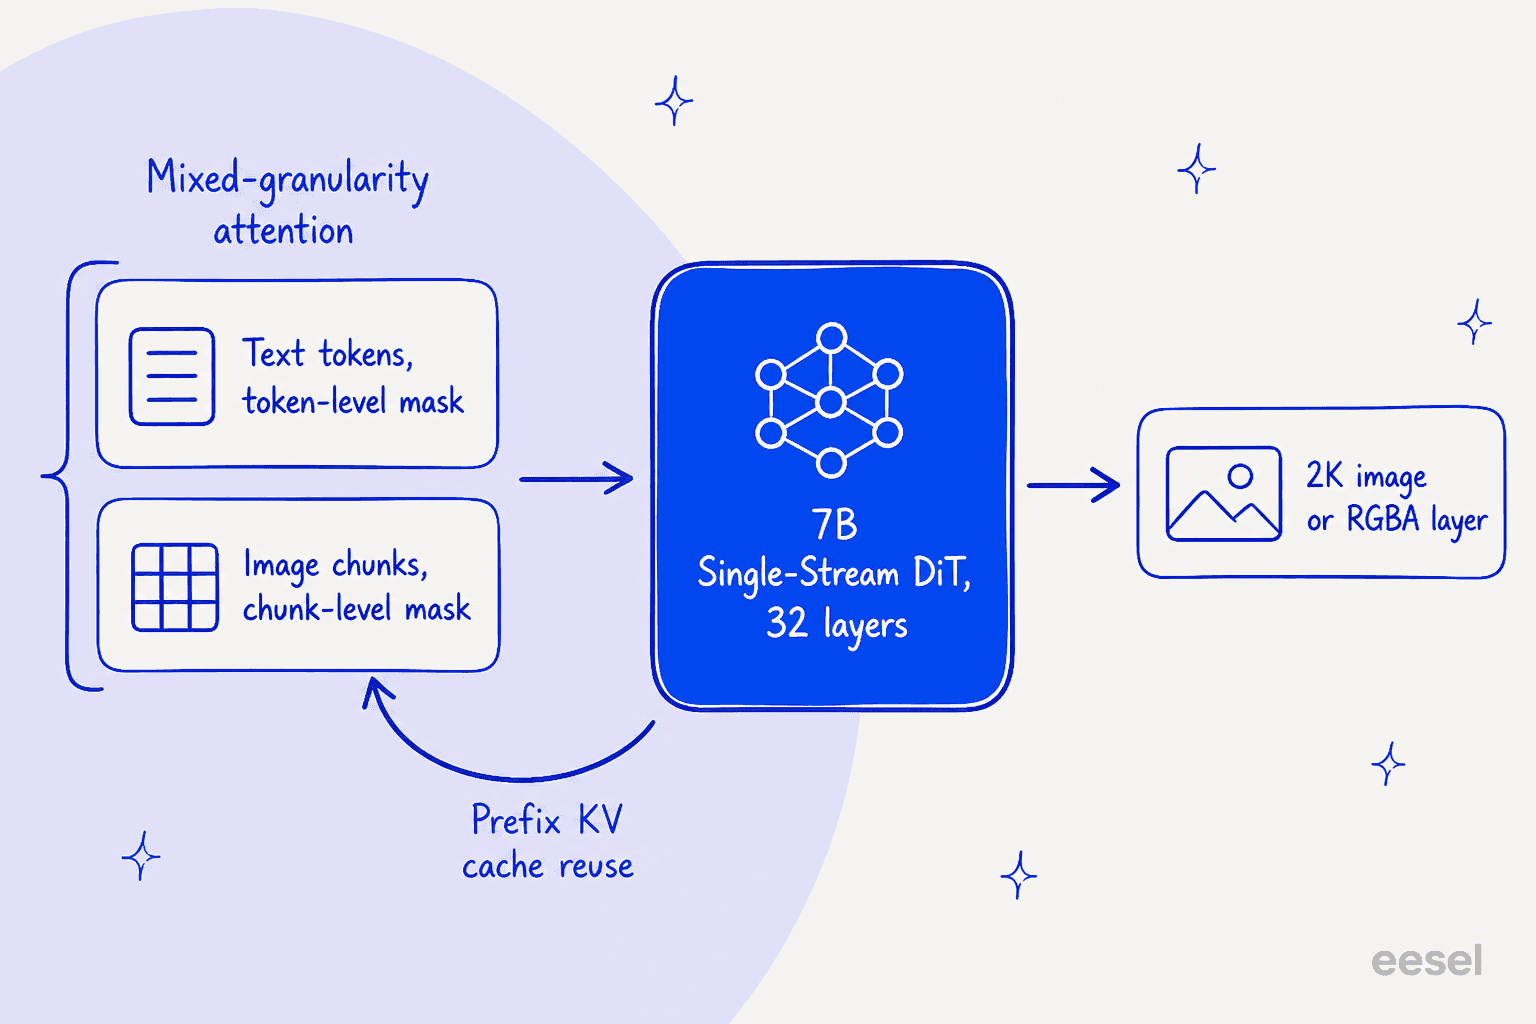
El primero es la atención de granularidad mixta. Los tokens de texto, es decir, el prefijo del sistema y tus instrucciones de edición, reciben una máscara causal fina a nivel de token, mientras que la imagen en sí se trata con una máscara más gruesa a nivel de chunk. El texto es donde importa la precisión, así que recibe el tratamiento detallado; la imagen recibe el más barato (blog de Qwen). El segundo es la reutilización de la caché KV de prefijo: tus imágenes de entrada e instrucciones son contexto estático, así que el modelo las calcula una vez, las guarda en caché y las reutiliza en cada paso posterior en lugar de recalcularlas (blog de Qwen). Ambos apuntan directamente al coste de editar con varias imágenes de referencia, que es justo donde un modelo ingenuo se ahogaría.
Si quieres construir sobre él, el modelo ya tiene un ecosistema: entrenamiento LoRA a través de DiffSynth-Studio de ModelScope, además de adaptadores de la comunidad, finetunes y cuantizaciones listados en el árbol de modelos. ControlNet, en particular, no se menciona en ningún material oficial, así que considéralo ausente hasta que aparezca un port de la comunidad.
El problema de la licencia
Esta es la parte que leería antes de que te encariñes. El Qwen-Image original salió con Apache 2.0, la licencia permisiva que te deja hacer prácticamente de todo, incluido trabajo comercial. Qwen Image 2.1 no. Sale con la Qwen Research License, que concede una "non-exclusive, worldwide ... royalty-free limited license ... for non-commercial purposes only", y el uso comercial requiere una autorización aparte de Alibaba.
La comunidad open source se dio cuenta de inmediato, y la reacción en Hacker News fue directa:
"Calling open-weights as open-source in marketing materials is the usual misrepresentation. But now with the restriction on commercial use (which is against opensource definition) it is not even open-weights, technically it would be more accurate to call it weights-available."
Es una lectura justa. Puedes descargar los pesos, ejecutarlos, ajustarlos y compartir tus cambios, siempre que sea para investigación o evaluación y mantengas los avisos de atribución. Lo que no puedes hacer es meter el resultado en un producto comercial sin escribir a Alibaba para pedir una licencia. Es un cambio real en lo que significa "abierto" aquí, y es la mayor queja sobre el lanzamiento. Para ser justos con Qwen, muchos laboratorios van en esta dirección, y una licencia de investigación sigue siendo más de lo que ofrecen la mayoría de los modelos cerrados. Simplemente no es el vale-todo de Apache que la gente esperaba.
Cómo acceder y cuánto cuesta
Hay varias formas de entrar, y la adecuada depende por completo de lo que vayas a hacer con él.
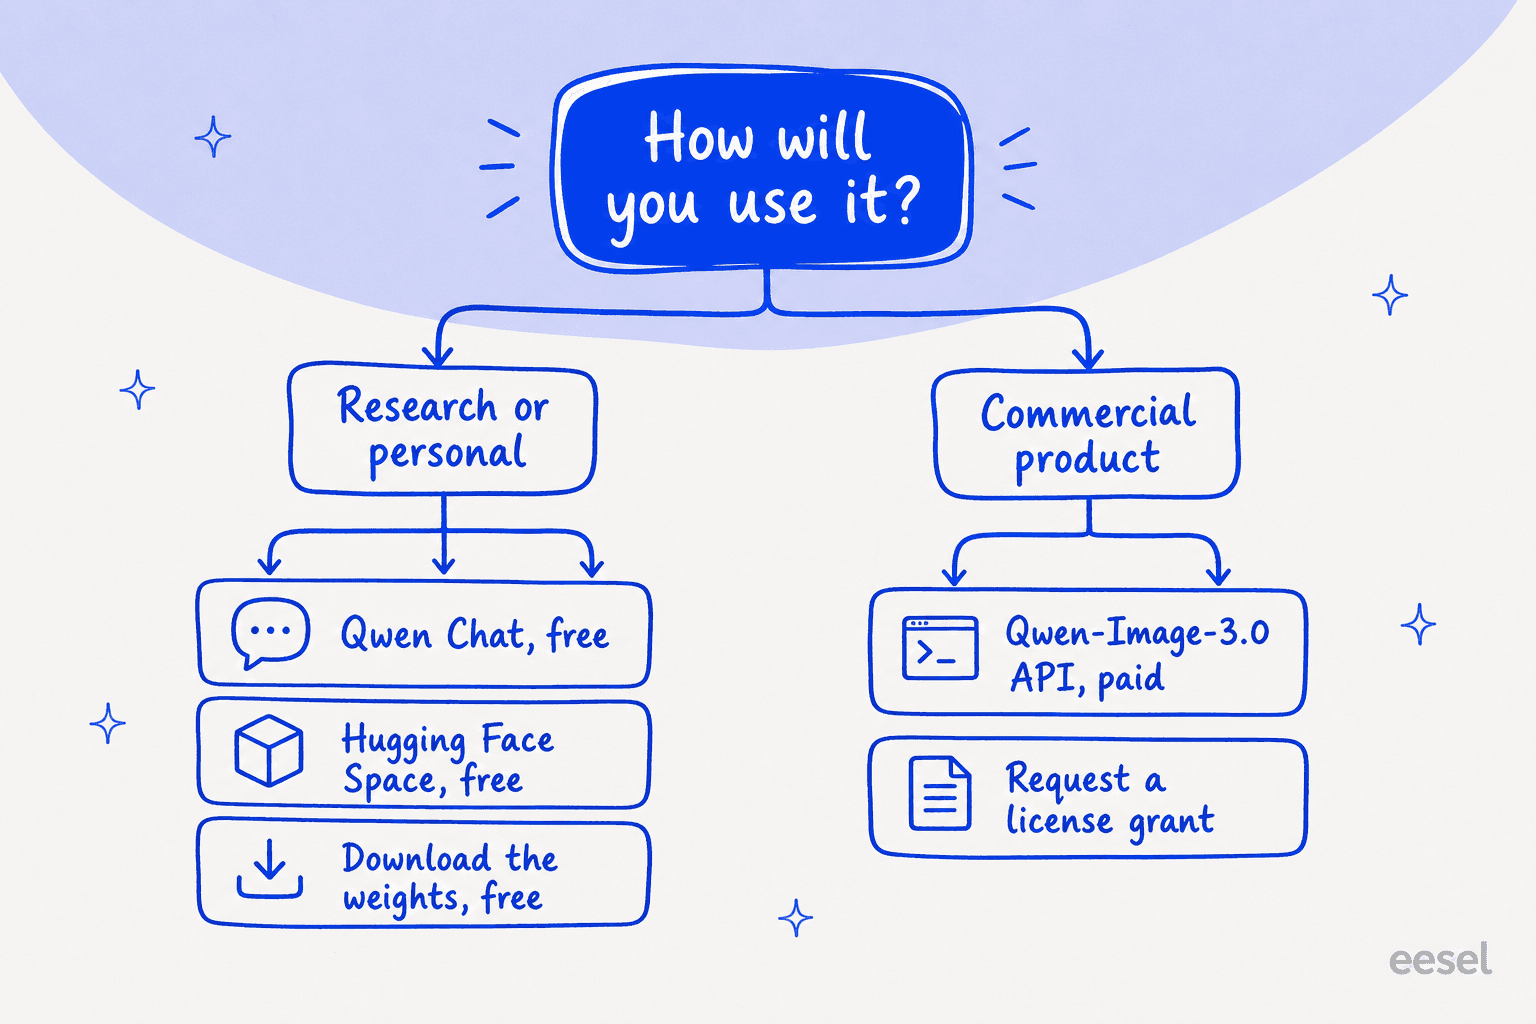
Si solo quieres probarlo, las vías más rápidas son gratis:
| Vía | Coste | Notas |
|---|---|---|
| Hugging Face Space | Gratis | Demo alojada oficial del modelo 2.1 exacto, sin instalación, cola limitada |
| Qwen Chat | Gratis | Generación y edición de imágenes integradas en el asistente de Qwen |
| Pesos en Hugging Face | Descarga gratuita | Licencia no comercial, necesitas tu propia GPU |
| Pesos en ModelScope | Descarga gratuita | Los mismos pesos, replicados para Asia |
API oficial de pago (qwen-image-2.1) | No se ofrece | Model Studio sirve la generación de imágenes con los IDs 3.0 |
Para una carga de trabajo comercial lo que tienes es la API de pago, y esa funciona con la línea 3.0, no con la 2.1. Alibaba Cloud Model Studio la cobra por imagen generada con éxito (precios de Model Studio):
| Modelo | Resolución | Precio de salida |
|---|---|---|
qwen-image-3.0 | 1k y 2k | 0,03 $ / imagen |
qwen-image-3.0-pro | 1k | 0,04 $ / imagen |
qwen-image-3.0-pro | 2k | 0,075 $ / imagen |
Las imágenes de entrada cuestan 0,003 $ cada una, las generaciones fallidas no se cobran y hay una cuota gratuita de 10 imágenes válida durante 90 días. Proveedores externos como fal.ai y Replicate ofrecen Qwen Image 2.0, no 2.1, muy probablemente porque la licencia no comercial les impide alojar la 2.1 para uso de pago (Price Per Token).
Una nota práctica más sobre ejecutarlo tú mismo: la etiqueta "7B" subestima el hardware necesario. Necesita unos 16 GiB en Q8 y hasta 17 GB durante una ejecución de 50 pasos, aunque con descarga a CPU un usuario lo dejó en 3,05 GiB de VRAM. Las velocidades rondan entre 5 y 25 segundos por imagen de 1 MP en una tarjeta moderna, y unos 90 segundos para un render 4K en una 5080.
Qué dice la gente realmente
La reacción de la comunidad está realmente dividida, y vale la pena escuchar ambos lados. Lo positivo se concentra en la relación tamaño-calidad y en la velocidad. De r/comfyui:
"I tested image editing with the default 25 steps at 2K resolution, and it takes about 2 minutes on a 5060 Ti. The output images are noticeably sharper than 2511, so I'd say this is a huge step forward. Considering the model is only 7B, I really can't ask for much more."

La reseña más equilibrada que encontré elogiaba el modelo como local y señalaba el defecto de calidad concreto que la gente repite, un tono amarillento sintético (r/StableDiffusion):
"In terms of being able to run it at a reasonable speed in a local environment, I'd say it's a good model. However, at commonly used resolutions ... the results did feel quite synthetic. In particular, the characteristic yellowish color tone and graininess made it feel like the model was trained on a lot of GPT Image data."
Y el elogio al renderizado de texto es discutido. Las mismas imágenes comparativas que impresionaron a un lector de Hacker News le parecieron confusas a otro, que puntuó más alto a Ideogram por su texto limpio. Un fallo recurrente y muy concreto apareció en r/comfyui: un usuario "just can't get the model to generate infographics only in English ... it always adds some other parts I never prompted for in Chinese." La adherencia al prompt en prompts de composición compleja es el otro punto débil que señalaron los primeros testers.
En conjunto, una ejecución independiente de GenAI Showdown lo puntuó con 7 de 15 frente a 4 de 15 de la versión abierta anterior, un salto real con un tercio del tamaño, con artefactos visibles de datos sintéticos.
¿Deberías usar Qwen Image 2.1?
Mi opinión: es el modelo de imagen de pesos abiertos más interesante del momento para un tipo de persona concreto, y una trampa para otro. Si quieres generación nativa de PNG transparentes en tu propio hardware, para investigación, prototipos o proyectos personales, descárgalo hoy, porque ningún otro modelo abierto lo hace tan limpio, y 7B en una GPU de consumo es un regalo. Con el sampler y el número de pasos adecuados, varios testers lo consideran la mejor opción local.
Si produces trabajo comercial, ve más despacio. La licencia solo para investigación significa que los pesos gratuitos no son una comida gratis, y la "API oficial" a la que recurrirías es en realidad qwen-image-3.0, un modelo distinto. Y si tu trabajo depende de un texto pequeño impecable o de un aspecto fotográfico limpio y no sintético, pruébalo contra Ideogram o un modelo más grande antes de comprometerte; el tono amarillento y los problemas de texto con prompts largos son reales y los reportan personas que querían que les gustara.
eesel para convertir modelos como este en trabajo terminado
Un modelo es infraestructura. Qwen Image 2.1 te da generación de imágenes en bruto, pero aún tienes que integrarlo en un flujo de trabajo, darle contexto y convertir su resultado en algo que se publique. Ese es el hueco que eesel está hecho para cubrir: en lugar de un modelo en bruto, eesel te da compañeros de equipo de IA listos para trabajar en tareas definidas, cada uno con las habilidades, integraciones y contexto de empresa que el puesto necesita.
El más cercano a los modelos de imagen es el redactor de blogs de IA de eesel, un compañero que investiga, redacta e ilustra contenido extenso de principio a fin; la generación de imágenes como la de Qwen es una de las herramientas que usa por debajo, no algo que te toque operar a ti. Tú aportas el tema y la marca; él se encarga del proceso, desde la investigación hasta un borrador listo para publicar con imágenes.
Si prefieres contratar la capacidad terminada en lugar de montarla con pesos y scripts, puedes probar eesel gratis.
Preguntas frecuentes
¿Qwen Image 2.1 es gratis?
Es gratis para probar y gratis para ejecutar. Puedes usarlo sin coste en Qwen Chat, en el Space de demostración de Hugging Face oficial, o descargando los pesos abiertos y ejecutándolos en tu propia GPU. El problema es la licencia: Qwen Image 2.1 tiene licencia solo para uso no comercial (investigación y evaluación), así que "gratis para ejecutar" no es lo mismo que "gratis para vender con él".
¿Cuánto cuesta la API de Qwen Image 2.1?
No existe un modelo de API de pago qwen-image-2.1. Model Studio de Alibaba Cloud ofrece su API de imagen comercial con los IDs de qwen-image-3.0, a 0,03 $ por imagen generada (1k y 2k) en qwen-image-3.0 y hasta 0,075 $ por imagen de 2k en qwen-image-3.0-pro. Si necesitas Qwen Image 2.1 en concreto para trabajo comercial, descargas los pesos y solicitas una licencia aparte.
¿Qué GPU necesito para ejecutar Qwen Image 2.1?
A pesar de la etiqueta "7B", es más pesado de lo que parece. Los usuarios reportan unos 16 GiB de VRAM en Q8 y hasta 17 GB durante una generación de 50 pasos, así que una tarjeta de la clase 3090, 4090 o 5080 va holgada. Con descarga a CPU funciona con apenas unos 3 GiB de VRAM, incluso en un portátil, aunque una sola imagen de 512x512 puede tardar unos tres minutos solo con CPU.
¿Qué es la transparencia nativa en Qwen Image 2.1?
La transparencia nativa significa que el modelo puede generar directamente imágenes RGBA con un canal alfa real a partir de un prompt, en lugar de obligarte a generar una imagen y luego recortar el fondo. También edita capas transparentes y puede extraer un sujeto de una foto normal como recorte transparente. Es el cambio principal de Qwen Image 2.1, que integra lo que antes era un modelo aparte, Qwen-Image-Layered.
¿Qwen Image 2.1 es mejor que los modelos de imagen anteriores de Qwen?
En la mayoría de los aspectos, sí: tiene aproximadamente un tercio del tamaño (7B frente a 20B), añade transparencia nativa, edita con hasta 10 imágenes de referencia, y los testers de r/comfyui dicen que el resultado es notablemente más nítido que el de la versión 2511. Las contrapartidas son la licencia restrictiva y un aspecto sintético, ligeramente amarillento, que no gusta a algunos analistas.