

Gemini Omni 1.1 Flash es el modelo de generación de vídeo de Google, lanzado en versión preliminar el 27 de agosto de 2026. Se factura por token con tres contadores distintos: $1,50 por 1 M de tokens de entrada, $9,00 por 1 M de tokens de salida de texto y $17,50 por 1 M de tokens de salida de vídeo. Google redondea la cifra del vídeo a unos $0,10 por segundo en 720p.
El dato clave: un clip de 10 segundos en 720p cuesta aproximadamente $1,01 solo en salida de vídeo, y la resolución es tu mayor palanca, ya que 4K cuesta unas 9 veces más por segundo que un borrador a 360p.
Hay dos cosas que sorprenden. No hay nivel gratuito, así que pagas desde el primer token, y tampoco hay descuento por lotes, que los modelos Flash solo de texto sí conservan. Los precios son idénticos en la API de Gemini y en Vertex. Si solo necesitas borradores cortos, genera en 360p y escala los que te gusten.
Qué es realmente Gemini Omni 1.1 Flash
Trabajo con APIs de modelos para ganarme la vida, así que con cualquier modelo "Flash" nuevo lo primero que hago es ignorar el anuncio de lanzamiento y leer la tabla de precios, porque ahí está el diseño real del producto. Con Gemini Omni 1.1 Flash, la tabla lo cuenta casi todo: no es un modelo de chat con un precio más bajo, es un modelo de vídeo de Google DeepMind que además entiende texto.
Google lo describe como un modelo multimodal "optimized for video generation, offering video output alongside text responses in a single model." El ID del modelo es gemini-omni-1.1-flash-preview, está en fase preliminar (no en disponibilidad general) y llegó el 27 de agosto de 2026 como la actualización 1.1 del Gemini Omni Flash original. Si has seguido los otros modelos creativos de Google, piensa en él como el hermano en movimiento de Nano Banana para imágenes y de Lyria para música.
La versión 1.1 trata sobre todo de control. Ahora tienes extensión de escena (alargar un clip en pasos de 10 segundos hasta un acumulado de 40), control del primer y el último fotograma, una referencia de vídeo de 3 segundos para mantener la coherencia de los personajes, escalado a 4K y un modo borrador a 360p que, según Google, es hasta un 60 % más rápido y cuesta alrededor de un tercio que 720p. Entre los socios de lanzamiento que construyen sobre él figuran Adobe, Figma y Runway.
Una rareza del nombre que conviene aclarar desde el principio: "Omni" sugiere todas las modalidades, pero aquí el modelo acepta texto, imagen y vídeo como entrada y devuelve texto y vídeo como salida. Genera sonido (voz, música, efectos) como parte del vídeo, pero no es un generador independiente de audio ni de imágenes. Para ver dónde encaja en la familia, nuestro resumen de Gemini repasa toda la gama.
Precios de Gemini Omni 1.1 Flash de un vistazo
Aquí está toda la tarifa, directamente de las páginas de Google. No hay diferencia entre precio de lista y precio real que desentrañar: las tarifas por token son el precio.
| Contador | Precio por 1 M de tokens | Qué cubre |
|---|---|---|
| Entrada | $1,50 | Texto, imagen, audio o vídeo enviados |
| Salida de texto | $9,00 | Respuestas de texto y tokens de razonamiento |
| Salida de vídeo | $17,50 | Vídeo generado (con audio) |
Tanto la página de precios de la API de Gemini como la página de precios de Gemini Enterprise muestran estas cifras, y coinciden. La página de la API de Gemini añade la versión legible: la salida de vídeo cuesta "approximately $0.10 per second" en 720p, y el nivel gratuito es "Not available."
El problema de un modelo de vídeo con precio por token es que "por 1 M de tokens" oculta lo rápido que se acumulan los tokens cuando la salida son imágenes en movimiento. De eso trata la siguiente sección.
Los tres contadores, y por qué la salida de vídeo es la que pesa
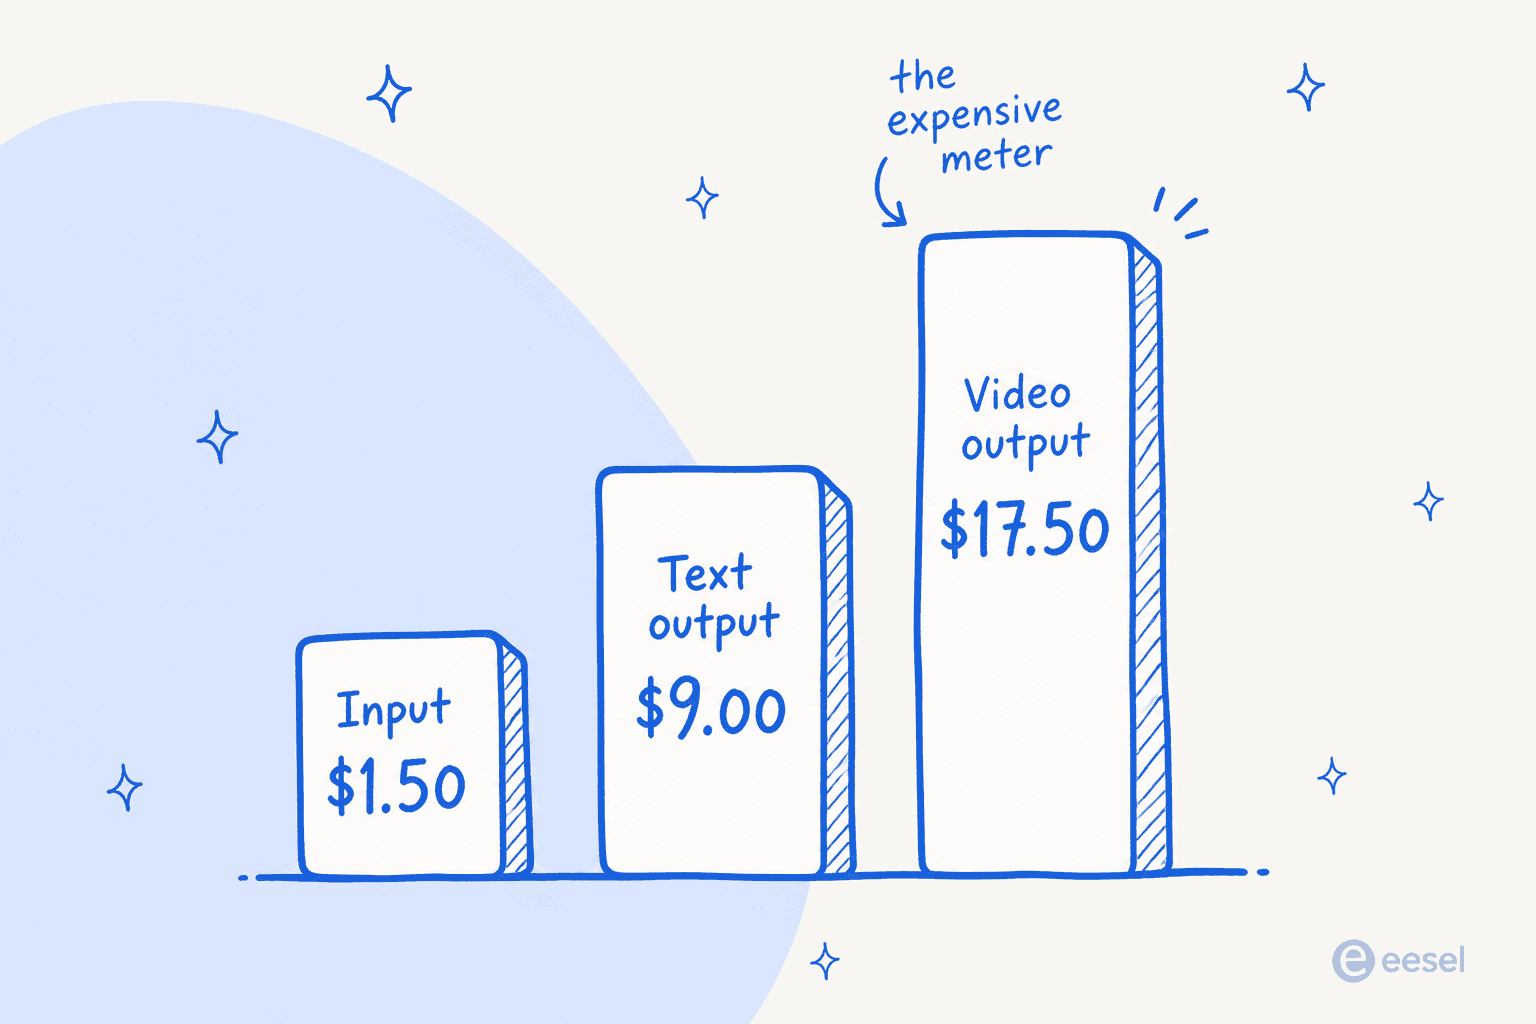
Lo que hay que interiorizar es que la salida de vídeo cuesta casi 12 veces lo que cuesta la entrada, por token. En un modelo de chat normal, entrada y salida difieren por un múltiplo pequeño, así que se razona de forma aproximada sobre el "coste por llamada". Aquí, la misma llamada puede facturar tres tarifas a la vez: tus tokens de prompt a $1,50, cualquier texto que el modelo devuelva a $9,00 y cada fotograma de vídeo generado a $17,50.
En el uso real, el contador de salida de vídeo domina tanto que los otros dos son errores de redondeo. Un prompt largo puede sumar unas décimas de céntimo; unos segundos en 4K suman dólares. Así que, al presupuestar este modelo, presupuesta los segundos de vídeo y trata todo lo demás como ruido.
Así convierte Google cada modalidad de entrada en tokens, que es la base real de la facturación:
| Modalidad de entrada | Tarifa de tokens | Coste a $1,50 / 1 M |
|---|---|---|
| Texto | recuento estándar de tokens | $1,50 / 1 M de tokens |
| Imagen | 1.120 tokens por imagen | ~$0,0017 por imagen |
| Audio | 32 tokens por segundo de audio | ~$0,00005 por segundo |
| Vídeo | 5.792 tokens por segundo de vídeo | ~$0,0087 por segundo de vídeo |
Esos costes de entrada son diminutos. Enviar una imagen de referencia cuesta una fracción de céntimo. El dinero se va en la salida.
Cuánto cuesta realmente un vídeo
La salida de vídeo se mide por segundo, y la tarifa por segundo depende de la resolución. Google publica directamente las tarifas de tokens, así que esto es aritmética, no estimación: multiplica los tokens por segundo por la tarifa de salida de $17,50.
| Resolución | Tokens por segundo | Coste por segundo de salida |
|---|---|---|
| 360p (borrador) | 1.931 | ~$0,034 |
| 720p | 5.792 | ~$0,101 |
| 1080p | 8.688 | ~$0,152 |
| 4K | 17.376 | ~$0,304 |
Unos números de ejemplo para concretar. Un clip de 10 segundos en 720p con audio son 57.920 tokens de salida, es decir, unos $1,01. Esos mismos 10 segundos en modo borrador a 360p cuestan unos $0,34. En 4K, aproximadamente $3,04 por los mismos 10 segundos. Si alargas un clip hasta el tope de 40 segundos en 720p, hablamos de unos $4,05 en salida de vídeo.
Introduce tus propios números abajo para ver cuánto costaría un proyecto antes de lanzarlo.
El patrón que deja claro la calculadora: tu factura mensual crece de forma lineal con los clips y los segundos, pero la resolución multiplica el total. Doscientos borradores cortos en 720p al mes rondan los $200; el mismo volumen en 4K se acerca a $600.
La resolución es la palanca de coste, así que usa el modo borrador
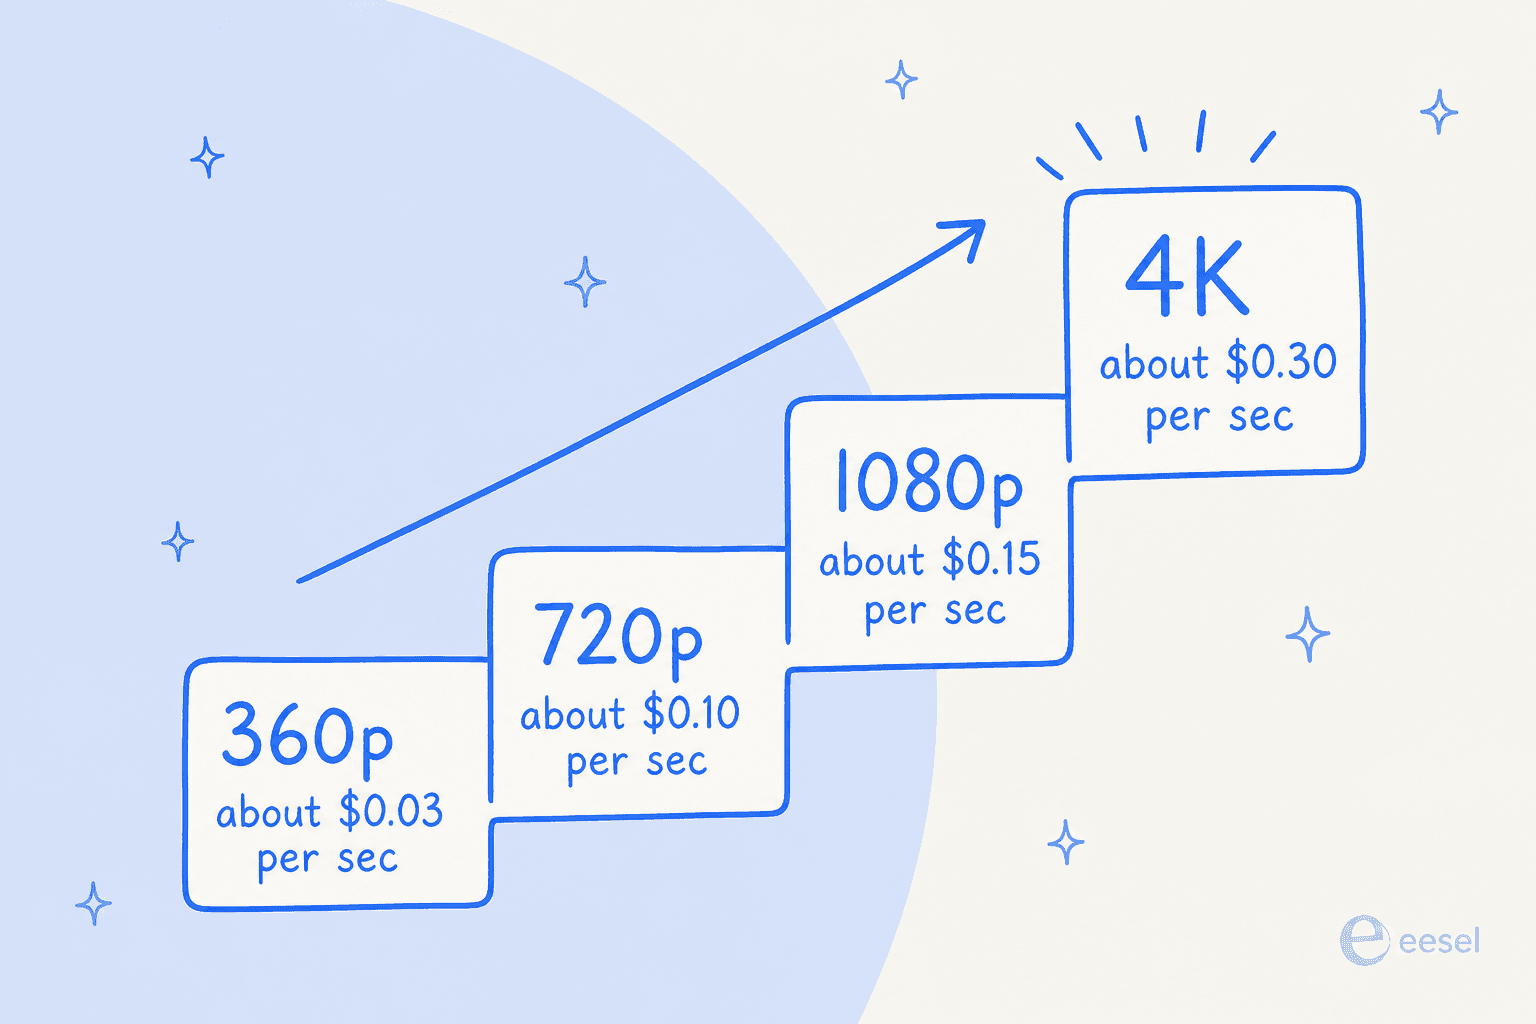
Por eso Google lanzó el modo borrador a 360p, y por eso yo construiría todo mi flujo de trabajo en torno a él. El coste por segundo sube unas 9 veces de 360p a 4K, pero las decisiones creativas (composición, movimiento, si la escena funciona siquiera) no necesitan 4K para evaluarse. Genera un lote de borradores baratos a 360p, elige el que funciona y vuelve a renderizar o escala solo ese a 1080p o 4K.
Hacerlo al revés (generar todo a resolución completa y tirar la mayor parte) es como una factura de vídeo se triplica sin que nadie se dé cuenta. Es la misma trampa que tiene el precio de Nano Banana Pro para las imágenes, solo que con una dimensión de tiempo que multiplica cada error.
Lo que falta
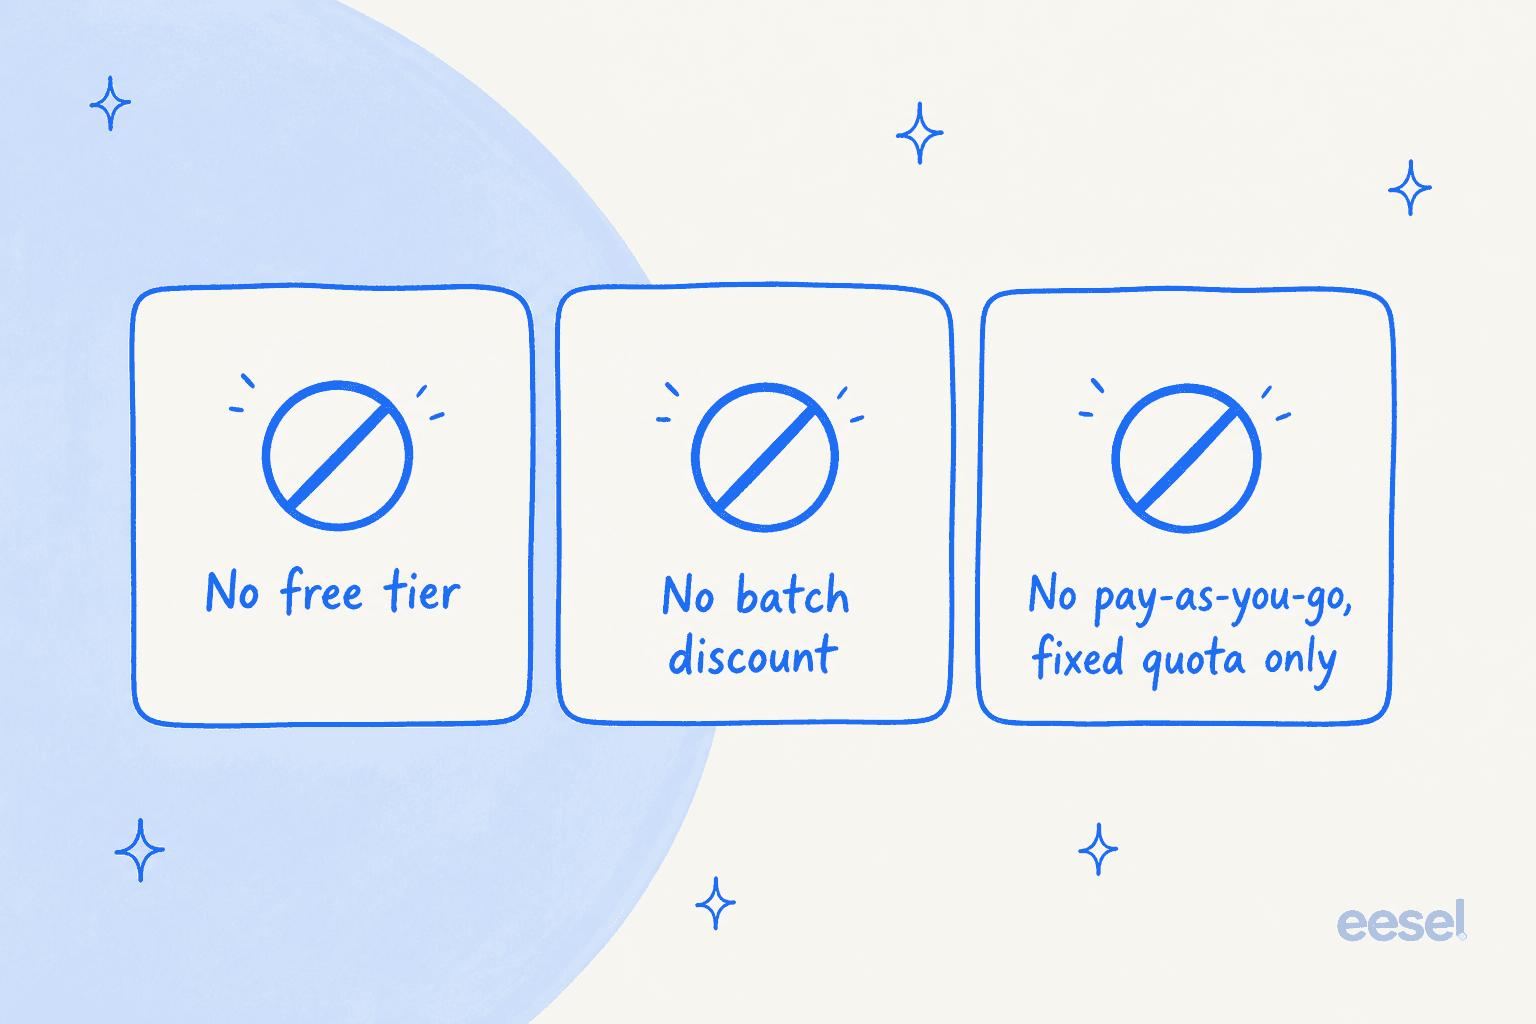
Si vienes de los modelos Gemini Flash solo de texto, tres suposiciones que traes son incorrectas aquí.
- Sin nivel gratuito. Los modelos Flash de texto te dan una cuota gratuita de API para prototipar. Omni 1.1 Flash no, según la página de precios de la API de Gemini. Pagas desde el primer token, así que presupuesta también tus pruebas, no solo la producción.
- Sin descuento por lotes. El descuento del 50 % por lotes de Google es una de las mejores ofertas de la gama Gemini, y aquí no se aplica porque el modelo no admite inferencia por lotes. Cada segundo cuesta el precio completo.
- Sin pago por uso ni rendimiento aprovisionado. El acceso es solo mediante cuota fija, en la región global. Para la mayoría de los equipos está bien, pero significa que no puedes comprar capacidad dedicada como sí puedes en cargas de texto de gran volumen.
Ninguno de estos puntos es un impedimento. Son simplemente el tipo de detalle que convierte un "esto parece barato" de primera impresión en una sorpresa en la primera factura, y por eso vale la pena dedicar diez minutos a leer la especificación antes de comprometerte.
API de Gemini vs. Vertex: el precio es el mismo
Una pregunta que surge con cada modelo de Google: ¿sale más barato a través de la API de Gemini (Google AI Studio) o de la Gemini Enterprise Agent Platform de la línea Vertex? Para Omni 1.1 Flash, los precios por token son idénticos: $1,50 de entrada, $9,00 de salida de texto y $17,50 de salida de vídeo en ambas plataformas.
Así que la elección depende de todo salvo del precio. La API de Gemini es la forma más rápida de empezar y el hogar natural de un proyecto en solitario o un prototipo. La Enterprise Agent Platform es donde vas por los controles a nivel de organización, IAM y el resto de la gobernanza de Google Cloud. El modelo también está disponible en Google Flow para suscriptores de AI Plus, Pro y Ultra, y la extensión de escena aparece en la propia app de Gemini. Elige la plataforma que encaje con cómo trabaja ya tu equipo, no la que creas más barata, porque cuestan lo mismo.
Cómo se compara con otros modelos Gemini Flash
La palabra "Flash" nos ha enseñado a esperar algo barato, y ahí es donde Omni 1.1 Flash puede confundir. En texto, tiene un precio de modelo Flash de gama media. El contador de vídeo es la parte que no tiene equivalente en la línea de texto.
| Modelo | Entrada / 1 M | Salida / 1 M | Nivel gratuito | Lotes |
|---|---|---|---|---|
| Gemini Omni 1.1 Flash | $1,50 | $9,00 texto / $17,50 vídeo | No | No |
| Gemini 3.5 Flash (texto) | $1,50 | $9,00 | Sí | Sí |
| Gemini 3.7 Flash (texto) | $0,75* | $3,75* | Sí | Sí |
| Gemini 2.5 Flash (texto) | $0,30 | $2,50 | Sí | Sí |
*Gemini 3.7 Flash tiene un precio promocional que sube a $1,50 / $7,50 después del 31 de diciembre de 2026, según la página de precios de la API de Gemini.
La conclusión: los tokens de texto de Omni 1.1 Flash cuestan exactamente lo mismo que los de Gemini 3.5 Flash, así que no pagas un recargo por hablar con él. Pagas por el contador de vídeo, que es un producto genuinamente distinto de lo que hacen los modelos Flash de texto. Compararlo en precio con 2.5 Flash no tiene sentido; no hacen el mismo trabajo.
¿Merece la pena Gemini Omni 1.1 Flash?
Si necesitas generación de vídeo programática con control fino (extensión de escena, control de fotogramas clave, coherencia de personajes) y te sientes cómodo gestionando costes por segundo, tiene un precio justo para lo que hace, y el flujo de borradores a 360p lo mantiene asequible durante la fase de iterar y descartar, donde de otro modo se iría la mayor parte del gasto.
Donde frenaría: si solo estás experimentando, la falta de nivel gratuito hace que cada prueba cueste dinero real, y si tu caso es renderizado por lotes de gran volumen, la ausencia de descuento por lotes duele. En esos casos, haz storyboards a fondo y prototipa a 360p antes de tocar una resolución mayor.
El resumen honesto es que Omni 1.1 Flash es una buena opción para trabajo de vídeo controlado e iterativo y un mal ajuste para generar a lo loco. Sabe cuál de las dos cosas vas a hacer antes de integrarlo.
Escribir el contenido en torno a tu stack de IA
Un modelo como Gemini Omni 1.1 Flash es infraestructura: una capacidad en bruto que integras en un producto. No conoce tu marca, tu documentación ni lo que quieres publicar. Ese es el hueco que cubre eesel. En lugar de una API de modelo, eesel te da un compañero de equipo de IA listo para trabajar, y uno de los actuales es un redactor de blogs con IA que ya conoce el contexto de tu empresa y convierte un tema en un borrador investigado y con la voz de tu marca, igual que nuestro compañero de IA para el helpdesk gestiona los tickets de soporte.
Así que si estás lanzando demos de vídeo con Omni 1.1 Flash y necesitas la publicación de lanzamiento, la página de documentación y el contenido comparativo que las acompañe, ese es el compañero que debes contratar. Se puede probar gratis y se integra en las herramientas donde ya vive tu contenido.
Preguntas frecuentes
¿Cuánto cuesta Gemini Omni 1.1 Flash?
Gemini Omni 1.1 Flash se factura por token: $1,50 por 1 M de tokens de entrada (texto, imagen, audio o vídeo), $9,00 por 1 M de tokens de salida de texto y $17,50 por 1 M de tokens de salida de vídeo. Google sitúa la salida de vídeo en unos $0,10 por segundo en 720p. Consulta la página de precios de la API de Gemini para ver las cifras actualizadas.
¿Hay un nivel gratuito para Gemini Omni 1.1 Flash?
No. A diferencia de los modelos Gemini Flash solo de texto, Gemini Omni 1.1 Flash no tiene nivel gratuito, así que cada solicitud se factura desde el primer token. Si quieres una forma gratuita de probar los modelos de Google, los niveles de precios estándar de Gemini siguen incluyendo una cuota gratuita de API.
¿Cuánto cuesta un vídeo de 10 segundos con Gemini Omni 1.1 Flash?
Un clip de 10 segundos en 720p con audio son unos 57.920 tokens de salida, lo que supone aproximadamente $1,01 en costes de salida de vídeo, antes de sumar tokens de entrada o de texto. Con el modo borrador a 360p baja a unos $0,34.
¿Gemini Omni 1.1 Flash tiene el 50 % de descuento por lotes?
No. Este modelo no admite inferencia por lotes, así que no se aplica el habitual descuento del 50 % de Gemini. Los modelos Flash solo de texto como Gemini 3.5 y 3.7 Flash siguen teniéndolo.
¿Son iguales los precios de Gemini Omni 1.1 Flash en Vertex AI y en la API de Gemini?
Sí. Las tarifas por token son idénticas en Google AI Studio (la API de Gemini) y en la Gemini Enterprise Agent Platform (la línea de Vertex): $1,50 de entrada, $9,00 de salida de texto y $17,50 de salida de vídeo por 1 M de tokens. Solo está disponible en la región global.