

Gemini Omni 1.1 Flash ist Googles Modell zur Videogenerierung, am 27. August 2026 als Preview veröffentlicht. Abgerechnet wird pro Token über drei getrennte Zähler: $1,50 pro 1 Mio. Input-Tokens, $9,00 pro 1 Mio. Text-Output-Tokens und $17,50 pro 1 Mio. Video-Output-Tokens. Google rundet den Videopreis auf etwa $0,10 pro Sekunde in 720p.
Die wichtigste Zahl: Ein 720p-Clip von 10 Sekunden kostet allein für den Video-Output rund $1,01, und die Auflösung ist dein größter Hebel, denn 4K kostet pro Sekunde etwa das 9-Fache eines 360p-Entwurfs.
Zwei Dinge überraschen viele. Es gibt kein kostenloses Kontingent, du zahlst also ab dem ersten Token, und es gibt keinen Batch-Rabatt, den die reinen Text-Flash-Modelle weiterhin bekommen. Die Preise sind in der Gemini API und auf Vertex identisch. Wenn du nur kurze Entwürfe brauchst, generiere in 360p und skaliere die brauchbaren Clips hoch.
Was Gemini Omni 1.1 Flash eigentlich ist
Ich arbeite beruflich mit Modell-APIs, deshalb ignoriere ich bei jedem neuen "Flash"-Modell zuerst den Launch-Post und lese die Preistabelle, denn dort steckt das eigentliche Produktdesign. Bei Gemini Omni 1.1 Flash verrät die Tabelle fast alles: Das ist kein Chat-Modell mit niedrigerem Preis, sondern ein Videomodell von Google DeepMind, das nebenbei Text versteht.
Google beschreibt es als multimodales Modell "optimized for video generation, offering video output alongside text responses in a single model." Die Modell-ID lautet gemini-omni-1.1-flash-preview, es befindet sich in der Preview-Phase (nicht allgemein verfügbar) und erschien am 27. August 2026 als Version 1.1 des ursprünglichen Gemini Omni Flash. Wenn du Googles andere Kreativmodelle kennst: Es ist das bewegte Geschwister von Nano Banana für Bilder und Lyria für Musik.
Das Update 1.1 dreht sich vor allem um Kontrolle. Neu sind Szenenverlängerung (einen Clip in 10-Sekunden-Schritten bis zu insgesamt 40 Sekunden verlängern), Steuerung über erstes und letztes Bild, eine 3-sekündige Video-Referenz für konsistente Figuren, 4K-Upscaling und ein 360p-Entwurfsmodus, der laut Google bis zu 60 % schneller ist und etwa ein Drittel der Kosten von 720p verursacht. Zu den genannten Launch-Partnern gehören Adobe, Figma und Runway.
Eine Namensfalle gleich vorweg: "Omni" suggeriert alle Modalitäten, aber das Modell nimmt Text, Bild und Video als Eingabe und liefert Text und Video als Ausgabe. Ton (Sprache, Musik, Effekte) erzeugt es als Teil des Videos, es ist aber kein eigenständiger Audio- oder Bildgenerator. Wo es in der Modellfamilie steht, zeigt unser Gemini-Überblick.
Gemini Omni 1.1 Flash Preise im Überblick
Hier die komplette Preisliste, direkt von Googles eigenen Seiten. Eine Lücke zwischen Listenpreis und echtem Preis gibt es nicht, die Token-Preise sind der Preis.
| Zähler | Preis pro 1 Mio. Tokens | Was darunter fällt |
|---|---|---|
| Input | $1,50 | Gesendeter Text, Bild, Audio oder Video |
| Text-Output | $9,00 | Textantworten und Reasoning-Tokens |
| Video-Output | $17,50 | Generiertes Video (mit Audio) |
Sowohl die Preisseite der Gemini API als auch die Gemini-Enterprise-Preisseite nennen diese Zahlen, und sie stimmen überein. Die Seite der Gemini API ergänzt die verständliche Version: Video-Output kostet "approximately $0.10 per second" in 720p, und das kostenlose Kontingent ist "Not available."
Der Haken bei einem Videomodell mit Token-Abrechnung: "pro 1 Mio. Tokens" verschleiert, wie schnell sich Tokens bei bewegten Bildern anhäufen. Darum geht es im nächsten Abschnitt.
Die drei Zähler, und warum der Video-Output zuschlägt
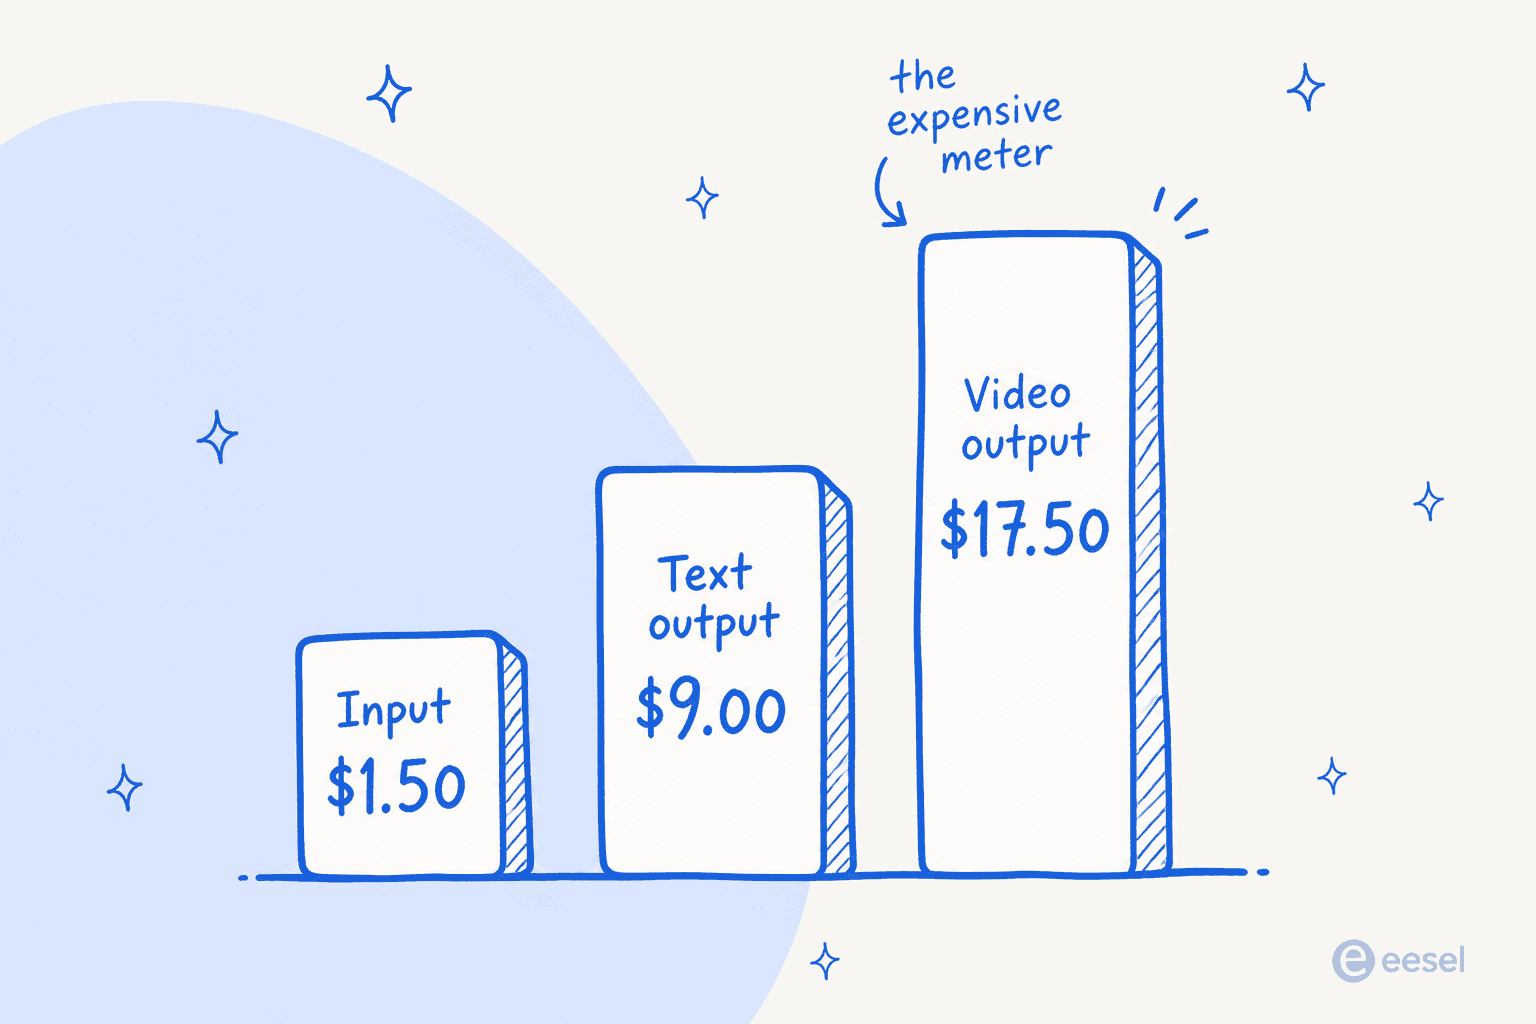
Wichtig zu verinnerlichen: Video-Output kostet pro Token fast das 12-Fache des Inputs. Bei einem normalen Chat-Modell liegen Input und Output nur um einen kleinen Faktor auseinander, man denkt also locker in "Kosten pro Aufruf". Hier kann derselbe Aufruf drei verschiedene Preise gleichzeitig auslösen: deine Prompt-Tokens mit $1,50, jeden Text, den das Modell zurückgibt, mit $9,00 und jedes Bild des generierten Videos mit $17,50.
In der Praxis dominiert der Video-Output-Zähler so stark, dass die beiden anderen Rundungsfehler sind. Ein langer Text-Prompt kostet vielleicht ein paar Zehntel Cent, ein paar Sekunden 4K kosten Dollar. Plane bei diesem Modell also das Budget für die Videosekunden und behandle alles andere als Rauschen.
So rechnet Google jede Eingabe-Modalität in Tokens um, und genau danach wird abgerechnet:
| Eingabe-Modalität | Token-Rate | Kosten bei $1,50 / 1 Mio. |
|---|---|---|
| Text | übliche Token-Zahl | $1,50 / 1 Mio. Tokens |
| Bild | 1.120 Tokens pro Bild | ~$0,0017 pro Bild |
| Audio | 32 Tokens pro Audiosekunde | ~$0,00005 pro Sekunde |
| Video | 5.792 Tokens pro Videosekunde | ~$0,0087 pro Videosekunde |
Diese Input-Kosten sind winzig. Ein Referenzbild kostet einen Bruchteil eines Cents. Das Geld geht beim Output drauf.
Was ein Video tatsächlich kostet
Video-Output wird pro Sekunde abgerechnet, und der Sekundenpreis hängt von der Auflösung ab. Google veröffentlicht die Token-Raten direkt, das sind also Rechnungen und keine Schätzungen: Tokens pro Sekunde mal der Output-Rate von $17,50.
| Auflösung | Tokens pro Sekunde | Kosten pro Sekunde Output |
|---|---|---|
| 360p (Entwurf) | 1.931 | ~$0,034 |
| 720p | 5.792 | ~$0,101 |
| 1080p | 8.688 | ~$0,152 |
| 4K | 17.376 | ~$0,304 |
Ein paar Rechenbeispiele. Ein 10-Sekunden-Clip in 720p mit Audio sind 57.920 Output-Tokens, also etwa $1,01. Dieselben 10 Sekunden im 360p-Entwurfsmodus kosten rund $0,34. In 4K sind es für die gleichen 10 Sekunden etwa $3,04. Verlängerst du einen Clip in 720p bis zum Limit von 40 Sekunden, landest du bei rund $4,05 für den Video-Output.
Trag unten deine eigenen Zahlen ein, um zu sehen, wo ein Projekt landet, bevor du es startest.
Das Muster, das der Rechner sichtbar macht: Deine Monatsrechnung steigt linear mit Clips und Sekunden, aber die Auflösung multipliziert alles. Zweihundert kurze 720p-Entwürfe pro Monat kosten etwa $200, dieselbe Menge in 4K eher $600.
Die Auflösung ist der Kostenhebel, nutze den Entwurfsmodus
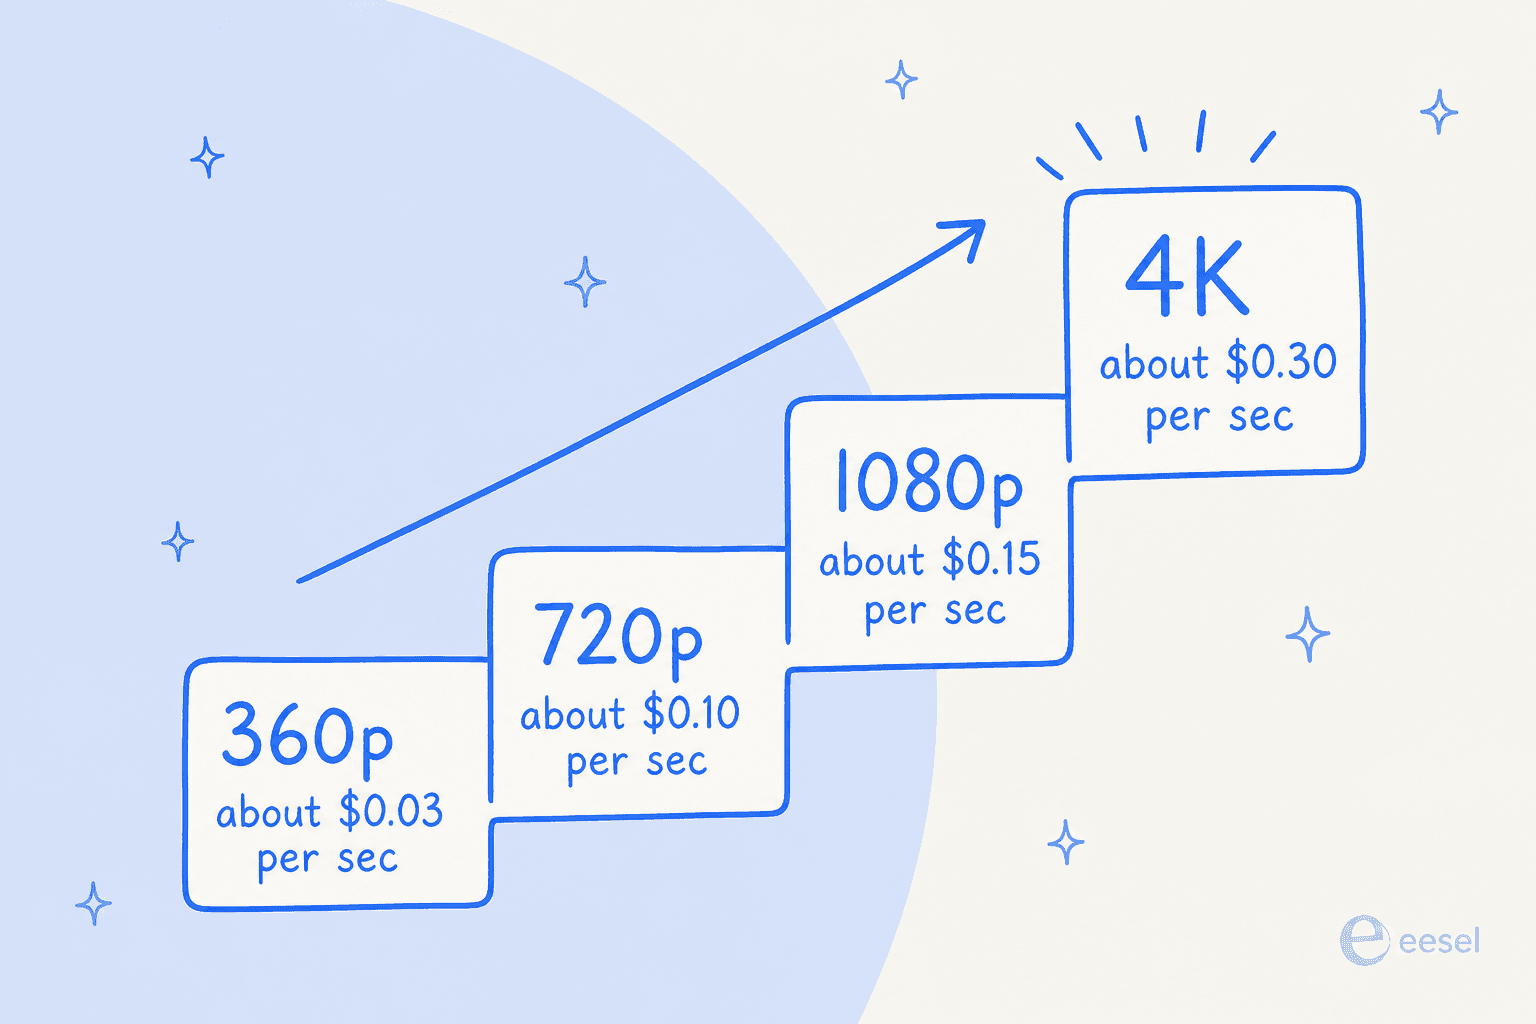
Deshalb hat Google den 360p-Entwurfsmodus gebaut, und deshalb würde ich den ganzen Workflow darum herum aufbauen. Die Kosten pro Sekunde steigen von 360p zu 4K um das etwa 9-Fache, aber die kreativen Entscheidungen (Bildaufbau, Bewegung, ob die Szene überhaupt funktioniert) lassen sich auch ohne 4K beurteilen. Generiere einen Stapel günstiger 360p-Entwürfe, such den besten aus und rendere oder skaliere nur diesen einen Clip auf 1080p oder 4K.
Alles in voller Auflösung zu generieren und das meiste wegzuwerfen, ist genau die Art, wie sich eine Videorechnung unbemerkt verdreifacht. Dieselbe Falle kennt Nano Banana Pro bei der Bildgenerierung, nur dass hier die Zeitdimension jeden Fehler zusätzlich multipliziert.
Was fehlt
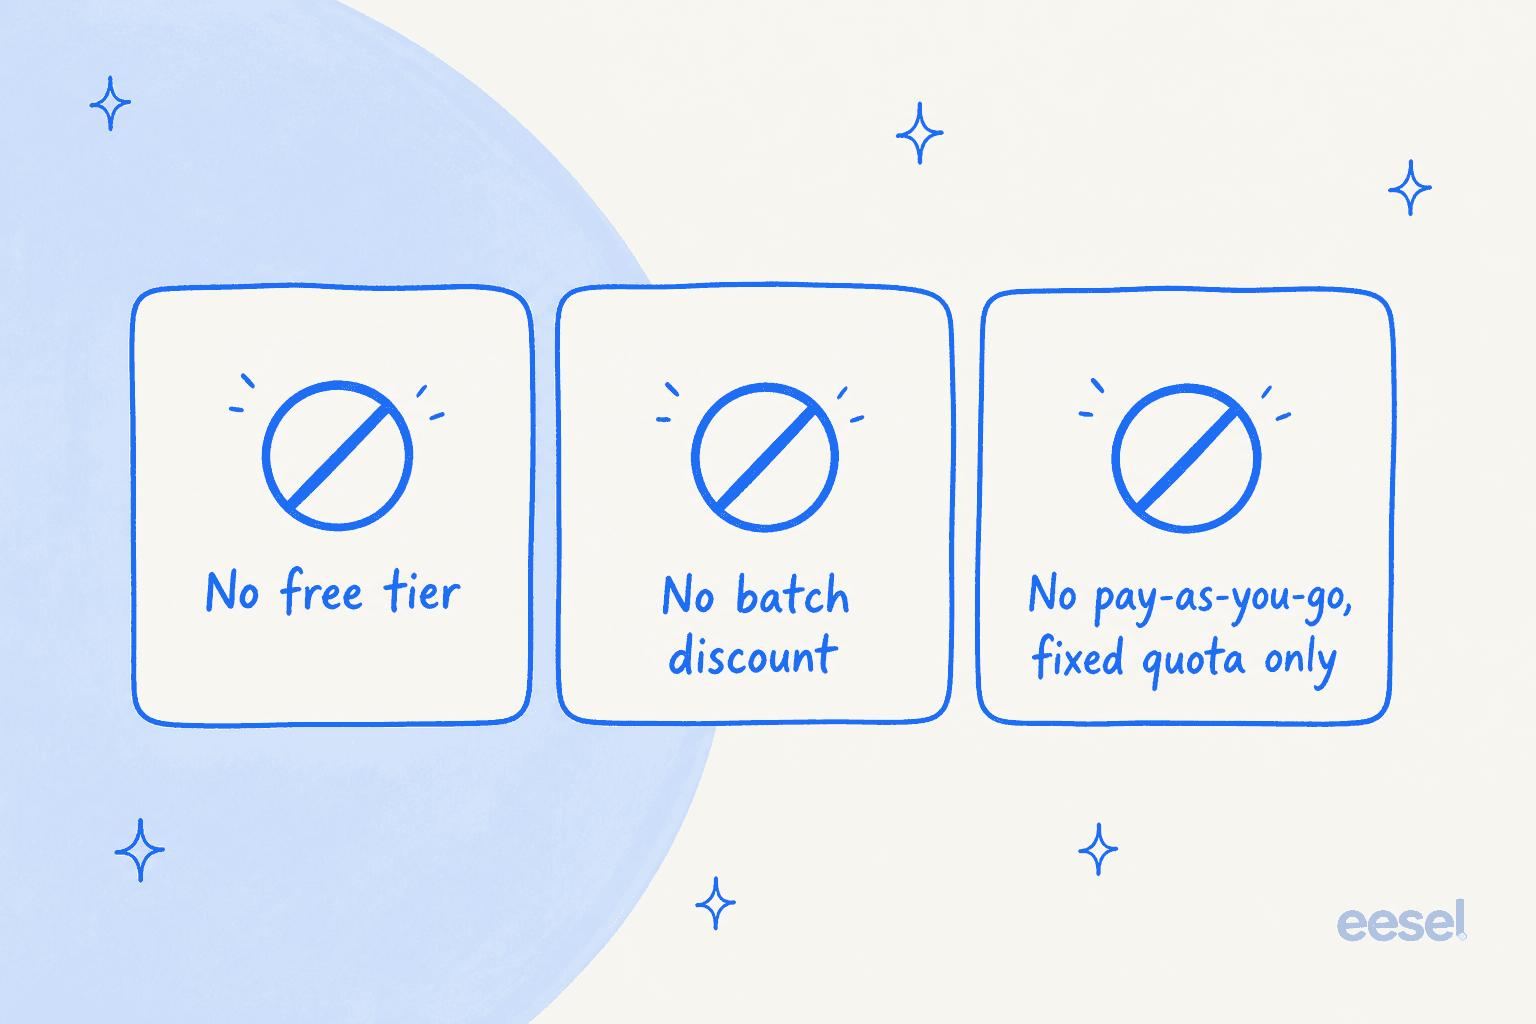
Wenn du von den reinen Text-Gemini-Flash-Modellen kommst, stimmen drei Annahmen hier nicht.
- Kein kostenloses Kontingent. Die Text-Flash-Modelle bieten ein kostenloses API-Kontingent zum Prototyping. Omni 1.1 Flash laut Preisseite der Gemini API nicht. Du zahlst ab dem ersten Token, plane also auch das Testen ein, nicht nur die Produktion.
- Kein Batch-Rabatt. Googles 50-%-Batch-Rabatt gehört zu den besten Angeboten im Gemini-Sortiment und gilt hier nicht, weil das Modell keine Batch-Inferenz unterstützt. Jede Sekunde kostet den vollen Preis.
- Kein Pay-as-you-go und kein Provisioned Throughput. Zugang gibt es nur über eine feste Quote in der globalen Region. Für die meisten Teams reicht das, aber du kannst keine dedizierte Kapazität kaufen, wie es bei hochvolumigen Text-Workloads möglich ist.
Keiner dieser Punkte ist ein K.-o.-Kriterium. Es sind genau die Details, die aus einem "sieht günstig aus" beim ersten Eindruck eine Überraschung auf der ersten Rechnung machen, und deshalb lohnen sich die zehn Minuten, die Spezifikation vor dem Einstieg zu lesen.
Gemini API vs. Vertex: Der Preis ist gleich
Diese Frage stellt sich bei jedem Google-Modell: Ist es über die Gemini API (Google AI Studio) oder über die Gemini Enterprise Agent Platform aus der Vertex-Linie günstiger? Bei Omni 1.1 Flash sind die Token-Preise identisch: $1,50 Input, $9,00 Text-Output, $17,50 Video-Output auf beiden Plattformen.
Die Wahl hängt also von allem außer dem Preis ab. Die Gemini API ist der schnellste Einstieg und die natürliche Heimat für ein Solo-Projekt oder einen Prototyp. Die Enterprise Agent Platform ist der richtige Ort für Kontrollen auf Organisationsebene, IAM und den Rest der Google-Cloud-Governance. Das Modell steht außerdem in Google Flow für Abonnenten von AI Plus, Pro und Ultra bereit, und die Szenenverlängerung erscheint in der Gemini-App selbst. Wähle die Plattform, die zur Arbeitsweise deines Teams passt, nicht die, von der du dir niedrigere Kosten erhoffst, denn sie kosten gleich viel.
Wie schneidet es im Vergleich zu anderen Gemini-Flash-Modellen ab?
Das Wort "Flash" hat alle darauf trainiert, etwas Günstiges zu erwarten, und genau da kann Omni 1.1 Flash in die Irre führen. Bei Text liegt es preislich auf dem Niveau eines Flash-Modells der mittleren Stufe. Der Video-Zähler hat in der Text-Reihe kein Gegenstück.
| Modell | Input / 1 Mio. | Output / 1 Mio. | Kostenloses Kontingent | Batch |
|---|---|---|---|---|
| Gemini Omni 1.1 Flash | $1,50 | $9,00 Text / $17,50 Video | Nein | Nein |
| Gemini 3.5 Flash (Text) | $1,50 | $9,00 | Ja | Ja |
| Gemini 3.7 Flash (Text) | $0,75* | $3,75* | Ja | Ja |
| Gemini 2.5 Flash (Text) | $0,30 | $2,50 | Ja | Ja |
*Gemini 3.7 Flash hat einen Aktionspreis, der laut Preisseite der Gemini API nach dem 31. Dezember 2026 auf $1,50 / $7,50 steigt.
Fazit: Die Text-Tokens von Omni 1.1 Flash kosten genau so viel wie bei Gemini 3.5 Flash, du zahlst also keinen Aufpreis dafür, mit dem Modell zu schreiben. Du zahlst für den Video-Zähler, und das ist ein grundlegend anderes Produkt als das, was die Text-Flash-Modelle leisten. Es preislich mit 2.5 Flash zu vergleichen, geht am Punkt vorbei, denn sie erledigen nicht dieselbe Aufgabe.
Lohnt sich Gemini Omni 1.1 Flash?
Wenn du programmatische Videogenerierung mit feiner Kontrolle brauchst (Szenenverlängerung, Keyframe-Steuerung, konsistente Figuren) und mit Kosten pro Sekunde umgehen kannst, ist es für seine Leistung fair bepreist, und der 360p-Entwurfs-Workflow hält es in der Iterations- und Verwerfungsphase bezahlbar, in der sonst der Großteil der Ausgaben anfiele.
Bremsen würde ich dort, wo du nur experimentierst: Ohne kostenloses Kontingent kostet jeder Test echtes Geld, und bei hochvolumigem Batch-Rendering schmerzt der fehlende Batch-Rabatt. Plane in diesen Fällen die Storyboards gründlich und prototypisiere in 360p, bevor du je eine höhere Auflösung anfasst.
Die ehrliche Zusammenfassung: Omni 1.1 Flash ist ein guter Deal für kontrollierte, iterative Videoarbeit und eine schlechte Wahl für wahlloses Massengenerieren. Wisse, was du tust, bevor du es einbaust.
Die Inhalte rund um deinen KI-Stack schreiben
Ein Modell wie Gemini Omni 1.1 Flash ist Infrastruktur: eine rohe Fähigkeit, die du in ein Produkt einbaust. Es kennt weder deine Marke noch deine Dokumentation noch das, was du veröffentlichen willst. Diese Lücke schließt eesel. Statt einer Modell-API bekommst du mit eesel einen einsatzbereiten KI-Teamkollegen, und einer davon ist ein KI-Blog-Writer, der den Kontext deines Unternehmens bereits kennt und aus einem Thema einen recherchierten Entwurf im Markenton macht, so wie unser KI-Helpdesk-Teamkollege Support-Tickets bearbeitet.
Wenn du also Video-Demos mit Omni 1.1 Flash baust und den Launch-Post, die Doku-Seite und die Vergleichsinhalte dazu brauchst, ist das der Teamkollege, den du einstellen solltest. Du kannst ihn kostenlos testen, und er fügt sich in die Tools ein, in denen deine Inhalte ohnehin liegen.
Häufig gestellte Fragen
Was kostet Gemini Omni 1.1 Flash?
Gemini Omni 1.1 Flash wird pro Token abgerechnet: $1,50 pro 1 Mio. Input-Tokens (Text, Bild, Audio oder Video als Eingabe), $9,00 pro 1 Mio. Text-Output-Tokens und $17,50 pro 1 Mio. Video-Output-Tokens. Google beziffert den Video-Output auf etwa $0,10 pro Sekunde in 720p. Die aktuellen Zahlen findest du auf der Preisseite der Gemini API.
Gibt es für Gemini Omni 1.1 Flash ein kostenloses Kontingent?
Nein. Anders als die reinen Text-Modelle der Gemini-Flash-Reihe hat Gemini Omni 1.1 Flash kein kostenloses Kontingent, jede Anfrage wird ab dem ersten Token berechnet. Wenn du Googles Modelle kostenlos ausprobieren willst, enthalten die Standard-Preisstufen von Gemini weiterhin ein kostenloses API-Kontingent.
Was kostet ein 10-Sekunden-Video mit Gemini Omni 1.1 Flash?
Ein 10-Sekunden-Clip in 720p mit Audio sind etwa 57.920 Output-Tokens, also rund $1,01 an Video-Output-Kosten, noch bevor Input- oder Text-Tokens dazukommen. Im 360p-Entwurfsmodus sinkt der Preis auf etwa $0,34.
Gibt es für Gemini Omni 1.1 Flash den 50-%-Batch-Rabatt?
Nein. Batch-Inferenz wird von diesem Modell nicht unterstützt, deshalb entfällt der übliche Gemini-Batch-Rabatt von 50 %. Die reinen Text-Flash-Modelle wie Gemini 3.5 und 3.7 Flash bekommen ihn weiterhin.
Sind die Preise für Gemini Omni 1.1 Flash auf Vertex AI und der Gemini API gleich?
Ja. Die Token-Preise sind in Google AI Studio (der Gemini API) und auf der Gemini Enterprise Agent Platform (der Vertex-Linie) identisch: $1,50 Input, $9,00 Text-Output, $17,50 Video-Output pro 1 Mio. Tokens. Verfügbar ist das Modell nur in der globalen Region.